

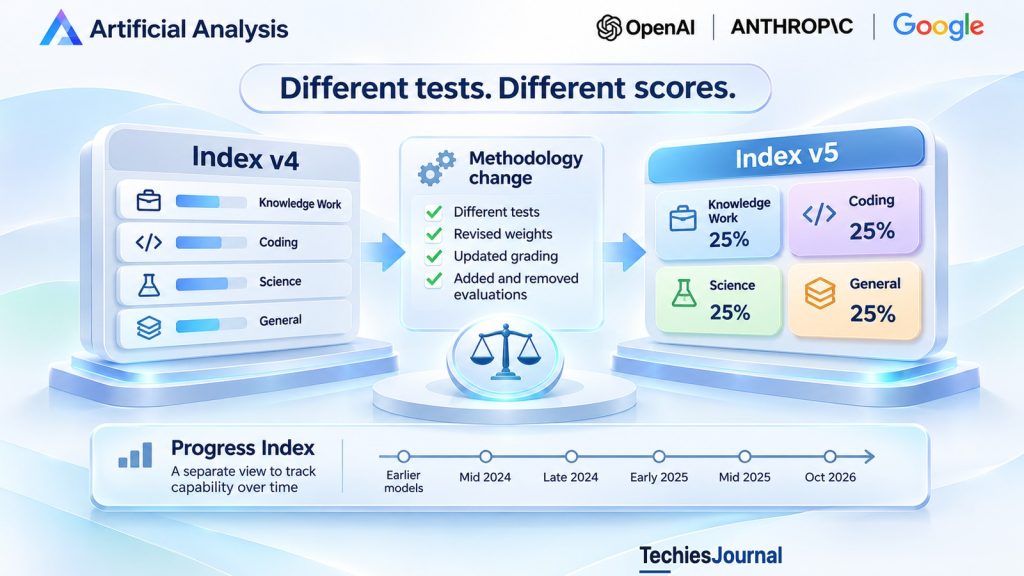
Artificial Analysis ने अक्टूबर 2026 में अपने Intelligence Index को नए सिरे से तैयार किया और AI मॉडलों की तुलना के लिए इस्तेमाल होने वाले टेस्ट और वेटेज बदल दिए। यह अपडेट समझाता है कि मॉडल में खुद कोई बदलाव न होने पर भी उसका स्कोर क्यों बदल सकता है।
कल्पना कीजिए कि एक डेवलपमेंट टीम AI मॉडलों की दो मूल्यांकन रिपोर्टें देख रही है।
पहली रिपोर्ट एक मॉडल को 55 का स्कोर देती है। एक नई रिपोर्ट उसी मॉडल वर्ज़न को 50 का स्कोर देती है।
ज़रूरी नहीं कि मॉडल में कुछ भी बदला हो, फिर भी टीम को अब एक कम संख्या दिख रही है।
क्या मॉडल की क्षमता घट गई है, या मापने का तरीका बदल गया है?
ये संख्याएँ काल्पनिक हैं। ये एक ऐसे सवाल को सामने रखती हैं जो 27 अक्टूबर 2026 को खास तौर पर प्रासंगिक हो गया, जब Artificial Analysis ने अपने Intelligence Index का वर्ज़न 5 जारी किया।
संगठन ने अपने समग्र (कंपोज़िट) बेंचमार्क में इस्तेमाल होने वाले मूल्यांकन बदले, नए टेस्ट जोड़े, मौजूदा टेस्ट अपग्रेड किए और यह संशोधित किया कि अलग-अलग क्षमताएँ अंतिम स्कोर में कितना योगदान देती हैं।
Artificial Analysis के अनुसार, अपडेट किए गए इंडेक्स के वेटेज का 60% हिस्सा उन मूल्यांकनों से आता है जो निजी टेस्ट सेट या छिपाकर रखे गए उत्तरों का इस्तेमाल करते हैं।
कंपनी ने एक अलग Progress Index भी पेश किया, ताकि यह अनुमान लगाया जा सके कि समय के साथ मॉडलों की क्षमताएँ कैसे बदली हैं।
ये बदलाव इस बात पर असर डालते हैं कि कोई रिपोर्ट किया गया स्कोर असल में किस चीज़ को दर्शाता है।
AI मॉडल चुनने वाले किसी भी व्यक्ति के लिए बुनियादी फ़र्क़ यह है: मॉडल के प्रदर्शन में बदलाव एक बात है, और उस प्रदर्शन को मापने के तरीके में बदलाव दूसरी बात।
Intelligence Index v5 में क्या बदला?
Artificial Analysis Intelligence Index कई मूल्यांकनों के नतीजों को मिलाकर एक समग्र स्कोर बनाता है।
वर्ज़न 5 नौ मूल्यांकनों को चार श्रेणियों में रखता है, और हर श्रेणी का वेटेज बराबर है।
| श्रेणी | इंडेक्स में वेटेज | मूल्यांकन |
|---|---|---|
| नॉलेज वर्क | 25% | AA-Briefcase, AutomationBench-AA, GDP.pdf |
| कोडिंग | 25% | FrontierCode 2.0, Terminal-Bench 4.0 |
| विज्ञान | 25% | Terminal-Bench-Science, CritPt v2 का कठिन सबसेट |
| सामान्य | 25% | AA-Omniscience v1.1, HLE-Diamond |
हर श्रेणी के भीतर अलग-अलग मूल्यांकनों का वेटेज बराबर नहीं है।
उदाहरण के लिए, पूरे इंडेक्स में FrontierCode 2.0 का योगदान 15% है, जबकि Terminal-Bench 4.0 का योगदान 10% है।
Artificial Analysis ने अक्टूबर की रिलीज़ को जनवरी में v4 के लॉन्च के बाद का अपना सबसे बड़ा अपग्रेड बताया।
दो मूल्यांकन जोड़े गए।
FrontierCode 2.0 कोडिंग एजेंटों को ओपन-सोर्स रिपॉज़िटरी से जुड़े 132 कामों पर परखता है। इसका आकलन सिर्फ इस पर निर्भर नहीं रहता कि ऑटोमेटेड टेस्ट पास हुए या नहीं, बल्कि यह देखता है कि कोई मेंटेनर उस बदलाव को स्वीकार करेगा या नहीं। किसी ब्लॉकिंग जांच में विफलता काम के स्कोर को शून्य तक ला सकती है।
Terminal-Bench-Science टर्मिनल वातावरण के ज़रिए किए जाने वाले 70 वैज्ञानिक शोध कार्य पेश करता है। कोई काम तभी पास होता है जब हर ज़रूरी टेस्ट पास हो।
तीन मूल्यांकन अपग्रेड किए गए।
HLE-Diamond ने मूल Humanity’s Last Exam घटक की जगह 1,000 सवालों का एक परिष्कृत सेट रखा।
AA-Omniscience v1.1 ने अपना डेटासेट संशोधित किया, ताकि सार्वजनिक या सैचुरेटेड सवाल हटाए जा सकें और अस्पष्ट या गलत आइटम ठीक किए जा सकें।
CritPt v2 फ़िज़िक्स के एक मूल्यांकन के 40 सवालों वाले निजी कठिन सबसेट के रूप में इंडेक्स में आया, जिसमें कोड चलाने की सुविधा उपलब्ध है।
समग्र इंडेक्स से GDPval-AA v2.1, SciCode और AA-LCR v1.1 भी हटा दिए गए।
इन बदलावों के नतीजे तकनीकी हैं, सिर्फ दिखावटी नहीं। v5 से बना स्कोर पिछले वर्ज़न की तुलना में कामों, ग्रेडिंग की शर्तों और वेटेज के एक अलग संग्रह को दर्शाता है।
जोड़े
FrontierCode 2.0 कोडिंग एजेंटों को ओपन-सोर्स रिपॉज़िटरी से जुड़े 132 कामों पर परखता है। इसका आकलन सिर्फ इस पर निर्भर नहीं रहता कि ऑटोमेटेड टेस्ट पास हुए या नहीं, बल्कि यह देखता है कि कोई मेंटेनर उस बदलाव को स्वीकार करेगा या नहीं। किसी ब्लॉकिंग जांच में विफलता काम के स्कोर को शून्य तक ला सकती है।
Terminal-Bench-Science टर्मिनल वातावरण के ज़रिए किए जाने वाले 70 वैज्ञानिक शोध कार्य पेश करता है। कोई काम तभी पास होता है जब हर ज़रूरी टेस्ट पास हो।
अपग्रेड
HLE-Diamond ने मूल Humanity’s Last Exam घटक की जगह 1,000 सवालों का एक परिष्कृत सेट रखा।
AA-Omniscience v1.1 ने अपना डेटासेट संशोधित किया, ताकि सार्वजनिक या सैचुरेटेड सवाल हटाए जा सकें और अस्पष्ट या गलत आइटम ठीक किए जा सकें।
CritPt v2 फ़िज़िक्स के एक मूल्यांकन के 40 सवालों वाले निजी कठिन सबसेट के रूप में इंडेक्स में आया, जिसमें कोड चलाने की सुविधा उपलब्ध है।
हटाए
समग्र इंडेक्स से GDPval-AA v2.1, SciCode और AA-LCR v1.1 भी हटा दिए गए।
इन बदलावों के नतीजे तकनीकी हैं, सिर्फ दिखावटी नहीं। v5 से बना स्कोर पिछले वर्ज़न की तुलना में कामों, ग्रेडिंग की शर्तों और वेटेज के एक अलग संग्रह को दर्शाता है।
स्रोत: Artificial Analysis, Announcing Artificial Analysis Intelligence Index v5, 27 अक्टूबर 2026
एक ही मॉडल को अलग स्कोर कैसे मिल सकता है?
उसी काल्पनिक डेवलपमेंट टीम पर लौटते हैं।
उसका मॉडल वर्ज़न नहीं बदला है, लेकिन मूल्यांकन का सेट (evaluation suite) अलग है।
कोई पुराना बेंचमार्क छोटे कोडिंग अभ्यासों पर ज़ोर दे सकता है। कोई नया बेंचमार्क जटिल रिपॉज़िटरी में बदलाव करने और स्वीकृति की कई शर्तें पूरी करने को ज़्यादा वेटेज दे सकता है।
कोई मॉडल पहली तरह के काम में असरदार हो सकता है, जबकि दूसरी तरह के काम में उसे मुश्किल हो।
ज़रूरी नहीं कि यह फ़र्क़ मॉडल की बुनियादी क्षमताओं में गिरावट को दर्शाए।
यह इस बात में बदलाव को दर्शा सकता है कि मूल्यांकनकर्ता मॉडल से क्या करवाना चाहता है।
ग्रेडिंग का तरीका भी मायने रखता है।
मान लीजिए एक कोडिंग एजेंट मांगे गए बदलाव का ज़्यादातर हिस्सा पूरा कर देता है, लेकिन एक अहम ज़रूरत पूरी नहीं कर पाता।
आंशिक अंक देने वाला मूल्यांकन सफल काम को मान्यता दे सकता है। कोई दूसरा मूल्यांकन शून्य दे सकता है, क्योंकि उस विफलता से बदलाव अस्वीकार्य हो जाता है।
FrontierCode 2.0 ब्लॉकिंग जांचों का इस्तेमाल करता है, जो किसी प्रयास का स्कोर शून्य कर सकती हैं।
स्वीकृति के इस सख्त मानक पर मॉडल का प्रदर्शन पाठकों को उसके व्यवहार के बारे में कुछ उपयोगी बताता है। इससे यह साबित नहीं होता कि पहले के, अलग तरीके से ग्रेड किए गए काम पर उसका स्कोर गिर गया होता।
वेटेज का भी एक अलग असर होता है।
अगर कोई मॉडल विज्ञान में अपेक्षाकृत मज़बूत है लेकिन रिपॉज़िटरी पर आधारित कोडिंग में कमज़ोर है, तो कोडिंग कामों का महत्व बढ़ाने से उसका समग्र नतीजा बदल सकता है।
इसीलिए किसी समग्र बेंचमार्क को इंटेलिजेंस का स्थायी, सार्वभौमिक माप नहीं समझना चाहिए।
यह तय की गई मूल्यांकन शर्तों के तहत कामों के एक खास चयन पर प्रदर्शन का सारांश देता है।
सवाल
एक टीम उसी मॉडल वर्ज़न के लिए एक मूल्यांकन रिपोर्ट में 55 और एक नई रिपोर्ट में 50 का स्कोर देखती है। क्या मॉडल की क्षमता घट गई है, या मापने का तरीका बदल गया है? ये संख्याएँ काल्पनिक हैं।
काम का मिश्रण
कोई पुराना बेंचमार्क छोटे कोडिंग अभ्यासों पर ज़ोर दे सकता है। कोई नया बेंचमार्क जटिल रिपॉज़िटरी में बदलाव करने और स्वीकृति की कई शर्तें पूरी करने को ज़्यादा वेटेज दे सकता है। कोई मॉडल पहली तरह के काम में असरदार हो सकता है, जबकि दूसरी तरह के काम में उसे मुश्किल हो। ज़रूरी नहीं कि यह मॉडल की बुनियादी क्षमताओं में गिरावट को दर्शाए।
ग्रेडिंग
आंशिक अंक देने वाला मूल्यांकन सफल काम को मान्यता दे सकता है। कोई दूसरा मूल्यांकन शून्य दे सकता है, क्योंकि एक अहम ज़रूरत पूरी नहीं हुई। FrontierCode 2.0 ब्लॉकिंग जांचों का इस्तेमाल करता है, जो किसी प्रयास का स्कोर शून्य कर सकती हैं।
वेटेज
अगर कोई मॉडल विज्ञान में अपेक्षाकृत मज़बूत है लेकिन रिपॉज़िटरी पर आधारित कोडिंग में कमज़ोर है, तो कोडिंग कामों का महत्व बढ़ाने से उसका समग्र नतीजा बदल सकता है।
ज़्यादा निजी मूल्यांकन से क्या बेहतर होता है?
Artificial Analysis बताता है कि v5 इंडेक्स के वेटेज का 60% हिस्सा उन मूल्यांकनों से आता है जो निजी टेस्ट सेट या छिपाकर रखे गए उत्तरों का इस्तेमाल करते हैं।
यह मूल्यांकन की एक वास्तविक समस्या को संबोधित करता है।
सार्वजनिक बेंचमार्क शोधकर्ताओं को सवाल जांचने, ग्रेडिंग के नियम समझने और नतीजे दोहराने का मौका देते हैं।
लेकिन सार्वजनिक उपलब्धता से यह मौका भी बनता है कि टेस्ट सामग्री ट्रेनिंग डेटा, प्रॉम्प्ट या मॉडल डेवलपमेंट के फ़ीडबैक में पहुंच जाए।
बेंचमार्क के सवालों से परिचित मॉडल आंशिक रूप से पहले के संपर्क की वजह से अच्छा प्रदर्शन कर सकता है, न कि इसलिए कि वह उतनी ही कठिन अनजानी समस्याएँ हल कर सकता है।
टेस्ट के काम या उत्तर निजी रखने का मकसद इस जोखिम को कम करना है।
FrontierCode 2.0 निजी रिपॉज़िटरी कामों का इस्तेमाल करता है। AA-Omniscience v1.1 उन सवालों को भी हटाता है जिन्हें प्रकाशक ने सार्वजनिक या पर्याप्त रूप से भेद न कर पाने वाला बताया है।
ये उपाय पहले से ज्ञात उत्तरों के संपर्क को ज़्यादा मुश्किल बना सकते हैं।
फिर भी, निजी होने का मतलब कंटैमिनेशन से पूरी तरह सुरक्षित होना नहीं है।
प्रकाशित कार्यप्रणाली मूल्यांकनकर्ता के डिज़ाइन से जुड़े फ़ैसलों को समझाती है। यह स्वतंत्र रूप से यह साबित नहीं करती कि किसी भी मॉडल का संबंधित सामग्री से सामना नहीं हुआ है।
निजी टेस्ट एक ट्रेड-ऑफ़ भी पैदा करते हैं।
जब काम और ग्रेडिंग के विवरण रोक लिए जाते हैं, तो बाहरी शोधकर्ताओं के पास अलग-अलग नतीजों को दोहराने या उन्हें चुनौती देने के लिए कम जानकारी होती है।
यह तरीका संपर्क के कुछ जोखिम कम कर सकता है, लेकिन साथ ही बेंचमार्क प्रकाशक के काम चुनने, ग्रेडिंग लागू करने और गुणवत्ता नियंत्रण पर निर्भरता बढ़ाता है।
न तो पूरी तरह सार्वजनिक और न ही आंशिक रूप से निजी बेंचमार्क अपने आप वास्तविक दुनिया में मॉडल की विश्वसनीयता का पूरा माप देता है।
सुधार
सार्वजनिक उपलब्धता से यह मौका बनता है कि टेस्ट सामग्री ट्रेनिंग डेटा, प्रॉम्प्ट या मॉडल डेवलपमेंट के फ़ीडबैक में पहुंच जाए। बेंचमार्क के सवालों से परिचित मॉडल आंशिक रूप से पहले के संपर्क की वजह से अच्छा प्रदर्शन कर सकता है। टेस्ट के काम या उत्तर निजी रखने का मकसद इस जोखिम को कम करना है।
कीमत
जब काम और ग्रेडिंग के विवरण रोक लिए जाते हैं, तो बाहरी शोधकर्ताओं के पास अलग-अलग नतीजों को दोहराने या उन्हें चुनौती देने के लिए कम जानकारी होती है। यह तरीका संपर्क के कुछ जोखिम कम कर सकता है, लेकिन साथ ही बेंचमार्क प्रकाशक के काम चुनने, ग्रेडिंग लागू करने और गुणवत्ता नियंत्रण पर निर्भरता बढ़ाता है।
साबित नहीं
निजी होने का मतलब कंटैमिनेशन से पूरी तरह सुरक्षित होना नहीं है। प्रकाशित कार्यप्रणाली मूल्यांकनकर्ता के डिज़ाइन से जुड़े फ़ैसलों को समझाती है। यह स्वतंत्र रूप से यह साबित नहीं करती कि किसी भी मॉडल का संबंधित सामग्री से सामना नहीं हुआ है।
व्यावहारिक काम उपयोगी हैं, फिर भी चुने हुए हैं
Intelligence Index v5 उन मूल्यांकनों को काफ़ी वेटेज देता है जिनमें टूल, रिपॉज़िटरी और कई चरणों वाला काम शामिल है।
यह उपयोगी है, क्योंकि कई पेशेवर एप्लिकेशन में सिर्फ एक अलग-थलग जवाब देने से ज़्यादा की ज़रूरत होती है।
फिर भी, व्यावहारिक काम जैसा दिखने वाला मूल्यांकन अपने आप हर संगठन के माहौल का प्रतिनिधित्व नहीं करता।
FrontierCode चुनी हुई रिपॉज़िटरी में बदलावों को परखता है। किसी निजी एंटरप्राइज़ एप्लिकेशन को संभालने वाली डेवलपमेंट टीम की प्रोग्रामिंग भाषाएँ, आर्किटेक्चर, सुरक्षा से जुड़ी बाधाएँ और समीक्षा की ज़रूरतें अलग हो सकती हैं।
Terminal-Bench-Science तय की गई टर्मिनल परिस्थितियों में शोध वर्कफ़्लो को परखता है। इससे यह साबित नहीं होता कि कोई मॉडल हर वैज्ञानिक वर्कफ़्लो को भरोसेमंद ढंग से पूरा कर सकता है।
Artificial Analysis अपने Intelligence Index को मुख्य रूप से टेक्स्ट-आधारित और अंग्रेज़ी भाषा पर आधारित भी बताता है। व्यापक बहुभाषी क्षमता और दूसरी मोडैलिटी के नतीजे वह अलग मूल्यांकनों के ज़रिए रिपोर्ट करता है।
फ़र्क़ चुने गए कामों को मापने और मूल्यांकन से बाहर के कामों पर प्रदर्शन का अनुमान लगाने के बीच है।
अक्टूबर के बदलाव मौजूदा मॉडलों के बीच फ़र्क़ करने की प्रकाशक की क्षमता बेहतर कर सकते हैं। वे किसी खास कारोबारी एप्लिकेशन में सफलता का अनुमान देते हैं या नहीं, इसके लिए उसी एप्लिकेशन से अतिरिक्त साक्ष्य चाहिए।
v4 और v5 के स्कोर की सीधी तुलना क्यों नहीं हो सकती
किसी बेंचमार्क स्कोर का अर्थ सिर्फ उस मापन तरीके के भीतर होता है जिसने उसे बनाया।
जब कामों का चयन, स्कोरिंग के नियम या वेटेज बदलते हैं, तो संख्याओं का पैमाना भी बदल सकता है।
इसलिए जिस काल्पनिक मॉडल का स्कोर 55 से 50 हुआ, उसके बारे में क्षमता में पांच अंकों की गिरावट बताना उपलब्ध साक्ष्य से समर्थित नहीं होगा।
यह फ़र्क़ कठिन कामों, अलग वेटेज, सख्त ग्रेडिंग या बदली हुई मूल्यांकन शर्तों से आ सकता है।
रैंकिंग में बदलाव भी इस तथ्य को दर्शा सकता है कि अलग-अलग मॉडल कामों के संशोधित मिश्रण पर अलग-अलग प्रतिक्रिया देते हैं।
Artificial Analysis कहता है कि Intelligence Index के क्रमिक वर्ज़न लंबी अवधि की क्षमता का एक सीधे तुलनीय पैमाना बनाने के लिए नहीं हैं।
Intelligence Index v5 का स्कोर v5 ढांचे के तहत प्रदर्शन बताता है।
पहले का v4 स्कोर पहले वाले ढांचे के तहत प्रदर्शन बताता है।
दोनों उपयोगी हो सकते हैं, भले ही उन्हें सीधे एक दूसरे से घटाना ठीक न हो।
स्रोत: Artificial Analysis, Progress Index v1 Methodology, अक्टूबर 2026
अलग Progress Index क्या मापता है?
ऐतिहासिक तुलनाओं के लिए Artificial Analysis ने अक्टूबर के अपडेट के साथ Progress Index v1 पेश किया।
Intelligence Index और Progress Index के उद्देश्य अलग-अलग हैं।
Intelligence Index को मौजूदा मॉडलों की तुलना ऐसे कामों पर करने के लिए डिज़ाइन किया गया है जो आज की क्षमताओं का प्रतिनिधित्व करने के लिए चुने गए हैं।
जब मॉडल बेहतर होते हैं और पुराने मूल्यांकन उनके बीच फ़र्क़ करना बंद कर देते हैं, तो इसकी बनावट बदल सकती है।
इसके बजाय Progress Index एक साझा सांख्यिकीय पैमाने पर समय के साथ मॉडल की क्षमता का अनुमान लगाने की कोशिश करता है।
यह आइटम रिस्पॉन्स थ्योरी (item response theory) नाम की पद्धति का इस्तेमाल करता है।
मूल विचार यह है कि मॉडल की क्षमता और काम की कठिनाई का अनुमान एक साथ लगाया जाए।
अपेक्षाकृत कठिन कामों में सफल होने वाला मॉडल उस मॉडल से अलग साक्ष्य देता है जो सिर्फ आसान कामों में सफल होता है।
सांख्यिकीय पद्धति इन नतीजों को ध्यान में रखकर अनुमान लगाती है कि साझा पैमाने पर मॉडल कहाँ आते हैं।
अहम बात यह है कि सभी मॉडलों को बिल्कुल एक जैसे काम पूरे करने की ज़रूरत नहीं होती।
Artificial Analysis बेंचमार्कों को उन मॉडलों के ज़रिए जोड़ता है जिनका मूल्यांकन कई बेंचमार्कों पर हुआ है। जहाँ उपयुक्त डेटा उपलब्ध है वहाँ यह अलग-अलग कामों के नतीजों का इस्तेमाल करता है, और बाकी जगह बेंचमार्क के कुल नतीजों का।
मॉडलों के ये आपस में मेल खाते नतीजे पुराने और नए मूल्यांकनों को साझा अनुमानित पैमाने पर रखने में मदद करते हैं।
ऐतिहासिक रुझानों का अध्ययन करने के लिए यह Intelligence Index के अलग-अलग वर्ज़न के स्कोर एक दूसरे से घटाने की तुलना में ज़्यादा उपयुक्त है।
लेकिन यह फिर भी एक अनुमान ही है।
पैमाने पर मॉडलों को मिलने वाले स्थान उपलब्ध मूल्यांकन डेटा, सांख्यिकीय मॉडल और उसकी मान्यताओं पर निर्भर करते हैं। ये हर मॉडल को एक जैसी परिस्थितियों में कामों का एक जैसा सेट पूरा करते हुए देखने के बराबर नहीं हैं।
एक साथ
Progress Index आइटम रिस्पॉन्स थ्योरी (item response theory) नाम की पद्धति का इस्तेमाल करता है। मूल विचार यह है कि मॉडल की क्षमता और काम की कठिनाई का अनुमान एक साथ लगाया जाए। अपेक्षाकृत कठिन कामों में सफल होने वाला मॉडल उस मॉडल से अलग साक्ष्य देता है जो सिर्फ आसान कामों में सफल होता है।
एक जैसे काम नहीं
सभी मॉडलों को बिल्कुल एक जैसे काम पूरे करने की ज़रूरत नहीं होती।
जुड़ाव
Artificial Analysis बेंचमार्कों को उन मॉडलों के ज़रिए जोड़ता है जिनका मूल्यांकन कई बेंचमार्कों पर हुआ है। जहाँ उपयुक्त डेटा उपलब्ध है वहाँ यह अलग-अलग कामों के नतीजों का इस्तेमाल करता है, और बाकी जगह बेंचमार्क के कुल नतीजों का। मॉडलों के ये आपस में मेल खाते नतीजे पुराने और नए मूल्यांकनों को साझा अनुमानित पैमाने पर रखने में मदद करते हैं।
अनुमान
यह फिर भी एक अनुमान ही है। पैमाने पर मॉडलों को मिलने वाले स्थान उपलब्ध मूल्यांकन डेटा, सांख्यिकीय मॉडल और उसकी मान्यताओं पर निर्भर करते हैं। ये हर मॉडल को एक जैसी परिस्थितियों में कामों का एक जैसा सेट पूरा करते हुए देखने के बराबर नहीं हैं।
Artificial Analysis मौजूदा मॉडलों की तुलना के लिए Intelligence Index और समय के साथ क्षमता को परखने के लिए Progress Index की सलाह देता है।
स्रोत: Artificial Analysis, Progress Index v1 Methodology, अक्टूबर 2026
मॉडल की सेटिंग्स भी नतीजा बदल सकती हैं
सिर्फ बेंचमार्क की कार्यप्रणाली ही मायने रखने वाला अकेला कारक नहीं है।
एक ही मॉडल का मूल्यांकन अलग-अलग रीज़निंग एफ़र्ट सेटिंग्स पर किया जा सकता है।
27 अक्टूबर की अपनी घोषणा में Artificial Analysis ने बताया कि Claude Opus 5.5 ने कम एफ़र्ट पर 35 और अधिकतम एफ़र्ट पर 58 स्कोर किया।
Intelligence Index के प्रति काम की अनुमानित लागत भी $0.98 से बढ़कर $10.04 हो गई।
ये Artificial Analysis के रिपोर्ट किए गए नतीजे हैं, TechiesJournal के स्वतंत्र रूप से दोहराए गए माप नहीं।
कम एफ़र्ट
27 अक्टूबर की अपनी घोषणा में Artificial Analysis ने बताया कि Claude Opus 5.5 ने कम एफ़र्ट पर 35 स्कोर किया। Intelligence Index के प्रति काम की अनुमानित लागत $0.98 थी।
अधिकतम एफ़र्ट
अधिकतम एफ़र्ट पर उसी मॉडल ने 58 स्कोर किया, और Intelligence Index के प्रति काम की अनुमानित लागत बढ़कर $10.04 हो गई।
यह क्यों मायने रखता है
ये Artificial Analysis के रिपोर्ट किए गए नतीजे हैं, TechiesJournal के स्वतंत्र रूप से दोहराए गए माप नहीं। बेंचमार्क स्कोर सिर्फ किसी प्रोडक्ट के नाम का नहीं, बल्कि एक मॉडल वर्ज़न और उसके मूल्यांकन कॉन्फ़िगरेशन का होता है। ज़्यादा स्कोर मूल्यवान हो सकता है, लेकिन परिचालन उपयुक्तता आंकते समय अतिरिक्त कंप्यूटेशन और लागत मायने रखते हैं।
ये दिखाते हैं कि बेंचमार्क स्कोर सिर्फ किसी प्रोडक्ट के नाम का नहीं, बल्कि एक मॉडल वर्ज़न और उसके मूल्यांकन कॉन्फ़िगरेशन का होता है।
उपलब्ध टूल, प्रॉम्प्टिंग, एफ़र्ट सेटिंग्स और चलाने की परिस्थितियाँ, ये सभी देखे गए प्रदर्शन पर असर डाल सकते हैं।
ज़्यादा स्कोर मूल्यवान हो सकता है, लेकिन परिचालन उपयुक्तता आंकते समय अतिरिक्त कंप्यूटेशन और लागत मायने रखते हैं।
टीम को संशोधित बेंचमार्क का इस्तेमाल कैसे करना चाहिए?
नई मॉडल रैंकिंग देख रही डेवलपमेंट टीम को किसी स्कोर के बदलाव को सार्थक मानने से पहले चार बातें तय कर लेनी चाहिए।
पहली, बेंचमार्क का वर्ज़न जांचें। कार्यप्रणाली के अलग-अलग वर्ज़न के स्कोर की सीधी तुलना शायद न हो सके।
दूसरी, देखें कि मूल्यांकन क्या मापता है। काम, ग्रेडिंग की शर्तें और वेटेज पहचानें, फिर आंकें कि वे टीम के इच्छित एप्लिकेशन से कितने मिलते हैं।
तीसरी, मॉडल का कॉन्फ़िगरेशन जांचें। अधिकतम रीज़निंग एफ़र्ट पर मिले नतीजे को किसी सस्ते, कम एफ़र्ट वाले डिप्लॉयमेंट का वर्णन नहीं मान लेना चाहिए।
चौथी, सही तुलना चुनें। मौजूदा मॉडलों की तुलना उस मूल्यांकन की शर्तों के तहत करने के लिए मौजूदा वर्ज़न वाले मूल्यांकन का इस्तेमाल करें। लंबी अवधि के रुझानों का अध्ययन करते समय Progress Index जैसी दस्तावेज़ित ऐतिहासिक कार्यप्रणाली का इस्तेमाल करें।
वर्ज़न
बेंचमार्क का वर्ज़न जांचें। कार्यप्रणाली के अलग-अलग वर्ज़न के स्कोर की सीधी तुलना शायद न हो सके।
यह क्या मापता है
देखें कि मूल्यांकन क्या मापता है। काम, ग्रेडिंग की शर्तें और वेटेज पहचानें, फिर आंकें कि वे टीम के इच्छित एप्लिकेशन से कितने मिलते हैं।
कॉन्फ़िगरेशन
मॉडल का कॉन्फ़िगरेशन जांचें। अधिकतम रीज़निंग एफ़र्ट पर मिले नतीजे को किसी सस्ते, कम एफ़र्ट वाले डिप्लॉयमेंट का वर्णन नहीं मान लेना चाहिए।
तुलना
सही तुलना चुनें। मौजूदा मॉडलों की तुलना उस मूल्यांकन की शर्तों के तहत करने के लिए मौजूदा वर्ज़न वाले मूल्यांकन का इस्तेमाल करें। लंबी अवधि के रुझानों का अध्ययन करते समय Progress Index जैसी दस्तावेज़ित ऐतिहासिक कार्यप्रणाली का इस्तेमाल करें।
सार्वजनिक मूल्यांकन किसी टीम को यह तय करने में मदद कर सकते हैं कि किन मॉडलों को आगे परखा जाना चाहिए।
अंतिम परिचालन फ़ैसले में प्रतिनिधि काम, विफलता की गंभीरता, स्थिरता, लागत, विलंबता (latency) और संगठन की अपनी बाधाओं पर भी विचार होना चाहिए।
ये एक दूसरे के पूरक साक्ष्य हैं।
बेंचमार्क बदल गया। फ़ैसले में क्या बदलना चाहिए?
Artificial Analysis Intelligence Index v5 कार्यप्रणाली का एक ठोस संशोधन है।
यह मूल्यांकन की जाने वाली क्षमताओं का मिश्रण बदलता है, कामों का ज़्यादा सख्त आकलन लाता है, वेटेज संशोधित करता है और निजी या छिपाकर रखी गई मूल्यांकन सामग्री पर निर्भरता बढ़ाता है।
ये फ़ैसले इंडेक्स को उन क्षमताओं के बारे में ज़्यादा जानकारी देने वाला बना सकते हैं जिन्हें उसका प्रकाशक आज मापना चाहता है। इनसे यह साबित नहीं होता कि यह हर प्रोडक्शन वर्कलोड का ज़्यादा सटीक अनुमान देता है।
अलग Progress Index एक दूसरे सवाल पर काम करता है: वह साझा पैमाने पर ऐतिहासिक क्षमता का अनुमान लगाता है, सांख्यिकीय अनुमान में निहित सीमाओं के साथ।
AI मॉडल चुनने वाली टीमों के लिए, बदला हुआ स्कोर मॉडल की प्रगति या गिरावट के बारे में कोई निष्कर्ष निकालने से पहले मापन की शर्तों की जांच का संकेत होना चाहिए।
बेंचमार्क का नतीजा बताता है कि तय की गई शर्तों के तहत किसी मॉडल ने कैसा प्रदर्शन किया। जब तक शर्तें समझ में न आएँ, तब तक उस नतीजे में बदलाव यह नहीं बताता कि वह क्यों बदला।
संदर्भ और आगे पढ़ने के लिए
- Artificial Analysis, Announcing Artificial Analysis Intelligence Index v5। 27 अक्टूबर 2026। नए मूल्यांकनों, संशोधनों और अपडेट किए गए वेटेज की मूल घोषणा।
- Artificial Analysis, Intelligence Benchmarking Methodology। 3 नवंबर 2026 की समीक्षा के दौरान वर्ज़न 5.0.1 दिखाया गया।
- Artificial Analysis, Progress Index v1 Methodology। अक्टूबर 2026। अलग-अलग मूल्यांकन सेटों में क्षमता का अनुमान लगाने का सांख्यिकीय तरीका।
- TechiesJournal, बेंचमार्क थिएटर: AI मॉडल दावों को कैसे पढ़ें। सितंबर 2026। बेंचमार्क दावों को समझने और मॉडल चुनने पर संबंधित लेख।
साक्ष्य की कटऑफ़: 3 नवंबर 2026। कार्यप्रणाली, मूल्यांकनों की सूची और रिपोर्ट की गई रैंकिंग बदल सकती हैं। यह लेख 27 अक्टूबर की v5 रिलीज़ के बारे में है और समीक्षा के दौरान दिखाई देने वाले कार्यप्रणाली वर्ज़न की पहचान करता है।