

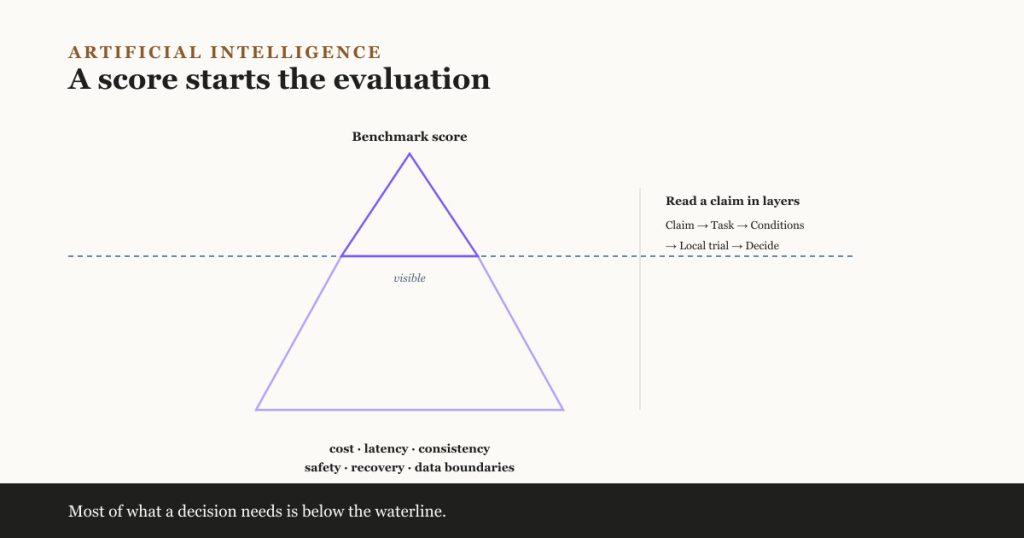
एक लीडरबोर्ड आपको यह चुनने में मदद कर सकता है कि क्या परखना है। यह आपको यह नहीं बता सकता कि कौन-सा मॉडल आपके वातावरण में काम करेगा।
चार्ट आपके सोचे से छोटे सवाल का जवाब दे रहा है
एक नया AI मॉडल ऐसे चार्ट के साथ आता है जो दिखाता है कि यह अपने प्रतिस्पर्धियों को पीछे छोड़ देता है। कोई और प्रयोगशाला उसी मॉडल को परखती है और अलग नतीजा बताती है। दोनों आँकड़े सही हो सकते हैं।
यह फ़र्क़ प्रॉम्प्ट, मॉडल वर्ज़न, टूल एक्सेस, स्कोरिंग तरीक़े, प्रयासों की संख्या या यहाँ तक कि जवाब के विकल्पों के क्रम से भी आ सकता है। इससे ज़्यादा अहम बात यह है कि बेंचमार्क शायद एक साफ़-सुथरा, संकरा काम परख रहा हो जबकि आपका काम अस्त-व्यस्त है, निजी डेटा से जुड़ा है और लागत, विलंबता (latency) और जोखिम से बंधा है।
एक बेंचमार्क स्कोर एक सवाल का जवाब देता है: इन टेस्ट परिस्थितियों में इस सिस्टम का प्रदर्शन कैसा रहा? यह अपने आप उस सवाल का जवाब नहीं देता जिसकी आपको परवाह है: क्या हमें यह मॉडल इस्तेमाल करना चाहिए?
एक बेंचमार्क असल में क्या मापता है
एक AI बेंचमार्क, स्कोरिंग तरीक़े के साथ दोहराए जा सकने वाले कामों का एक सेट है। कोई सवाल चुनता है, तय करता है कि सही क्या माना जाएगा और वे शर्तें तय करता है जिनके तहत मॉडल चलता है।
वे चुनाव ही मापन को बनाते हैं। एक कोडिंग बेंचमार्क यह जाँच सकता है कि टेस्ट पास हुए या नहीं, लेकिन यह नहीं कि मेंटेनर उस कोड को स्वीकार करेंगे या नहीं। एक रीज़निंग बेंचमार्क छोटी पहेलियों का इस्तेमाल कर सकता है लेकिन किसी प्रोडक्शन इंसिडेंट को डीबग करने के बारे में बहुत कम बताता है। एक बहुभाषी स्कोर आपके ग्राहकों की भाषा में कमज़ोर प्रदर्शन को छिपा सकता है।
इससे बेंचमार्क बेईमान नहीं बनते। इससे उनकी सीमाएँ अहम बन जाती हैं।
बेंचमार्क थिएटर कहाँ से शुरू होता है
बेंचमार्क थिएटर तब शुरू होता है जब एक सीमित नतीजे को व्यापक जीत के रूप में पेश किया जाता है। आम चेतावनी संकेतों में शामिल हैं:
- सिर्फ़ वे टेस्ट दिखाए जाते हैं जिनमें नया मॉडल जीतता है;
- सटीक मॉडल वर्ज़न या सेटिंग्स ग़ायब हैं;
- अनिश्चितता (uncertainty) को ध्यान में रखे बिना एक छोटे-से स्कोर अंतर को सार्थक माना जाता है;
- प्रकाशक ने ही टेस्ट डिज़ाइन किया, चलाया और विजेता घोषित किया;
- लागत, विलंबता, स्थिरता और विफलता की गंभीरता अनुपस्थित हैं;
- “रीज़निंग” जैसी किसी बेंचमार्क श्रेणी को एक सामान्य क्षमता माना जाता है।
एक नतीजा फिर भी उपयोगी हो सकता है। समस्या “यहाँ ज़्यादा स्कोर” से “हर जगह बेहतर मॉडल” की छलांग है।
दावे को परतों में पढ़ें
| जाँच | पूछने योग्य सवाल | यह क्यों मायने रखता है |
|---|---|---|
| काम | मॉडल को असल में क्या करना था? | एक व्यापक लेबल एक संकरे टेस्ट को छिपा सकता है |
| शर्तें | किस वर्ज़न, प्रॉम्प्ट, टूल और कितने प्रयासों का इस्तेमाल हुआ? | सेटअप में छोटे बदलाव नतीजे को बदल सकते हैं |
| स्कोरिंग | सफलता को सटीक मिलान, टेस्ट, मॉडल जज या इंसानों ने आँका? | हर तरीक़ा अलग-अलग विफलताओं को छोड़ देता है |
| स्वतंत्रता | मूल्यांकन किसने डिज़ाइन और चलाया? | स्व-मूल्यांकन के लिए दोहराए जा सकने वाले विवरण चाहिए |
| अनिश्चितता | क्या कॉन्फ़िडेंस इंटरवल या दोहराए गए रन रिपोर्ट किए गए हैं? | एक छोटा-सा अंतर असली बढ़त के बजाय शोर हो सकता है |
| उपयुक्तता | क्या टेस्ट आपके उपयोगकर्ताओं, डेटा और बाधाओं जैसा दिखता है? | प्रासंगिकता लीडरबोर्ड पोज़िशन से ज़्यादा मायने रखती है |
| छूटे हुए माप | लागत, विलंबता, सुरक्षा और स्थिरता के बारे में क्या? | गुणवत्ता एक परिचालन फ़ैसले का सिर्फ़ एक हिस्सा है |
एक व्यावहारिक उदाहरण
यह एक काल्पनिक, दृष्टांत-मात्र उदाहरण है, असली बेंचमार्क तुलना नहीं।
मान लीजिए Model A एक कोडिंग बेंचमार्क पर 88% स्कोर करता है और Model B 84% स्कोर करता है। Model A चुनने का मन करना स्वाभाविक है।
अब अपनी असली शर्तें जोड़ें। आपकी टीम एक बड़े निजी रिपॉज़िटरी में काम करती है, जनरेट किए गए बदलावों को सुरक्षा समीक्षा पास करने की ज़रूरत होती है और सोर्स कोड को किसी ख़ास क्षेत्र से बाहर नहीं भेज सकती। Model A धीमा है, दोगुनी लागत लेता है और बार-बार माँगे गए दायरे से बाहर की फ़ाइलें बदल देता है। Model B को सीमित रखना आसान है और यह कम समीक्षा टिप्पणियाँ पैदा करता है।
बेंचमार्क ग़लत नहीं था। इसने कुछ उपयोगी मापा। यह बस पूरा फ़ैसला नहीं माप पाया।
असली काम से एक छोटा मूल्यांकन बनाएँ
आपको किसी रिसर्च लैब की ज़रूरत नहीं है। 20–50 प्रतिनिधि कामों से शुरुआत करें जिन्हें आपका संगठन अच्छी तरह समझता है। सामान्य मामले, मुश्किल मामले और ऐसी विफलताएँ शामिल करें जिन्हें आप स्वीकार नहीं कर सकते।
मॉडल चलाने से पहले मूल्यांकन तय करें:
- कौन-सा नतीजा सही माना जाएगा?
- कौन-सी ग़लतियाँ हानिरहित, महँगी या ख़तरनाक हैं?
- मॉडल किस संदर्भ और टूल का इस्तेमाल कर सकता है?
- इंसान व्यक्तिपरक आउटपुट की समीक्षा कैसे करेंगे?
- लागत और विलंबता की सीमाएँ क्या हैं?
- असंगति उजागर करने के लिए कितने दोहराए गए रन चाहिए?
जहाँ तक व्यावहारिक हो, टेस्ट सेट को प्रॉम्प्ट ट्यून करने वाले लोगों से दूर रखें। मॉडल वर्ज़न और सेटिंग्स दर्ज करें। सिर्फ़ औसत स्कोर नहीं, विफलताओं की भी समीक्षा करें। कुल मिलाकर थोड़ा कमज़ोर मॉडल भी बेहतर विकल्प हो सकता है अगर उसकी ग़लतियाँ पकड़ना और सुधारना आसान हो।
जानें, इस्तेमाल करें या महारत हासिल करें?
जानें: समझें कि हर बेंचमार्क का एक काम, स्कोरिंग तरीक़ा और सीमा होती है। एक स्कोर सार्वभौमिक ग्रेड नहीं है।
इस्तेमाल करें: अगर आप AI टूल चुनते हैं, तो पद्धति पढ़ें और शॉर्टलिस्ट बनाने के लिए सार्वजनिक बेंचमार्क का इस्तेमाल करें। उस शॉर्टलिस्ट को प्रतिनिधि काम पर परखें।
महारत हासिल करें: अगर मॉडल का प्रदर्शन आपके उत्पाद के केंद्र में है, तो वर्ज़न वाले मूल्यांकन बनाएँ, अनिश्चितता मापें और निगरानी करें कि प्रोडक्शन व्यवहार टेस्ट से भटक तो नहीं रहा।
अब आपको क्या करना चाहिए?
अपने मौजूदा मॉडल चुनाव के पीछे सबसे अहम बेंचमार्क दावे को लें। लिखें कि इसने क्या मापा और तीन ऐसी चीज़ें जो इसने नहीं मापीं। फिर एक असली काम चलाएँ जो उन छूटे हुए आयामों में से किसी एक को उजागर करे।
बेंचमार्क उपयोगी नक़्शे हैं। बेंचमार्क थिएटर तब शुरू होता है जब नक़्शे को ही धरती मान लिया जाता है। सार्वजनिक स्कोर का इस्तेमाल यह तय करने के लिए करें कि किस पर क़रीब से नज़र डालनी है—अंतिम फ़ैसला बाहर सौंपने के लिए नहीं।
आगे पढ़ें
- HELM: Holistic Evaluation of Language Models — Stanford Center for Research on Foundation Models. परिदृश्यों, मीट्रिक और ट्रेड-ऑफ़ को कवर करने वाला एक पारदर्शी मूल्यांकन ढाँचा। सितंबर 2026 में समीक्षित।
- SWE-bench — Princeton NLP. असली GitHub इश्यू हल करने पर आधारित एक बेंचमार्क; इसका दस्तावेज़ीकरण काम बनाने और स्कोरिंग को समझने में मदद करता है। सितंबर 2026 में समीक्षित।
- Research Update: Algorithmic vs. Holistic Evaluation — METR, 13 अगस्त 2025। दिखाता है कि टेस्ट पास करने वाला कोड भी प्रोडक्शन गुणवत्ता से कम क्यों रह सकता है। सितंबर 2026 में समीक्षित।
- Artificial Intelligence Risk Management Framework: Generative AI Profile — NIST, जुलाई 2024। एक अकेले गुणवत्ता स्कोर से आगे जाकर जेनरेटिव AI का मूल्यांकन करने का मार्गदर्शन। सितंबर 2026 में समीक्षित।