

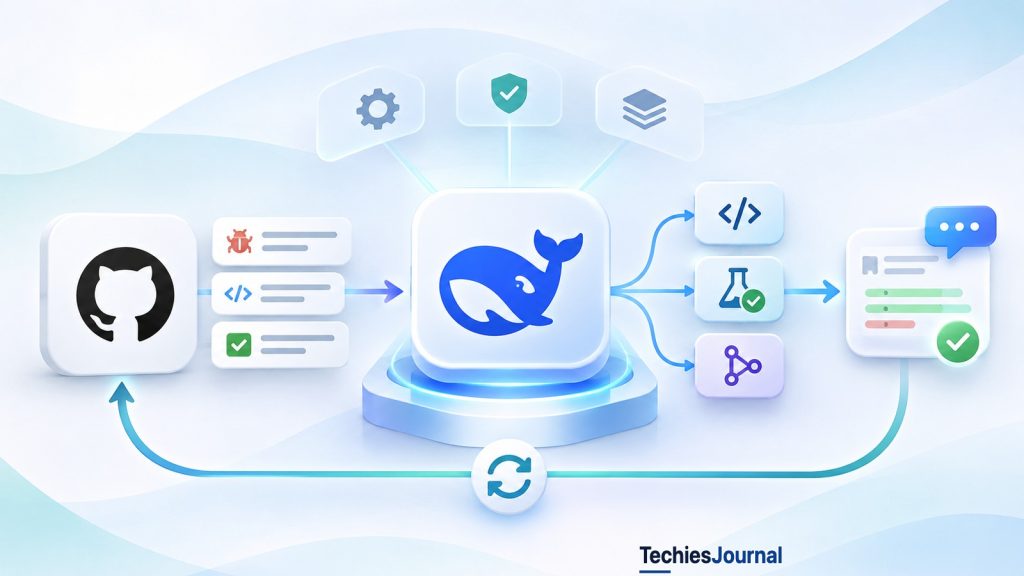
Les agents de codage IA aident déjà les développeurs à écrire du code, corriger des bugs, exécuter des tests et préparer des pull requests. Mais le travail de développement exige toujours que quelqu’un attribue les tâches, suive leur avancement et relance l’agent lorsque des modifications supplémentaires sont nécessaires.
Et si un agent d’IA pouvait rester connecté au travail quotidien d’une équipe de développement, recevoir des demandes autorisées et continuer à traiter les tâches qui lui sont confiées, sans que quelqu’un doive sans cesse lancer une nouvelle conversation ?
C’est l’idée qui sous-tend le nouveau prototype open source Super-Agent de DeepSeek.
Le projet explore la manière dont les agents de codage peuvent devenir des participants permanents du développement logiciel, plutôt que des outils que les développeurs n’utilisent que lorsqu’ils ont besoin d’aide.
Alors, que fait réellement le Super-Agent de DeepSeek, comment fonctionne-t-il et les développeurs doivent-ils s’y intéresser ?
Qu’est-ce que le Super-Agent de DeepSeek ?
Le Super-Agent de DeepSeek est un système d’agent de codage expérimental et open source, conçu pour DeepSeek Harness.
Le projet, baptisé dsh-superagent, relie un agent de codage IA au workflow existant d’une équipe de développement. Il reçoit les demandes via GitHub et peut, en option, s’intégrer à Feishu, une plateforme de messagerie professionnelle.
Au lieu d’ouvrir un outil de codage IA et d’y saisir chaque tâche à la main, un développeur autorisé peut demander du travail directement via GitHub. Le système peut confier ce travail à une session d’agent, suivre son avancement et renvoyer le résultat dans la conversation d’origine.
Il traite chaque mission dans sa propre session d’agent et son propre répertoire.
Par exemple, un développeur pourrait demander à l’agent d’enquêter sur un bug pendant qu’un autre lui demande de mettre à jour des tests ou d’implémenter une petite fonctionnalité.
Le projet a été publié sur GitHub le 31 octobre 2026 sous la licence open source MIT, ce qui permet aux développeurs d’inspecter le code et de l’adapter à leurs besoins.
DeepSeek fait toutefois une distinction importante dans son dépôt officiel : il s’agit d’un prototype de recherche, et non d’un produit officiel prêt pour la production. L’implémentation publique diffère aussi du système interne de DeepSeek, et certaines idées évoquées dans la conception plus large du Super-Agent ne sont pas encore implémentées.
Cette publication est donc l’occasion d’explorer une autre approche des workflows d’agents de codage, plutôt qu’un remplaçant abouti des outils de développement existants.
Source : DeepSeek, Official Super-Agent GitHub Repository.
Comment fonctionne-t-il ?
Le plus simple, pour comprendre le Super-Agent, est de partir d’une tâche de développement ordinaire.
Imaginez une équipe qui maintient une application web. Un développeur découvre que l’une de ses API renvoie une erreur de validation incorrecte et crée une issue GitHub qui explique le problème.
Le développeur demande ensuite au Super-Agent d’enquêter.
Le système reçoit la demande via GitHub et vérifie si la personne est autorisée à attribuer du travail. Si la demande est acceptée, il crée une tâche et l’attribue à une session d’agent.
L’agent peut examiner le dépôt, analyser le problème, modifier le code, exécuter les tests pertinents et préparer une pull request.
Le résultat peut ensuite être partagé dans la discussion GitHub d’origine.
Supposons maintenant qu’un relecteur repère un autre problème dans le correctif proposé et laisse un commentaire.
Au lieu d’obliger le développeur à créer une tâche d’agent entièrement nouvelle, le système est conçu pour transmettre ce retour à l’agent responsable du travail en cours.
L’agent peut examiner le commentaire et poursuivre la mission dans le périmètre qui lui est autorisé.
C’est l’idée centrale de l’approche de DeepSeek. L’agent ne se contente pas de répondre à une demande puis de disparaître. Le système maintient le lien entre une tâche attribuée et l’activité de développement qui suit.
En coulisses, DeepSeek s’appuie sur des enregistrements de tâches, des règles d’autorisation, des sessions d’agent distinctes et un suivi de l’état d’exécution pour coordonner ce travail.
Les développeurs n’ont pas besoin de comprendre chaque composant interne pour saisir le fonctionnement de base.
Une demande autorisée lance une tâche, l’agent y travaille, et l’activité de suivi pertinente peut revenir à la même mission.
Demande
Un développeur découvre que l’une des API de l’application web renvoie une erreur de validation incorrecte, crée une issue GitHub qui explique le problème et demande au Super-Agent d’enquêter.
Contrôle
Le système reçoit la demande via GitHub et vérifie si la personne est autorisée à attribuer du travail.
Tâche
Si la demande est acceptée, le système crée une tâche et l’attribue à une session d’agent.
Travail
L’agent peut examiner le dépôt, analyser le problème, modifier le code, exécuter les tests pertinents et préparer une pull request. Le résultat peut ensuite être partagé dans la discussion GitHub d’origine.
Suivi
Si un relecteur repère un autre problème dans le correctif proposé et laisse un commentaire, le système est conçu pour transmettre ce retour à l’agent responsable du travail en cours. L’agent peut examiner le commentaire et poursuivre la mission dans le périmètre qui lui est autorisé.
Il s’agit d’un exemple illustratif de la conception documentée, et non d’une démonstration, vérifiée de manière indépendante, du prototype exécutant exactement ce workflow.
Sources : DeepSeek, Domain Model et Execution.
Qu’est-ce qui le distingue des agents de codage existants ?
La principale différence ne tient pas au fait que l’agent de DeepSeek sait écrire du code ou créer des pull requests.
Les agents de codage existants offrent déjà ces capacités. Certains peuvent aussi travailler de manière asynchrone ou réagir à des événements provenant des outils de développement.
Le Super-Agent de DeepSeek s’intéresse à la manière dont ces activités sont coordonnées dans la durée.
Trois capacités sont particulièrement intéressantes.
Premièrement, il peut recevoir du travail via les outils de collaboration existants. Les développeurs peuvent demander de l’aide via GitHub au lieu de transférer manuellement chaque tâche dans une interface d’IA distincte.
Deuxièmement, il maintient le lien avec le travail attribué. Le système suit chaque tâche et peut transmettre les commentaires et mises à jour pertinents à l’agent qui s’en occupe. Cela peut réduire le besoin de réexpliquer sans cesse le même contexte.
Troisièmement, il permet un travail proactif selon des règles définies. Le système peut évaluer certains événements de développement comme des tâches possibles, au lieu de dépendre entièrement de demandes explicites.
Cette troisième capacité mérite d’être précisée.
DeepSeek ne laisse pas simplement l’agent agir sur tout ce qu’il voit. Son modèle d’autorisation distingue les demandes explicites du travail que le système identifie lui-même. Ses règles d’admission couvrent les nouvelles issues, les pull requests, les commentaires et la CI de la branche par défaut, et chaque type d’activité peut compter comme une demande explicite, une tâche candidate inférée ou rien du tout.
Pour le travail inféré, le système propose trois modes : off, observe et auto.
Le mode par défaut documenté est observe, qui permet au système d’évaluer des tâches potentielles sans les lancer automatiquement. L’acceptation automatique nécessite des règles et une configuration appropriées.
Les équipes peuvent ainsi examiner ce que l’agent pourrait faire avant de lui accorder davantage d’autonomie.
L’intérêt n’est pas que DeepSeek ait inventé le codage autonome. C’est que le projet réunit la réception des tâches, l’autorisation, l’exécution et le suivi dans un seul système open source.
Source : DeepSeek, Authorization.
Que peuvent réellement en faire les développeurs ?
Les développeurs et les équipes d’ingénierie peuvent utiliser le prototype pour expérimenter plusieurs workflows concrets.
Une équipe pourrait attribuer des issues GitHub à un agent et relire les modifications de code qui en résultent. Elle pourrait étudier la façon dont un agent traite les retours sur une pull request, ou dont plusieurs missions sont gérées sans qu’un développeur ait à coordonner manuellement chaque session.
Une autre expérience utile porte sur les événements de développement.
Par exemple, une équipe pourrait configurer des règles qui évaluent certains échecs de CI comme des tâches possibles. En mode observation, elle pourrait examiner quels événements le système juge pertinents avant d’autoriser la création automatique de tâches.
Le prototype fournit aussi un panneau d’administration web qui affiche le travail en attente de revue, les tâches bloquées et les éléments qui nécessitent une intervention humaine.
Ces capacités peuvent intéresser les équipes qui utilisent déjà régulièrement des agents de codage, en particulier lorsque plusieurs tâches sont traitées en même temps.
Le projet est disponible sur GitHub, et DeepSeek fournit des instructions d’installation pour configurer l’intégration, l’identité de l’agent, les règles d’autorisation et l’environnement d’exécution.
Sa mise en place demande davantage que l’installation d’une extension de codage. Les développeurs doivent configurer des comptes, des permissions d’accès, un environnement d’exécution et le service en cours d’exécution. Les prérequis documentés comprennent Node.js, pnpm, git, tmux, Python, GitHub CLI, DeepSeek Harness et un fournisseur de modèles, et le prototype ne prend en charge qu’un seul dépôt GitHub.
Il faut donc le considérer comme une expérience d’ingénierie plutôt que comme une application de productivité prête à l’emploi.
Source : DeepSeek, Setup Guide.
Quelles sont ses limites ?
La limite la plus importante est la maturité du projet.
DeepSeek avertit explicitement que le code publié peut contenir des bugs et doit être relu et adapté avant toute utilisation. Le dépôt public ne démontre pas que le prototype peut effectuer de manière fiable un travail de développement sans supervision dans différents environnements d’ingénierie.
Il y a aussi des considérations de sécurité.
L’agent a besoin d’accéder au code source et aux outils de développement pour accomplir des tâches utiles. Dans le prototype publié, les sessions d’exécution peuvent lancer des commandes shell sans approbation individuelle, sous le compte du système d’exploitation utilisé pour exécuter le service.
La documentation de DeepSeek indique que les wrappers et les répertoires de travail ne fixent que des valeurs par défaut, et non une frontière de sécurité, et qu’un worker peut toujours exécuter un programme par son chemin absolu.
Les permissions d’accès sont donc importantes. Un agent expérimental ne doit pas disposer d’un accès sans restriction à des identifiants sensibles, à l’infrastructure de production ou à des dépôts critiques.
Les équipes doivent aussi décider quelles actions exigent une approbation humaine. Un agent de codage peut être autorisé à préparer des modifications sans avoir le droit de les fusionner directement dans une branche protégée.
Les instructions d’installation de DeepSeek recommandent de commencer avec un compte GitHub dédié à l’agent et de garder la fusion sous contrôle humain.
Reste enfin la question de la productivité réelle.
Un système qui traite automatiquement plusieurs tâches n’est pas forcément plus efficace. Les développeurs doivent toujours relire son travail, corriger ses erreurs et maintenir l’infrastructure qui le fait tourner.
Il n’existe pour l’instant pas assez de preuves indépendantes pour conclure que ce prototype réduit systématiquement le temps de développement ou surpasse les workflows d’agents de codage établis.
Ces limites ne rendent pas la publication anodine. Elles marquent la différence entre une expérience open source intéressante et un logiciel prêt pour un usage courant en production.
| Limite | Ce qui est documenté ou connu | Précaution |
|---|---|---|
| Maturité | DeepSeek avertit que le code publié peut contenir des bugs et doit être relu et adapté avant toute utilisation. | Commencer avec un dépôt hors production. |
| Exécution | Les sessions peuvent lancer des commandes shell sans approbation individuelle, sous le compte du système d’exploitation qui exécute le service. Les wrappers et les répertoires ne fixent que des valeurs par défaut, et non une frontière de sécurité. | Ne pas lui donner un accès sans restriction à des identifiants sensibles, à l’infrastructure de production ou à des dépôts critiques. |
| Fusion | Les instructions d’installation recommandent un compte GitHub dédié à l’agent et de garder la fusion sous contrôle humain. | Conserver une relecture humaine des modifications proposées. |
| Preuves | Il n’existe pour l’instant pas assez de preuves indépendantes que le prototype réduit systématiquement le temps de développement ou surpasse les workflows d’agents de codage établis. | Évaluer s’il réduit la coordination manuelle et aide l’équipe à accomplir un travail utile. |
Sources : DeepSeek, Execution et Setup Guide.
Les développeurs doivent-ils l’explorer ?
Cela dépend de la façon dont les développeurs utilisent aujourd’hui les agents de codage IA.
Si vous apprenez encore le fonctionnement des agents de codage, vous n’avez aucune raison immédiate d’installer un système Super-Agent permanent. Savoir déléguer des tâches, relire les modifications générées et utiliser les agents en toute sécurité constitue un meilleur point de départ.
Si vous utilisez régulièrement des agents de codage pour développer, le projet vaut la peine d’être examiné. Il offre un exemple concret de la façon dont des agents peuvent recevoir des tâches via GitHub, conserver le contexte d’une tâche et participer à un workflow de développement continu.
Pour les ingénieurs DevOps et les architectes logiciels, l’architecture peut être particulièrement intéressante, car elle associe des agents d’IA à des préoccupations d’ingénierie familières comme les permissions, la gestion des événements, les environnements d’exécution et la supervision.
Les équipes d’ingénierie qui envisagent un essai devraient commencer avec un dépôt hors production, des permissions limitées et une relecture humaine des modifications proposées.
L’objectif doit être simple : déterminer si le système réduit la coordination manuelle et aide l’équipe à accomplir un travail utile.
Inutile de l’adopter simplement parce qu’il est open source ou parce que les agents autonomes retiennent l’attention du secteur.
Pour conclure
Le Super-Agent open source de DeepSeek est une évolution intéressante du génie logiciel assisté par l’IA.
Plutôt que de se concentrer uniquement sur la qualité du code qu’écrit un agent, il explore la manière dont les agents peuvent rester connectés au workflow de développement d’une équipe, accepter des missions autorisées et continuer à travailler à mesure que de nouvelles informations arrivent.
Le projet publié reste expérimental, et sa fiabilité comme ses gains de productivité en conditions réelles restent à démontrer.
Pour les développeurs, l’enseignement principal est simple : les agents de codage deviennent capables de participer à une plus grande partie du processus de développement, mais une autonomie accrue exige aussi un contrôle attentif de ce qu’ils ont le droit de faire.
Le prototype de DeepSeek offre un moyen open source d’explorer cette direction.
Il vaut la peine de le comprendre dès aujourd’hui, même si la plupart des équipes d’ingénierie n’ont pas encore besoin de l’adopter.
Pour aller plus loin
Sources primaires consultées le 3 novembre 2026.
- DeepSeek, Super-Agent Prototype. Implémentation officielle, licence, périmètre et limites du prototype de recherche.
- DeepSeek, Domain Model. Relations entre événements de développement, tâches et sessions d’agent.
- DeepSeek, Authorization Rules. Demandes explicites, travail inféré et modes de politique.
- DeepSeek, Execution. Exécution, reprise et limites de sécurité.
- DeepSeek, Setup Guide. Prérequis d’installation et configuration pour l’expérimentation.