

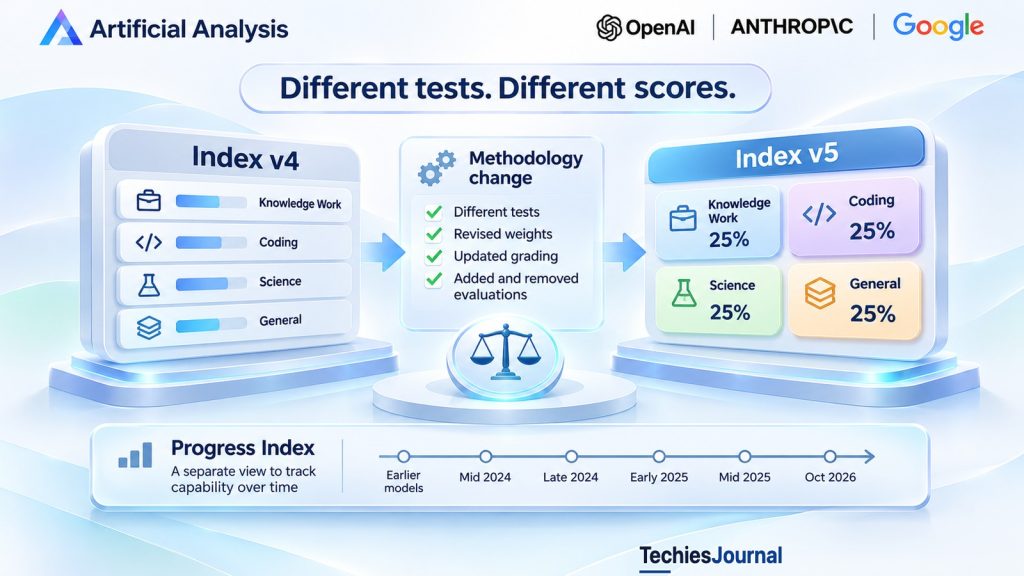
Artificial Analysis reconstruyó su Intelligence Index en octubre de 2026 y cambió las pruebas y los pesos que usa para comparar modelos de IA. La actualización explica por qué la puntuación de un modelo puede moverse aunque el propio modelo no haya cambiado.
Imagina que un equipo de desarrollo revisa dos informes de evaluación de un modelo de IA.
El primero da al modelo una puntuación de 55. Un informe más reciente da a la misma versión del modelo una puntuación de 50.
No necesariamente ha cambiado nada en el modelo, y sin embargo el equipo ve ahora un número más bajo.
¿Se ha vuelto menos capaz el modelo, o ha cambiado la forma de medirlo?
Estas cifras son hipotéticas. Ilustran una pregunta que cobró especial relevancia el 27 de octubre de 2026, cuando Artificial Analysis publicó la versión 5 de su Intelligence Index.
La organización cambió las evaluaciones que usa en su benchmark compuesto, introdujo pruebas nuevas, mejoró las existentes y revisó cómo contribuye cada capacidad a la puntuación final.
Según Artificial Analysis, el 60 % del peso del índice actualizado procede de evaluaciones que usan conjuntos de prueba privados o respuestas reservadas (held-out).
La empresa también introdujo un Progress Index independiente para estimar cómo han cambiado las capacidades de los modelos con el tiempo.
Estos cambios afectan a lo que representa una puntuación publicada.
Para quien elige modelos de IA, la distinción esencial es entre un cambio en el rendimiento del modelo y un cambio en la forma de medir ese rendimiento.
¿Qué cambió en el Intelligence Index v5?
El Intelligence Index de Artificial Analysis combina los resultados de varias evaluaciones en una sola puntuación compuesta.
La versión 5 organiza nueve evaluaciones en cuatro categorías con el mismo peso.
| Categoría | Peso en el índice | Evaluaciones |
|---|---|---|
| Trabajo del conocimiento | 25 % | AA-Briefcase, AutomationBench-AA, GDP.pdf |
| Programación | 25 % | FrontierCode 2.0, Terminal-Bench 4.0 |
| Ciencia | 25 % | Terminal-Bench-Science, CritPt v2 (subconjunto difícil) |
| General | 25 % | AA-Omniscience v1.1, HLE-Diamond |
Dentro de cada categoría, las evaluaciones individuales no tienen el mismo peso.
Por ejemplo, FrontierCode 2.0 aporta el 15 % del índice total, mientras que Terminal-Bench 4.0 aporta el 10 %.
Artificial Analysis describió la versión de octubre como su mayor actualización desde el lanzamiento de v4 en enero.
Se añadieron dos evaluaciones.
FrontierCode 2.0 pone a prueba agentes de programación con 132 tareas sobre repositorios de código abierto. Su evaluación tiene en cuenta si un mantenedor aceptaría el cambio, en lugar de basarse solo en si pasan las pruebas automatizadas. Una comprobación bloqueante fallida puede reducir a cero la puntuación de la tarea.
Terminal-Bench-Science introduce 70 tareas de investigación científica que se realizan en un entorno de terminal. Una tarea solo se supera cuando se superan todas las pruebas requeridas.
Se mejoraron tres evaluaciones.
HLE-Diamond sustituyó el componente original de Humanity’s Last Exam por un conjunto depurado de 1000 preguntas.
AA-Omniscience v1.1 revisó su conjunto de datos para eliminar preguntas públicas o saturadas y abordar elementos ambiguos o erróneos.
CritPt v2 entró en el índice mediante un subconjunto difícil y privado de 40 preguntas de una evaluación de física, con acceso a ejecución de código.
El índice compuesto también eliminó GDPval-AA v2.1, SciCode y AA-LCR v1.1.
Las consecuencias son técnicas, no estéticas. Una puntuación obtenida con v5 refleja un conjunto de tareas, unas condiciones de calificación y unos pesos distintos de los de la versión anterior.
Añadidas
FrontierCode 2.0 pone a prueba agentes de programación con 132 tareas sobre repositorios de código abierto. Su evaluación tiene en cuenta si un mantenedor aceptaría el cambio, en lugar de basarse solo en si pasan las pruebas automatizadas. Una comprobación bloqueante fallida puede reducir a cero la puntuación de la tarea.
Terminal-Bench-Science introduce 70 tareas de investigación científica que se realizan en un entorno de terminal. Una tarea solo se supera cuando se superan todas las pruebas requeridas.
Mejoradas
HLE-Diamond sustituyó el componente original de Humanity’s Last Exam por un conjunto depurado de 1000 preguntas.
AA-Omniscience v1.1 revisó su conjunto de datos para eliminar preguntas públicas o saturadas y abordar elementos ambiguos o erróneos.
CritPt v2 entró en el índice mediante un subconjunto difícil y privado de 40 preguntas de una evaluación de física, con acceso a ejecución de código.
Eliminadas
El índice compuesto también eliminó GDPval-AA v2.1, SciCode y AA-LCR v1.1.
Las consecuencias son técnicas, no estéticas. Una puntuación obtenida con v5 refleja un conjunto de tareas, unas condiciones de calificación y unos pesos distintos de los de la versión anterior.
¿Cómo puede el mismo modelo recibir una puntuación distinta?
Volvamos al equipo de desarrollo hipotético.
La versión de su modelo no ha cambiado, pero el conjunto de evaluaciones es distinto.
Un benchmark anterior podría dar prioridad a ejercicios de programación cortos. Uno más reciente podría dar más peso a modificar repositorios complejos y cumplir varias condiciones de aceptación.
Un modelo puede ser eficaz en el primer tipo de tarea y tener dificultades con el segundo.
Esa diferencia no representa necesariamente un deterioro de las capacidades subyacentes del modelo.
Puede representar un cambio en lo que el evaluador le pide al modelo que haga.
El método de calificación también importa.
Supón que un agente de programación completa la mayor parte de un cambio solicitado, pero no cumple un requisito crítico.
Una evaluación que otorgue puntuación parcial puede reconocer el trabajo bien hecho. Otra puede asignar cero porque el fallo hace que el cambio sea inaceptable.
FrontierCode 2.0 usa comprobaciones bloqueantes que pueden dar una puntuación de cero a un intento.
El rendimiento de un modelo con este criterio de aceptación más estricto dice algo útil sobre su comportamiento. No demuestra que su puntuación en una tarea anterior, calificada de otra manera, habría bajado.
La ponderación produce otro efecto.
Si un modelo es relativamente fuerte en ciencia pero más débil en programación sobre repositorios, aumentar la importancia de las tareas de programación puede cambiar su resultado compuesto.
Por eso un benchmark compuesto no debe entenderse como una medida permanente y universal de la inteligencia.
Resume el rendimiento en una selección concreta de tareas en unas condiciones de evaluación definidas.
La pregunta
Un equipo ve una puntuación de 55 en un informe de evaluación y de 50 en un informe más reciente para la misma versión del modelo. ¿Se ha vuelto menos capaz el modelo, o ha cambiado la forma de medirlo? Estas cifras son hipotéticas.
Combinación de tareas
Un benchmark anterior podría dar prioridad a ejercicios de programación cortos. Uno más reciente podría dar más peso a modificar repositorios complejos y cumplir varias condiciones de aceptación. Un modelo puede ser eficaz en el primer tipo de tarea y tener dificultades con el segundo. Eso no representa necesariamente un deterioro de las capacidades subyacentes del modelo.
Calificación
Una evaluación que otorgue puntuación parcial puede reconocer el trabajo bien hecho. Otra puede asignar cero porque falló un requisito crítico. FrontierCode 2.0 usa comprobaciones bloqueantes que pueden dar una puntuación de cero a un intento.
Pesos
Si un modelo es relativamente fuerte en ciencia pero más débil en programación sobre repositorios, aumentar la importancia de las tareas de programación puede cambiar su resultado compuesto.
¿Qué mejora una evaluación más privada?
Artificial Analysis indica que el 60 % del peso del índice v5 procede de evaluaciones que usan conjuntos de prueba privados o respuestas reservadas.
Esto responde a un problema real de la evaluación.
Los benchmarks públicos permiten a los investigadores examinar las preguntas, entender las reglas de calificación y reproducir los resultados.
Pero la disponibilidad pública también crea oportunidades para que el material de prueba aparezca en los datos de entrenamiento, en los prompts o en la retroalimentación del desarrollo del modelo.
Un modelo que ya conoce las preguntas de un benchmark puede rendir bien en parte por esa exposición previa, y no porque sepa resolver problemas desconocidos de igual dificultad.
Mantener privadas las tareas de prueba o las respuestas tiene como objetivo reducir ese riesgo.
FrontierCode 2.0 usa tareas de repositorios privados. AA-Omniscience v1.1 también elimina preguntas que la entidad que publica el benchmark describe como públicas o poco discriminantes.
Estas medidas pueden dificultar la exposición a respuestas conocidas.
Sin embargo, privado no significa inmune a la contaminación.
La metodología publicada explica las decisiones de diseño del evaluador. No demuestra de forma independiente que ningún modelo haya tenido contacto con material relacionado.
Las pruebas privadas también implican una contrapartida.
Cuando se ocultan las tareas y los detalles de calificación, los investigadores externos tienen menos información para reproducir o cuestionar resultados concretos.
Este enfoque puede reducir algunos riesgos de exposición, a la vez que aumenta la dependencia de la selección de tareas, la implementación de la calificación y los controles de calidad de quien publica el benchmark.
Ni un benchmark totalmente público ni uno parcialmente privado ofrecen automáticamente una medida completa de la fiabilidad de un modelo en el mundo real.
Mejoras
La disponibilidad pública crea oportunidades para que el material de prueba aparezca en los datos de entrenamiento, en los prompts o en la retroalimentación del desarrollo del modelo. Un modelo que ya conoce las preguntas de un benchmark puede rendir bien en parte por esa exposición previa. Mantener privadas las tareas de prueba o las respuestas tiene como objetivo reducir ese riesgo.
Costos
Cuando se ocultan las tareas y los detalles de calificación, los investigadores externos tienen menos información para reproducir o cuestionar resultados concretos. Este enfoque puede reducir algunos riesgos de exposición, a la vez que aumenta la dependencia de la selección de tareas, la implementación de la calificación y los controles de calidad de quien publica el benchmark.
Sin demostrar
Privado no significa inmune a la contaminación. La metodología publicada explica las decisiones de diseño del evaluador. No demuestra de forma independiente que ningún modelo haya tenido contacto con material relacionado.
Las tareas prácticas son útiles, pero siguen siendo una selección
El Intelligence Index v5 da un peso considerable a evaluaciones con herramientas, repositorios y trabajo de varios pasos.
Eso es útil porque muchas aplicaciones profesionales exigen algo más que producir una respuesta aislada.
Aun así, una evaluación que se parece al trabajo práctico no es automáticamente representativa del entorno de cada organización.
FrontierCode pone a prueba cambios en repositorios seleccionados. Un equipo de desarrollo que mantiene una aplicación empresarial privada puede tener otros lenguajes de programación, otra arquitectura, otras restricciones de seguridad y otros requisitos de revisión.
Terminal-Bench-Science pone a prueba flujos de trabajo de investigación en unas condiciones de terminal especificadas. No demuestra que un modelo pueda completar de forma fiable cualquier flujo de trabajo científico.
Artificial Analysis también describe su Intelligence Index como un índice principalmente basado en texto y en inglés. Publica los resultados multilingües más amplios y los de otras modalidades en evaluaciones separadas.
La distinción está entre medir las tareas elegidas y predecir el rendimiento en tareas ajenas a la evaluación.
Los cambios de octubre pueden mejorar la capacidad de quien publica el índice para distinguir entre los modelos actuales. Saber si predicen el éxito en una aplicación de negocio concreta exige evidencia adicional procedente de esa aplicación.
Por qué las puntuaciones de v4 y v5 no son directamente comparables
Una puntuación de benchmark solo tiene sentido dentro del método de medición que la produjo.
Cuando cambian la selección de tareas, las reglas de puntuación o los pesos, la escala numérica también puede cambiar.
Para el modelo hipotético cuya puntuación pasó de 55 a 50, hablar de una caída de capacidad de cinco puntos no estaría, por tanto, justificado.
La diferencia podría deberse a tareas más difíciles, ponderaciones distintas, una calificación más estricta o condiciones de evaluación modificadas.
Incluso un cambio en la clasificación puede reflejar que distintos modelos responden de forma distinta a la nueva combinación de tareas.
Artificial Analysis afirma que las sucesivas versiones del Intelligence Index no pretenden formar una única escala de capacidad a largo plazo directamente comparable.
Una puntuación del Intelligence Index v5 describe el rendimiento dentro del marco de v5.
Una puntuación anterior de v4 describe el rendimiento dentro del marco anterior.
Ambas pueden ser útiles sin que sea adecuado restarlas directamente.
Fuente: Artificial Analysis, Progress Index v1 Methodology, octubre de 2026
¿Qué mide el Progress Index, un índice aparte?
Para abordar las comparaciones históricas, Artificial Analysis presentó el Progress Index v1 junto con la actualización de octubre.
El Intelligence Index y el Progress Index tienen propósitos distintos.
El Intelligence Index está diseñado para comparar los modelos actuales con tareas seleccionadas para representar las capacidades contemporáneas.
Su composición puede cambiar cuando los modelos mejoran y las evaluaciones antiguas dejan de distinguir entre ellos.
El Progress Index, en cambio, intenta estimar la capacidad de los modelos a lo largo del tiempo en una escala estadística compartida.
Usa un método llamado teoría de respuesta al ítem.
La idea central es estimar a la vez la capacidad del modelo y la dificultad de la tarea.
Un modelo que tiene éxito en tareas relativamente difíciles aporta una evidencia distinta de la de otro que solo tiene éxito en tareas más fáciles.
El método estadístico tiene en cuenta esos resultados al estimar dónde se sitúa cada modelo en una escala común.
Es importante señalar que no todos los modelos necesitan completar exactamente las mismas tareas.
Artificial Analysis conecta los benchmarks mediante modelos que se han evaluado en varios benchmarks. Usa los resultados de cada tarea cuando hay datos adecuados y, en caso contrario, los resultados agregados del benchmark.
Esos resultados de modelos que se solapan ayudan a situar las evaluaciones antiguas y las nuevas en la escala estimada compartida.
Esto es más adecuado para estudiar tendencias históricas que restar puntuaciones de distintas versiones del Intelligence Index.
Pero sigue siendo una estimación.
Las posiciones resultantes dependen de los datos de evaluación disponibles, del modelo estadístico y de sus supuestos. No equivalen a observar cómo cada modelo completa un conjunto idéntico de tareas en condiciones idénticas.
A la vez
El Progress Index usa un método llamado teoría de respuesta al ítem. La idea central es estimar a la vez la capacidad del modelo y la dificultad de la tarea. Un modelo que tiene éxito en tareas relativamente difíciles aporta una evidencia distinta de la de otro que solo tiene éxito en tareas más fáciles.
No las mismas tareas
No todos los modelos necesitan completar exactamente las mismas tareas.
Enlazados
Artificial Analysis conecta los benchmarks mediante modelos que se han evaluado en varios benchmarks. Usa los resultados de cada tarea cuando hay datos adecuados y, en caso contrario, los resultados agregados del benchmark. Esos resultados de modelos que se solapan ayudan a situar las evaluaciones antiguas y las nuevas en la escala estimada compartida.
Una estimación
Sigue siendo una estimación. Las posiciones resultantes dependen de los datos de evaluación disponibles, del modelo estadístico y de sus supuestos. No equivalen a observar cómo cada modelo completa un conjunto idéntico de tareas en condiciones idénticas.
Artificial Analysis recomienda el Intelligence Index para comparar los modelos actuales y el Progress Index para examinar la capacidad a lo largo del tiempo.
Fuente: Artificial Analysis, Progress Index v1 Methodology, octubre de 2026
La configuración del modelo también puede cambiar el resultado
La metodología del benchmark no es la única variable que importa.
El mismo modelo puede evaluarse con distintos niveles de esfuerzo de razonamiento.
En su anuncio del 27 de octubre, Artificial Analysis publicó que Claude Opus 5.5 obtuvo 35 con esfuerzo bajo y 58 con esfuerzo máximo.
El costo estimado por tarea del Intelligence Index también subió de 0.98 dólares a 10.04 dólares.
Son resultados publicados por Artificial Analysis, no mediciones reproducidas de forma independiente por TechiesJournal.
Esfuerzo bajo
En su anuncio del 27 de octubre, Artificial Analysis publicó que Claude Opus 5.5 obtuvo 35 con esfuerzo bajo. El costo estimado por tarea del Intelligence Index fue de 0.98 dólares.
Esfuerzo máximo
Con esfuerzo máximo, el mismo modelo obtuvo 58, y el costo estimado por tarea del Intelligence Index subió a 10.04 dólares.
Por qué importa
Son resultados publicados por Artificial Analysis, no mediciones reproducidas de forma independiente por TechiesJournal. Una puntuación de benchmark corresponde a una versión del modelo y a su configuración de evaluación, y no solo al nombre de un producto. Una puntuación más alta puede ser valiosa, pero el cómputo y el costo adicionales importan al evaluar la idoneidad operativa.
Ilustran por qué una puntuación de benchmark corresponde a una versión del modelo y a su configuración de evaluación, y no solo al nombre de un producto.
Las herramientas disponibles, los prompts, los niveles de esfuerzo y las condiciones de ejecución pueden influir en el rendimiento observado.
Una puntuación más alta puede ser valiosa, pero el cómputo y el costo adicionales importan al evaluar la idoneidad operativa.
¿Cómo debería usar un equipo un benchmark revisado?
Un equipo de desarrollo que revisa una nueva clasificación de modelos debería aclarar cuatro cosas antes de considerar significativo un cambio de puntuación.
Primero, comprueba la versión del benchmark. Las puntuaciones de distintas versiones de la metodología pueden no ser directamente comparables.
Segundo, examina qué mide la evaluación. Identifica las tareas, las condiciones de calificación y los pesos, y después valora hasta qué punto se parecen a la aplicación que el equipo tiene prevista.
Tercero, comprueba la configuración del modelo. No se debe suponer que un resultado obtenido con el máximo esfuerzo de razonamiento describe un despliegue más barato y de menor esfuerzo.
Cuarto, elige la comparación adecuada. Usa una evaluación de la versión actual para comparar modelos en las condiciones de esa evaluación. Usa una metodología histórica documentada, como el Progress Index, cuando estudies tendencias a más largo plazo.
Versión
Comprueba la versión del benchmark. Las puntuaciones de distintas versiones de la metodología pueden no ser directamente comparables.
Qué mide
Examina qué mide la evaluación. Identifica las tareas, las condiciones de calificación y los pesos, y después valora hasta qué punto se parecen a la aplicación que el equipo tiene prevista.
Configuración
Comprueba la configuración del modelo. No se debe suponer que un resultado obtenido con el máximo esfuerzo de razonamiento describe un despliegue más barato y de menor esfuerzo.
Comparación
Elige la comparación adecuada. Usa una evaluación de la versión actual para comparar modelos en las condiciones de esa evaluación. Usa una metodología histórica documentada, como el Progress Index, cuando estudies tendencias a más largo plazo.
Las evaluaciones públicas pueden ayudar a un equipo a decidir qué modelos merecen más pruebas.
La decisión operativa final también debería tener en cuenta tareas representativas, la gravedad de los fallos, la consistencia, el costo, la latencia y las restricciones propias de la organización.
Son tipos de evidencia complementarios.
El benchmark cambió. ¿Qué debería cambiar en la decisión?
El Artificial Analysis Intelligence Index v5 es una revisión sustancial de la metodología.
Cambia la combinación de capacidades evaluadas, introduce evaluaciones de tareas más estrictas, revisa los pesos y aumenta la dependencia de material de evaluación privado o reservado.
Esas decisiones pueden hacer que el índice sea más informativo sobre las capacidades que quien lo publica quiere medir hoy. No demuestran que prediga con más precisión todas las cargas de trabajo en producción.
El Progress Index, que es independiente, responde a otra pregunta: estima la capacidad histórica en una escala compartida, con las limitaciones propias de la estimación estadística.
Para los equipos que eligen modelos de IA, una puntuación que cambia debería llevar a revisar las condiciones de medición antes de sacar conclusiones sobre el progreso o el deterioro del modelo.
Un resultado de benchmark nos dice cómo rindió un modelo en unas condiciones definidas. Un cambio en ese resultado no nos dice por qué cambió hasta que se entienden esas condiciones.
Referencias y lecturas adicionales
- Artificial Analysis, Announcing Artificial Analysis Intelligence Index v5. 27 de octubre de 2026. Anuncio principal de las nuevas evaluaciones, las revisiones y los pesos actualizados.
- Artificial Analysis, Intelligence Benchmarking Methodology. Versión 5.0.1 mostrada durante la revisión del 3 de noviembre de 2026.
- Artificial Analysis, Progress Index v1 Methodology. Octubre de 2026. Enfoque estadístico para estimar la capacidad a partir de distintos conjuntos de evaluación.
- TechiesJournal, Benchmark Theatre: How to Read AI Model Claims (en inglés). Septiembre de 2026. Lectura relacionada sobre cómo interpretar las afirmaciones de los benchmarks y elegir modelos.
Fecha de corte de la evidencia: 3 de noviembre de 2026. La metodología, la lista de evaluaciones y las clasificaciones publicadas pueden cambiar. Este artículo describe la versión v5 del 27 de octubre e identifica la versión de la metodología visible durante la revisión.