

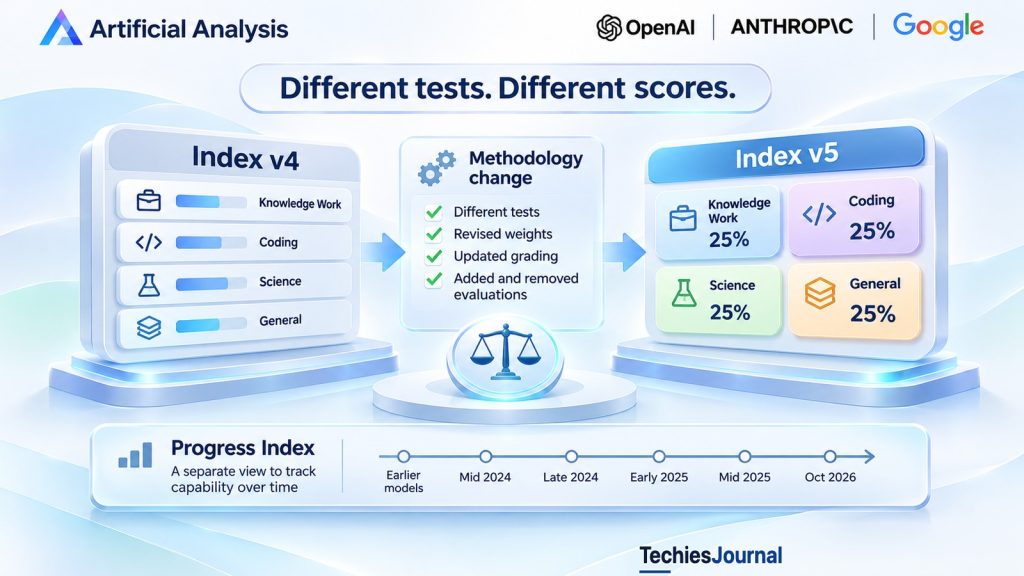
Artificial Analysis అక్టోబర్ 2026లో తన Intelligence Index (సంయుక్త బెంచ్మార్క్ సూచిక)ను పునర్నిర్మించింది, AI మోడళ్లను పోల్చడానికి వాడే టెస్ట్లను, వెయిటేజీలను మార్చింది. మోడల్ స్వయంగా మారకపోయినా దాని స్కోర్ ఎందుకు మారవచ్చో ఈ అప్డేట్ వివరిస్తుంది.
ఒక డెవలప్మెంట్ బృందం రెండు AI మోడల్ మూల్యాంకన నివేదికలను పరిశీలిస్తోందని ఊహించుకోండి.
మొదటి నివేదిక ఒక మోడల్కు 55 స్కోర్ ఇస్తుంది. కొత్త నివేదిక అదే మోడల్ వెర్షన్కు 50 స్కోర్ ఇస్తుంది.
మోడల్లో ఏదీ తప్పనిసరిగా మారి ఉండాల్సిన అవసరం లేదు, అయినా బృందానికి ఇప్పుడు తక్కువ సంఖ్య కనిపిస్తోంది.
మోడల్ సామర్థ్యం తగ్గిందా, లేక కొలత మారిందా?
ఈ సంఖ్యలు ఊహాత్మకమైనవి. అక్టోబర్ 27, 2026న Artificial Analysis తన Intelligence Index వెర్షన్ 5ను విడుదల చేసినప్పుడు ప్రత్యేకంగా ప్రాధాన్యం సంతరించుకున్న ఒక ప్రశ్నను అవి వివరిస్తాయి.
ఆ సంస్థ తన సంయుక్త బెంచ్మార్క్లో వాడే మూల్యాంకనాలను మార్చింది, కొత్త టెస్ట్లను ప్రవేశపెట్టింది, ఉన్నవాటిని అప్గ్రేడ్ చేసింది, తుది స్కోర్కు సామర్థ్యాలు ఎలా దోహదపడతాయో సవరించింది.
Artificial Analysis ప్రకారం, అప్డేట్ చేసిన ఇండెక్స్ వెయిటేజీలో 60% ప్రైవేట్ టెస్ట్ సెట్లు లేదా బయటకు వెల్లడించని (held-out) సమాధానాలను వాడే మూల్యాంకనాల నుండి వస్తుంది.
కాలక్రమేణా మోడల్ సామర్థ్యాలు ఎలా మారాయో అంచనా వేయడానికి ఆ కంపెనీ ఒక ప్రత్యేక Progress Indexను కూడా ప్రవేశపెట్టింది.
నివేదించిన స్కోర్ దేనిని సూచిస్తుందనే దానిపై ఈ మార్పులు ప్రభావం చూపుతాయి.
AI మోడళ్లను ఎంచుకునే ఎవరికైనా ముఖ్యమైన తేడా ఇది: మోడల్ పనితీరులో మార్పు ఒకటి, ఆ పనితీరును కొలిచే విధానంలో మార్పు మరొకటి.
Intelligence Index v5లో ఏం మారింది?
Artificial Analysis Intelligence Index అనేక మూల్యాంకనాల ఫలితాలను ఒకే సంయుక్త స్కోర్గా కలుపుతుంది.
వెర్షన్ 5 తొమ్మిది మూల్యాంకనాలను సమాన వెయిటేజీ ఉన్న నాలుగు వర్గాలుగా విభజిస్తుంది.
| వర్గం | ఇండెక్స్ వెయిటేజీ | మూల్యాంకనాలు |
|---|---|---|
| జ్ఞాన ఆధారిత పని | 25% | AA-Briefcase, AutomationBench-AA, GDP.pdf |
| కోడింగ్ | 25% | FrontierCode 2.0, Terminal-Bench 4.0 |
| సైన్స్ | 25% | Terminal-Bench-Science, CritPt v2 కఠిన ఉపసమితి |
| సాధారణం | 25% | AA-Omniscience v1.1, HLE-Diamond |
ప్రతి వర్గంలోని ఒక్కో మూల్యాంకనానికి సమాన వెయిటేజీ ఉండదు.
ఉదాహరణకు, మొత్తం ఇండెక్స్లో FrontierCode 2.0 వాటా 15%, Terminal-Bench 4.0 వాటా 10%.
జనవరిలో v4 ప్రారంభమైనప్పటి నుండి ఇదే తన అతిపెద్ద అప్గ్రేడ్ అని అక్టోబర్ విడుదల గురించి Artificial Analysis వర్ణించింది.
రెండు మూల్యాంకనాలు కొత్తగా చేరాయి.
FrontierCode 2.0 ఓపెన్-సోర్స్ రిపోజిటరీలకు సంబంధించిన 132 టాస్క్లపై కోడింగ్ ఏజెంట్లను పరీక్షిస్తుంది. ఆటోమేటెడ్ టెస్ట్లు పాస్ అయ్యాయా అనే దానిపై మాత్రమే ఆధారపడకుండా, ఒక మెయింటెయినర్ ఆ మార్పును అంగీకరిస్తారా అనే దాన్ని దీని అసెస్మెంట్ పరిగణిస్తుంది. ఒక బ్లాకింగ్ చెక్ విఫలమైతే టాస్క్ స్కోర్ సున్నాకు పడిపోవచ్చు.
Terminal-Bench-Science టెర్మినల్ వాతావరణం ద్వారా నిర్వహించే 70 శాస్త్రీయ పరిశోధన టాస్క్లను ప్రవేశపెడుతుంది. అవసరమైన ప్రతి టెస్ట్ పాస్ అయినప్పుడు మాత్రమే ఒక టాస్క్ పాస్ అవుతుంది.
మూడు మూల్యాంకనాలు అప్గ్రేడ్ అయ్యాయి.
HLE-Diamond అసలు Humanity’s Last Exam భాగం స్థానంలో 1,000 ప్రశ్నలతో మెరుగుపరిచిన సెట్ను తీసుకొచ్చింది.
AA-Omniscience v1.1 పబ్లిక్ లేదా సంతృప్తమైన (saturated) ప్రశ్నలను తొలగించడానికి, అస్పష్టమైన లేదా తప్పులున్న అంశాలను సరిచేయడానికి తన డేటాసెట్ను సవరించింది.
CritPt v2 ఒక ఫిజిక్స్ మూల్యాంకనం నుండి తీసిన 40 ప్రశ్నల ప్రైవేట్ కఠిన ఉపసమితి ద్వారా, కోడ్ ఎగ్జిక్యూషన్ యాక్సెస్తో ఇండెక్స్లో చేరింది.
సంయుక్త ఇండెక్స్ నుండి GDPval-AA v2.1, SciCode, AA-LCR v1.1లను కూడా తొలగించారు.
దీని పర్యవసానాలు సాంకేతికమైనవి, పైపై మార్పులు కావు. v5 ఇచ్చే స్కోర్, మునుపటి వెర్షన్తో పోలిస్తే వేరే టాస్క్ల సమాహారాన్ని, గ్రేడింగ్ పరిస్థితులను, వెయిటేజీలను ప్రతిబింబిస్తుంది.
చేర్చినవి
FrontierCode 2.0 ఓపెన్-సోర్స్ రిపోజిటరీలకు సంబంధించిన 132 టాస్క్లపై కోడింగ్ ఏజెంట్లను పరీక్షిస్తుంది. ఆటోమేటెడ్ టెస్ట్లు పాస్ అయ్యాయా అనే దానిపై మాత్రమే ఆధారపడకుండా, ఒక మెయింటెయినర్ ఆ మార్పును అంగీకరిస్తారా అనే దాన్ని దీని అసెస్మెంట్ పరిగణిస్తుంది. ఒక బ్లాకింగ్ చెక్ విఫలమైతే టాస్క్ స్కోర్ సున్నాకు పడిపోవచ్చు.
Terminal-Bench-Science టెర్మినల్ వాతావరణం ద్వారా నిర్వహించే 70 శాస్త్రీయ పరిశోధన టాస్క్లను ప్రవేశపెడుతుంది. అవసరమైన ప్రతి టెస్ట్ పాస్ అయినప్పుడు మాత్రమే ఒక టాస్క్ పాస్ అవుతుంది.
అప్గ్రేడ్
HLE-Diamond అసలు Humanity’s Last Exam భాగం స్థానంలో 1,000 ప్రశ్నలతో మెరుగుపరిచిన సెట్ను తీసుకొచ్చింది.
AA-Omniscience v1.1 పబ్లిక్ లేదా సంతృప్తమైన (saturated) ప్రశ్నలను తొలగించడానికి, అస్పష్టమైన లేదా తప్పులున్న అంశాలను సరిచేయడానికి తన డేటాసెట్ను సవరించింది.
CritPt v2 ఒక ఫిజిక్స్ మూల్యాంకనం నుండి తీసిన 40 ప్రశ్నల ప్రైవేట్ కఠిన ఉపసమితి ద్వారా, కోడ్ ఎగ్జిక్యూషన్ యాక్సెస్తో ఇండెక్స్లో చేరింది.
తొలగించినవి
సంయుక్త ఇండెక్స్ నుండి GDPval-AA v2.1, SciCode, AA-LCR v1.1లను కూడా తొలగించారు.
దీని పర్యవసానాలు సాంకేతికమైనవి, పైపై మార్పులు కావు. v5 ఇచ్చే స్కోర్, మునుపటి వెర్షన్తో పోలిస్తే వేరే టాస్క్ల సమాహారాన్ని, గ్రేడింగ్ పరిస్థితులను, వెయిటేజీలను ప్రతిబింబిస్తుంది.
మూలం: Artificial Analysis, Announcing Artificial Analysis Intelligence Index v5, అక్టోబర్ 27, 2026
ఒకే మోడల్కు వేరే స్కోర్ ఎలా రావచ్చు?
ఊహాత్మక డెవలప్మెంట్ బృందం దగ్గరకు మళ్లీ వెళ్దాం.
దాని మోడల్ వెర్షన్ మారలేదు, కానీ మూల్యాంకన సూట్ వేరు.
పాత బెంచ్మార్క్ చిన్న కోడింగ్ అభ్యాసాలకు ప్రాధాన్యం ఇవ్వవచ్చు. కొత్త బెంచ్మార్క్ సంక్లిష్టమైన రిపోజిటరీలను మార్చడానికి, అనేక అంగీకార షరతులను నెరవేర్చడానికి ఎక్కువ వెయిటేజీ ఇవ్వవచ్చు.
ఒక మోడల్ మొదటి రకం టాస్క్లో సమర్థంగా ఉండి, రెండో రకంలో ఇబ్బంది పడవచ్చు.
ఆ తేడా తప్పనిసరిగా మోడల్ అంతర్లీన సామర్థ్యాలలో క్షీణతను సూచించదు.
మూల్యాంకనం చేసేవారు మోడల్ను ఏం చేయమని అడుగుతున్నారో అందులో వచ్చిన మార్పును అది సూచించవచ్చు.
గ్రేడింగ్ పద్ధతి కూడా ముఖ్యమే.
ఒక కోడింగ్ ఏజెంట్ అడిగిన మార్పులో ఎక్కువ భాగం పూర్తి చేసి, ఒక కీలకమైన అవసరాన్ని మాత్రం నెరవేర్చలేకపోయిందని అనుకుందాం.
పాక్షిక క్రెడిట్ ఇచ్చే మూల్యాంకనం విజయవంతంగా చేసిన పనిని గుర్తించవచ్చు. ఆ వైఫల్యం వల్ల మార్పు ఆమోదయోగ్యం కాదు కాబట్టి మరో మూల్యాంకనం సున్నా ఇవ్వవచ్చు.
FrontierCode 2.0 ఒక ప్రయత్నానికి సున్నా స్కోర్ ఇవ్వగల బ్లాకింగ్ చెక్లను వాడుతుంది.
ఈ కఠినమైన అంగీకార ప్రమాణం కింద మోడల్ పనితీరు దాని ప్రవర్తన గురించి పాఠకులకు ఉపయోగకరమైన విషయం చెబుతుంది. అంతకుముందు, వేరే విధంగా గ్రేడ్ చేసిన టాస్క్పై దాని స్కోర్ తగ్గి ఉండేదని అది నిరూపించదు.
వెయిటేజీ మరో ప్రభావాన్ని కలిగిస్తుంది.
ఒక మోడల్ సైన్స్లో సాపేక్షంగా బలంగా ఉండి, రిపోజిటరీ ఆధారిత కోడింగ్లో బలహీనంగా ఉంటే, కోడింగ్ టాస్క్ల ప్రాముఖ్యతను పెంచడం దాని సంయుక్త ఫలితాన్ని మార్చగలదు.
అందుకే సంయుక్త బెంచ్మార్క్ను మేధస్సుకు శాశ్వతమైన, సార్వత్రిక కొలతగా అర్థం చేసుకోకూడదు.
నిర్దేశిత మూల్యాంకన పరిస్థితుల్లో, ఎంచుకున్న ఒక నిర్దిష్ట టాస్క్ల సమితిపై పనితీరును అది సంగ్రహిస్తుంది.
ప్రశ్న
ఒకే మోడల్ వెర్షన్కు ఒక మూల్యాంకన నివేదికలో 55, కొత్త నివేదికలో 50 స్కోర్ను ఒక బృందం చూస్తుంది. మోడల్ సామర్థ్యం తగ్గిందా, లేక కొలత మారిందా? ఈ సంఖ్యలు ఊహాత్మకమైనవి.
టాస్క్ మిశ్రమం
పాత బెంచ్మార్క్ చిన్న కోడింగ్ అభ్యాసాలకు ప్రాధాన్యం ఇవ్వవచ్చు. కొత్త బెంచ్మార్క్ సంక్లిష్టమైన రిపోజిటరీలను మార్చడానికి, అనేక అంగీకార షరతులను నెరవేర్చడానికి ఎక్కువ వెయిటేజీ ఇవ్వవచ్చు. ఒక మోడల్ మొదటి రకం టాస్క్లో సమర్థంగా ఉండి, రెండో రకంలో ఇబ్బంది పడవచ్చు. అది తప్పనిసరిగా మోడల్ అంతర్లీన సామర్థ్యాలలో క్షీణతను సూచించదు.
గ్రేడింగ్
పాక్షిక క్రెడిట్ ఇచ్చే మూల్యాంకనం విజయవంతంగా చేసిన పనిని గుర్తించవచ్చు. ఒక కీలకమైన అవసరం విఫలమైనందున మరో మూల్యాంకనం సున్నా ఇవ్వవచ్చు. FrontierCode 2.0 ఒక ప్రయత్నానికి సున్నా స్కోర్ ఇవ్వగల బ్లాకింగ్ చెక్లను వాడుతుంది.
వెయిటేజీలు
ఒక మోడల్ సైన్స్లో సాపేక్షంగా బలంగా ఉండి, రిపోజిటరీ ఆధారిత కోడింగ్లో బలహీనంగా ఉంటే, కోడింగ్ టాస్క్ల ప్రాముఖ్యతను పెంచడం దాని సంయుక్త ఫలితాన్ని మార్చగలదు.
మరింత ప్రైవేట్ మూల్యాంకనం దేనిని మెరుగుపరుస్తుంది?
v5 ఇండెక్స్ వెయిటేజీలో 60% ప్రైవేట్ టెస్ట్ సెట్లు లేదా బయటకు వెల్లడించని సమాధానాలను వాడే మూల్యాంకనాల నుండి వస్తుందని Artificial Analysis నివేదిస్తోంది.
ఇది మూల్యాంకనంలోని ఒక నిజమైన సమస్యను పరిష్కరిస్తుంది.
పబ్లిక్ బెంచ్మార్క్లు పరిశోధకులకు ప్రశ్నలను పరిశీలించడానికి, గ్రేడింగ్ నియమాలను అర్థం చేసుకోవడానికి, ఫలితాలను పునరుత్పత్తి చేయడానికి వీలు కల్పిస్తాయి.
కానీ పబ్లిక్గా అందుబాటులో ఉండటం వల్ల టెస్ట్ మెటీరియల్ ట్రైనింగ్ డేటాలో, ప్రాంప్ట్లలో లేదా మోడల్ అభివృద్ధి ఫీడ్బ్యాక్లో కనిపించే అవకాశాలు కూడా ఏర్పడతాయి.
బెంచ్మార్క్ ప్రశ్నలు ముందే పరిచయమున్న మోడల్, అంతే కష్టమైన కొత్త సమస్యలను పరిష్కరించగలగడం వల్ల కాకుండా, పాక్షికంగా ముందస్తు ఎక్స్పోజర్ వల్ల బాగా రాణించవచ్చు.
టెస్ట్ టాస్క్లను లేదా సమాధానాలను ప్రైవేట్గా ఉంచడం ఆ రిస్క్ను తగ్గించడానికి ఉద్దేశించినది.
FrontierCode 2.0 ప్రైవేట్ రిపోజిటరీ టాస్క్లను వాడుతుంది. పబ్లిషర్ పబ్లిక్ లేదా తగినంతగా వేరు చేయలేనివిగా వర్ణించిన ప్రశ్నలను AA-Omniscience v1.1 కూడా తొలగిస్తుంది.
ఈ చర్యలు, తెలిసిన సమాధానాలు మోడల్కు చేరడాన్ని మరింత కష్టతరం చేయవచ్చు.
అయితే, ప్రైవేట్ అంటే కాంటామినేషన్ ఉండదని హామీ కాదు.
ప్రచురించిన మెథడాలజీ మూల్యాంకనం చేసేవారి డిజైన్ ఎంపికలను వివరిస్తుంది. సంబంధిత మెటీరియల్ ఏ మోడల్కూ ఎదురుకాలేదని అది స్వతంత్రంగా నిరూపించదు.
ప్రైవేట్ టెస్ట్లు ఒక ట్రేడ్-ఆఫ్ను కూడా సృష్టిస్తాయి.
టాస్క్లు, గ్రేడింగ్ వివరాలను బయటపెట్టనప్పుడు, ఒక్కో ఫలితాన్ని పునరుత్పత్తి చేయడానికి లేదా సవాలు చేయడానికి బయటి పరిశోధకులకు తక్కువ సమాచారం ఉంటుంది.
ఈ విధానం కొన్ని ఎక్స్పోజర్ రిస్క్లను తగ్గించగలదు, అదే సమయంలో బెంచ్మార్క్ పబ్లిషర్ టాస్క్ ఎంపిక, గ్రేడింగ్ అమలు, నాణ్యత నియంత్రణలపై ఆధారపడటాన్ని పెంచుతుంది.
పూర్తిగా పబ్లిక్ బెంచ్మార్క్ గానీ, పాక్షికంగా ప్రైవేట్ బెంచ్మార్క్ గానీ వాస్తవ ప్రపంచంలో మోడల్ విశ్వసనీయతకు పూర్తి కొలతను స్వయంచాలకంగా అందించదు.
మెరుగుపరిచేది
పబ్లిక్గా అందుబాటులో ఉండటం వల్ల టెస్ట్ మెటీరియల్ ట్రైనింగ్ డేటాలో, ప్రాంప్ట్లలో లేదా మోడల్ అభివృద్ధి ఫీడ్బ్యాక్లో కనిపించే అవకాశాలు ఏర్పడతాయి. బెంచ్మార్క్ ప్రశ్నలు ముందే పరిచయమున్న మోడల్ పాక్షికంగా ముందస్తు ఎక్స్పోజర్ వల్ల బాగా రాణించవచ్చు. టెస్ట్ టాస్క్లను లేదా సమాధానాలను ప్రైవేట్గా ఉంచడం ఆ రిస్క్ను తగ్గించడానికి ఉద్దేశించినది.
మూల్యం
టాస్క్లు, గ్రేడింగ్ వివరాలను బయటపెట్టనప్పుడు, ఒక్కో ఫలితాన్ని పునరుత్పత్తి చేయడానికి లేదా సవాలు చేయడానికి బయటి పరిశోధకులకు తక్కువ సమాచారం ఉంటుంది. ఈ విధానం కొన్ని ఎక్స్పోజర్ రిస్క్లను తగ్గించగలదు, అదే సమయంలో బెంచ్మార్క్ పబ్లిషర్ టాస్క్ ఎంపిక, గ్రేడింగ్ అమలు, నాణ్యత నియంత్రణలపై ఆధారపడటాన్ని పెంచుతుంది.
నిరూపించనిది
ప్రైవేట్ అంటే కాంటామినేషన్ ఉండదని హామీ కాదు. ప్రచురించిన మెథడాలజీ మూల్యాంకనం చేసేవారి డిజైన్ ఎంపికలను వివరిస్తుంది. సంబంధిత మెటీరియల్ ఏ మోడల్కూ ఎదురుకాలేదని అది స్వతంత్రంగా నిరూపించదు.
ఆచరణాత్మక టాస్క్లు ఉపయోగకరమే, కానీ అవీ ఎంపిక చేసినవే
Intelligence Index v5 టూల్స్, రిపోజిటరీలు, బహుళ దశల పనితో కూడిన మూల్యాంకనాలకు గణనీయమైన వెయిటేజీ ఇస్తుంది.
అది ఉపయోగకరం, ఎందుకంటే అనేక వృత్తిపరమైన అప్లికేషన్లకు ఒక విడి సమాధానం ఇవ్వడం కంటే ఎక్కువ అవసరం.
అయినప్పటికీ, ఆచరణాత్మక పనిని పోలిన మూల్యాంకనం ప్రతి సంస్థ వాతావరణానికి స్వయంచాలకంగా ప్రాతినిధ్యం వహించదు.
FrontierCode ఎంచుకున్న రిపోజిటరీలలో మార్పులను పరీక్షిస్తుంది. ఒక ప్రైవేట్ ఎంటర్ప్రైజ్ అప్లికేషన్ను నిర్వహించే డెవలప్మెంట్ బృందానికి వేరే ప్రోగ్రామింగ్ భాషలు, ఆర్కిటెక్చర్, సెక్యూరిటీ పరిమితులు, రివ్యూ అవసరాలు ఉండవచ్చు.
Terminal-Bench-Science నిర్దేశిత టెర్మినల్ పరిస్థితుల్లో పరిశోధన వర్క్ఫ్లోలను పరీక్షిస్తుంది. ఒక మోడల్ ప్రతి శాస్త్రీయ వర్క్ఫ్లోనూ విశ్వసనీయంగా పూర్తి చేయగలదని అది నిరూపించదు.
Artificial Analysis తన Intelligence Indexను ప్రధానంగా టెక్స్ట్ ఆధారితమైనదిగా, ఇంగ్లీష్ భాషకు సంబంధించినదిగా కూడా వర్ణిస్తుంది. విస్తృత బహుభాషా సామర్థ్యాలను, ఇతర మోడాలిటీలను అది వేర్వేరు మూల్యాంకనాల ద్వారా నివేదిస్తుంది.
ఎంచుకున్న టాస్క్లను కొలవడం ఒకటి, మూల్యాంకనం పరిధికి వెలుపలి టాస్క్లపై పనితీరును అంచనా వేయడం మరొకటి.
అక్టోబర్ మార్పులు ప్రస్తుత మోడళ్ల మధ్య తేడాను గుర్తించే పబ్లిషర్ సామర్థ్యాన్ని మెరుగుపరచవచ్చు. ఒక నిర్దిష్ట వ్యాపార అప్లికేషన్లో విజయాన్ని అవి ముందే సూచిస్తాయా అని తెలుసుకోవడానికి ఆ అప్లికేషన్ నుండే అదనపు ఆధారాలు అవసరం.
v4, v5 స్కోర్లను నేరుగా ఎందుకు పోల్చలేము
ఒక బెంచ్మార్క్ స్కోర్కు దాన్ని ఉత్పత్తి చేసిన కొలత పద్ధతి పరిధిలో మాత్రమే అర్థం ఉంటుంది.
టాస్క్ ఎంపిక, స్కోరింగ్ నియమాలు లేదా వెయిటేజీలు మారినప్పుడు, సంఖ్యాత్మక స్కేల్ కూడా మారవచ్చు.
అందువల్ల, స్కోర్ 55 నుండి 50కి మారిన ఊహాత్మక మోడల్ విషయంలో, దాన్ని ఐదు పాయింట్ల సామర్థ్య క్షీణతగా నివేదించడానికి ఆధారం లేదు.
ఆ తేడా కష్టమైన టాస్క్లు, వేరే వెయిటేజీలు, కఠినమైన గ్రేడింగ్ లేదా మారిన మూల్యాంకన పరిస్థితుల వల్ల రావచ్చు.
ర్యాంకింగ్లో మార్పు కూడా, సవరించిన టాస్క్ మిశ్రమానికి వేర్వేరు మోడళ్లు వేర్వేరుగా స్పందిస్తాయనే వాస్తవాన్ని ప్రతిబింబించవచ్చు.
వరుస Intelligence Index వెర్షన్లు నేరుగా పోల్చదగిన ఒకే దీర్ఘకాలిక సామర్థ్య స్కేల్ను ఏర్పరచడానికి ఉద్దేశించినవి కావని Artificial Analysis పేర్కొంటోంది.
Intelligence Index v5 స్కోర్ v5 ఫ్రేమ్వర్క్ కింద పనితీరును వర్ణిస్తుంది.
అంతకుముందు v4 స్కోర్ అంతకుముందు ఫ్రేమ్వర్క్ కింద పనితీరును వర్ణిస్తుంది.
రెండూ ఉపయోగకరంగా ఉండవచ్చు, కానీ ఒకదాని నుండి మరొకదాన్ని నేరుగా తీసివేయడానికి తగినవి కావు.
మూలం: Artificial Analysis, Progress Index v1 Methodology, అక్టోబర్ 2026
ప్రత్యేక Progress Index దేనిని కొలుస్తుంది?
చారిత్రక పోలికల కోసం, Artificial Analysis అక్టోబర్ అప్డేట్తో పాటు Progress Index v1ను ప్రవేశపెట్టింది.
Intelligence Index, Progress Index వేర్వేరు ప్రయోజనాల కోసం ఉన్నాయి.
ప్రస్తుత సామర్థ్యాలకు ప్రాతినిధ్యం వహించేలా ఎంచుకున్న టాస్క్లపై ప్రస్తుత మోడళ్లను పోల్చడానికి Intelligence Indexను రూపొందించారు.
మోడళ్లు మెరుగుపడి, పాత మూల్యాంకనాలు వాటి మధ్య తేడాను చూపలేకపోయినప్పుడు దాని కూర్పు మారవచ్చు.
Progress Index మాత్రం ఉమ్మడి గణాంక స్కేల్పై కాలక్రమేణా మోడల్ సామర్థ్యాన్ని అంచనా వేయడానికి ప్రయత్నిస్తుంది.
ఇది item response theory (ఐటమ్ రెస్పాన్స్ థియరీ) అనే పద్ధతిని వాడుతుంది.
మోడల్ సామర్థ్యాన్ని, టాస్క్ కష్టాన్ని కలిపి ఒకేసారి అంచనా వేయడం దీని కేంద్ర ఆలోచన.
సాపేక్షంగా కష్టమైన టాస్క్లలో విజయం సాధించే మోడల్, సులభమైన టాస్క్లలో మాత్రమే విజయం సాధించే మోడల్ కంటే భిన్నమైన ఆధారాన్ని అందిస్తుంది.
ఉమ్మడి స్కేల్పై మోడళ్ల స్థానం ఎక్కడో అంచనా వేసేటప్పుడు గణాంక పద్ధతి ఆ ఫలితాలను పరిగణనలోకి తీసుకుంటుంది.
ముఖ్యంగా, అన్ని మోడళ్లూ సరిగ్గా ఒకే టాస్క్లను పూర్తి చేయాల్సిన అవసరం లేదు.
అనేక బెంచ్మార్క్లలో మూల్యాంకనం పొందిన మోడళ్ల ద్వారా Artificial Analysis బెంచ్మార్క్లను అనుసంధానిస్తుంది. తగిన డేటా అందుబాటులో ఉన్నచోట ఒక్కో టాస్క్ ఫలితాలను, లేనిచోట మొత్తం బెంచ్మార్క్ ఫలితాలను అది వాడుతుంది.
ఆ అతివ్యాప్తి చెందే మోడల్ ఫలితాలు పాత, కొత్త మూల్యాంకనాలను ఉమ్మడి అంచనా స్కేల్పై ఉంచడానికి సహాయపడతాయి.
చారిత్రక ధోరణులను అధ్యయనం చేయడానికి, వేర్వేరు Intelligence Index వెర్షన్ల స్కోర్లను తీసివేయడం కంటే ఇది మరింత తగినది.
కానీ ఇది ఇప్పటికీ ఒక అంచనానే.
ఫలితంగా వచ్చే స్థానాలు అందుబాటులో ఉన్న మూల్యాంకన డేటా, గణాంక మోడల్, దాని ఊహలపై ఆధారపడతాయి. ప్రతి మోడల్ ఒకే పరిస్థితుల్లో ఒకేలాంటి టాస్క్ల సమితిని పూర్తి చేయడాన్ని గమనించడంతో అవి సమానం కావు.
కలిపి
Progress Index, item response theory (ఐటమ్ రెస్పాన్స్ థియరీ) అనే పద్ధతిని వాడుతుంది. మోడల్ సామర్థ్యాన్ని, టాస్క్ కష్టాన్ని కలిపి ఒకేసారి అంచనా వేయడం దీని కేంద్ర ఆలోచన. సాపేక్షంగా కష్టమైన టాస్క్లలో విజయం సాధించే మోడల్, సులభమైన టాస్క్లలో మాత్రమే విజయం సాధించే మోడల్ కంటే భిన్నమైన ఆధారాన్ని అందిస్తుంది.
ఒకే టాస్క్లు కావు
అన్ని మోడళ్లూ సరిగ్గా ఒకే టాస్క్లను పూర్తి చేయాల్సిన అవసరం లేదు.
అనుసంధానం
అనేక బెంచ్మార్క్లలో మూల్యాంకనం పొందిన మోడళ్ల ద్వారా Artificial Analysis బెంచ్మార్క్లను అనుసంధానిస్తుంది. తగిన డేటా అందుబాటులో ఉన్నచోట ఒక్కో టాస్క్ ఫలితాలను, లేనిచోట మొత్తం బెంచ్మార్క్ ఫలితాలను అది వాడుతుంది. ఆ అతివ్యాప్తి చెందే మోడల్ ఫలితాలు పాత, కొత్త మూల్యాంకనాలను ఉమ్మడి అంచనా స్కేల్పై ఉంచడానికి సహాయపడతాయి.
ఒక అంచనా
ఇది ఇప్పటికీ ఒక అంచనానే. ఫలితంగా వచ్చే స్థానాలు అందుబాటులో ఉన్న మూల్యాంకన డేటా, గణాంక మోడల్, దాని ఊహలపై ఆధారపడతాయి. ప్రతి మోడల్ ఒకే పరిస్థితుల్లో ఒకేలాంటి టాస్క్ల సమితిని పూర్తి చేయడాన్ని గమనించడంతో అవి సమానం కావు.
ప్రస్తుత మోడళ్లను పోల్చడానికి Intelligence Indexను, కాలక్రమేణా సామర్థ్యాన్ని పరిశీలించడానికి Progress Indexను Artificial Analysis సిఫార్సు చేస్తుంది.
మూలం: Artificial Analysis, Progress Index v1 Methodology, అక్టోబర్ 2026
మోడల్ సెట్టింగ్లు కూడా ఫలితాన్ని మార్చగలవు
ముఖ్యమైన అంశం బెంచ్మార్క్ మెథడాలజీ ఒక్కటే కాదు.
ఒకే మోడల్ను వేర్వేరు రీజనింగ్ ఎఫర్ట్ సెట్టింగ్ల కింద మూల్యాంకనం చేయవచ్చు.
తన అక్టోబర్ 27 ప్రకటనలో, Claude Opus 5.5 తక్కువ ఎఫర్ట్లో 35, గరిష్ఠ ఎఫర్ట్లో 58 స్కోర్ చేసిందని Artificial Analysis నివేదించింది.
ఒక్కో Intelligence Index టాస్క్కు అంచనా వేసిన ఖర్చు కూడా $0.98 నుండి $10.04కి పెరిగింది.
ఇవి Artificial Analysis నివేదించిన ఫలితాలు, TechiesJournal స్వతంత్రంగా పునరుత్పత్తి చేసిన కొలతలు కావు.
తక్కువ ఎఫర్ట్
తన అక్టోబర్ 27 ప్రకటనలో, Claude Opus 5.5 తక్కువ ఎఫర్ట్లో 35 స్కోర్ చేసిందని Artificial Analysis నివేదించింది. ఒక్కో Intelligence Index టాస్క్కు అంచనా వేసిన ఖర్చు $0.98.
గరిష్ఠ ఎఫర్ట్
గరిష్ఠ ఎఫర్ట్లో అదే మోడల్ 58 స్కోర్ చేసింది, ఒక్కో Intelligence Index టాస్క్కు అంచనా వేసిన ఖర్చు $10.04కి పెరిగింది.
ఇది ఎందుకు ముఖ్యం
ఇవి Artificial Analysis నివేదించిన ఫలితాలు, TechiesJournal స్వతంత్రంగా పునరుత్పత్తి చేసిన కొలతలు కావు. ఒక బెంచ్మార్క్ స్కోర్ కేవలం ప్రొడక్ట్ పేరుకు కాకుండా, ఒక మోడల్ వెర్షన్కు దాని మూల్యాంకన కాన్ఫిగరేషన్తో కలిపి చెందుతుంది. ఎక్కువ స్కోర్ విలువైనది కావచ్చు, కానీ ఆపరేషనల్ అనుకూలతను అంచనా వేసేటప్పుడు అదనపు కంప్యూటేషన్, ఖర్చు ముఖ్యమైనవి.
ఒక బెంచ్మార్క్ స్కోర్ కేవలం ప్రొడక్ట్ పేరుకు కాకుండా, ఒక మోడల్ వెర్షన్కు దాని మూల్యాంకన కాన్ఫిగరేషన్తో కలిపి ఎందుకు చెందుతుందో ఇవి చూపిస్తాయి.
అందుబాటులో ఉన్న టూల్స్, ప్రాంప్టింగ్, ఎఫర్ట్ సెట్టింగ్లు, ఎగ్జిక్యూషన్ పరిస్థితులు అన్నీ గమనించిన పనితీరుపై ప్రభావం చూపగలవు.
ఎక్కువ స్కోర్ విలువైనది కావచ్చు, కానీ ఆపరేషనల్ అనుకూలతను అంచనా వేసేటప్పుడు అదనపు కంప్యూటేషన్, ఖర్చు ముఖ్యమైనవి.
సవరించిన బెంచ్మార్క్ను ఒక బృందం ఎలా వాడాలి?
కొత్త మోడల్ ర్యాంకింగ్ను పరిశీలిస్తున్న డెవలప్మెంట్ బృందం, స్కోర్ మార్పును అర్థవంతమైనదిగా పరిగణించే ముందు నాలుగు విషయాలను నిర్ధారించుకోవాలి.
మొదట, బెంచ్మార్క్ వెర్షన్ను తనిఖీ చేయండి. వేర్వేరు మెథడాలజీ వెర్షన్ల స్కోర్లు నేరుగా పోల్చదగినవి కాకపోవచ్చు.
రెండవది, మూల్యాంకనం దేనిని కొలుస్తుందో పరిశీలించండి. టాస్క్లు, గ్రేడింగ్ పరిస్థితులు, వెయిటేజీలను గుర్తించి, అవి బృందం ఉద్దేశించిన అప్లికేషన్ను ఎంత దగ్గరగా పోలి ఉన్నాయో అంచనా వేయండి.
మూడవది, మోడల్ కాన్ఫిగరేషన్ను తనిఖీ చేయండి. గరిష్ఠ రీజనింగ్ ఎఫర్ట్లో పొందిన ఫలితం, తక్కువ ఖర్చుతో కూడిన, తక్కువ ఎఫర్ట్ డిప్లాయ్మెంట్ను వర్ణిస్తుందని భావించకూడదు.
నాల్గవది, సరైన పోలికను ఎంచుకోండి. ప్రస్తుత వెర్షన్ మూల్యాంకనాన్ని వాడి, ఆ మూల్యాంకనం నిర్దేశించిన పరిస్థితుల కింద మోడళ్లను పోల్చండి. దీర్ఘకాలిక ధోరణులను అధ్యయనం చేసేటప్పుడు Progress Index వంటి డాక్యుమెంట్ చేసిన చారిత్రక మెథడాలజీని వాడండి.
వెర్షన్
బెంచ్మార్క్ వెర్షన్ను తనిఖీ చేయండి. వేర్వేరు మెథడాలజీ వెర్షన్ల స్కోర్లు నేరుగా పోల్చదగినవి కాకపోవచ్చు.
ఏం కొలుస్తుంది
మూల్యాంకనం దేనిని కొలుస్తుందో పరిశీలించండి. టాస్క్లు, గ్రేడింగ్ పరిస్థితులు, వెయిటేజీలను గుర్తించి, అవి బృందం ఉద్దేశించిన అప్లికేషన్ను ఎంత దగ్గరగా పోలి ఉన్నాయో అంచనా వేయండి.
కాన్ఫిగరేషన్
మోడల్ కాన్ఫిగరేషన్ను తనిఖీ చేయండి. గరిష్ఠ రీజనింగ్ ఎఫర్ట్లో పొందిన ఫలితం, తక్కువ ఖర్చుతో కూడిన, తక్కువ ఎఫర్ట్ డిప్లాయ్మెంట్ను వర్ణిస్తుందని భావించకూడదు.
పోలిక
సరైన పోలికను ఎంచుకోండి. ప్రస్తుత వెర్షన్ మూల్యాంకనాన్ని వాడి, ఆ మూల్యాంకనం నిర్దేశించిన పరిస్థితుల కింద మోడళ్లను పోల్చండి. దీర్ఘకాలిక ధోరణులను అధ్యయనం చేసేటప్పుడు Progress Index వంటి డాక్యుమెంట్ చేసిన చారిత్రక మెథడాలజీని వాడండి.
ఏ మోడళ్లను మరింత పరీక్షించాలో నిర్ణయించడంలో పబ్లిక్ మూల్యాంకనాలు బృందానికి సహాయపడతాయి.
తుది ఆపరేషనల్ నిర్ణయం ప్రాతినిధ్య టాస్క్లు, వైఫల్య తీవ్రత, స్థిరత్వం, ఖర్చు, లేటెన్సీ, సంస్థ స్వంత పరిమితులను కూడా పరిగణించాలి.
ఇవి ఒకదానికొకటి పూరకమైన ఆధారాలు.
బెంచ్మార్క్ మారింది. నిర్ణయంలో ఏం మారాలి?
Artificial Analysis Intelligence Index v5 ఒక గణనీయమైన మెథడాలజీ సవరణ.
ఇది మూల్యాంకనం చేసే సామర్థ్యాల మిశ్రమాన్ని మారుస్తుంది, కఠినమైన టాస్క్ అసెస్మెంట్లను ప్రవేశపెడుతుంది, వెయిటేజీలను సవరిస్తుంది, ప్రైవేట్ లేదా బయటకు వెల్లడించని మూల్యాంకన మెటీరియల్పై ఆధారపడటాన్ని పెంచుతుంది.
ఈ ఎంపికలు, పబ్లిషర్ ఈరోజు కొలవాలనుకుంటున్న సామర్థ్యాల గురించి ఇండెక్స్ను మరింత సమాచారపూర్వకంగా చేయవచ్చు. ప్రతి ప్రొడక్షన్ వర్క్లోడ్ను అది మరింత కచ్చితంగా అంచనా వేస్తుందని అవి నిరూపించవు.
ప్రత్యేక Progress Index, గణాంక అంచనాకు సహజంగా ఉండే పరిమితులతో, ఉమ్మడి స్కేల్పై చారిత్రక సామర్థ్యాన్ని అంచనా వేయడం ద్వారా వేరే ప్రశ్నను పరిష్కరిస్తుంది.
AI మోడళ్లను ఎంచుకునే బృందాలకు, మారిన స్కోర్ మోడల్ పురోగతి లేదా క్షీణత గురించి నిర్ధారణకు రావడానికి ముందు, కొలత పరిస్థితులను తనిఖీ చేసేలా చేయాలి.
ఒక బెంచ్మార్క్ ఫలితం, నిర్దేశిత పరిస్థితుల్లో ఒక మోడల్ ఎలా పనిచేసిందో మనకు చెబుతుంది. ఆ ఫలితంలో మార్పు, పరిస్థితులను అర్థం చేసుకునే వరకు అది ఎందుకు మారిందో చెప్పదు.
రిఫరెన్సులు, అదనపు పఠనం
- Artificial Analysis, Announcing Artificial Analysis Intelligence Index v5. అక్టోబర్ 27, 2026. కొత్త మూల్యాంకనాలు, సవరణలు, అప్డేట్ చేసిన వెయిటేజీల ప్రాథమిక ప్రకటన.
- Artificial Analysis, Intelligence Benchmarking Methodology. నవంబర్ 3, 2026 సమీక్ష సమయంలో వెర్షన్ 5.0.1 కనిపించింది.
- Artificial Analysis, Progress Index v1 Methodology. అక్టోబర్ 2026. వేర్వేరు మూల్యాంకన సెట్లలో సామర్థ్యాన్ని అంచనా వేసే గణాంక విధానం.
- TechiesJournal, బెంచ్మార్క్ థియేటర్: AI మోడల్ క్లెయిమ్లను ఎలా చదవాలి. సెప్టెంబర్ 2026. బెంచ్మార్క్ క్లెయిమ్లను అర్థం చేసుకోవడం, మోడళ్లను ఎంచుకోవడంపై సంబంధిత పఠనం.
ఆధారాల కటాఫ్: నవంబర్ 3, 2026. మెథడాలజీ, మూల్యాంకనాల జాబితా, నివేదించిన ర్యాంకింగ్లు మారవచ్చు. ఈ వ్యాసం అక్టోబర్ 27 నాటి v5 విడుదలను వర్ణిస్తుంది, సమీక్ష సమయంలో కనిపించిన మెథడాలజీ వెర్షన్ను గుర్తిస్తుంది.