

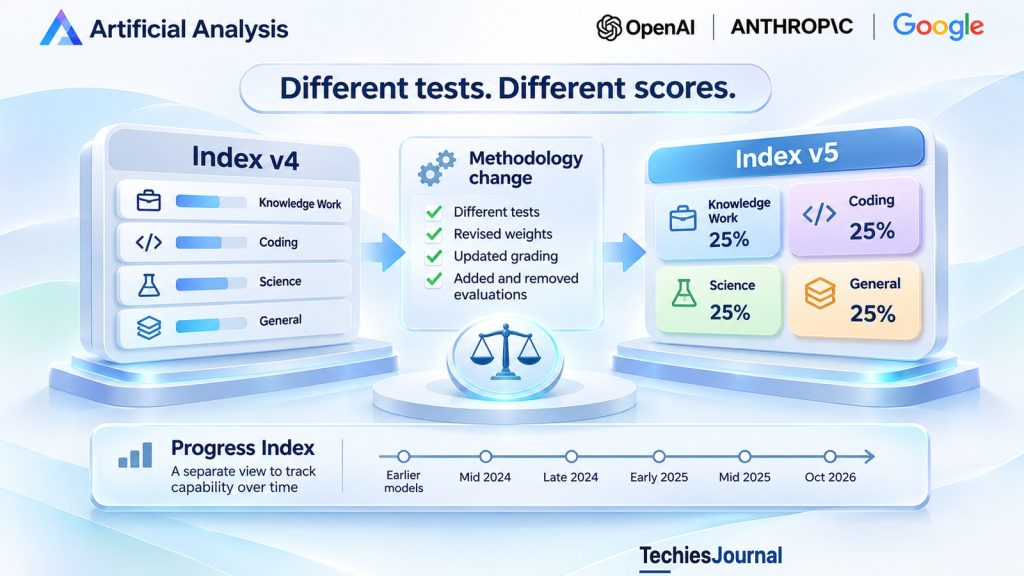
Artificial Analysis a remanié son Intelligence Index (indice d’intelligence) en octobre 2026, en modifiant les tests et les pondérations utilisés pour comparer les modèles d’IA. Cette mise à jour explique pourquoi le score d’un modèle peut bouger même lorsque le modèle lui-même n’a pas changé.
Imaginez une équipe de développement qui examine deux rapports d’évaluation de modèles d’IA.
Le premier attribue à un modèle un score de 55. Un rapport plus récent attribue à la même version du modèle un score de 50.
Le modèle n’a pas nécessairement changé, et pourtant l’équipe voit désormais un chiffre plus bas.
Le modèle est-il devenu moins capable, ou est-ce la mesure qui a changé ?
Ces chiffres sont hypothétiques. Ils illustrent une question devenue particulièrement pertinente le 27 octobre 2026, quand Artificial Analysis a publié la version 5 de son Intelligence Index.
L’organisation a modifié les évaluations utilisées dans son benchmark composite, introduit de nouveaux tests, mis à niveau des tests existants et revu la manière dont les capacités contribuent au score final.
Selon Artificial Analysis, 60 % du poids de l’indice mis à jour provient d’évaluations qui utilisent des jeux de test privés ou des réponses non publiées.
L’entreprise a également introduit un indice distinct, le Progress Index (indice de progression), pour estimer l’évolution des capacités des modèles au fil du temps.
Ces changements modifient ce que représente un score communiqué.
Pour quiconque choisit des modèles d’IA, la distinction essentielle se situe entre un changement de performance du modèle et un changement dans la manière de mesurer cette performance.
Qu’est-ce qui a changé dans l’Intelligence Index v5 ?
L’Intelligence Index d’Artificial Analysis combine les résultats de plusieurs évaluations en un seul score composite.
La version 5 répartit neuf évaluations en quatre catégories de poids égal.
| Catégorie | Poids dans l’indice | Évaluations |
|---|---|---|
| Travail intellectuel | 25 % | AA-Briefcase, AutomationBench-AA, GDP.pdf |
| Programmation | 25 % | FrontierCode 2.0, Terminal-Bench 4.0 |
| Sciences | 25 % | Terminal-Bench-Science, CritPt v2 (sous-ensemble difficile) |
| Général | 25 % | AA-Omniscience v1.1, HLE-Diamond |
Au sein de chaque catégorie, les évaluations n’ont pas toutes le même poids.
Par exemple, FrontierCode 2.0 représente 15 % de l’indice global, tandis que Terminal-Bench 4.0 en représente 10 %.
Artificial Analysis a présenté la version d’octobre comme sa plus importante mise à niveau depuis le lancement de la v4 en janvier.
Deux évaluations ont été ajoutées.
FrontierCode 2.0 évalue des agents de programmation sur 132 tâches portant sur des dépôts open source. Son évaluation cherche à savoir si un mainteneur accepterait la modification, plutôt que de se fonder uniquement sur la réussite de tests automatisés. Un contrôle bloquant en échec peut ramener le score de la tâche à zéro.
Terminal-Bench-Science introduit 70 tâches de recherche scientifique réalisées dans un environnement de terminal. Une tâche n’est réussie que si chaque test requis est réussi.
Trois évaluations ont été mises à niveau.
HLE-Diamond a remplacé la composante d’origine Humanity’s Last Exam par un ensemble affiné de 1 000 questions.
AA-Omniscience v1.1 a révisé son jeu de données pour retirer les questions publiques ou saturées et traiter les éléments ambigus ou erronés.
CritPt v2 est entré dans l’indice sous la forme d’un sous-ensemble difficile et privé de 40 questions, tiré d’une évaluation de physique, avec accès à l’exécution de code.
L’indice composite a également retiré GDPval-AA v2.1, SciCode et AA-LCR v1.1.
Les conséquences sont techniques, pas cosmétiques. Un score produit par la v5 reflète un ensemble de tâches, des conditions de notation et des pondérations différents de ceux de la version précédente.
Ajout
FrontierCode 2.0 évalue des agents de programmation sur 132 tâches portant sur des dépôts open source. Son évaluation cherche à savoir si un mainteneur accepterait la modification, plutôt que de se fonder uniquement sur la réussite de tests automatisés. Un contrôle bloquant en échec peut ramener le score de la tâche à zéro.
Terminal-Bench-Science introduit 70 tâches de recherche scientifique réalisées dans un environnement de terminal. Une tâche n’est réussie que si chaque test requis est réussi.
Révision
HLE-Diamond a remplacé la composante d’origine Humanity’s Last Exam par un ensemble affiné de 1 000 questions.
AA-Omniscience v1.1 a révisé son jeu de données pour retirer les questions publiques ou saturées et traiter les éléments ambigus ou erronés.
CritPt v2 est entré dans l’indice sous la forme d’un sous-ensemble difficile et privé de 40 questions, tiré d’une évaluation de physique, avec accès à l’exécution de code.
Retrait
L’indice composite a également retiré GDPval-AA v2.1, SciCode et AA-LCR v1.1.
Les conséquences sont techniques, pas cosmétiques. Un score produit par la v5 reflète un ensemble de tâches, des conditions de notation et des pondérations différents de ceux de la version précédente.
Source : Artificial Analysis, Announcing Artificial Analysis Intelligence Index v5, 27 octobre 2026
Comment le même modèle peut-il obtenir un score différent ?
Revenons à l’équipe de développement hypothétique.
La version de son modèle n’a pas changé, mais la batterie d’évaluations est différente.
Un ancien benchmark pourrait privilégier de courts exercices de programmation. Un benchmark plus récent pourrait accorder davantage de poids à la modification de dépôts complexes et au respect de plusieurs conditions d’acceptation.
Un modèle peut être efficace sur le premier type de tâche tout en peinant sur le second.
Cette différence ne traduit pas nécessairement un déclin des capacités fondamentales du modèle.
Elle peut traduire un changement dans ce que l’évaluateur demande au modèle de faire.
La méthode de notation compte aussi.
Supposons qu’un agent de programmation réalise l’essentiel d’une modification demandée, mais échoue sur une exigence critique.
Une évaluation qui accorde une note partielle peut reconnaître le travail réussi. Une autre peut attribuer zéro, car cet échec rend la modification inacceptable.
FrontierCode 2.0 utilise des contrôles bloquants qui peuvent donner un score nul à une tentative.
La performance d’un modèle selon ce critère d’acceptation plus strict apprend aux lecteurs quelque chose d’utile sur son comportement. Elle n’établit pas que son score sur une tâche antérieure, notée différemment, aurait baissé.
La pondération produit un autre effet.
Si un modèle est relativement fort en sciences mais plus faible en programmation sur des dépôts, accroître l’importance des tâches de programmation peut modifier son résultat composite.
C’est pourquoi un benchmark composite ne doit pas être compris comme une mesure permanente et universelle de l’intelligence.
Il résume la performance sur une sélection particulière de tâches, dans des conditions d’évaluation définies.
La question
Une équipe voit un score de 55 dans un rapport d’évaluation et de 50 dans un rapport plus récent, pour la même version du modèle. Le modèle est-il devenu moins capable, ou est-ce la mesure qui a changé ? Ces chiffres sont hypothétiques.
Tâches
Un ancien benchmark pourrait privilégier de courts exercices de programmation. Un benchmark plus récent pourrait accorder davantage de poids à la modification de dépôts complexes et au respect de plusieurs conditions d’acceptation. Un modèle peut être efficace sur le premier type de tâche tout en peinant sur le second. Cela ne traduit pas nécessairement un déclin des capacités fondamentales du modèle.
Notation
Une évaluation qui accorde une note partielle peut reconnaître le travail réussi. Une autre peut attribuer zéro parce qu’une exigence critique a échoué. FrontierCode 2.0 utilise des contrôles bloquants qui peuvent donner un score nul à une tentative.
Poids
Si un modèle est relativement fort en sciences mais plus faible en programmation sur des dépôts, accroître l’importance des tâches de programmation peut modifier son résultat composite.
Qu’apporte une évaluation plus privée ?
Artificial Analysis indique que 60 % du poids de l’indice v5 provient d’évaluations qui utilisent des jeux de test privés ou des réponses non publiées.
Cela répond à un véritable problème d’évaluation.
Les benchmarks publics permettent aux chercheurs d’examiner les questions, de comprendre les règles de notation et de reproduire les résultats.
Mais leur accès public crée aussi des occasions pour que le matériel de test se retrouve dans les données d’entraînement, dans des prompts ou dans les retours utilisés pour développer les modèles.
Un modèle qui connaît déjà les questions d’un benchmark peut obtenir de bons résultats en partie grâce à cette exposition préalable, plutôt que parce qu’il sait résoudre des problèmes inconnus tout aussi difficiles.
Garder privées les tâches de test ou leurs réponses vise à réduire ce risque.
FrontierCode 2.0 utilise des tâches tirées de dépôts privés. AA-Omniscience v1.1 retire aussi des questions que l’éditeur décrit comme publiques ou insuffisamment discriminantes.
Ces mesures peuvent rendre plus difficile l’exposition à des réponses connues.
Cependant, privé ne signifie pas à l’abri de la contamination.
La méthodologie publiée explique les choix de conception de l’évaluateur. Elle n’établit pas de façon indépendante qu’aucun modèle n’a rencontré de contenus apparentés.
Les tests privés impliquent aussi un compromis.
Lorsque les tâches et les détails de notation ne sont pas divulgués, les chercheurs extérieurs disposent de moins d’informations pour reproduire ou contester des résultats particuliers.
Cette approche peut réduire certains risques d’exposition tout en accroissant la dépendance envers la sélection des tâches, la mise en œuvre de la notation et les contrôles qualité de l’éditeur du benchmark.
Ni un benchmark entièrement public ni un benchmark en partie privé ne fournit automatiquement une mesure complète de la fiabilité des modèles en conditions réelles.
Améliore
L’accès public crée des occasions pour que le matériel de test se retrouve dans les données d’entraînement, dans des prompts ou dans les retours utilisés pour développer les modèles. Un modèle qui connaît déjà les questions d’un benchmark peut obtenir de bons résultats en partie grâce à cette exposition préalable. Garder privées les tâches de test ou leurs réponses vise à réduire ce risque.
Coûte
Lorsque les tâches et les détails de notation ne sont pas divulgués, les chercheurs extérieurs disposent de moins d’informations pour reproduire ou contester des résultats particuliers. Cette approche peut réduire certains risques d’exposition tout en accroissant la dépendance envers la sélection des tâches, la mise en œuvre de la notation et les contrôles qualité de l’éditeur du benchmark.
Non prouvé
Privé ne signifie pas à l’abri de la contamination. La méthodologie publiée explique les choix de conception de l’évaluateur. Elle n’établit pas de façon indépendante qu’aucun modèle n’a rencontré de contenus apparentés.
Les tâches concrètes sont utiles, mais restent sélectives
L’Intelligence Index v5 accorde un poids important aux évaluations qui font intervenir des outils, des dépôts et un travail en plusieurs étapes.
C’est utile, car de nombreuses applications professionnelles exigent davantage que la production d’une réponse isolée.
Néanmoins, une évaluation qui ressemble à un travail concret n’est pas automatiquement représentative de l’environnement de chaque organisation.
FrontierCode teste des modifications dans des dépôts sélectionnés. Une équipe de développement qui maintient une application d’entreprise privée peut avoir d’autres langages de programmation, une autre architecture, d’autres contraintes de sécurité et d’autres exigences de revue.
Terminal-Bench-Science teste des flux de travail de recherche dans des conditions de terminal définies. Il n’établit pas qu’un modèle peut mener à bien de façon fiable n’importe quel flux de travail scientifique.
Artificial Analysis décrit aussi son Intelligence Index comme principalement textuel et en anglais. L’entreprise rend compte plus largement du multilinguisme et d’autres modalités au moyen d’évaluations distinctes.
La distinction se situe entre mesurer les tâches choisies et prédire la performance sur des tâches extérieures à l’évaluation.
Les changements d’octobre peuvent améliorer la capacité de l’éditeur à départager les modèles actuels. Savoir s’ils prédisent la réussite dans une application métier particulière exige des éléments supplémentaires issus de cette application.
Pourquoi les scores v4 et v5 ne sont pas directement comparables
Un score de benchmark n’a de sens qu’au sein de la méthode de mesure qui l’a produit.
Lorsque la sélection des tâches, les règles de notation ou les pondérations changent, l’échelle numérique peut changer elle aussi.
Pour le modèle hypothétique dont le score est passé de 55 à 50, annoncer une baisse de capacité de cinq points ne serait donc pas fondé.
L’écart pourrait provenir de tâches plus difficiles, d’autres pondérations, d’une notation plus stricte ou de conditions d’évaluation modifiées.
Même un changement de classement peut refléter le fait que des modèles différents réagissent différemment à la nouvelle combinaison de tâches.
Artificial Analysis précise que les versions successives de l’Intelligence Index ne sont pas conçues pour former une seule échelle de capacité à long terme, directement comparable.
Un score de l’Intelligence Index v5 décrit une performance dans le cadre de la v5.
Un score v4 antérieur décrit une performance dans le cadre précédent.
Les deux peuvent être utiles sans se prêter à une soustraction directe.
Source : Artificial Analysis, Progress Index v1 Methodology, octobre 2026
Que mesure le Progress Index, publié séparément ?
Pour traiter les comparaisons historiques, Artificial Analysis a introduit le Progress Index v1 en même temps que la mise à jour d’octobre.
L’Intelligence Index et le Progress Index servent des objectifs différents.
L’Intelligence Index est conçu pour comparer les modèles actuels sur des tâches choisies pour représenter les capacités contemporaines.
Sa composition peut changer lorsque les modèles progressent et que d’anciennes évaluations ne permettent plus de les départager.
Le Progress Index cherche plutôt à estimer la capacité des modèles au fil du temps sur une échelle statistique commune.
Il utilise une méthode appelée théorie de la réponse à l’item (item response theory).
L’idée centrale est d’estimer conjointement la capacité des modèles et la difficulté des tâches.
Un modèle qui réussit des tâches relativement difficiles fournit des indices différents de ceux d’un modèle qui ne réussit que des tâches plus faciles.
La méthode statistique prend ces résultats en compte pour estimer la place des modèles sur une échelle commune.
Point important, les modèles n’ont pas tous besoin d’accomplir exactement les mêmes tâches.
Artificial Analysis relie les benchmarks entre eux par l’intermédiaire de modèles évalués sur plusieurs benchmarks. L’entreprise utilise les résultats tâche par tâche lorsque des données adaptées sont disponibles, et les résultats agrégés par benchmark dans le cas contraire.
Ces résultats de modèles qui se recoupent aident à placer les évaluations anciennes et récentes sur l’échelle estimée commune.
Cette approche convient mieux à l’étude des tendances historiques que la soustraction de scores issus de différentes versions de l’Intelligence Index.
Mais elle reste une estimation.
Les positions obtenues dépendent des données d’évaluation disponibles, du modèle statistique et de ses hypothèses. Elles ne reviennent pas à observer chaque modèle accomplir un ensemble identique de tâches dans des conditions identiques.
Ensemble
Le Progress Index utilise une méthode appelée théorie de la réponse à l’item (item response theory). L’idée centrale est d’estimer conjointement la capacité des modèles et la difficulté des tâches. Un modèle qui réussit des tâches relativement difficiles fournit des indices différents de ceux d’un modèle qui ne réussit que des tâches plus faciles.
Tâches différentes
Les modèles n’ont pas tous besoin d’accomplir exactement les mêmes tâches.
Reliés
Artificial Analysis relie les benchmarks entre eux par l’intermédiaire de modèles évalués sur plusieurs benchmarks. L’entreprise utilise les résultats tâche par tâche lorsque des données adaptées sont disponibles, et les résultats agrégés par benchmark dans le cas contraire. Ces résultats de modèles qui se recoupent aident à placer les évaluations anciennes et récentes sur l’échelle estimée commune.
Estimation
Cela reste une estimation. Les positions obtenues dépendent des données d’évaluation disponibles, du modèle statistique et de ses hypothèses. Elles ne reviennent pas à observer chaque modèle accomplir un ensemble identique de tâches dans des conditions identiques.
Artificial Analysis recommande l’Intelligence Index pour comparer les modèles actuels et le Progress Index pour examiner l’évolution des capacités au fil du temps.
Source : Artificial Analysis, Progress Index v1 Methodology, octobre 2026
Les réglages du modèle peuvent aussi changer le résultat
La méthodologie du benchmark n’est pas la seule variable qui compte.
Un même modèle peut être évalué avec différents réglages d’effort de raisonnement.
Dans son annonce du 27 octobre, Artificial Analysis a indiqué que Claude Opus 5.5 obtenait 35 avec un effort bas et 58 avec l’effort maximal.
Le coût estimé par tâche de l’Intelligence Index est aussi passé de 0,98 dollar à 10,04 dollars.
Ce sont des résultats communiqués par Artificial Analysis, et non des mesures reproduites de façon indépendante par TechiesJournal.
Effort bas
Dans son annonce du 27 octobre, Artificial Analysis a indiqué que Claude Opus 5.5 obtenait 35 avec un effort bas. Le coût estimé par tâche de l’Intelligence Index était de 0,98 dollar.
Effort maximal
Avec l’effort maximal, le même modèle obtenait 58, et le coût estimé par tâche de l’Intelligence Index passait à 10,04 dollars.
Pourquoi c’est important
Ce sont des résultats communiqués par Artificial Analysis, et non des mesures reproduites de façon indépendante par TechiesJournal. Un score de benchmark appartient à une version de modèle et à sa configuration d’évaluation, plutôt qu’à un simple nom de produit. Un score plus élevé peut avoir de la valeur, mais le calcul et le coût supplémentaires comptent lorsqu’on évalue l’adéquation opérationnelle.
Ils montrent pourquoi un score de benchmark appartient à une version de modèle et à sa configuration d’évaluation, plutôt qu’à un simple nom de produit.
Les outils disponibles, les prompts, les réglages d’effort et les conditions d’exécution peuvent tous influer sur la performance observée.
Un score plus élevé peut avoir de la valeur, mais le calcul et le coût supplémentaires comptent lorsqu’on évalue l’adéquation opérationnelle.
Comment une équipe doit-elle utiliser un benchmark révisé ?
Une équipe de développement qui examine un nouveau classement de modèles devrait établir quatre points avant de considérer une variation de score comme significative.
Premièrement, vérifiez la version du benchmark. Les scores issus de versions différentes de la méthodologie ne sont pas forcément directement comparables.
Deuxièmement, examinez ce que mesure l’évaluation. Identifiez les tâches, les conditions de notation et les pondérations, puis évaluez dans quelle mesure elles ressemblent à l’application prévue par l’équipe.
Troisièmement, vérifiez la configuration du modèle. Un résultat obtenu avec l’effort de raisonnement maximal ne doit pas être présumé valable pour un déploiement moins coûteux, avec un effort moindre.
Quatrièmement, choisissez la bonne comparaison. Utilisez une évaluation de la version actuelle pour comparer des modèles dans les conditions de cette évaluation. Utilisez une méthodologie historique documentée, comme le Progress Index, pour étudier les tendances à plus long terme.
Version
Vérifiez la version du benchmark. Les scores issus de versions différentes de la méthodologie ne sont pas forcément directement comparables.
Ce qui est mesuré
Examinez ce que mesure l’évaluation. Identifiez les tâches, les conditions de notation et les pondérations, puis évaluez dans quelle mesure elles ressemblent à l’application prévue par l’équipe.
Configuration
Vérifiez la configuration du modèle. Un résultat obtenu avec l’effort de raisonnement maximal ne doit pas être présumé valable pour un déploiement moins coûteux, avec un effort moindre.
Comparaison
Choisissez la bonne comparaison. Utilisez une évaluation de la version actuelle pour comparer des modèles dans les conditions de cette évaluation. Utilisez une méthodologie historique documentée, comme le Progress Index, pour étudier les tendances à plus long terme.
Les évaluations publiques peuvent aider une équipe à décider quels modèles méritent des tests plus poussés.
La décision opérationnelle finale doit aussi tenir compte de tâches représentatives, de la gravité des défaillances, de la constance, du coût, de la latence et des contraintes propres à l’organisation.
Ce sont des types de preuves complémentaires.
Le benchmark a changé. Qu’est-ce qui doit changer dans la décision ?
L’Intelligence Index v5 d’Artificial Analysis est une révision méthodologique de fond.
Il modifie la combinaison des capacités évaluées, introduit des évaluations de tâches plus strictes, révise les pondérations et s’appuie davantage sur des contenus d’évaluation privés ou non publiés.
Ces choix peuvent rendre l’indice plus informatif sur les capacités que son éditeur veut mesurer aujourd’hui. Ils ne prouvent pas qu’il prédit plus précisément chaque charge de travail en production.
Le Progress Index, distinct, répond à une autre question en estimant la capacité historique sur une échelle commune, avec les limites inhérentes à toute estimation statistique.
Pour les équipes qui choisissent des modèles d’IA, un score modifié devrait déclencher une vérification des conditions de mesure avant toute conclusion sur le progrès ou le déclin d’un modèle.
Un résultat de benchmark nous dit comment un modèle s’est comporté dans des conditions définies. Une variation de ce résultat ne nous dit pas pourquoi il a changé tant que ces conditions ne sont pas comprises.
Références et lectures complémentaires
- Artificial Analysis, Announcing Artificial Analysis Intelligence Index v5. 27 octobre 2026. Annonce principale des nouvelles évaluations, des révisions et des pondérations mises à jour.
- Artificial Analysis, Intelligence Benchmarking Methodology. Version 5.0.1 affichée lors de la vérification du 3 novembre 2026.
- Artificial Analysis, Progress Index v1 Methodology. Octobre 2026. Approche statistique pour estimer la capacité à travers différents ensembles d’évaluations.
- TechiesJournal, Benchmark Theatre: How to Read AI Model Claims (en anglais). Septembre 2026. Lecture complémentaire sur l’interprétation des annonces de benchmark et le choix des modèles.
Date d’arrêt des sources : 3 novembre 2026. La méthodologie, la liste des évaluations et les classements communiqués peuvent changer. Cet article décrit la version v5 du 27 octobre et indique la version de la méthodologie visible lors de la vérification.