

Un site de vente en ligne se prépare à la plus grosse opération commerciale de son année. L’application a passé ses tests de charge. La mise à l’échelle automatique est activée, les quotas de service ont été relevés et la page d’état du cloud ne signale aucun problème.
Au lancement de l’opération, le trafic augmente comme prévu. Le mécanisme de mise à l’échelle automatique demande davantage de machines virtuelles, mais la plateforme cloud ne peut pas fournir le type de machine choisi dans cette zone. Une partie des demandes de mise à l’échelle échoue.
Le fournisseur n’a pas subi de panne régionale. D’autres clients et d’autres services fonctionnent peut-être normalement. Pourtant, cette application ne parvient pas à obtenir les ressources dont elle a besoin.
Cette situation surprend les équipes, car les services cloud donnent généralement une impression de ressources illimitées. On demande de l’infrastructure par une API et on l’obtient en quelques minutes. Après des centaines de demandes réussies, il est facile de considérer la capacité comme une propriété permanente du service.
Ce n’est pas le cas. L’API repose toujours sur des équipements physiques situés dans un lieu bien réel.
Ce qui se cache derrière une demande cloud
Une demande de machine virtuelle finit par exiger un serveur doté du bon processeur, de la bonne mémoire et des connexions locales adéquates. Une demande de GPU exige un accélérateur précis et le matériel qui l’accompagne. Dans les deux cas, il faut du stockage, des réseaux, du refroidissement, de l’électricité et de l’espace disponible dans un centre de données.
Ces ressources sont installées dans des sites précis. Si la demande augmente à un endroit, le matériel inutilisé d’une autre région ne peut pas y répondre immédiatement. Les fournisseurs peuvent ajouter de l’infrastructure, mais une nouvelle capacité de centre de données demande du temps : il faut la planifier, l’alimenter en électricité, la construire et la raccorder.
L’ampleur de ce chantier augmente. L’analyse Energy and AI de l’Agence internationale de l’énergie prévoit que la consommation électrique mondiale des centres de données pourrait plus que doubler, pour atteindre environ 945 térawattheures d’ici 2030. Cela ne signifie pas que la capacité cloud vient à manquer de manière générale. Cela montre que l’expansion ne dépend plus seulement de l’achat de serveurs : l’électricité et l’infrastructure associée doivent elles aussi arriver aux bons endroits.
L’investissement mondial d’un fournisseur ne dit pas grand-chose sur la possibilité, pour votre compte, de lancer un GPU précis dans une zone donnée demain matin.
« Disponible » peut vouloir dire plusieurs choses
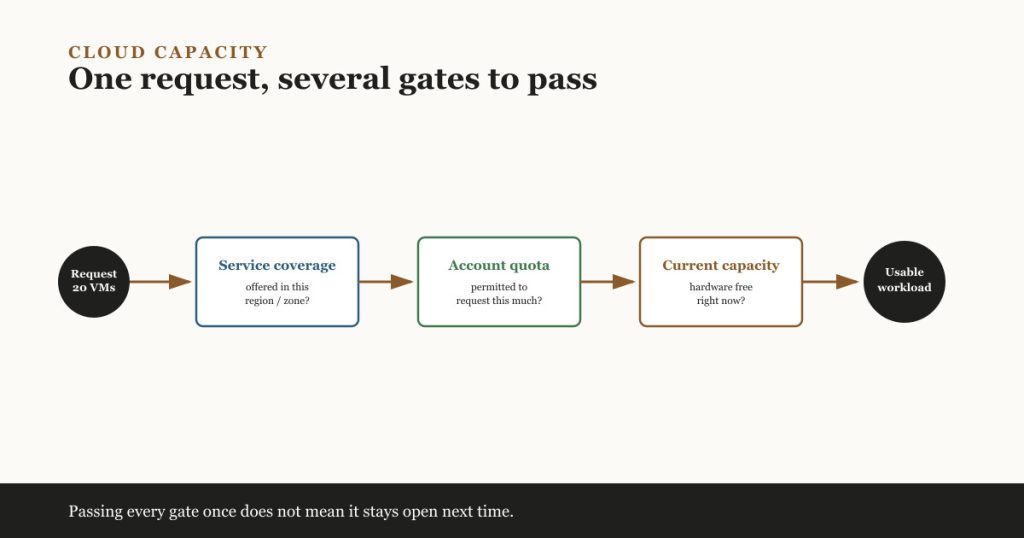
Supposons qu’une équipe veuille vingt machines d’un même type dans une zone donnée. Pour que la demande aboutisse, plusieurs conditions doivent être réunies.
| Vérification | Ce que cela signifie |
|---|---|
| Couverture du service | La famille de machines et les fonctionnalités requises sont proposées dans cette région ou cette zone. |
| Quota du compte | Le projet ou l’abonnement est autorisé à demander cette quantité. |
| Capacité actuelle | Le fournisseur dispose, à cet instant, de suffisamment de matériel adapté et libre. |
| Garantie de capacité | Une réservation valide, ou un dispositif équivalent, bloque les ressources nécessaires. |
| Disponibilité de la charge de travail | L’application peut rester utilisable, ou se rétablir, lorsqu’une ressource ne peut pas être allouée. |
Ces vérifications sont liées, mais elles ne sont pas interchangeables.
Un type de machine peut figurer au catalogue régional alors qu’une zone n’a plus de capacité libre. Le matériel peut être disponible alors que le quota du client est trop bas. Une réservation peut garantir de la capacité de calcul dans une zone tout en laissant l’application exposée à une défaillance de cette zone.
La formule « le service est disponible » est donc trop vague pour la planification de capacité.
Un quota approuvé ne confirme pas la capacité physique
Un quota fixe la quantité d’une ressource qu’un compte, un projet ou un abonnement peut utiliser. Si un compte est limité à 100 processeurs virtuels, une demande qui porterait la consommation à 120 peut échouer même lorsque le fournisseur dispose de matériel en abondance.
Les équipes règlent généralement ce problème en demandant une limite plus élevée, en réduisant leur consommation ou en déplaçant une partie de la charge de travail. Les vérifications de quotas ont leur place dans la planification des mises en production et des événements, car les approbations peuvent prendre du temps.
La capacité physique est une autre question. Le compte peut disposer d’un quota de 500 processeurs virtuels et ne pas réussir pour autant à obtenir 200 processeurs d’une famille de machines donnée dans une zone.
Ce comportement n’a rien d’inhabituel ni de caché. La documentation d’AWS décrit les erreurs InsufficientInstanceCapacity et conseille d’essayer un autre type d’instance, une autre zone de disponibilité (Availability Zone) ou un autre moment. Les recommandations de Microsoft pour Azure expliquent qu’un type de VM privilégié peut être temporairement indisponible dans un emplacement choisi. Google Cloud documente des erreurs de disponibilité des ressources similaires pour des demandes portant par exemple sur des vCPU et des GPU.
Un quota approuvé signifie que le compte a le droit de demander. Il ne promet pas que la réponse sera oui.
Là où la mise à l’échelle automatique atteint sa limite
La mise à l’échelle automatique répond à la demande en réclamant davantage de ressources. Elle ne peut pas faire apparaître du matériel indisponible.
Reprenons l’exemple du site de vente en ligne. Sa politique de mise à l’échelle n’autorise qu’une seule famille de machines, parce que l’équipe a testé cette configuration et l’a recopiée telle quelle en production. Toutes les instances doivent tourner dans la même zone qu’une autre dépendance. Quand la capacité se raréfie, le mécanisme de mise à l’échelle répète une demande que la plateforme ne peut pas satisfaire.
L’application dispose d’une mise à l’échelle automatisée, mais elle n’a aucune flexibilité.
Une meilleure conception pourrait autoriser deux ou trois familles de machines testées, répartir la capacité sur plusieurs zones, placer le travail entrant dans une file d’attente ou réduire les traitements non essentiels pendant un pic. Le bon choix dépend de la charge de travail. Une appliance de base de données sous licence ne peut pas changer de configuration aussi facilement qu’un pool de serveurs web sans état.
Les configurations spécialisées et de grande taille méritent une attention particulière. Les clusters de GPU, les machines exceptionnellement grandes et les parcs de calcul très densément regroupés laissent au fournisseur moins d’options de placement. La flexibilité doit être conçue et testée avant l’arrivée de la demande.
Quand une réservation a du sens
Les fournisseurs proposent des réservations de capacité pour les charges de travail qui ne peuvent pas dépendre d’une allocation au mieux (best effort). Les AWS EC2 Capacity Reservations, par exemple, peuvent bloquer une configuration précise dans une zone de disponibilité donnée. Les réservations Google Cloud vérifient elles aussi que la capacité demandée est disponible avant de la réserver dans une zone.
Cela peut être utile pour une migration planifiée, une grande opération commerciale, une exigence de reprise ou une charge de travail qui a besoin d’accélérateurs rares. L’organisation paie pour obtenir davantage de certitude et accepte les règles de configuration et d’emplacement de la réservation.
Il existe une limite importante : une capacité de calcul réservée ne rend pas l’ensemble du service résilient. Si toutes les machines réservées se trouvent dans une seule zone, un problème dans cette zone peut toujours toucher l’ensemble du parc. L’application peut aussi dépendre d’une seule base de données, d’un seul service d’identité ou d’un seul chemin réseau. Chaque dépendance a besoin de sa propre conception en matière de disponibilité et de reprise.
La réservation aide à savoir si la capacité de calcul peut être allouée. Elle ne dit pas si le service métier survivra à une défaillance.
L’hypothèse de la machine arrêtée
Les équipes arrêtent parfois des machines en dehors des heures ouvrées ou conservent des ressources désallouées pour la reprise après sinistre. La configuration reste visible dans la console, ce qui peut donner l’impression que le matériel attend toujours.
Selon le service et le dispositif de réservation, arrêter ou désallouer une machine peut libérer sa capacité physique. La redémarrer plus tard peut alors nécessiter une nouvelle allocation. Si ce type de machine se fait rare, le redémarrage peut échouer alors qu’il fonctionnait auparavant.
C’est pourquoi un test de reprise doit aller au-delà de l’inspection des modèles et de la vérification de l’existence des sauvegardes. L’équipe doit démarrer ou créer les ressources nécessaires, restaurer les données, reconnecter les dépendances et mesurer le temps nécessaire pour fournir un service utilisable. Un test réussi avec une seule petite machine ne prouve pas qu’un parc de production complet peut être rétabli.
Les questions à trancher avant le prochain pic
Commencez par recenser les éléments de la charge de travail qui ne peuvent pas être déplacés. Des règles de résidence des données peuvent imposer une région unique. Des licences logicielles peuvent restreindre les types d’instance. Des exigences de performance peuvent lier un service à une famille de GPU ou à un stockage local. Ces contraintes déterminent combien d’alternatives sont réellement disponibles.
Répondez ensuite aux questions suivantes :
- Quels quotas pourraient bloquer la croissance, et quand ont-ils été vérifiés pour la dernière fois ?
- Quels types de machines alternatifs ont réellement été testés ?
- La charge de travail peut-elle utiliser une autre zone sans enfreindre les exigences liées aux données, à la latence ou aux licences ?
- Quels événements exigent une capacité réservée plutôt qu’une allocation au mieux ?
- Que devient le travail entrant tant que la nouvelle capacité est indisponible ?
- Le plan de reprise peut-il allouer l’intégralité du parc nécessaire, et pas seulement une instance de démonstration ?
- L’automatisation reconnaît-elle une erreur de capacité et choisit-elle une alternative approuvée, ou se contente-t-elle de réessayer indéfiniment ?
Tous les systèmes n’ont pas besoin de plusieurs régions ou de matériel réservé. Un petit service interne peut accepter davantage de risque qu’une plateforme de paiement pendant un pic saisonnier. La décision doit être délibérée, en comparant le coût de la protection à l’impact métier d’une attente de capacité.
Ce que les équipes doivent retenir
Les personnes qui approuvent ou conçoivent des systèmes cloud doivent comprendre la différence entre la couverture régionale du service, le quota du compte, la capacité physique actuelle, les réservations et la disponibilité de l’application.
Les ingénieurs cloud, plateforme et fiabilité ont besoin d’une expérience pratique des quotas, des configurations alternatives, du comportement de la mise à l’échelle, des réservations et de tests de reprise réalistes. Les ingénieurs responsables de grands parcs d’accélérateurs ou de plateformes critiques ont besoin d’une connaissance plus approfondie des contraintes de placement et des engagements de capacité, car de petits choix de conception peuvent supprimer des options de repli.
Il ne s’agit pas de prédire si un fournisseur cloud va manquer d’infrastructure. Il s’agit de débusquer les hypothèses cachées dans une charge de travail donnée.
Avant la prochaine migration, la prochaine opération commerciale ou le prochain exercice de reprise, posez une question précise : si la ressource privilégiée ne peut pas être allouée à l’emplacement choisi, que fera le système ?
Si personne n’a testé la réponse, le plan de capacité n’est pas terminé.
Références et lectures complémentaires
- Energy demand from AI — Agence internationale de l’énergie. Projections de la consommation électrique des centres de données et de l’infrastructure nécessaire à l’expansion de la capacité.
- Troubleshoot Amazon EC2 instance launch issues — AWS. Causes des erreurs de lancement pour capacité insuffisante et réponses possibles.
- Troubleshoot Azure VM allocation failures — Microsoft. Comment l’emplacement, la taille de VM et les contraintes de déploiement influent sur l’allocation.
- Troubleshooting resource availability errors — Google Cloud. Pénuries de ressources au niveau d’une zone et réponses possibles.
- EC2 On-Demand Capacity Reservations — AWS. Fonctionnement des réservations de capacité par zone.
- Compute Engine reservations overview — Google Cloud. Comment Compute Engine vérifie et bloque les ressources réservées.