

एक ऑनलाइन रिटेलर साल की सबसे बड़ी सेल की तैयारी कर रहा है। एप्लिकेशन ने अपने लोड टेस्ट पास कर लिए हैं। ऑटोस्केलिंग चालू है, सर्विस कोटा बढ़ाए जा चुके हैं, और क्लाउड स्टेटस पेज कोई समस्या नहीं दिखाता।
जब सेल शुरू होती है, ट्रैफ़िक उम्मीद के मुताबिक़ बढ़ता है। ऑटोस्केलर ज़्यादा वर्चुअल मशीनें माँगता है, लेकिन क्लाउड प्लेटफ़ॉर्म उस ज़ोन में चुना गया मशीन टाइप नहीं दे पाता। कुछ स्केलिंग रिक्वेस्ट फेल हो जाते हैं।
प्रोवाइडर को कोई क्षेत्रीय आउटेज नहीं हुआ। दूसरे ग्राहक और सेवाएँ सामान्य रूप से काम कर रही हो सकती हैं। फिर भी इस एप्लिकेशन को अपनी ज़रूरत के संसाधन नहीं मिल पाते।
यह स्थिति टीमों को चौंका देती है क्योंकि क्लाउड सेवाएँ आमतौर पर असीमित महसूस होती हैं। हम API के ज़रिए इंफ़्रास्ट्रक्चर माँगते हैं और कुछ मिनटों में पा लेते हैं। सैकड़ों बार ऐसा होने के बाद, क्षमता को सेवा की स्थायी विशेषता मान लेना आसान हो जाता है।
ऐसा नहीं है। API अब भी किसी असली जगह पर मौजूद भौतिक उपकरण पर निर्भर करता है।
एक क्लाउड रिक्वेस्ट के पीछे क्या होता है
किसी वर्चुअल मशीन की रिक्वेस्ट को आख़िरकार सही प्रोसेसर, मेमोरी, और स्थानीय कनेक्शन वाले सर्वर की ज़रूरत होती है। किसी GPU रिक्वेस्ट को एक ख़ास एक्सेलेरेटर और सहायक हार्डवेयर चाहिए। दोनों स्टोरेज, नेटवर्क, कूलिंग, बिजली, और उपलब्ध डेटा-सेंटर जगह पर निर्भर हैं।
ये संसाधन ख़ास सुविधाओं में लगे होते हैं। अगर किसी जगह माँग बढ़ती है, तो किसी दूसरे क्षेत्र में बिना इस्तेमाल हुआ हार्डवेयर उसे तुरंत पूरा नहीं कर सकता। प्रोवाइडर इंफ़्रास्ट्रक्चर जोड़ सकते हैं, लेकिन नई डेटा-सेंटर क्षमता को योजना बनाने, बिजली देने, बनाने, और जोड़ने में समय लगता है।
यह काम बड़े पैमाने पर बढ़ रहा है। International Energy Agency का Energy and AI विश्लेषण अनुमान लगाता है कि वैश्विक डेटा-सेंटर बिजली खपत 2030 तक लगभग 945 टेरावाट-घंटे तक, यानी दोगुने से भी ज़्यादा, हो सकती है। इसका मतलब यह नहीं कि क्लाउड क्षमता आम तौर पर ख़त्म हो रही है। यह दिखाता है कि विस्तार अब सिर्फ़ सर्वर ख़रीदने से आगे की चीज़ों पर निर्भर करता है। बिजली और सहायक इंफ़्रास्ट्रक्चर को भी सही जगहों पर पहुँचना होता है।
प्रोवाइडर का वैश्विक निवेश यह बहुत कम बताता है कि क्या आपका अकाउंट कल सुबह किसी ज़ोन में कोई ख़ास GPU लॉन्च कर पाएगा।
“उपलब्ध” का मतलब कई चीज़ें हो सकती हैं
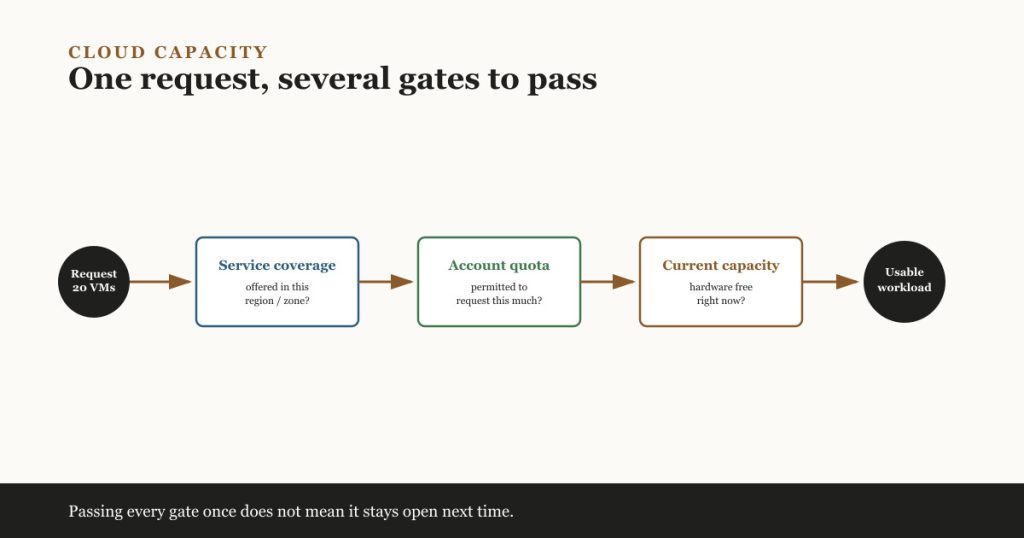
मान लीजिए किसी टीम को किसी ख़ास ज़ोन में एक तरह की बीस मशीनें चाहिए। रिक्वेस्ट सफल होने से पहले, कई शर्तों का सच होना ज़रूरी है।
| जाँच | इसका मतलब क्या है |
|---|---|
| सेवा कवरेज | मशीन फ़ैमिली और ज़रूरी फ़ीचर उस क्षेत्र या ज़ोन में उपलब्ध हैं। |
| अकाउंट कोटा | प्रोजेक्ट या सब्सक्रिप्शन को उतनी मात्रा माँगने की अनुमति है। |
| मौजूदा क्षमता | प्रोवाइडर के पास उस पल पर्याप्त उपयुक्त हार्डवेयर खाली है। |
| क्षमता आश्वासन | ज़रूरी संसाधनों को एक वैध रिज़र्वेशन या ऐसी ही व्यवस्था पकड़े हुए है। |
| वर्कलोड उपलब्धता | जब कोई संसाधन नहीं मिल पाता, तब भी एप्लिकेशन इस्तेमाल-योग्य बना रह सकता है या उबर सकता है। |
ये जाँचें आपस में जुड़ी हैं, लेकिन एक-दूसरे की जगह नहीं ले सकतीं।
कोई मशीन टाइप क्षेत्रीय कैटलॉग में दिख सकता है जबकि किसी एक ज़ोन में कोई खाली क्षमता न हो। हार्डवेयर उपलब्ध हो सकता है जबकि ग्राहक का कोटा बहुत कम हो। कोई रिज़र्वेशन एक ज़ोन में कंप्यूट सुरक्षित कर सकता है जबकि एप्लिकेशन को किसी ज़ोनल विफलता के जोखिम में छोड़ सकता है।
इसलिए “सेवा उपलब्ध है” वाक्यांश क्षमता योजना के लिए बहुत अस्पष्ट है।
कोटा मंज़ूरी भौतिक क्षमता की पुष्टि नहीं करती
कोई कोटा यह नियंत्रित करता है कि कोई अकाउंट, प्रोजेक्ट, या सब्सक्रिप्शन कितने संसाधन का इस्तेमाल कर सकता है। अगर किसी अकाउंट की सीमा 100 वर्चुअल CPU है, तो इस्तेमाल को 120 तक बढ़ाने वाली रिक्वेस्ट फेल हो सकती है, भले ही प्रोवाइडर के पास बहुत सारा हार्डवेयर हो।
टीमें आमतौर पर ऊँची सीमा माँगकर, इस्तेमाल घटाकर, या वर्कलोड का कुछ हिस्सा कहीं और ले जाकर इसे हल करती हैं। कोटा जाँच को रिलीज़ और इवेंट योजना में शामिल होना चाहिए क्योंकि मंज़ूरी में समय लग सकता है।
भौतिक क्षमता एक अलग मसला है। अकाउंट के पास 500 वर्चुअल CPU का कोटा हो सकता है, फिर भी किसी एक ज़ोन में किसी ख़ास मशीन फ़ैमिली के 200 CPU पाने में विफल हो सकता है।
यह कोई असामान्य या छुपा हुआ व्यवहार नहीं है। AWS का दस्तावेज़ीकरण InsufficientInstanceCapacity त्रुटियों का वर्णन करता है और कोई दूसरा इंस्टेंस टाइप, Availability Zone, या समय आज़माने की सलाह देता है। Microsoft का Azure मार्गदर्शन बताता है कि पसंदीदा VM टाइप किसी चुनी गई जगह पर अस्थायी रूप से अनुपलब्ध हो सकता है। vCPU और GPU जैसी रिक्वेस्ट के लिए Google Cloud भी ऐसी ही रिसोर्स-उपलब्धता त्रुटियों का दस्तावेज़ीकरण करता है।
मंज़ूर किया गया कोटा बस इतना बताता है कि अकाउंट माँग सकता है। इसकी कोई गारंटी नहीं कि जवाब “हाँ” ही होगा।
ऑटोस्केलिंग की सीमा कहाँ आती है
ऑटोस्केलिंग ज़्यादा संसाधन माँगकर माँग का जवाब देती है। यह ऐसा हार्डवेयर पैदा नहीं कर सकती जो उपलब्ध ही न हो।
रिटेलर के उदाहरण पर फिर से नज़र डालें। उसकी स्केलिंग पॉलिसी सिर्फ़ एक मशीन फ़ैमिली की इजाज़त देती है, क्योंकि टीम ने उसी कॉन्फ़िगरेशन की जाँच की और उसे प्रोडक्शन में कॉपी कर दिया। सभी इंस्टेंस को किसी दूसरी निर्भरता वाले उसी ज़ोन में चलना है। जब क्षमता कम पड़ती है, ऑटोस्केलर वही रिक्वेस्ट दोहराता है जिसे प्लेटफ़ॉर्म पूरा नहीं कर सकता।
एप्लिकेशन के पास ऑटोमेटेड स्केलिंग है, लेकिन उसमें लचीलापन नहीं है।
बेहतर डिज़ाइन दो या तीन परखे हुए मशीन फ़ैमिली की अनुमति दे सकता है, क्षमता को कई ज़ोन में बाँट सकता है, आने वाले काम को एक क्यू में डाल सकता है, या पीक के दौरान ग़ैर-ज़रूरी प्रोसेसिंग घटा सकता है। सही चुनाव वर्कलोड पर निर्भर करता है। कोई लाइसेंस-प्राप्त डेटाबेस एप्लायंस स्टेटलेस वेब सर्वर के झुंड जितनी आसानी से कॉन्फ़िगरेशन नहीं बदल सकता।
विशेष और बड़े कॉन्फ़िगरेशन को अतिरिक्त ध्यान चाहिए। GPU क्लस्टर, असामान्य रूप से बड़ी मशीनें, और कसकर भरे हुए कंप्यूट फ़्लीट प्रोवाइडर को कम प्लेसमेंट विकल्प देते हैं। माँग आने से पहले ही लचीलापन डिज़ाइन और परखा जाना चाहिए।
रिज़र्वेशन कब मायने रखता है
जो वर्कलोड बेस्ट-एफ़र्ट आवंटन पर निर्भर नहीं रह सकते, उनके लिए प्रोवाइडर कैपेसिटी रिज़र्वेशन देते हैं। उदाहरण के लिए, AWS EC2 Capacity Reservations किसी ख़ास Availability Zone में एक तय कॉन्फ़िगरेशन बनाए रख सकते हैं। Google Cloud के रिज़र्वेशन भी किसी ज़ोन में रिज़र्व करने से पहले यह जाँचते हैं कि माँगी गई क्षमता उपलब्ध है।
यह किसी योजनाबद्ध माइग्रेशन, किसी बड़ी सेल, किसी रिकवरी ज़रूरत, या दुर्लभ एक्सेलेरेटर चाहने वाले वर्कलोड के लिए उपयोगी हो सकता है। संगठन ज़्यादा निश्चितता के लिए भुगतान करता है और रिज़र्वेशन के कॉन्फ़िगरेशन व स्थान के नियम स्वीकार करता है।
एक अहम सीमा है: रिज़र्व किया गया कंप्यूट पूरी सेवा को रेज़िलिएंट नहीं बनाता। अगर हर रिज़र्व की गई मशीन एक ही ज़ोन में है, तो कोई ज़ोनल समस्या अब भी पूरे फ़्लीट को प्रभावित कर सकती है। एप्लिकेशन किसी एक डेटाबेस, पहचान सेवा, या नेटवर्क पाथ पर भी निर्भर हो सकता है। हर निर्भरता को अपनी ख़ुद की उपलब्धता और रिकवरी डिज़ाइन चाहिए।
रिज़र्वेशन यह जवाब देने में मदद करता है कि क्या कंप्यूट आवंटित हो सकता है। यह यह नहीं बताता कि बिज़नेस सेवा किसी विफलता से बच पाएगी या नहीं।
रुकी हुई मशीन वाली धारणा
टीमें कभी-कभी कामकाजी घंटों के बाहर मशीनें रोक देती हैं या आपदा रिकवरी के लिए डीएलोकेटेड संसाधन रखती हैं। कॉन्फ़िगरेशन कंसोल में दिखता रहता है, जिससे यह धारणा बन सकती है कि हार्डवेयर अब भी इंतज़ार कर रहा है।
सेवा और रिज़र्वेशन व्यवस्था के हिसाब से, किसी मशीन को रोकना या डीएलोकेट करना उसकी भौतिक क्षमता छोड़ सकता है। बाद में उसे दोबारा शुरू करने के लिए नया आवंटन चाहिए हो सकता है। अगर वह मशीन टाइप सीमित है, तो पहले काम करने के बावजूद रीस्टार्ट फेल हो सकता है।
इसलिए किसी रिकवरी टेस्ट को सिर्फ़ टेम्प्लेट जाँचने और बैकअप मौजूद होने की पुष्टि करने से ज़्यादा करना चाहिए। टीम को ज़रूरी संसाधन शुरू या तैयार करने चाहिए, डेटा बहाल करना चाहिए, निर्भरताएँ फिर से जोड़नी चाहिए, और यह मापना चाहिए कि उपयोग-योग्य सेवा देने में कितना समय लगता है। एक छोटी मशीन के साथ सफल टेस्ट यह साबित नहीं करता कि पूरा प्रोडक्शन फ़्लीट बहाल किया जा सकता है।
अगले पीक से पहले तय करने वाले सवाल
वर्कलोड के उन हिस्सों की सूची बनाकर शुरू करें जो हिल नहीं सकते। डेटा-निवास (residency) नियमों के लिए एक ही क्षेत्र ज़रूरी हो सकता है। सॉफ़्टवेयर लाइसेंस इंस्टेंस टाइप सीमित कर सकते हैं। परफ़ॉर्मेंस की ज़रूरतें किसी सेवा को एक GPU फ़ैमिली या लोकल स्टोरेज से बाँध सकती हैं। ये पाबंदियाँ तय करती हैं कि असल में कितने विकल्प उपलब्ध हैं।
फिर इन सवालों के जवाब दें:
- कौन-से कोटा विकास को रोक सकते हैं, और आख़िरी बार कब जाँचे गए थे?
- कौन-से वैकल्पिक मशीन टाइप वाक़ई परखे गए हैं?
- क्या वर्कलोड डेटा, लेटेंसी, या लाइसेंसिंग की ज़रूरतों को तोड़े बिना दूसरे ज़ोन का इस्तेमाल कर सकता है?
- बेस्ट-एफ़र्ट आवंटन के बजाय किन घटनाओं के लिए रिज़र्व की गई क्षमता चाहिए?
- जब नई क्षमता उपलब्ध न हो, तो आने वाले काम का क्या होता है?
- क्या रिकवरी योजना सिर्फ़ एक डेमो इंस्टेंस नहीं, बल्कि पूरा ज़रूरी फ़्लीट आवंटित कर सकती है?
- क्या ऑटोमेशन किसी क्षमता त्रुटि को पहचानकर कोई मंज़ूर विकल्प चुनता है, या बस हमेशा दोबारा कोशिश करता रहता है?
हर सिस्टम को कई क्षेत्रों या रिज़र्व किए हार्डवेयर की ज़रूरत नहीं होती। कोई छोटी अंदरूनी सेवा किसी सीज़नल पीक के दौरान पेमेंट प्लेटफ़ॉर्म से ज़्यादा जोखिम झेल सकती है। यह फ़ैसला सोच-समझकर लिया जाना चाहिए, जहाँ सुरक्षा की लागत की तुलना क्षमता के इंतज़ार के बिज़नेस असर से की जाए।
टीमों को क्या सीखना चाहिए
जो लोग क्लाउड सिस्टम मंज़ूर या डिज़ाइन करते हैं, उन्हें क्षेत्रीय सेवा कवरेज, अकाउंट कोटा, मौजूदा भौतिक क्षमता, रिज़र्वेशन, और एप्लिकेशन उपलब्धता के बीच का फ़र्क़ समझना चाहिए।
क्लाउड, प्लेटफ़ॉर्म, और रिलायबिलिटी इंजीनियरों को कोटा, वैकल्पिक कॉन्फ़िगरेशन, स्केलिंग व्यवहार, रिज़र्वेशन, और असली रिकवरी टेस्ट का व्यावहारिक अनुभव चाहिए। बड़े एक्सेलेरेटर फ़्लीट या अहम प्लेटफ़ॉर्म के लिए ज़िम्मेदार इंजीनियरों को प्लेसमेंट पाबंदियों और क्षमता प्रतिबद्धताओं की गहरी समझ चाहिए, क्योंकि छोटे डिज़ाइन फ़ैसले फ़ॉलबैक विकल्प हटा सकते हैं।
यह विषय इस बारे में अनुमान लगाने का नहीं है कि क्या कोई क्लाउड प्रोवाइडर इंफ़्रास्ट्रक्चर से बाहर हो जाएगा। यह किसी एक वर्कलोड के अंदर छुपी मान्यताओं को खोजने के बारे में है।
अगले माइग्रेशन, सेल, या रिकवरी अभ्यास से पहले, एक सटीक सवाल पूछें: अगर पसंदीदा संसाधन चुनी गई जगह पर आवंटित नहीं हो पाता, तो सिस्टम क्या करेगा?
अगर किसी ने इस जवाब की जाँच नहीं की है, तो क्षमता योजना अधूरी है।
संदर्भ और आगे पढ़ने के लिए
- Energy demand from AI — International Energy Agency. डेटा-सेंटर बिजली इस्तेमाल और क्षमता विस्तार के पीछे के इंफ़्रास्ट्रक्चर के अनुमान।
- Troubleshoot Amazon EC2 instance launch issues — AWS. अपर्याप्त-क्षमता लॉन्च त्रुटियों के कारण और समाधान।
- Troubleshoot Azure VM allocation failures — Microsoft. जगह, VM साइज़, और डिप्लॉयमेंट पाबंदियाँ आवंटन को कैसे प्रभावित करती हैं।
- Troubleshooting resource availability errors — Google Cloud. ज़ोनल संसाधन कमी और उपलब्ध समाधान।
- EC2 On-Demand Capacity Reservations — AWS. ज़ोनल कैपेसिटी रिज़र्वेशन कैसे काम करते हैं।
- Compute Engine reservations overview — Google Cloud. Compute Engine रिज़र्व किए संसाधनों की जाँच और होल्डिंग कैसे करता है।