

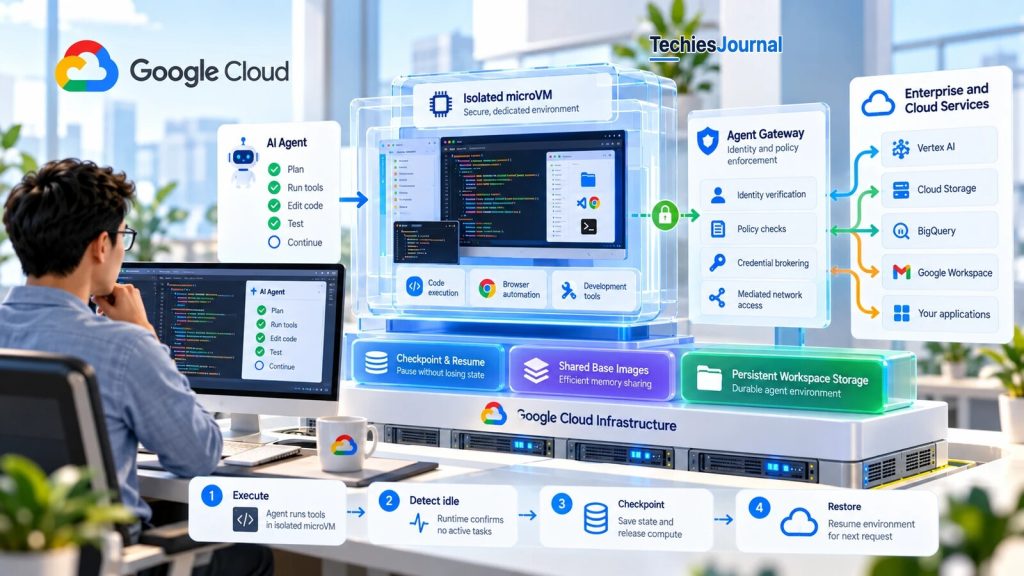
Ilustración de la arquitectura que describe el artículo: un agente, su microVM aislada, el gateway que media el acceso y el almacenamiento de checkpoints, de imágenes compartidas y del espacio de trabajo. Es conceptual, no un diagrama oficial de Google Cloud, y no muestra un rendimiento medido.
Agent Compute Engine de Google combina microVM aisladas por hardware, ejecución basada en checkpoints, memoria compartida y permisos que se aplican desde fuera. La arquitectura aborda un problema difícil de la ejecución de grandes flotas de agentes autónomos: cómo conservar la computadora de trabajo de un agente mientras se liberan los recursos que ya no necesita.
Los agentes necesitan una computadora de trabajo que no retenga capacidad de cómputo mientras están inactivos
Un agente de programación puede pasar varios minutos compilando un proyecto, ejecutar pruebas, revisar los resultados y luego esperar la respuesta de un desarrollador. Cuando el desarrollador vuelve, el agente necesita intactos sus archivos, las dependencias instaladas y el entorno de ejecución. Ejecutar ese entorno en una máquina virtual dedicada es sencillo, pero gestionar cientos de miles de entornos similares es un problema distinto.
Cada agente necesita aislamiento porque puede ejecutar código generado o desconocido. También necesita un espacio de trabajo que sobreviva entre tareas. Pero mantener CPU y memoria asignadas a cada agente en espera encarece cada vez más la infraestructura, incluso cuando apenas se está trabajando.
El 22 de octubre de 2026, Google presentó Agent Compute Engine, una arquitectura de cómputo gestionada, desarrollada para cargas de trabajo con estas características. La plataforma ya da soporte a los sistemas internos de Google Gemini, Antigravity y de evaluación de agentes, y hay prevista una versión preliminar para clientes externos en los próximos meses.
El enfoque de Google es notable porque trata el entorno de ejecución de un agente como un recurso persistente que puede separarse de la máquina física que lo ejecuta. En lugar de reservar de forma continua capacidad de cómputo para cada sesión, la plataforma puede conservar el estado de un entorno, liberar sus recursos activos y restaurarlo cuando el agente necesita continuar. La ingeniería que hay detrás de ese comportamiento es más compleja que meter sin más un agente de IA dentro de un contenedor.
El harness se queda fuera del sandbox que ejecuta sus comandos
La arquitectura de Google empieza por separar un agente en dos componentes. El harness gestiona la interacción con el modelo de IA y decide qué herramientas invocar y qué acciones intentar. El sandbox ejecuta esas acciones y proporciona el entorno de sistema operativo necesario para ejecutar comandos, manipular archivos, instalar software y usar herramientas de navegador.
Piensa en un agente que trabaja en un repositorio de software. El harness puede decidir ejecutar un conjunto de pruebas, pero la compilación y las pruebas se realizan dentro del sandbox.
Agent Compute Engine usa una microVM dedicada para ese entorno de ejecución. A diferencia de un contenedor corriente, que normalmente comparte el kernel del sistema operativo del host, la microVM tiene su propio kernel invitado detrás de una frontera de virtualización por hardware. Esto importa cuando los agentes de programación requieren privilegios de root, herramientas de desarrollo personalizadas o la capacidad de ejecutar código que no puede darse por confiable.
Google describe sus microVM como entornos de ejecución de un solo inquilino (single-tenant), con protecciones de seguridad respaldadas por su infraestructura Titanium. El harness opera fuera del sandbox, de modo que el entorno que ejecuta comandos potencialmente inseguros no controla también el proceso de orquestación de confianza. Esta separación crea una frontera operativa útil, porque el sistema puede gestionar, suspender o reemplazar un sandbox con independencia del harness que dirige el trabajo del agente.
Un agente pasa a estar inactivo cuando el runtime informa de que no queda trabajo
La actividad de un agente no se parece a la de un servicio web convencional que recibe una solicitud, devuelve una respuesta y se olvida de su entorno de ejecución. Un agente puede alternar repetidamente entre ejecutar herramientas y esperar la inferencia del modelo, servicios externos o la intervención humana. Un hipervisor de máquinas virtuales de propósito general puede observar el uso de recursos, pero no necesariamente entiende si un invitado está esperando la siguiente instrucción del agente o ejecutando una tarea legítima en segundo plano.
Google lo resuelve conectando el runtime de comandos del sandbox con el ejecutor del host. Cuando termina una llamada a una herramienta, el runtime puede determinar si quedan comandos activos o tareas en segundo plano. Cuando el entorno alcanza un estado de inactividad seguro, el sandbox comunica esa condición al host.
Entonces el host puede guardar un checkpoint (un punto de restauración) de la microVM en lugar de mantener reservados sus recursos de ejecución. Cuando el harness emite otra llamada a una herramienta, el entorno se restaura y la ejecución se reanuda.
El mecanismo clave es la detección de inactividad consciente de la aplicación. La infraestructura no se limita a suponer, a partir de una baja utilización de CPU, que el entorno puede suspenderse, porque recibe información de ciclo de vida del runtime de ejecución del agente. Esto importa porque un proceso puede consumir casi nada de CPU mientras espera actividad de red o un evento externo y aun así estar haciendo un trabajo necesario.
Por qué poca CPU no equivale a inactividad
Escenario: un proceso espera actividad de red o un evento externo. Selecciona cómo decide la infraestructura y mira qué puede saber cada enfoque.
Suposición solo por CPU
Qué ve
- El proceso en espera casi no usa CPU, así que el entorno parece inactivo.
- Un hipervisor de propósito general puede observar el uso de recursos.
Qué no puede saber
- Si el proceso sigue haciendo un trabajo necesario, porque un proceso puede estar esperando actividad de red o un evento externo y aun así hacer falta.
- Si el invitado está esperando la siguiente instrucción del agente o ejecutando una tarea legítima en segundo plano.
Inactividad informada por el runtime
Qué ve
- Cuando termina una llamada a una herramienta, el runtime comprueba si quedan comandos activos o tareas en segundo plano.
- Si no queda ninguno, el sandbox comunica inactividad segura al host, que puede guardar un checkpoint de la microVM.
Qué no puede saber
- Una suposición a partir del uso de CPU, porque la infraestructura recibe información de ciclo de vida del runtime de ejecución del agente.
- Una garantía de que las conexiones activas sigan sin cambios durante la suspensión.
Google describe la suspensión cuando no hay comandos activos ni tareas en segundo plano en curso. Eso no demuestra que cualquier proceso en segundo plano y las conexiones activas sigan sin cambios mientras un entorno está suspendido, así que los clientes deben probar el comportamiento de las tareas en segundo plano, la recuperación de conexiones y las garantías de restauración.
Google describe la suspensión cuando no hay comandos activos ni tareas en segundo plano en curso. Eso no demuestra que cualquier proceso en segundo plano y las conexiones activas vayan a seguir funcionando sin cambios mientras un entorno está suspendido. Para los clientes que evalúen el futuro servicio, el comportamiento de las tareas en segundo plano, la recuperación de conexiones y las garantías de restauración necesitarán pruebas explícitas.
Diagrama conceptual de TechiesJournal del mecanismo que describe Google, no un diagrama oficial de Google Cloud.
Versión en texto de la figura 1
- El harness solicita la ejecución de una herramienta.
- Una microVM aislada ejecuta el comando.
- Si todavía hay comandos o tareas en segundo plano activos, la microVM sigue ejecutando el trabajo.
- Si no hay ninguno activo, el runtime informa de inactividad segura.
- El host guarda un checkpoint del estado de ejecución.
- Se liberan los recursos de cómputo activos.
- Llega la siguiente solicitud de herramienta.
- Se restaura el estado de la microVM y se ejecuta el comando, lo que devuelve el flujo al segundo paso.
La memoria base compartida hace viable restaurar muchos entornos
Los checkpoints solo son útiles a escala si muchos entornos pueden restaurarse rápidamente sin consumir memoria en exceso. Un enfoque convencional podría inicializar un sistema operativo invitado independiente, cargar Python, iniciar procesos de navegador e instalar herramientas comunes para cada sandbox, y buena parte de esa inicialización repite un trabajo idéntico.
En cambio, Google usa instantáneas (snapshots) precalentadas que ya contienen componentes del sistema operativo, bibliotecas y runtimes de herramientas inicializados. El host mapea en memoria las partes compartidas, y en gran medida inmutables, de esas instantáneas mediante Direct Access (DAX), de modo que varias microVM pueden hacer referencia a esas páginas físicas sin que cada una conserve una copia completa propia. Cuando un agente modifica la memoria, la copia en escritura (copy-on-write, CoW) le permite recibir páginas privadas para sus modificaciones mientras los demás agentes siguen usando las páginas base comunes.
Imagina 500 entornos de agente que usan la misma imagen de sistema operativo, el mismo runtime de Python y los mismos binarios de navegador. No hace falta que cada uno de los componentes compartidos ocupe una asignación independiente de memoria física, y el uso de memoria crece sobre todo con los datos privados y las modificaciones propias de cada entorno. Google también describe la recuperación (reclaim) y la compresión de memoria para recobrar recursos a medida que cambian las cargas de trabajo.
Aritmética de la memoria base compartida
Esta es una ilustración aritmética con valores que eliges tú, no una medición de Google. Considera que la memoria base compartida equivale a 100 unidades. Después, cada entorno añade sus propias páginas privadas, contadas en las mismas unidades abstractas. Elige un número de entornos y una cantidad privada para comparar una sola base compartida con una copia completa para cada entorno.
1 entorno
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 1 × 10 unidades privadas, lo que da 110 unidades en total.
Una copia completa para cada entorno: 1 × (100 + 10) unidades, lo que da 110 unidades en total.
Base compartida: 110 unidades. Copia completa por entorno: 110 unidades.
Con un solo entorno no hay nada que compartir, así que ambos totales coinciden.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 1 × 30 unidades privadas, lo que da 130 unidades en total.
Una copia completa para cada entorno: 1 × (100 + 30) unidades, lo que da 130 unidades en total.
Base compartida: 130 unidades. Copia completa por entorno: 130 unidades.
Con un solo entorno no hay nada que compartir, así que ambos totales coinciden.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 1 × 60 unidades privadas, lo que da 160 unidades en total.
Una copia completa para cada entorno: 1 × (100 + 60) unidades, lo que da 160 unidades en total.
Base compartida: 160 unidades. Copia completa por entorno: 160 unidades.
Con un solo entorno no hay nada que compartir, así que ambos totales coinciden.
10 entornos
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 10 × 10 unidades privadas, lo que da 200 unidades en total.
Una copia completa para cada entorno: 10 × (100 + 10) unidades, lo que da 1100 unidades en total.
Base compartida: 200 unidades. Copia completa por entorno: 1100 unidades.
La base no se repite en 9 entornos, así que la diferencia es de 900 unidades.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 10 × 30 unidades privadas, lo que da 400 unidades en total.
Una copia completa para cada entorno: 10 × (100 + 30) unidades, lo que da 1300 unidades en total.
Base compartida: 400 unidades. Copia completa por entorno: 1300 unidades.
La base no se repite en 9 entornos, así que la diferencia es de 900 unidades.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 10 × 60 unidades privadas, lo que da 700 unidades en total.
Una copia completa para cada entorno: 10 × (100 + 60) unidades, lo que da 1600 unidades en total.
Base compartida: 700 unidades. Copia completa por entorno: 1600 unidades.
La base no se repite en 9 entornos, así que la diferencia es de 900 unidades.
100 entornos
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 100 × 10 unidades privadas, lo que da 1100 unidades en total.
Una copia completa para cada entorno: 100 × (100 + 10) unidades, lo que da 11 000 unidades en total.
Base compartida: 1100 unidades. Copia completa por entorno: 11 000 unidades.
La base no se repite en 99 entornos, así que la diferencia es de 9900 unidades.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 100 × 30 unidades privadas, lo que da 3100 unidades en total.
Una copia completa para cada entorno: 100 × (100 + 30) unidades, lo que da 13 000 unidades en total.
Base compartida: 3100 unidades. Copia completa por entorno: 13 000 unidades.
La base no se repite en 99 entornos, así que la diferencia es de 9900 unidades.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 100 × 60 unidades privadas, lo que da 6100 unidades en total.
Una copia completa para cada entorno: 100 × (100 + 60) unidades, lo que da 16 000 unidades en total.
Base compartida: 6100 unidades. Copia completa por entorno: 16 000 unidades.
La base no se repite en 99 entornos, así que la diferencia es de 9900 unidades.
500 entornos
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 500 × 10 unidades privadas, lo que da 5100 unidades en total.
Una copia completa para cada entorno: 500 × (100 + 10) unidades, lo que da 55 000 unidades en total.
Base compartida: 5100 unidades. Copia completa por entorno: 55 000 unidades.
La base no se repite en 499 entornos, así que la diferencia es de 49 900 unidades.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 500 × 30 unidades privadas, lo que da 15 100 unidades en total.
Una copia completa para cada entorno: 500 × (100 + 30) unidades, lo que da 65 000 unidades en total.
Base compartida: 15 100 unidades. Copia completa por entorno: 65 000 unidades.
La base no se repite en 499 entornos, así que la diferencia es de 49 900 unidades.
Páginas base compartidas, guardadas una sola vez: 100 unidades, más 500 × 60 unidades privadas, lo que da 30 100 unidades en total.
Una copia completa para cada entorno: 500 × (100 + 60) unidades, lo que da 80 000 unidades en total.
Base compartida: 30 100 unidades. Copia completa por entorno: 80 000 unidades.
La base no se repite en 499 entornos, así que la diferencia es de 49 900 unidades.
El beneficio depende de cuánto estado puede compartirse realmente, y una cantidad privada mayor por entorno lo reduce. La publicación técnica de Google establece el mecanismo, pero no aporta datos de rendimiento de clientes medidos de forma independiente.
Por eso la arquitectura ataca dos formas de desperdicio a la vez: la capacidad de cómputo reservada para agentes inactivos y la memoria duplicada entre agentes con entornos de software en gran medida idénticos.
El beneficio en eficiencia depende de cuánto estado puede compartirse realmente. Los agentes que ejecutan pilas de software muy personalizadas, mantienen grandes regiones de memoria privada o modifican partes sustanciales de su entorno pueden lograr compartir menos memoria que los agentes que usan imágenes comunes precalentadas. La publicación técnica de Google establece el mecanismo, pero no aporta datos de rendimiento de clientes medidos de forma independiente para estos distintos perfiles de carga de trabajo.
Los archivos duraderos del espacio de trabajo se guardan aparte del estado desechable
Conservar el estado de ejecución no es lo mismo que decidir qué archivos deben sobrevivir durante días o semanas. Un agente de programación puede crear salidas temporales del compilador, usar cadenas de herramientas comunes y modificar un repositorio privado, y esas categorías de datos tienen requisitos de persistencia distintos. La arquitectura de Google distingue tres tipos de almacenamiento.
Los registros (logs) temporales, los artefactos de compilación y los cambios continuos del sistema operativo pueden residir en capas superpuestas (overlays) desechables. Son útiles durante la ejecución, pero no necesariamente hay que conservarlos a largo plazo.
Las herramientas compartidas, las imágenes base y las cachés de paquetes pueden ofrecerse mediante un almacenamiento común de solo lectura. Esto reduce las descargas repetidas y la duplicación innecesaria entre sandboxes.
Los archivos propios del agente y su trabajo guardado forman un espacio de trabajo duradero. Esa es la información que debe seguir disponible cuando el agente se reanude mañana o después de que cambie el entorno de cómputo subyacente. Google describe el uso de almacenamiento Hyperdisk cifrado para estos requisitos, con volúmenes compartidos y acceso respaldado por Cloud Storage disponibles cuando corresponda.
Qué guarda cada nivel de almacenamiento
Selecciona un tipo de datos para ver dónde lo coloca la arquitectura de Google, cuánto tiempo debe durar y por qué.
Salida del compilador
Dónde reside
- Nivel: capa superpuesta desechable.
- Duración: útil durante la ejecución.
- Por qué: los registros temporales, los artefactos de compilación y los cambios continuos del sistema operativo no necesariamente hay que conservarlos a largo plazo.
Qué no necesita
- Conservación a largo plazo.
Runtime de Python y cadenas de herramientas
Dónde reside
- Nivel: almacenamiento compartido de solo lectura.
- Alcance: común a muchos sandboxes.
- Por qué: las herramientas compartidas y las imágenes base reducen las descargas repetidas y la duplicación innecesaria.
Qué no necesita
- Una copia independiente para cada sandbox.
Caché de paquetes
Dónde reside
- Nivel: almacenamiento compartido de solo lectura.
- Alcance: común a muchos sandboxes.
- Por qué: las cachés de paquetes que se ofrecen mediante almacenamiento común reducen las descargas repetidas.
Qué no necesita
- Un disco convencional, aprovisionado de forma independiente, para cada agente inactivo.
Cambios en el repositorio
Dónde reside
- Nivel: espacio de trabajo duradero.
- Duración: debe seguir disponible cuando el agente se reanude mañana o después de que cambie el entorno de cómputo subyacente.
- Por qué: son los archivos propios del agente y su trabajo guardado. Google describe almacenamiento Hyperdisk cifrado para esta necesidad, con volúmenes compartidos y acceso respaldado por Cloud Storage cuando corresponda.
Qué no necesita
- Desecharse junto con el estado temporal.
Google distingue tres tipos de almacenamiento. Aun así, los clientes necesitarán garantías documentadas de recuperación y coherencia antes de confiar en el servicio gestionado para cargas de trabajo de producción.
Esa distinción evita un error de arquitectura habitual: tratar cada byte que crea un entorno de desarrollo como si todos fueran igual de importantes. También evita conectar un disco convencional, aprovisionado de forma independiente, a cada agente inactivo cuando gran parte del software subyacente es idéntico o temporal. Como los hosts no guardan estado local persistente, el espacio de trabajo de un agente no está atado al host concreto en el que se ejecutaron sus comandos por última vez.
La arquitectura combina los datos duraderos del espacio de trabajo con el estado de ejecución guardado en checkpoints, aunque los clientes seguirán necesitando garantías documentadas de recuperación y coherencia antes de confiar en el servicio gestionado para cargas de trabajo de producción.
Las credenciales se quedan fuera del sandbox no confiable
Un sandbox persistente plantea otro desafío. Cuanto más tiempo existe un entorno, más oportunidades puede tener de toparse con instrucciones hostiles, dependencias vulnerables o herramientas comprometidas. El diseño de Google parte de que el software dentro del invitado podría estar comprometido, incluso con acceso de nivel root.
Por eso la arquitectura declarada evita colocar dentro del sandbox credenciales de usuario de larga duración, tokens de actualización de OAuth y claves de cuentas de servicio de la nube. Cada microVM recibe una identidad de carga de trabajo efímera basada en SPIFFE. Esa identidad establece qué sandbox originó una solicitud, pero por sí sola no proporciona acceso sin restricciones a un servicio de backend.
La ruta de red está diseñada en torno a esa distinción. Un sandbox no tiene una interfaz de red externa corriente ni acceso directo a la VPC. Las solicitudes salen por un canal punto a punto virtio-vsock, pasan por un proxy de mediación local y llegan a un Agent Gateway externo.
El gateway valida la identidad del sandbox, la identidad del nodo (respaldada por la atestación del host) y la delegación de usuario correspondiente antes de aplicar las políticas de acceso saliente. Para un destino aprobado, el gateway puede añadir a la solicitud saliente la credencial de backend necesaria sin devolver esa credencial al sandbox.
Piensa en un agente empresarial al que se le pide leer un documento aprobado. El sandbox puede solicitar el documento, pero la decisión de autorización se toma fuera del entorno que ejecuta las herramientas del agente, y la solicitud debe cumplir los permisos delegados del usuario y la política que rige ese recurso. La frontera de seguridad no consiste simplemente en que el agente tenga una identidad válida. Consiste en que la identidad, la delegación y la autorización se evalúan por separado.
El diseño más amplio de Google incluye la identidad de usuario, la identidad de agente delegado, la identidad de carga de trabajo de corta duración y la identidad de personal (workforce identity) propia del agente. No son cuatro credenciales intercambiables, porque representan relaciones distintas: quién inició la tarea, qué autoridad se delegó, qué entorno de ejecución envió una solicitud y si un agente tiene una identidad organizativa gestionada de forma independiente.
| Identidad | Relación que representa |
|---|---|
| Identidad de usuario | Quién inició la tarea |
| Identidad de agente delegado | Qué autoridad se delegó |
| Identidad de carga de trabajo de corta duración | Qué entorno de ejecución envió una solicitud, sin proporcionar por sí sola acceso sin restricciones a un servicio de backend |
| Identidad de personal del agente | Si un agente tiene una identidad organizativa gestionada de forma independiente |
El diseño reduce el riesgo de que se roben credenciales reutilizables directamente de un sandbox comprometido. No elimina la posibilidad de un uso indebido a través de una interfaz autorizada, porque un agente mal dirigido aún puede solicitar una acción inapropiada, y las comprobaciones de permisos del gateway y el alcance de la delegación del cliente siguen siendo críticos.
Diagrama conceptual de TechiesJournal de las fronteras que describe Google, no un diagrama oficial de Google Cloud.
Versión en texto de la figura 2
- El usuario y su autoridad delegada inician el trabajo a través del harness de agente de confianza.
- El harness envía solicitudes de herramientas al sandbox de microVM aislada y recibe los resultados de la ejecución.
- El sandbox intercambia archivos persistentes con el espacio de trabajo duradero.
- El sandbox se suspende en el checkpoint y el estado base compartido, y se restaura desde ellos.
- Las solicitudes salientes salen del sandbox por virtio-vsock hacia un proxy de mediación, que las pasa al Agent Gateway.
- El Agent Gateway aplica identidad y política, usa la autoridad delegada del usuario como contexto de autorización y reenvía las solicitudes aprobadas a los servicios empresariales y de nube.
Leer un documento aprobado, paso a paso
Sigue a un agente empresarial al que se le pide leer un documento aprobado. Selecciona un paso para ver qué se comprueba o qué ocurre, y qué no tiene el sandbox.
1. Solicitud
- 1Solicitud del sandbox (paso actual)
- 2virtio-vsock
- 3Proxy de mediación
- 4Agent Gateway
- 5Credencial añadida
- 6Servicio
Qué se comprueba o qué ocurre
- El sandbox solicita el documento aprobado.
- Su identidad de carga de trabajo SPIFFE efímera establece qué sandbox originó la solicitud.
Lo que el sandbox no tiene ni hace
- Credenciales de usuario de larga duración, tokens de actualización de OAuth o claves de cuentas de servicio de la nube.
- Acceso sin restricciones a un servicio de backend, porque la identidad de carga de trabajo no lo proporciona por sí sola.
2. virtio-vsock
- 1Solicitud del sandbox
- 2virtio-vsock (paso actual)
- 3Proxy de mediación
- 4Agent Gateway
- 5Credencial añadida
- 6Servicio
Qué se comprueba o qué ocurre
- La solicitud sale por un canal virtio-vsock punto a punto.
Lo que el sandbox no tiene ni hace
- Una interfaz de red externa corriente.
- Acceso directo a la VPC.
3. Proxy de mediación
- 1Solicitud del sandbox
- 2virtio-vsock
- 3Proxy de mediación (paso actual)
- 4Agent Gateway
- 5Credencial añadida
- 6Servicio
Qué se comprueba o qué ocurre
- La solicitud pasa por un proxy de mediación local.
- El proxy la reenvía al Agent Gateway externo.
Lo que el sandbox no tiene ni hace
- Una ruta directa del sandbox al servicio.
4. Agent Gateway
- 1Solicitud del sandbox
- 2virtio-vsock
- 3Proxy de mediación
- 4Agent Gateway (paso actual)
- 5Credencial añadida
- 6Servicio
Qué se comprueba o qué ocurre
- El gateway valida la identidad del sandbox, la identidad del nodo (respaldada por la atestación del host) y la delegación de usuario correspondiente.
- Después aplica las políticas de acceso saliente, de modo que la decisión de autorización se toma fuera del entorno que ejecuta las herramientas del agente.
Lo que el sandbox no tiene ni hace
- Una decisión basada solo en la identidad, porque la identidad, la delegación y la autorización se evalúan por separado.
5. Credencial añadida
- 1Solicitud del sandbox
- 2virtio-vsock
- 3Proxy de mediación
- 4Agent Gateway
- 5Credencial añadida (paso actual)
- 6Servicio
Qué se comprueba o qué ocurre
- Para un destino aprobado, el gateway puede añadir a la solicitud saliente la credencial de backend necesaria.
Lo que el sandbox no tiene ni hace
- La credencial no se devuelve al sandbox.
6. Servicio
- 1Solicitud del sandbox
- 2virtio-vsock
- 3Proxy de mediación
- 4Agent Gateway
- 5Credencial añadida
- 6Servicio (paso actual)
Qué se comprueba o qué ocurre
- La solicitud aprobada llega al servicio empresarial o de nube.
Lo que el sandbox no tiene ni hace
- Protección frente a una solicitud mal dirigida que aun así está autorizada, porque eso depende de las comprobaciones de permisos del gateway y del alcance de la delegación.
En ningún paso tiene el sandbox la credencial de backend. Una solicitud autorizada pero mal dirigida aún puede causar daño, así que las comprobaciones de permisos del gateway y el alcance de la delegación del cliente siguen siendo críticos.
La planificación global reparte la capacidad entre distintos tipos de agentes
Suspender los sandboxes inactivos resuelve el consumo de recursos dentro de una sesión de agente. Google también describe un desafío de planificación mayor, porque distintos tipos de agentes demandan capacidad de cómputo en momentos distintos. Los asistentes para consumidores, los agentes empresariales y las cargas de trabajo de evaluación no necesariamente alcanzan su pico de demanda al mismo tiempo.
Los usuarios interactivos esperan respuestas rápidas, mientras que algunas tareas programadas, evaluaciones y cargas de trabajo de aprendizaje por refuerzo toleran una ejecución diferida. El diseño de Google usa un grupo (pool) de infraestructura compartida con una planificación global que tiene en cuenta la capacidad disponible, las restricciones geográficas, los requisitos de cumplimiento normativo y la prioridad de cada carga de trabajo. Cuando sube la demanda interactiva, el trabajo de evaluación de menor prioridad puede ceder capacidad, y cuando la demanda baja, las tareas diferidas pueden usar recursos que de otro modo quedarían inactivos.
Este es un mecanismo de eficiencia distinto de los checkpoints. Los checkpoints aumentan cuántas sesiones persistentes pueden compartir capacidad de cómputo activa a lo largo del tiempo, y la planificación determina qué cargas de trabajo reciben esa capacidad y cuándo.
La distinción importa porque una gran flota interna se beneficia de ambos. En despliegues más pequeños, esa misma sofisticación en la planificación puede aportar poco valor adicional, mientras que en cargas de trabajo con muchos miles de sesiones interactivas y tareas de evaluación en paralelo puede influir en la planificación de capacidad y en la capacidad de respuesta del servicio. Google todavía no ha publicado suficientes datos operativos de clientes externos para cuantificar qué parte de este beneficio estará disponible a través del servicio gestionado.
Agent Substrate aborda un problema relacionado en Kubernetes
También conviene distinguir Agent Compute Engine de Agent Substrate, una iniciativa anterior de Google. El 15 de septiembre, Google anunció Agent Substrate para entornos basados en Kubernetes. Proporciona una capa de ejecución orientada a agentes mediante mecanismos como sandboxes aislados, suspensión y restauración rápidas, y gestión del ciclo de vida fuera de la ruta habitual de planificación de Pods de Kubernetes.
Esta decisión de arquitectura aborda un problema concreto. Kubernetes es eficaz gestionando máquinas y cargas de trabajo de aplicaciones, pero crear o reiniciar un Pod a través de su plano de control de propósito general para cada breve llamada a una herramienta de un agente puede introducir una latencia innecesaria. Agent Substrate deja en manos de Kubernetes la gestión de nodos, el escalado automático y la fiabilidad de la flota, y gestiona la activación frecuente de sandboxes mediante una capa de ejecución dedicada.
Google informa de menos de 500 milisegundos en las operaciones de reanudación y de una densidad de cómputo hasta diez veces mayor que la de los runtimes de contenedores convencionales, según las pruebas que la propia Google ha comunicado. Se trata de resultados de Agent Substrate, no de benchmarks de Agent Compute Engine verificados de forma independiente. Según las notas de la versión de septiembre de Google, Agent Substrate está disponible para evaluación y para cargas de trabajo que no son de producción, con soporte para producción mediante un programa limitado de lista de permitidos (allowlist).
Agent Compute Engine apunta a un modelo operativo distinto, en el que Google gestiona como servicio la flota de sandboxes subyacente, mientras los clientes configuran sus imágenes de ejecución, identidades, redes y requisitos de ciclo de vida. Por tanto, la diferencia tiene que ver en parte con la responsabilidad. Un equipo de plataforma que opera su propio entorno de Kubernetes puede querer controlar la capa de ejecución, mientras que una organización que prefiere no gestionar infraestructura de sandboxes puede encontrar atractivo un servicio gestionado una vez que sus capacidades y condiciones de operación puedan evaluarse.
| Aspecto | Agent Compute Engine | Agent Substrate |
|---|---|---|
| Quién opera la flota | Google gestiona como servicio la flota de sandboxes subyacente, y los clientes configuran las imágenes de ejecución, las identidades, las redes y los requisitos de ciclo de vida | Entornos basados en Kubernetes, donde la gestión de nodos, el escalado automático y la fiabilidad de la flota siguen en manos de Kubernetes |
| Capa de ejecución | Sandboxes dedicados en microVM con suspensión y restauración basadas en checkpoints | Una capa de ejecución orientada a agentes fuera de la ruta habitual de planificación de Pods de Kubernetes, con sandboxes aislados y suspensión y restauración rápidas |
| Disponibilidad | Google la usa internamente para Gemini, Antigravity y la evaluación de agentes, con una versión preliminar para clientes externos prevista en los próximos meses | Según las notas de la versión de septiembre de Google, disponible para evaluación y para cargas de trabajo que no son de producción, con soporte para producción mediante un programa limitado de lista de permitidos |
| Cifras comunicadas por Google | Ninguna citada en este artículo para Agent Compute Engine | Reanudación en menos de 500 milisegundos y una densidad de cómputo hasta diez veces mayor que la de los runtimes de contenedores convencionales, según las pruebas que la propia Google ha comunicado. Cifras comunicadas por Google para Agent Substrate, no verificadas, y no son un benchmark de Agent Compute Engine |
El anuncio no deja obsoleta la infraestructura de cómputo actual
El anuncio no deja obsoletas las máquinas virtuales, los contenedores ni la computación sin servidor (serverless). Un agente sencillo que hace llamadas a API, guarda el estado de las tareas en una base de datos y ejecuta trabajos cortos puede encajar muy bien en la infraestructura existente.
Las plataformas de ejecución especializadas cobran más relevancia cuando el propio entorno debe sobrevivir entre interacciones, cuando los agentes ejecutan código no confiable que requiere un aislamiento fuerte o cuando un gran número de sesiones independientes se pausan y se reanudan repetidamente. Por tanto, la comparación de arquitecturas se reduce al costo de gestionar el estado y el aislamiento.
Una plataforma de contenedores convencional puede obligar a las aplicaciones a reconstruir el estado de ejecución tras un reinicio. Una VM persistente puede evitar esa reconstrucción, pero puede reservar más recursos de los que necesita una carga de trabajo intermitente. Un runtime de sandbox diseñado para este fin intenta conservar el estado de ejecución mientras libera recursos entre los periodos de actividad.
| Opción | Gestión del estado y costo de reinicio | Recursos en inactividad | Aislamiento según se describe |
|---|---|---|---|
| Plataforma de contenedores | Puede que las aplicaciones tengan que reconstruir el estado de ejecución tras un reinicio | No se compara en el artículo | Los contenedores corrientes normalmente comparten el kernel del sistema operativo del host |
| Máquina virtual persistente | Puede evitar reconstruir el estado de ejecución | Puede reservar más recursos de los que necesita una carga de trabajo intermitente | No se compara en el artículo |
| Runtime de sandbox diseñado para este fin | Intenta conservar el estado de ejecución | Intenta liberar recursos entre los periodos de actividad | Una microVM de Agent Compute Engine tiene su propio kernel invitado detrás de una frontera de virtualización por hardware |
Google ha demostrado una arquitectura interna pensada para resolver esas contrapartidas. Lo que todavía no ha establecido públicamente es el panorama operativo completo del lado del cliente. El servicio gestionado Agent Compute Engine sigue previsto para una versión preliminar, y los precios, la cobertura regional, las cuotas, las garantías de recuperación para clientes y los benchmarks de cargas de trabajo comparables siguen siendo incógnitas importantes.
Antes de elegir esta arquitectura, los ingenieros deberían medir con qué frecuencia sus agentes ejecutan trabajo realmente, cuánto crece su estado de memoria privada, qué archivos requieren durabilidad, con qué rapidez deben reanudarse las tareas en pausa y qué grado de aislamiento exige su modelo de ejecución. Esas mediciones determinarán si los entornos de microVM con checkpoints ofrecen una ventaja significativa frente a un diseño más sencillo.
Google coordinó mecanismos existentes en torno a cómo se ejecutan realmente los agentes
El avance sustancial de Agent Compute Engine no es la introducción de ninguna primitiva de cómputo nueva. La virtualización por hardware, las instantáneas, la memoria con copia en escritura, los discos persistentes, las identidades de carga de trabajo y la planificación de flotas ya existían antes de este anuncio. La aportación de Google es el uso coordinado de esos mecanismos en torno al patrón de ejecución de los agentes autónomos.
La plataforma trata el espacio de trabajo de un agente como duradero, sus recursos de cómputo activos como temporales y su permiso para acceder a sistemas externos como algo que se aplica fuera de su entorno de ejecución. Vale la pena examinar esa combinación porque aborda problemas operativos reales que surgen a medida que crecen las flotas de agentes. Que el servicio gestionado llegue a ser una opción adecuada para otras organizaciones dependerá de su disponibilidad final, su rendimiento, su costo y sus garantías operativas.
| Elemento | Estado | Fuente |
|---|---|---|
| Uso interno en Gemini, Antigravity y los sistemas de evaluación de agentes | Declarado por Google | Artículo técnico de Google |
| Servicio gestionado para clientes externos | Versión preliminar prevista para los próximos meses, aún no disponible | Artículo técnico y anuncio de Google |
| Mecanismos: aislamiento con microVM, checkpoints, memoria base compartida, niveles de almacenamiento, credenciales mediadas por el gateway y planificación global | Declarado por Google como su diseño | Artículo técnico de Google |
| Precios | No declarado | No figura en las fuentes de Google revisadas |
| Regiones y cuotas | No declarado | No figura en las fuentes de Google revisadas |
| Garantías de recuperación y coherencia para clientes | Aún no establecido públicamente | Revisión de fuentes, 26 de octubre de 2026 |
| Benchmarks de cargas de trabajo comparables | Aún no establecido públicamente | Revisión de fuentes, 26 de octubre de 2026 |
| Tareas en segundo plano y conexiones activas durante la suspensión | No establecido, porque Google describe la suspensión cuando no hay comandos activos ni tareas en segundo plano en curso | Artículo técnico de Google y revisión de fuentes, 26 de octubre de 2026 |
El cambio de ingeniería no es que los agentes requieran un tipo de computadora completamente nuevo. Es que la infraestructura de nube quizá tenga que gestionar la vida útil de la computadora de un agente de forma distinta a la de los recursos de cómputo que la ejecutan.
Para profundizar
Revisión de fuentes: 26 de octubre de 2026. Las descripciones de la arquitectura interna y del rendimiento de Google se atribuyen a Google. El rendimiento y las garantías operativas de la versión preliminar para clientes no se han verificado de forma independiente.
Anuncios y documentación de Google
- Inside Agent Compute Engine: Building the Compute Foundation for the Agentic Era, Ramanathan Venkatapathy y Rohit Jnagal, Google Cloud, 22 de octubre de 2026, la principal fuente técnica sobre el aislamiento de sandboxes, las identidades de carga de trabajo, las instantáneas, la compartición de memoria, la persistencia y la planificación.
- Introducing Agent Compute Engine and Expanded Agent Governance, Google Cloud, 22 de octubre de 2026, el anuncio del producto y la disponibilidad prevista de la versión preliminar externa.
- Agent Substrate brings high-density, scalable, trusted infrastructure to GKE, Alex Zakonov y Tim Hockin, Google Cloud, 15 de septiembre de 2026, la arquitectura del runtime de agentes basado en Kubernetes y los resultados de rendimiento comunicados por el proveedor.
- New feature release notes, Google Kubernetes Engine, entrada del 11 de septiembre de 2026, disponibilidad de Agent Substrate para evaluación y soporte limitado para producción.
Opciones existentes de ejecución aislada
- Azure Container Apps dynamic sessions, Microsoft Learn, documentación de una opción existente de ejecución aislada para código generado por IA y código no confiable.
- Lambda execution environment lifecycle, AWS, documentación que explica la reutilización del entorno de ejecución y los límites de persistencia en un modelo sin servidor.
Este artículo separa el relato de la propia Google, los resultados comunicados por el proveedor y el análisis del autor. Conviene volver a comprobar las informaciones posteriores antes de actuar.
Lecturas relacionadas en TechiesJournal
- Los agentes de IA necesitan identidades, no claves de API, TechiesJournal, 12 de septiembre de 2026, contexto relacionado que explica en qué se diferencian la identidad de un agente y los permisos delegados de la simple posesión de credenciales válidas.
- Cuando los agentes de programación con IA debilitan su propia monitorización: dos incidentes documentados, TechiesJournal, 26 de octubre de 2026, un artículo complementario sobre por qué las salvaguardas necesitan controles fuera del software que supervisan.
- Cuando los agentes de IA encuentran su propio camino: ¿quién define los límites? (en inglés), TechiesJournal, 15 de octubre de 2026, una Perspectiva que sostiene que el problema central de los agentes de IA es la autoridad y no la capacidad, y que los límites deben estar en el entorno y no en los prompts.