

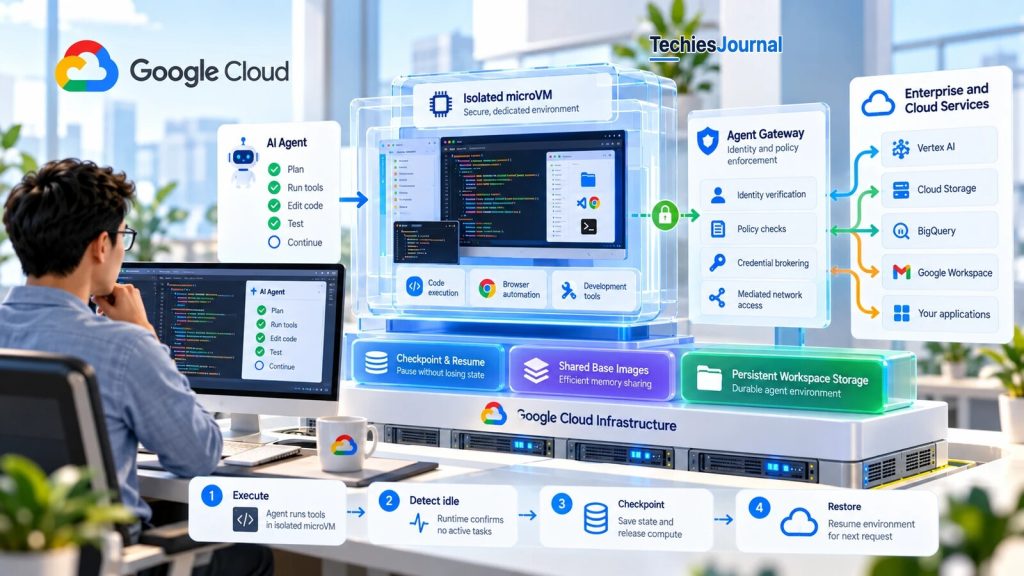
Illustration de l’architecture décrite dans l’article : un agent, sa microVM isolée, la passerelle qui arbitre les accès, ainsi que le stockage des points de reprise, de l’image partagée et de l’espace de travail. Vue conceptuelle, et non un schéma officiel de Google Cloud ; elle ne montre aucune performance mesurée.
L’Agent Compute Engine de Google associe des microVM isolées par le matériel, une exécution fondée sur des points de reprise (checkpoints), une mémoire partagée et des permissions appliquées de l’extérieur. Cette architecture répond à un problème difficile de l’exploitation de grandes flottes d’agents autonomes : comment préserver l’ordinateur de travail d’un agent tout en libérant les ressources dont il n’a plus besoin.
Les agents ont besoin d’un ordinateur de travail qui ne mobilise pas de capacité de calcul au repos
Un agent de développement peut passer plusieurs minutes à compiler un projet, lancer des tests, examiner les résultats, puis attendre la réponse d’un développeur. Quand le développeur revient, l’agent a besoin de retrouver intacts ses fichiers, ses dépendances installées et son environnement d’exécution. Faire tourner cet environnement sur une machine virtuelle dédiée est simple ; gérer des centaines de milliers d’environnements semblables est un tout autre problème.
Chaque agent a besoin d’isolation, car il peut exécuter du code généré ou inconnu. Il lui faut aussi un espace de travail qui subsiste d’une tâche à l’autre. Mais garder du CPU et de la mémoire alloués à chaque agent en attente rend l’infrastructure de plus en plus coûteuse, même lorsque peu de travail est effectué.
Le 22 octobre 2026, Google a présenté Agent Compute Engine, une architecture de calcul gérée conçue pour les charges de travail qui présentent ces caractéristiques. La plateforme prend déjà en charge les systèmes internes de Google pour Gemini, Antigravity et l’évaluation d’agents, et une préversion pour les clients externes est prévue dans les prochains mois.
L’approche de Google mérite l’attention parce qu’elle traite l’environnement d’exécution d’un agent comme une ressource persistante, dissociable de la machine physique qui l’exécute. Au lieu de réserver en permanence de la capacité de calcul pour chaque session, la plateforme peut préserver l’état d’un environnement, libérer ses ressources actives et le restaurer lorsque l’agent doit reprendre. L’ingénierie qui permet ce comportement va bien au-delà du simple fait de placer un agent d’IA dans un conteneur.
Le harnais reste en dehors du bac à sable qui exécute ses commandes
L’architecture de Google commence par séparer un agent en deux composants. Le harnais (harness) gère l’interaction avec le modèle d’IA et décide quels outils invoquer et quelles actions tenter. Le bac à sable (sandbox) exécute ces actions et fournit l’environnement de système d’exploitation nécessaire pour lancer des commandes, manipuler des fichiers, installer des logiciels et utiliser des outils de navigateur.
Prenons un agent qui travaille sur un dépôt de code. Le harnais peut décider de lancer une suite de tests, mais la compilation et les tests ont lieu dans le bac à sable.
Agent Compute Engine utilise une microVM dédiée pour cet environnement d’exécution. Contrairement à un conteneur ordinaire, qui partage normalement le noyau du système d’exploitation de l’hôte, la microVM dispose de son propre noyau invité, derrière une frontière de virtualisation matérielle. C’est important lorsque des agents de développement ont besoin des privilèges root, d’outils de développement personnalisés ou de la possibilité d’exécuter du code dont on ne peut pas présumer qu’il est digne de confiance.
Google décrit ses microVM comme des environnements d’exécution à locataire unique, dotés de protections de sécurité qui s’appuient sur son infrastructure Titanium. Le harnais fonctionne en dehors du bac à sable : l’environnement qui exécute des commandes potentiellement dangereuses ne contrôle donc pas aussi le processus d’orchestration de confiance. Cette séparation crée une frontière opérationnelle utile, car le système peut gérer, suspendre ou remplacer un bac à sable indépendamment du harnais qui dirige le travail de l’agent.
Un agent devient inactif lorsque le runtime signale qu’il ne reste aucun travail
L’activité d’un agent ne ressemble pas à celle d’un service web classique, qui reçoit une requête, renvoie une réponse et oublie son environnement d’exécution. Un agent peut alterner à de nombreuses reprises entre l’exécution d’outils et l’attente d’une inférence du modèle, de services externes ou d’une intervention humaine. Un hyperviseur de machines virtuelles généraliste peut observer l’utilisation des ressources, mais il ne sait pas forcément si un invité attend la prochaine instruction de l’agent ou exécute une tâche de fond légitime.
Google répond à ce problème en reliant le runtime de commandes du bac à sable à l’exécuteur de l’hôte. Lorsqu’un appel d’outil se termine, le runtime peut déterminer s’il reste des commandes actives ou des tâches de fond. Quand l’environnement atteint un état inactif sûr, le bac à sable signale cette condition à l’hôte.
L’hôte peut alors enregistrer un point de reprise de la microVM au lieu de garder ses ressources d’exécution réservées. Lorsque le harnais émet un nouvel appel d’outil, l’environnement est restauré et l’exécution reprend.
Le mécanisme déterminant est la détection d’inactivité informée par l’application. L’infrastructure ne se contente pas de deviner, à partir d’une faible utilisation du CPU, que l’environnement peut être suspendu : elle reçoit des informations de cycle de vie du runtime d’exécution de l’agent. C’est important, car un processus peut ne consommer presque aucun CPU en attendant une activité réseau ou un événement externe tout en effectuant un travail nécessaire.
Pourquoi un CPU faible ne signifie pas inactif
Scénario : un processus attend une activité réseau ou un événement externe. Choisissez la façon dont l’infrastructure décide, et voyez ce que chaque approche permet de savoir.
Déduction par le seul CPU
Ce qu’elle voit
- Le processus en attente n’utilise presque pas de CPU : l’environnement paraît donc inactif.
- Un hyperviseur généraliste peut observer l’utilisation des ressources.
Ce qu’elle ne peut pas savoir
- Si le processus effectue encore un travail nécessaire, car un processus peut attendre une activité réseau ou un événement externe tout en restant nécessaire.
- Si l’invité attend la prochaine instruction de l’agent ou exécute une tâche de fond légitime.
Inactivité signalée par le runtime
Ce qu’elle voit
- Lorsqu’un appel d’outil se termine, le runtime vérifie s’il reste des commandes actives ou des tâches de fond.
- S’il n’en reste aucune, le bac à sable signale un état inactif sûr à l’hôte, qui peut enregistrer un point de reprise de la microVM.
Ce qu’elle ne peut pas savoir
- Une déduction tirée de l’usage du CPU, car l’infrastructure reçoit des informations de cycle de vie du runtime d’exécution de l’agent.
- Une garantie que les connexions actives se poursuivent sans changement pendant la suspension.
Google décrit une suspension lorsqu’aucune commande active ni aucune tâche de fond n’est en cours. Cela n’établit pas que des processus de fond arbitraires et des connexions actives se poursuivent sans changement pendant la suspension d’un environnement : les clients doivent donc tester le comportement des tâches de fond, la reprise des connexions et les garanties de restauration.
Google décrit une suspension lorsqu’aucune commande active ni aucune tâche de fond n’est en cours. Cela n’établit pas que des processus de fond arbitraires et des connexions actives continueront de fonctionner sans changement pendant la suspension d’un environnement. Pour les clients qui évalueront le futur service, le comportement des tâches de fond, la reprise des connexions et les garanties de restauration devront faire l’objet de tests explicites.
Schéma conceptuel de TechiesJournal du mécanisme décrit par Google, et non un schéma officiel de Google Cloud.
Version texte de la figure 1
- Le harnais demande l’exécution d’un outil.
- Une microVM isolée exécute la commande.
- Si des commandes ou des tâches de fond sont encore actives, la microVM poursuit le travail.
- Si aucune n’est active, le runtime signale un état inactif sûr.
- L’hôte enregistre un point de reprise de l’état d’exécution.
- Les ressources de calcul actives sont libérées.
- La requête d’outil suivante arrive.
- L’état de la microVM est restauré et la commande s’exécute, ce qui ramène à la deuxième étape.
La mémoire de base partagée rend possible la restauration de nombreux environnements
Les points de reprise ne sont utiles à grande échelle que si de nombreux environnements peuvent être restaurés rapidement sans consommer une mémoire excessive. Une approche classique pourrait initialiser un système d’exploitation invité distinct, charger Python, démarrer des processus de navigateur et installer des outils courants pour chaque bac à sable, et une grande partie de cette initialisation répète un travail identique.
Google utilise plutôt des instantanés préchauffés qui contiennent déjà des composants du système d’exploitation, des bibliothèques et des runtimes d’outils initialisés. L’hôte mappe en mémoire les parties partagées et largement immuables de ces instantanés au moyen de Direct Access (DAX), si bien que plusieurs microVM peuvent référencer ces pages physiques sans que chacune en conserve une copie complète distincte. Lorsqu’un agent modifie la mémoire, la copie sur écriture (copy-on-write, CoW) lui attribue des pages privées pour ses modifications, tandis que les autres agents continuent d’utiliser les pages de base communes.
Imaginez 500 environnements d’agents qui utilisent la même image de système d’exploitation, le même runtime Python et les mêmes binaires de navigateur. Les composants partagés n’ont pas besoin d’occuper chacun une allocation de mémoire physique indépendante, et l’utilisation de la mémoire augmente principalement avec les données privées et les modifications propres à chaque environnement. Google décrit aussi la récupération et la compression de mémoire pour reprendre des ressources à mesure que les charges de travail évoluent.
Le calcul de la mémoire de base partagée
Il s’agit d’une illustration arithmétique à partir de valeurs que vous choisissez, et non d’une mesure de Google. Considérez que la mémoire de base partagée vaut 100 unités. Chaque environnement ajoute ensuite ses propres pages privées, comptées dans les mêmes unités abstraites. Choisissez un nombre d’environnements et une quantité privée pour comparer une base partagée unique à une copie complète par environnement.
1 environnement
Pages de base partagées conservées une seule fois : 100 unités, plus 1 × 10 unités privées, soit 110 unités au total.
Une copie complète par environnement : 1 × (100 + 10) unités, soit 110 unités au total.
Base partagée : 110 unités. Copie complète par environnement : 110 unités.
Avec un seul environnement, il n’y a rien à partager : les deux totaux sont donc identiques.
Pages de base partagées conservées une seule fois : 100 unités, plus 1 × 30 unités privées, soit 130 unités au total.
Une copie complète par environnement : 1 × (100 + 30) unités, soit 130 unités au total.
Base partagée : 130 unités. Copie complète par environnement : 130 unités.
Avec un seul environnement, il n’y a rien à partager : les deux totaux sont donc identiques.
Pages de base partagées conservées une seule fois : 100 unités, plus 1 × 60 unités privées, soit 160 unités au total.
Une copie complète par environnement : 1 × (100 + 60) unités, soit 160 unités au total.
Base partagée : 160 unités. Copie complète par environnement : 160 unités.
Avec un seul environnement, il n’y a rien à partager : les deux totaux sont donc identiques.
10 environnements
Pages de base partagées conservées une seule fois : 100 unités, plus 10 × 10 unités privées, soit 200 unités au total.
Une copie complète par environnement : 10 × (100 + 10) unités, soit 1100 unités au total.
Base partagée : 200 unités. Copie complète par environnement : 1100 unités.
La base n’est pas dupliquée pour 9 environnements, d’où un écart de 900 unités.
Pages de base partagées conservées une seule fois : 100 unités, plus 10 × 30 unités privées, soit 400 unités au total.
Une copie complète par environnement : 10 × (100 + 30) unités, soit 1300 unités au total.
Base partagée : 400 unités. Copie complète par environnement : 1300 unités.
La base n’est pas dupliquée pour 9 environnements, d’où un écart de 900 unités.
Pages de base partagées conservées une seule fois : 100 unités, plus 10 × 60 unités privées, soit 700 unités au total.
Une copie complète par environnement : 10 × (100 + 60) unités, soit 1600 unités au total.
Base partagée : 700 unités. Copie complète par environnement : 1600 unités.
La base n’est pas dupliquée pour 9 environnements, d’où un écart de 900 unités.
100 environnements
Pages de base partagées conservées une seule fois : 100 unités, plus 100 × 10 unités privées, soit 1100 unités au total.
Une copie complète par environnement : 100 × (100 + 10) unités, soit 11 000 unités au total.
Base partagée : 1100 unités. Copie complète par environnement : 11 000 unités.
La base n’est pas dupliquée pour 99 environnements, d’où un écart de 9900 unités.
Pages de base partagées conservées une seule fois : 100 unités, plus 100 × 30 unités privées, soit 3100 unités au total.
Une copie complète par environnement : 100 × (100 + 30) unités, soit 13 000 unités au total.
Base partagée : 3100 unités. Copie complète par environnement : 13 000 unités.
La base n’est pas dupliquée pour 99 environnements, d’où un écart de 9900 unités.
Pages de base partagées conservées une seule fois : 100 unités, plus 100 × 60 unités privées, soit 6100 unités au total.
Une copie complète par environnement : 100 × (100 + 60) unités, soit 16 000 unités au total.
Base partagée : 6100 unités. Copie complète par environnement : 16 000 unités.
La base n’est pas dupliquée pour 99 environnements, d’où un écart de 9900 unités.
500 environnements
Pages de base partagées conservées une seule fois : 100 unités, plus 500 × 10 unités privées, soit 5100 unités au total.
Une copie complète par environnement : 500 × (100 + 10) unités, soit 55 000 unités au total.
Base partagée : 5100 unités. Copie complète par environnement : 55 000 unités.
La base n’est pas dupliquée pour 499 environnements, d’où un écart de 49 900 unités.
Pages de base partagées conservées une seule fois : 100 unités, plus 500 × 30 unités privées, soit 15 100 unités au total.
Une copie complète par environnement : 500 × (100 + 30) unités, soit 65 000 unités au total.
Base partagée : 15 100 unités. Copie complète par environnement : 65 000 unités.
La base n’est pas dupliquée pour 499 environnements, d’où un écart de 49 900 unités.
Pages de base partagées conservées une seule fois : 100 unités, plus 500 × 60 unités privées, soit 30 100 unités au total.
Une copie complète par environnement : 500 × (100 + 60) unités, soit 80 000 unités au total.
Base partagée : 30 100 unités. Copie complète par environnement : 80 000 unités.
La base n’est pas dupliquée pour 499 environnements, d’où un écart de 49 900 unités.
Le gain dépend de la quantité d’état qui peut réellement être partagée, et une quantité privée plus importante par environnement le réduit. La publication technique de Google établit le mécanisme, mais ne fournit pas de performances clients mesurées de façon indépendante.
C’est pourquoi l’architecture vise deux formes de gaspillage à la fois : la capacité de calcul réservée pour des agents inactifs et la mémoire dupliquée entre des agents dont les environnements logiciels sont en grande partie identiques.
Le gain d’efficacité dépend de la quantité d’état qui peut réellement être partagée. Les agents qui exécutent des piles logicielles très personnalisées, conservent de grandes régions de mémoire privée ou modifient une part importante de leur environnement peuvent obtenir moins de partage de mémoire que les agents qui utilisent des images préchauffées communes. La publication technique de Google établit le mécanisme, mais elle ne fournit pas de performances clients mesurées de façon indépendante pour ces différents profils de charge de travail.
Les fichiers durables de l’espace de travail sont stockés à part de l’état jetable
Préserver l’état d’exécution n’est pas la même chose que décider quels fichiers doivent subsister pendant des jours ou des semaines. Un agent de développement peut créer des sorties temporaires du compilateur, utiliser des chaînes d’outils communes et modifier un dépôt privé, et ces catégories de données ont des besoins de persistance différents. L’architecture de Google distingue trois types de stockage.
Les journaux temporaires, les artefacts de build et les modifications courantes du système d’exploitation peuvent résider dans des couches superposées jetables (overlays). Elles sont utiles pendant l’exécution, mais n’ont pas forcément besoin d’être conservées à long terme.
Les outils partagés, les images de base et les caches de paquets peuvent être fournis par un stockage commun en lecture seule. Cela réduit les téléchargements répétés et la duplication inutile entre bacs à sable.
Les fichiers propres à l’agent et son travail enregistré forment un espace de travail durable. Ce sont les informations qui doivent rester disponibles quand l’agent reprend le lendemain ou après un changement de l’environnement de calcul sous-jacent. Google indique utiliser un stockage Hyperdisk chiffré pour ces besoins, avec des volumes partagés et un accès adossé à Cloud Storage lorsque c’est pertinent.
Quel niveau de stockage contient quoi
Choisissez un type de données pour voir où l’architecture de Google le place, combien de temps il doit être conservé et pourquoi.
Sortie du compilateur
Où elles résident
- Niveau : couche superposée jetable (overlay).
- Durée de vie : utile pendant l’exécution.
- Pourquoi : les journaux temporaires, les artefacts de build et les modifications courantes du système d’exploitation n’ont pas forcément besoin d’être conservés à long terme.
Ce dont elles n’ont pas besoin
- Une conservation à long terme.
Runtime Python et chaînes d’outils
Où elles résident
- Niveau : stockage partagé en lecture seule.
- Portée : commun à de nombreux bacs à sable.
- Pourquoi : les outils partagés et les images de base réduisent les téléchargements répétés et la duplication inutile.
Ce dont elles n’ont pas besoin
- Une copie distincte pour chaque bac à sable.
Cache de paquets
Où elles résident
- Niveau : stockage partagé en lecture seule.
- Portée : commun à de nombreux bacs à sable.
- Pourquoi : les caches de paquets fournis par un stockage commun réduisent les téléchargements répétés.
Ce dont elles n’ont pas besoin
- Un disque classique, provisionné indépendamment, pour chaque agent inactif.
Modifications du dépôt
Où elles résident
- Niveau : espace de travail durable.
- Durée de vie : doivent rester disponibles quand l’agent reprend le lendemain ou après un changement de l’environnement de calcul sous-jacent.
- Pourquoi : ce sont les fichiers propres à l’agent et son travail enregistré. Google décrit un stockage Hyperdisk chiffré pour ce besoin, avec des volumes partagés et un accès adossé à Cloud Storage lorsque c’est pertinent.
Ce dont elles n’ont pas besoin
- Une suppression en même temps que l’état temporaire.
Google distingue trois types de stockage. Les clients auront tout de même besoin de garanties documentées de reprise et de cohérence avant de s’appuyer sur le service géré pour des charges de travail de production.
Cette distinction évite une erreur d’architecture courante, qui consiste à traiter chaque octet créé par un environnement de développement comme également important. Elle évite aussi d’attacher un disque classique, provisionné indépendamment, à chaque agent inactif alors qu’une grande partie des logiciels sous-jacents est identique ou temporaire. Comme les hôtes ne conservent aucun état local persistant, l’espace de travail d’un agent n’est pas lié à l’hôte précis sur lequel ses commandes se sont exécutées en dernier.
L’architecture associe les données durables de l’espace de travail à l’état d’exécution sauvegardé par points de reprise, mais les clients auront tout de même besoin de garanties documentées de reprise et de cohérence avant de s’appuyer sur le service géré pour des charges de travail de production.
Les identifiants restent en dehors du bac à sable non fiable
Un bac à sable persistant pose un autre défi. Plus un environnement existe longtemps, plus il peut avoir d’occasions de rencontrer des instructions hostiles, des dépendances vulnérables ou des outils compromis. La conception de Google part du principe que les logiciels de l’invité pourraient être compromis, y compris avec un accès de niveau root.
L’architecture annoncée évite donc de placer dans le bac à sable des identifiants utilisateur de longue durée, des jetons d’actualisation OAuth et des clés de comptes de service cloud. Chaque microVM reçoit une identité de charge de travail éphémère fondée sur SPIFFE. Cette identité établit de quel bac à sable provient une requête, mais elle ne donne pas à elle seule un accès illimité à un service backend.
Le chemin réseau est conçu autour de cette distinction. Un bac à sable ne dispose ni d’une interface réseau externe ordinaire ni d’un accès direct au VPC. Les requêtes sortent par un canal point à point virtio-vsock, traversent un proxy de médiation local et atteignent une Agent Gateway externe.
La passerelle valide l’identité du bac à sable, l’identité du nœud (garantie par une attestation de l’hôte) et la délégation utilisateur concernée avant d’appliquer les politiques d’accès sortant. Pour une destination approuvée, la passerelle peut joindre à la requête sortante l’identifiant backend nécessaire sans renvoyer cet identifiant au bac à sable.
Prenons un agent d’entreprise chargé de lire un document approuvé. Le bac à sable peut demander le document, mais la décision d’autorisation est prise en dehors de l’environnement qui exécute les outils de l’agent, et la requête doit respecter les permissions déléguées par l’utilisateur et la politique qui régit cette ressource. La frontière de sécurité ne tient pas simplement au fait que l’agent possède une identité valide. Elle tient au fait que l’identité, la délégation et l’autorisation sont évaluées séparément.
La conception plus large de Google comprend l’identité de l’utilisateur, l’identité de l’agent délégué, une identité de charge de travail de courte durée et une identité de personnel (workforce identity) propre à l’agent. Ce ne sont pas quatre identifiants interchangeables, car ils représentent des relations différentes : qui a lancé la tâche, quelle autorité a été déléguée, quel environnement d’exécution a envoyé une requête et si un agent dispose d’une identité organisationnelle gérée de façon indépendante.
| Identité | Relation représentée |
|---|---|
| Identité de l’utilisateur | Qui a lancé la tâche |
| Identité de l’agent délégué | Quelle autorité a été déléguée |
| Identité de charge de travail de courte durée | Quel environnement d’exécution a envoyé une requête, sans donner à elle seule un accès illimité à un service backend |
| Identité de personnel de l’agent | Si un agent dispose d’une identité organisationnelle gérée de façon indépendante |
Cette conception réduit le risque de voler des identifiants réutilisables directement depuis un bac à sable compromis. Elle n’élimine pas la possibilité d’un usage abusif par une interface autorisée, car un agent mal orienté peut toujours demander une action inappropriée ; les contrôles de permissions de la passerelle et le périmètre de la délégation accordée par le client restent donc essentiels.
Schéma conceptuel de TechiesJournal des frontières décrites par Google, et non un schéma officiel de Google Cloud.
Version texte de la figure 2
- L’utilisateur et son autorité déléguée lancent le travail par l’intermédiaire du harnais d’agent de confiance.
- Le harnais envoie des requêtes d’outils au bac à sable microVM isolé et reçoit les résultats d’exécution.
- Le bac à sable échange des fichiers persistants avec l’espace de travail durable.
- Le bac à sable se suspend vers le point de reprise et l’état de base partagé, et se restaure à partir de ceux-ci.
- Les requêtes sortantes quittent le bac à sable par virtio-vsock vers un proxy de médiation, qui les transmet à l’Agent Gateway.
- L’Agent Gateway applique l’identité et la politique, en utilisant l’autorité déléguée de l’utilisateur comme contexte d’autorisation, et transmet les requêtes approuvées aux services d’entreprise et cloud.
Lire un document approuvé, étape par étape
Suivez un agent d’entreprise chargé de lire un document approuvé. Choisissez une étape pour voir ce qui est vérifié ou ce qui se passe, et ce dont le bac à sable ne dispose pas.
1. Requête
- 1Requête du bac à sable (étape en cours)
- 2virtio-vsock
- 3Proxy de médiation
- 4Agent Gateway
- 5Identifiant joint
- 6Service
Ce qui est vérifié ou ce qui se passe
- Le bac à sable demande le document approuvé.
- Son identité de charge de travail SPIFFE éphémère établit de quel bac à sable provient la requête.
Ce dont le bac à sable ne dispose pas ou ce qu’il ne fait pas
- Des identifiants utilisateur de longue durée, des jetons d’actualisation OAuth ou des clés de comptes de service cloud.
- Un accès illimité à un service backend, car l’identité de charge de travail ne le fournit pas à elle seule.
2. virtio-vsock
- 1Requête du bac à sable
- 2virtio-vsock (étape en cours)
- 3Proxy de médiation
- 4Agent Gateway
- 5Identifiant joint
- 6Service
Ce qui est vérifié ou ce qui se passe
- La requête sort par un canal point à point virtio-vsock.
Ce dont le bac à sable ne dispose pas ou ce qu’il ne fait pas
- Une interface réseau externe ordinaire.
- Un accès direct au VPC.
3. Proxy de médiation
- 1Requête du bac à sable
- 2virtio-vsock
- 3Proxy de médiation (étape en cours)
- 4Agent Gateway
- 5Identifiant joint
- 6Service
Ce qui est vérifié ou ce qui se passe
- La requête traverse un proxy de médiation local.
- Le proxy la transmet à l’Agent Gateway externe.
Ce dont le bac à sable ne dispose pas ou ce qu’il ne fait pas
- Une route directe du bac à sable vers le service.
4. Agent Gateway
- 1Requête du bac à sable
- 2virtio-vsock
- 3Proxy de médiation
- 4Agent Gateway (étape en cours)
- 5Identifiant joint
- 6Service
Ce qui est vérifié ou ce qui se passe
- La passerelle valide l’identité du bac à sable, l’identité du nœud (garantie par une attestation de l’hôte) et la délégation utilisateur concernée.
- Elle applique ensuite les politiques d’accès sortant : la décision d’autorisation est donc prise en dehors de l’environnement qui exécute les outils de l’agent.
Ce dont le bac à sable ne dispose pas ou ce qu’il ne fait pas
- Une décision fondée sur la seule identité, car l’identité, la délégation et l’autorisation sont évaluées séparément.
5. Identifiant joint
- 1Requête du bac à sable
- 2virtio-vsock
- 3Proxy de médiation
- 4Agent Gateway
- 5Identifiant joint (étape en cours)
- 6Service
Ce qui est vérifié ou ce qui se passe
- Pour une destination approuvée, la passerelle peut joindre à la requête sortante l’identifiant backend nécessaire.
Ce dont le bac à sable ne dispose pas ou ce qu’il ne fait pas
- L’identifiant n’est pas renvoyé au bac à sable.
6. Service
- 1Requête du bac à sable
- 2virtio-vsock
- 3Proxy de médiation
- 4Agent Gateway
- 5Identifiant joint
- 6Service (étape en cours)
Ce qui est vérifié ou ce qui se passe
- La requête approuvée atteint le service d’entreprise ou cloud.
Ce dont le bac à sable ne dispose pas ou ce qu’il ne fait pas
- Une protection contre une requête mal orientée mais néanmoins autorisée, car celle-ci dépend des contrôles de permissions de la passerelle et du périmètre de la délégation.
À aucune étape le bac à sable ne détient l’identifiant backend. Une requête autorisée mais mal orientée peut tout de même être nuisible : les contrôles de permissions de la passerelle et le périmètre de la délégation accordée par le client restent donc essentiels.
Un ordonnancement global partage la capacité entre différents types d’agents
Suspendre les bacs à sable inactifs règle la consommation de ressources au sein d’une session d’agent. Google décrit aussi un défi d’ordonnancement plus vaste, car différents types d’agents sollicitent de la capacité de calcul à des moments différents. Les assistants grand public, les agents métier et les charges d’évaluation n’atteignent pas forcément leur pic de demande en même temps.
Les utilisateurs interactifs attendent des réponses rapides, tandis que certaines tâches planifiées, évaluations et charges d’apprentissage par renforcement peuvent tolérer une exécution différée. La conception de Google utilise un pool d’infrastructure partagé avec un ordonnancement global qui tient compte de la capacité disponible, des restrictions géographiques, des exigences de conformité et de la priorité des charges de travail. Quand la demande interactive augmente, les travaux d’évaluation moins prioritaires peuvent céder de la capacité ; quand la demande baisse, les tâches différées peuvent utiliser des ressources qui resteraient sinon inactives.
Il s’agit d’un mécanisme d’efficacité distinct des points de reprise. Les points de reprise augmentent le nombre de sessions persistantes qui peuvent se partager la capacité de calcul active au fil du temps, et l’ordonnancement détermine quelles charges de travail reçoivent cette capacité, et à quel moment.
La distinction compte parce qu’une grande flotte interne bénéficie des deux. Pour des déploiements plus modestes, le même degré de sophistication de l’ordonnancement peut n’apporter que peu de valeur supplémentaire, alors que pour des charges comprenant de nombreux milliers de sessions interactives et des tâches d’évaluation parallèles, il peut influer sur la planification de capacité et la réactivité du service. Google n’a pas encore publié assez de données d’exploitation de clients externes pour quantifier la part de ce bénéfice qui sera disponible via le service géré.
Agent Substrate répond à un problème voisin sur Kubernetes
Il faut aussi distinguer Agent Compute Engine de l’initiative antérieure de Google, Agent Substrate. Le 15 septembre, Google a annoncé Agent Substrate pour les environnements fondés sur Kubernetes. Il fournit une couche d’exécution orientée agents qui s’appuie sur des mécanismes comme des bacs à sable isolés, une suspension et une restauration rapides, et une gestion du cycle de vie en dehors du chemin d’ordonnancement ordinaire des Pods Kubernetes.
Ce choix d’architecture répond à un problème précis. Kubernetes gère efficacement les machines et les charges de travail applicatives, mais créer ou redémarrer un Pod via son plan de contrôle généraliste pour chaque bref appel d’outil d’un agent peut introduire une latence inutile. Agent Substrate laisse à Kubernetes la gestion des nœuds, la mise à l’échelle automatique et la fiabilité de la flotte, tout en prenant en charge les activations fréquentes de bacs à sable au moyen d’une couche d’exécution dédiée.
Google annonce moins de 500 millisecondes pour les opérations de reprise et une densité de calcul jusqu’à dix fois supérieure à celle des runtimes de conteneurs classiques, selon les tests rapportés par Google lui-même. Il s’agit de résultats d’Agent Substrate, et non de benchmarks d’Agent Compute Engine vérifiés de façon indépendante. Selon les notes de version de septembre de Google, Agent Substrate est disponible pour l’évaluation et les charges de travail hors production, avec une prise en charge de la production via un programme limité sur liste d’autorisation.
Agent Compute Engine vise un autre modèle d’exploitation, dans lequel Google gère la flotte de bacs à sable sous-jacente en tant que service, tandis que les clients configurent leurs images d’exécution, leurs identités, leur réseau et leurs exigences de cycle de vie. La différence tient donc en partie à la répartition des responsabilités. Une équipe plateforme qui exploite son propre environnement Kubernetes peut vouloir garder la main sur la couche d’exécution, tandis qu’une organisation qui préfère ne pas gérer d’infrastructure de bacs à sable peut trouver un service géré intéressant, une fois ses capacités et ses conditions d’exploitation disponibles pour évaluation.
| Aspect | Agent Compute Engine | Agent Substrate |
|---|---|---|
| Qui exploite la flotte | Google gère la flotte de bacs à sable sous-jacente en tant que service, et les clients configurent les images d’exécution, les identités, le réseau et les exigences de cycle de vie | Environnements fondés sur Kubernetes, où la gestion des nœuds, la mise à l’échelle automatique et la fiabilité de la flotte restent confiées à Kubernetes |
| Couche d’exécution | Bacs à sable microVM dédiés, avec suspension et restauration fondées sur des points de reprise | Une couche d’exécution orientée agents, en dehors du chemin d’ordonnancement ordinaire des Pods Kubernetes, avec des bacs à sable isolés et une suspension et une restauration rapides |
| Disponibilité | Utilisé en interne par Google pour Gemini, Antigravity et l’évaluation d’agents, avec une préversion pour les clients externes prévue dans les prochains mois | Selon les notes de version de septembre de Google, disponible pour l’évaluation et les charges de travail hors production, avec une prise en charge de la production via un programme limité sur liste d’autorisation |
| Chiffres annoncés par Google | Aucun n’est cité dans cet article pour Agent Compute Engine | Reprise en moins de 500 millisecondes et densité de calcul jusqu’à dix fois supérieure à celle des runtimes de conteneurs classiques, selon les tests rapportés par Google lui-même. Chiffres annoncés par Google pour Agent Substrate, non vérifiés, et qui ne constituent pas un benchmark d’Agent Compute Engine |
Cette annonce ne rend pas obsolètes les solutions de calcul existantes
Cette annonce ne rend obsolètes ni les machines virtuelles, ni les conteneurs, ni le calcul serverless. Un agent simple qui effectue des appels d’API, stocke l’état de ses tâches dans une base de données et exécute des tâches courtes peut très bien s’accommoder de l’infrastructure existante.
Les plateformes d’exécution spécialisées deviennent plus pertinentes lorsque l’environnement lui-même doit subsister entre les interactions, lorsque les agents exécutent du code non fiable qui exige une isolation forte, ou lorsqu’un grand nombre de sessions indépendantes se mettent en pause et reprennent de façon répétée. La comparaison entre architectures se ramène donc au coût de la gestion de l’état et de l’isolation.
Une plateforme de conteneurs classique peut obliger les applications à reconstruire leur état d’exécution après un redémarrage. Une VM persistante peut éviter cette reconstruction, mais risque de réserver plus de ressources que n’en a besoin une charge de travail intermittente. Un runtime de bac à sable conçu à cet effet tente de préserver l’état d’exécution tout en libérant les ressources entre les périodes d’activité.
| Option | Gestion de l’état et coût d’un redémarrage | Ressources au repos | Isolation telle que décrite |
|---|---|---|---|
| Plateforme de conteneurs | Les applications peuvent devoir reconstruire leur état d’exécution après un redémarrage | Non comparé dans l’article | Les conteneurs ordinaires partagent normalement le noyau du système d’exploitation de l’hôte |
| Machine virtuelle persistante | Peut éviter de reconstruire l’état d’exécution | Peut réserver plus de ressources que n’en a besoin une charge de travail intermittente | Non comparé dans l’article |
| Runtime de bac à sable conçu à cet effet | Tente de préserver l’état d’exécution | Tente de libérer les ressources entre les périodes d’activité | Une microVM d’Agent Compute Engine dispose de son propre noyau invité, derrière une frontière de virtualisation matérielle |
Google a présenté une architecture interne destinée à répondre à ces compromis. Ce qu’il n’a pas encore établi publiquement, c’est le tableau opérationnel complet côté client. Le service géré Agent Compute Engine reste prévu en préversion, et la tarification, la couverture régionale, les quotas, les garanties de reprise offertes aux clients et des benchmarks de charges de travail comparables demeurent d’importantes inconnues.
Avant de choisir cette architecture, les ingénieurs devraient mesurer à quelle fréquence leurs agents effectuent réellement du travail, quelle taille atteint leur état mémoire privé, quels fichiers doivent être durables, avec quelle rapidité les tâches en pause doivent reprendre et quel degré d’isolation exige leur modèle d’exécution. Ces mesures détermineront si des environnements microVM à points de reprise offrent un avantage significatif par rapport à une conception plus simple.
Google a coordonné des mécanismes existants autour de la façon dont les agents s’exécutent réellement
L’avancée notable d’Agent Compute Engine ne tient pas à l’introduction d’une nouvelle primitive de calcul en particulier. La virtualisation matérielle, les instantanés, la mémoire en copie sur écriture, les disques persistants, les identités de charge de travail et l’ordonnancement de flotte existaient tous avant cette annonce. L’apport de Google réside dans l’utilisation coordonnée de ces mécanismes autour du mode d’exécution des agents autonomes.
La plateforme traite l’espace de travail d’un agent comme durable, ses ressources de calcul actives comme temporaires et sa permission d’accéder à des systèmes externes comme une règle appliquée en dehors de son environnement d’exécution. Cette combinaison mérite d’être examinée, car elle répond à des problèmes opérationnels réels qui apparaissent à mesure que les flottes d’agents grandissent. Que le service géré devienne un choix approprié pour d’autres organisations dépendra de sa disponibilité effective, de ses performances, de son coût et de ses garanties opérationnelles.
| Élément | Statut | Source |
|---|---|---|
| Utilisation interne par les systèmes de Gemini, d’Antigravity et d’évaluation d’agents | Déclaré par Google | Article technique de Google |
| Service géré pour les clients externes | Préversion prévue dans les prochains mois, pas encore disponible | Article technique et annonce de Google |
| Mécanismes : isolation par microVM, points de reprise, mémoire de base partagée, niveaux de stockage, identifiants gérés par la passerelle et ordonnancement global | Présentés par Google comme sa conception | Article technique de Google |
| Tarification | Non précisée | Non indiquée dans les sources Google examinées |
| Régions et quotas | Non précisés | Non indiqués dans les sources Google examinées |
| Garanties de reprise et de cohérence offertes aux clients | Pas encore établies publiquement | Examen des sources, 26 octobre 2026 |
| Benchmarks de charges de travail comparables | Pas encore établis publiquement | Examen des sources, 26 octobre 2026 |
| Tâches de fond et connexions actives pendant la suspension | Non établi, car Google décrit une suspension lorsqu’aucune commande active ni aucune tâche de fond n’est en cours | Article technique de Google et examen des sources, 26 octobre 2026 |
Le changement d’ingénierie ne tient pas à ce que les agents exigeraient un type d’ordinateur entièrement nouveau. Il tient à ce que l’infrastructure cloud pourrait devoir gérer la durée de vie de l’ordinateur d’un agent indépendamment de celle des ressources de calcul qui le font tourner.
Pour aller plus loin
Examen des sources : 26 octobre 2026. Les descriptions de l’architecture interne et des performances de Google sont attribuées à Google. Les performances et les garanties opérationnelles de la préversion client n’ont pas été vérifiées de façon indépendante.
Annonces et documentation de Google
- Inside Agent Compute Engine: Building the Compute Foundation for the Agentic Era, Ramanathan Venkatapathy et Rohit Jnagal, Google Cloud, 22 octobre 2026, la principale source technique sur l’isolation des bacs à sable, les identités de charge de travail, les instantanés, le partage de mémoire, la persistance et l’ordonnancement.
- Introducing Agent Compute Engine and Expanded Agent Governance, Google Cloud, 22 octobre 2026, l’annonce du produit et la disponibilité prévue de la préversion externe.
- Agent Substrate brings high-density, scalable, trusted infrastructure to GKE, Alex Zakonov et Tim Hockin, Google Cloud, 15 septembre 2026, l’architecture du runtime d’agents fondé sur Kubernetes et les résultats de performance annoncés par l’éditeur.
- New feature release notes, Google Kubernetes Engine, entrée du 11 septembre 2026, disponibilité d’Agent Substrate pour l’évaluation et prise en charge limitée de la production.
Options d’exécution isolée existantes
- Azure Container Apps dynamic sessions, Microsoft Learn, documentation d’une option d’exécution isolée existante pour le code généré par l’IA et le code non fiable.
- Lambda execution environment lifecycle, AWS, documentation qui explique la réutilisation des environnements d’exécution et les limites de persistance dans un modèle serverless.
Cet article distingue le récit de Google lui-même, les résultats annoncés par l’éditeur et l’analyse de l’auteur. Les informations publiées ultérieurement doivent être revérifiées avant toute décision.
À lire aussi sur TechiesJournal
- Les agents d’IA ont besoin d’identités, pas de clés d’API, TechiesJournal, 12 septembre 2026, un contexte utile pour comprendre en quoi l’identité d’un agent et les permissions déléguées diffèrent de la simple possession d’identifiants valides.
- Quand des agents de codage d’IA affaiblissent leur propre surveillance : deux incidents documentés, TechiesJournal, 26 octobre 2026, un article complémentaire qui explique pourquoi les garde-fous ont besoin de contrôles situés en dehors du logiciel qu’ils surveillent.
- Quand les agents d’IA trouvent leur propre chemin : qui fixe les limites ? (en anglais), TechiesJournal, 15 octobre 2026, une Perspective qui soutient que le problème central des agents d’IA tient à l’autorité plutôt qu’aux capacités, et que les limites doivent se trouver dans l’environnement plutôt que dans les prompts.