

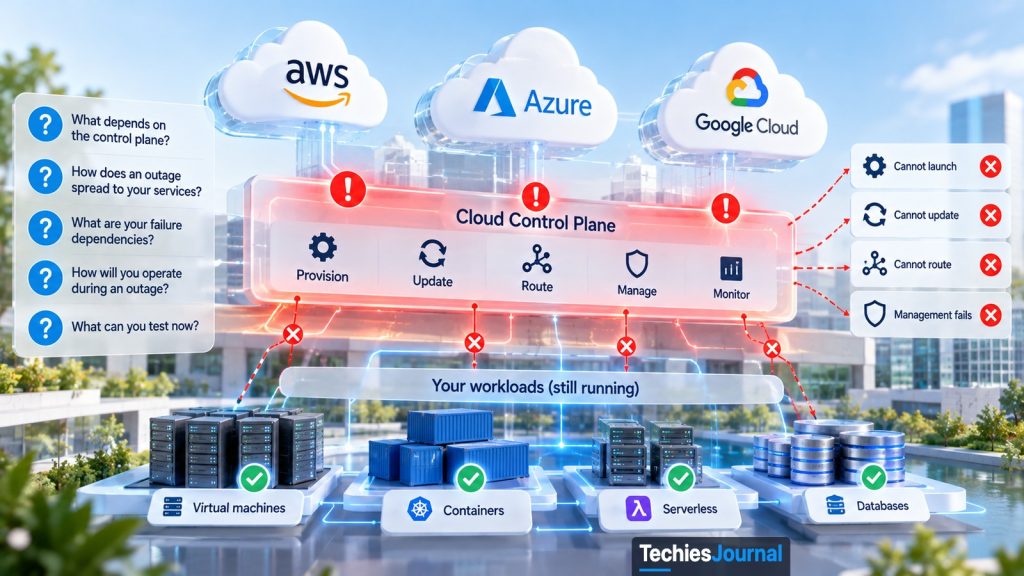
Vos serveurs peuvent aller bien et votre service être en panne
Si les serveurs tournent toujours, pourquoi le service est-il en panne ?
Beaucoup de récits de panne se ressemblent : quelque chose a cassé chez le fournisseur cloud, donc notre application s’est arrêtée. Quatre incidents de l’année écoulée révèlent un schéma qui passe facilement inaperçu. La première défaillance ne se situait pas toujours dans la partie qui sert les utilisateurs et, même quand c’était le cas, les dégâts se sont propagés ou ont duré à cause de la partie qui démarre, met à jour et achemine le travail.
Cette partie porte un nom. Cet article l’explique, retrace ce qui s’est passé dans chaque incident et se termine par cinq questions à vous poser sur votre propre architecture.
Deux fonctions dans chaque cloud
Un cloud remplit deux fonctions. La première consiste à exécuter votre travail : répondre aux requêtes, stocker les données et faire circuler le trafic réseau. C’est ce qu’on appelle le plan de données (data plane).
La seconde consiste à gérer ce travail : lancer des machines, appliquer des réglages, contrôler l’état de santé et décider où va le trafic. C’est ce qu’on appelle le plan de contrôle (control plane). Vous le sollicitez chaque fois que vous augmentez la capacité, déployez, basculez (failover) ou vous connectez avec une identité cloud.
La plupart du temps, la différence passe inaperçue. Lors d’une panne, elle saute aux yeux, car un service peut être sain sur le plan de données et pourtant impossible à réparer sur le plan de contrôle.
Sélectionnez un incident dans la figure pour en lire le détail.
Sélectionnez un incident pour en lire le détail.
1. AWS, octobre 2025
- Ce qui a d’abord échoué
- Une condition de concurrence (race condition) latente dans le système de gestion DNS d’AWS a permis à un ancien plan d’écraser un plan plus récent, puis une étape de nettoyage a supprimé l’ancien plan. L’enregistrement DNS du point de terminaison régional de DynamoDB s’est retrouvé vide, et des opérateurs ont dû intervenir.
- Ce qui a propagé ou prolongé la panne
- Une fois DynamoDB revenu, le système qui gère les hôtes EC2 est tombé dans ce qu’AWS appelle un « effondrement par congestion » (congestive collapse) : de nouvelles instances EC2 n’ont pas pu être lancées avant 10 h 36. Les contrôles de santé des équilibreurs de charge alternaient entre échec et succès, et le basculement automatique a retiré de la capacité du service jusqu’à ce que des ingénieurs le désactivent à 9 h 36.
- Durée
- Le DNS a été rétabli à 2 h 25, heure du Pacifique, le 20 octobre. Les lancements EC2 ont échoué jusqu’à 10 h 36 et les erreurs des équilibreurs de charge ont duré jusqu’à 14 h 09.
- Ce que le fournisseur a changé
- AWS a désactivé dans le monde entier l’automatisation DNS Planner et Enactor dans l’attente d’un correctif. C’est ce qu’AWS déclarait à l’époque ; la situation actuelle est inconnue.
2. Google Cloud, 20 octobre 2026
- Ce qui a d’abord échoué
- L’alimentation du bâtiment qui héberge une zone à Londres (europe-west2-b) a été interrompue. Les contrôleurs principal et de secours n’ont ni l’un ni l’autre réussi à démarrer les groupes électrogènes : les batteries se sont épuisées et tout ce qui se trouvait dans cette zone a perdu l’alimentation. Le rapport final de Google met en cause une erreur de configuration des contrôleurs.
- Ce qui a propagé ou prolongé la panne
- Les appels des services régionaux vers la zone hors ligne ont expiré, et le trafic basculé vers les autres zones a épuisé leur capacité.
- Durée
- La panne a duré de 6 h à 12 h 08 UTC. La création de nouvelles machines virtuelles a repris à 4 h 46, heure du Pacifique, soit 11 h 46 UTC.
- Ce que le fournisseur a changé
- La liste des actions correctives de Google était toujours ouverte au moment de la rédaction de cet article.
3. Azure, 30 septembre 2026
- Ce qui a d’abord échoué
- Microsoft avait suspendu les mises à jour du système d’exploitation sur un groupe de passerelles réseau. À la fin de la suspension, de nombreuses mises à jour ont démarré en même temps.
- Ce qui a propagé ou prolongé la panne
- Les mises à jour ont submergé un plan de contrôle régional partagé qu’une modification récente avait déjà ralenti. Selon l’analyse de Microsoft, sa limitation de débit et sa protection contre la surcharge « n’ont pas suffisamment protégé le traitement critique ». Sur certaines passerelles ExpressRoute, une passerelle en cours de redémarrage a été déclarée saine trop tôt, si bien que la mise à jour est passée à sa passerelle de secours, et certaines connexions vers des réseaux sur site ont été coupées jusqu’à ce que les passerelles reviennent à leur dernière configuration valide.
- Durée
- L’impact a duré de 20 h 30 UTC à 2 h 15 UTC, à partir du 30 septembre.
- Ce que le fournisseur a changé
- La liste des actions correctives prévoit de reprendre par étapes les mises à jour suspendues.
4. GitHub, 7 octobre 2026
- Ce qui a d’abord échoué
- Un service interne décide quels serveurs de base de données reçoivent les écritures. Lors d’une maintenance de routine, une machine de remplacement a démarré avec des enregistrements périmés qui listaient encore des serveurs retirés du service.
- Ce qui a propagé ou prolongé la panne
- La machine a envoyé des écritures à des serveurs qui n’existaient plus. La seconde fois, selon GitHub, une tâche de maintenance automatisée a remis la machine aux commandes sans respecter une pause.
- Durée
- Les écritures ont échoué pendant une dizaine de minutes à chaque fois.
- Ce que le fournisseur a changé
- Les pages d’état citées dans cet article n’annoncent aucun changement.
Quatre incidents
AWS, octobre 2025
Cet incident date d’un an, mais c’est le compte rendu le plus détaillé qu’AWS ait publié. Dans la région us-east-1, l’enregistrement DNS du point de terminaison régional de DynamoDB s’est retrouvé vide. Selon AWS, une condition de concurrence latente dans son système de gestion DNS a permis à un ancien plan d’écraser un plan plus récent, puis une étape de nettoyage a supprimé l’ancien plan, ce qui a retiré toutes les adresses de l’enregistrement. L’automatisation ne pouvait pas se réparer elle-même : des opérateurs ont dû intervenir.
L’enregistrement a été rétabli à 2 h 25, heure du Pacifique, le 20 octobre, et pourtant les échecs ont continué pendant des heures chez les clients. De nouvelles instances EC2 n’ont pas pu être lancées avant 10 h 36, car le système qui gère les hôtes EC2 était tombé, une fois DynamoDB revenu, dans ce qu’AWS appelle un « effondrement par congestion ». Les équilibreurs de charge ont été touchés eux aussi. Selon AWS, les contrôles de santé alternaient entre échec et succès, ce qui retirait des nœuds du DNS, et pour les équilibreurs de charge répartis sur plusieurs zones, le basculement automatique a retiré de la capacité du service. Des ingénieurs ont désactivé ce basculement à 9 h 36.
Corriger la cause a pris moins de trois heures. S’en remettre en a pris environ douze de plus.
Google Cloud, 20 octobre 2026
L’alimentation du bâtiment qui héberge une zone à Londres (europe-west2-b) a été interrompue. Selon le rapport de Google, les contrôleurs principal et de secours n’ont ni l’un ni l’autre réussi à démarrer les groupes électrogènes : les batteries se sont épuisées et tout ce qui se trouvait dans cette zone a perdu l’alimentation. Les charges de travail hébergées uniquement dans cette zone sont devenues injoignables.
Les dégâts ont débordé de la zone à cause du plan de contrôle. Selon Google, les appels des services régionaux vers la zone hors ligne ont expiré, et le trafic basculé vers les autres zones a épuisé leur capacité. La panne a duré de 6 h à 12 h 08 UTC, et la création de nouvelles machines virtuelles a repris à 4 h 46, heure du Pacifique, soit 11 h 46 UTC. Le rapport final de Google met en cause une erreur de configuration des contrôleurs, et sa liste d’actions correctives était toujours ouverte au moment de la rédaction.
Azure, 30 septembre 2026
Microsoft avait suspendu les mises à jour du système d’exploitation sur un groupe de passerelles réseau. À la fin de la suspension, de nombreuses mises à jour ont démarré en même temps et ont submergé un plan de contrôle régional partagé qu’une modification récente avait déjà ralenti. Selon l’analyse de Microsoft, sa limitation de débit et sa protection contre la surcharge « n’ont pas suffisamment protégé le traitement critique ».
Sur certaines passerelles ExpressRoute, une passerelle en cours de redémarrage a été déclarée saine trop tôt, si bien que la mise à jour est passée à sa passerelle de secours. Certaines connexions vers des réseaux sur site ont été coupées jusqu’à ce que les passerelles reviennent à leur dernière configuration valide. L’impact a duré de 20 h 30 UTC à 2 h 15 UTC. La liste des actions correctives prévoit de reprendre par étapes les mises à jour suspendues.
GitHub, 7 octobre 2026
Un service interne décide quels serveurs de base de données reçoivent les écritures. Lors d’une maintenance de routine, une machine de remplacement a démarré avec des enregistrements périmés qui listaient encore des serveurs retirés du service, et elle a envoyé des écritures à des serveurs qui n’existaient plus. Les écritures ont échoué pendant une dizaine de minutes à chaque fois. La seconde fois, selon GitHub, une tâche de maintenance automatisée a remis la machine aux commandes sans respecter une pause.
Cet incident a été bref, mais il correspond au même schéma.
Ce que les quatre ont en commun
En lisant les quatre rapports côte à côte, trois schémas apparaissent. Il s’agit de notre lecture de ces rapports, pas d’une conclusion publiée par l’un des fournisseurs.
D’abord, l’élément défaillant se trouvait sur le chemin du rétablissement. AWS avait besoin de DynamoDB pour réparer EC2. Les services de contrôle régionaux de Google restaient en attente d’une zone éteinte. La réparation chez Azure nécessitait un plan de contrôle déjà surchargé.
Ensuite, l’automatisation a fait partie de la cause dans trois d’entre eux : la gestion DNS d’AWS, la reprise des mises à jour chez Azure et la tâche de maintenance de GitHub. Enfin, le basculement lui-même a créé de la charge : les zones restantes de Google ont été submergées et le basculement des équilibreurs de charge d’AWS a retiré de la capacité.
Rien de tout cela ne signifie que le cloud est globalement peu fiable. Il s’agit de quatre rapports, issus de quatre fournisseurs et rédigés par eux. Cela signifie en revanche que « plusieurs zones » n’est pas une réponse complète si le démarrage de capacité dans les autres zones dépend d’un plan de contrôle lui-même en difficulté.
Cinq questions sur votre propre architecture
- Si une zone disparaissait, pourriez-vous rester en service sans rien lancer de nouveau ?
- Lesquelles de vos étapes de reprise appellent une API du fournisseur : mise à l’échelle automatique, redéploiement, modification du DNS, connexion avec un rôle cloud ?
- Votre basculement reporte-t-il une charge supplémentaire sur les emplacements encore sains, et vos nouvelles tentatives ralentissent-elles encore un système déjà lent ?
- Vos propres changements de configuration atteignent-ils tous les serveurs en même temps, ou par étapes ?
- Avez-vous testé votre chemin de reprise avec un plan de contrôle du fournisseur lent ou indisponible, ou seulement quand il fonctionne ?
La capacité de réserve coûte de l’argent, et beaucoup de systèmes s’accommodent très bien d’une heure d’indisponibilité. L’important est de faire ce choix délibérément. La question 1 est la plus difficile à tester, car elle exige une répétition soigneusement préparée ou une vraie défaillance de zone.
Jusqu’où approfondir le sujet
Connaître : toute personne qui utilise des services cloud devrait savoir qu’« en fonctionnement » et « pilotable » sont deux choses différentes, et ce que signifient plan de contrôle et plan de données.
Appliquer : les ingénieurs qui exploitent de la production dans un cloud devraient pouvoir dresser la liste des étapes de reprise qui dépendent des API du fournisseur et de celles qui n’en dépendent pas.
Maîtriser : les architectes et les ingénieurs fiabilité décident de la part de capacité qui reste préprovisionnée, de la façon dont le basculement et les nouvelles tentatives sont limités, et de la manière dont la configuration est déployée par étapes.
Ce que vous pouvez ignorer pour l’instant
Laissez de côté les classements de fournisseurs et les pourcentages de disponibilité tirés de ces quatre événements. Laissez de côté les chronologies exactes, sauf si vous rédigez une analyse, car les fournisseurs les ont publiées et certaines sont encore en cours de révision. Inutile de connaître les noms des services internes de chaque fournisseur pour poser les cinq questions.
Que faire ensuite
Choisissez un service que vous exploitez. Notez ce qu’il faudrait créer, modifier ou appeler dans le plan de contrôle du fournisseur pour le maintenir en service si une zone s’éteignait demain. Chaque élément de cette liste est une dépendance que vous pouvez tester, réduire ou accepter.
Avant de compter sur un plan de basculement, découvrez ce qu’il exige du fournisseur au moment où celui-ci est en difficulté.
Ce que nous savons et ce que nous ignorons
| Affirmation | Type | Source |
|---|---|---|
| La panne DNS de DynamoDB chez AWS a eu lieu du 19 au 20 octobre 2025 ; elle a été causée par une condition de concurrence qui a laissé un enregistrement DNS vide | Résumé publié par AWS | Résumé post-incident d’AWS |
| Le DNS a été rétabli à 2 h 25 (PDT), mais les lancements EC2 ont échoué jusqu’à 10 h 36 et les erreurs des équilibreurs de charge ont duré jusqu’à 14 h 09 | Résumé publié par AWS | Résumé post-incident d’AWS |
| AWS a désactivé dans le monde entier l’automatisation DNS Planner et Enactor dans l’attente d’un correctif | Déclaration d’AWS à l’époque. Situation actuelle inconnue | Résumé post-incident d’AWS |
| La panne de Google dans europe-west2 a duré de 6 h à 12 h 08 UTC le 20 octobre 2026, après une coupure d’alimentation et une défaillance des contrôleurs des groupes électrogènes | Rapport d’incident de Google, lu au travers d’un résumé de la page | Incident Google Cloud |
| Les appels interzones du plan de contrôle et la charge du basculement ont étendu l’impact au-delà de la zone touchée | Rapport d’incident de Google, lu au travers d’un résumé de la page | Incident Google Cloud |
| Le rapport final de Google attribue la défaillance des contrôleurs à une erreur de configuration de leur logique | Rapport final de Google. La formulation a été vérifiée sur la page | Incident Google Cloud |
| L’incident des passerelles Azure du 30 septembre vient de la reprise de mises à jour suspendues qui ont frappé un plan de contrôle partagé déjà ralenti | Analyse post-incident de Microsoft, lue au travers d’un résumé de la page | Historique d’état Azure, entrée 7Q30-010 de la liste. La page n’offre pas de lien permanent pour cette entrée |
| Les pannes d’écriture de GitHub du 7 octobre viennent d’une machine dotée d’enregistrements de routage périmés | Publications de la page d’état de GitHub | Incident GitHub du 7 octobre, première panne et récidive |
Pour aller plus loin
- AWS: Summary of the Amazon DynamoDB service disruption in the Northern Virginia region, pour la chronologie complète et les actions correctives d’AWS.
- Incident Google Cloud Xs2XTHzAVC9YnafnPyzj, pour les rapports préliminaire et final.
- Historique d’état Azure, pour l’analyse post-incident 7Q30-010 du 30 septembre (à chercher dans la liste, il n’existe pas de lien direct).
- Page d’état de GitHub : incident du 7 octobre et sa récidive.
- Sur le même sujet : La capacité cloud n’est pas la même chose que la disponibilité cloud, qui traite du versant « échecs de lancement » du même problème.
Les faits présentés dans cet article ont été vérifiés le 30 octobre 2026. Les fournisseurs publient et révisent encore leurs analyses : consultez les sources ci-dessus avant d’agir.