

Tus servidores pueden estar bien y tu servicio, caído
Si los servidores siguen funcionando, ¿por qué está caído el servicio?
Muchas historias de caídas suenan igual: algo se rompió en el proveedor de nube y por eso nuestra aplicación se detuvo. Cuatro incidentes del último año muestran un patrón fácil de pasar por alto. El primer fallo no siempre estuvo en la parte que atiende a los usuarios y, aun cuando lo estuvo, el daño se extendió o se prolongó por culpa de la parte que arranca, actualiza y enruta el trabajo.
Esa parte tiene nombre. Este artículo la explica, repasa lo que ocurrió en cada incidente y termina con cinco preguntas que puedes hacerte sobre tu propio diseño.
Dos funciones dentro de cada nube
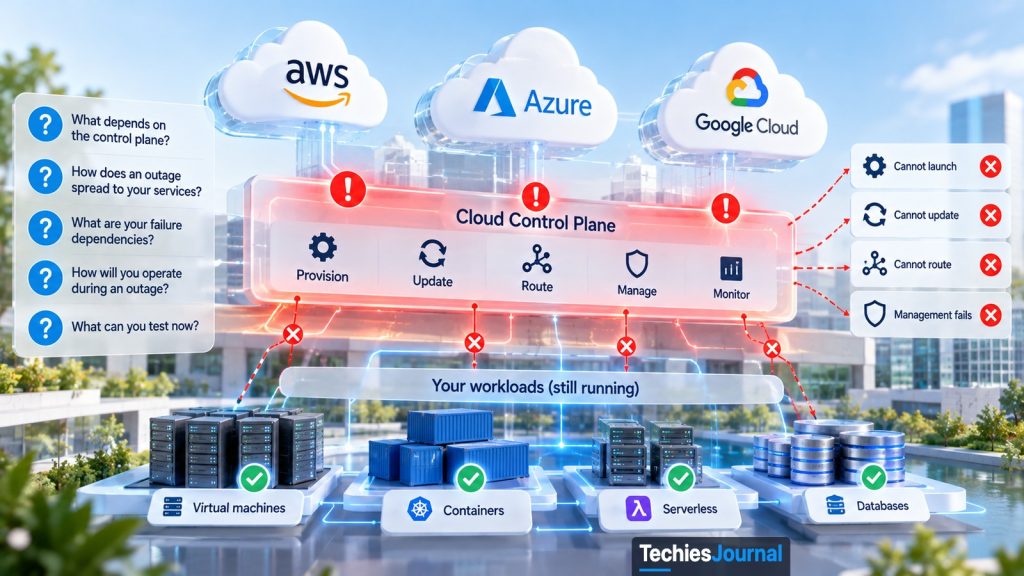
Una nube cumple dos funciones. La primera es ejecutar tu trabajo: responder solicitudes, almacenar datos y mover el tráfico de red. Es lo que se llama plano de datos.
La segunda es gestionar ese trabajo: lanzar máquinas, aplicar configuraciones, comprobar el estado y decidir adónde va el tráfico. Es lo que se llama plano de control. Lo usas cada vez que escalas, despliegas, haces una conmutación por error (failover) o inicias sesión con una identidad de la nube.
La mayor parte del tiempo no notas la diferencia. Durante una interrupción sí, porque un servicio puede estar sano en el plano de datos y aun así ser imposible de reparar en el plano de control.
Selecciona un incidente en la figura para leer sus detalles.
Selecciona un incidente para leer sus detalles.
1. AWS, octubre de 2025
- Qué falló primero
- Una condición de carrera latente en el sistema de gestión de DNS de AWS permitió que un plan antiguo sobrescribiera otro más reciente, y después un paso de limpieza eliminó el plan antiguo. Eso dejó vacío el registro DNS del endpoint regional de DynamoDB, y los operadores tuvieron que intervenir.
- Qué lo extendió o prolongó
- Cuando DynamoDB volvió, el sistema que gestiona los hosts de EC2 entró en lo que AWS llama un colapso por congestión (congestive collapse), de modo que no se pudieron lanzar nuevas instancias de EC2 hasta las 10:36 a. m. Las comprobaciones de estado de los balanceadores de carga alternaban entre fallo y estado sano, y la conmutación por error automática retiró capacidad del servicio hasta que los ingenieros la desactivaron a las 9:36 a. m.
- Cuánto duró
- El DNS ya estaba restablecido a las 2:25 a. m., hora del Pacífico, del 20 de octubre. Los lanzamientos de EC2 fallaron hasta las 10:36 a. m. y los errores de los balanceadores de carga duraron hasta las 2:09 p. m.
- Qué cambió el proveedor
- AWS desactivó en todo el mundo la automatización DNS Planner y Enactor a la espera de una corrección. Es lo que AWS declaró en su momento; se desconoce la situación actual.
2. Google Cloud, 20 de octubre de 2026
- Qué falló primero
- Se interrumpió el suministro eléctrico del edificio que aloja una zona de Londres (europe-west2-b). Ni el controlador principal ni el de respaldo lograron arrancar los generadores, así que las baterías se agotaron y todo lo que había en esa zona se quedó sin energía. El informe final de Google apunta a un error de configuración en los controladores.
- Qué lo extendió o prolongó
- Las llamadas de los servicios regionales a la zona fuera de línea agotaron el tiempo de espera, y el tráfico que pasó por conmutación por error a las otras zonas consumió su capacidad.
- Cuánto duró
- La interrupción duró de 06:00 a 12:08 UTC. La creación de nuevas máquinas virtuales se reanudó a las 04:46, hora del Pacífico, es decir, a las 11:46 UTC.
- Qué cambió el proveedor
- La lista de reparaciones de Google seguía abierta cuando se escribió este artículo.
3. Azure, 30 de septiembre de 2026
- Qué falló primero
- Microsoft había pausado las actualizaciones del sistema operativo en un grupo de puertas de enlace de red. Cuando terminó la pausa, muchas actualizaciones empezaron a la vez.
- Qué lo extendió o prolongó
- Las actualizaciones inundaron un plano de control regional compartido que un cambio reciente ya había hecho más lento. La revisión de Microsoft dice que su limitación de peticiones (throttling) y su protección frente a la carga «no protegieron lo suficiente el procesamiento crítico». En algunas puertas de enlace de ExpressRoute, una puerta de enlace que se estaba reiniciando se marcó como sana demasiado pronto, así que la actualización pasó a su respaldo, y algunas conexiones con redes locales (on-premises) se cortaron hasta que las puertas de enlace volvieron a su última configuración correcta.
- Cuánto duró
- El impacto duró de 20:30 UTC a 02:15 UTC, a partir del 30 de septiembre.
- Qué cambió el proveedor
- La lista de reparaciones incluye reanudar por etapas las actualizaciones pausadas.
4. GitHub, 7 de octubre de 2026
- Qué falló primero
- Un servicio interno decide qué servidores de bases de datos reciben las escrituras. Durante un mantenimiento rutinario, una máquina de reemplazo arrancó con registros obsoletos que aún incluían servidores retirados.
- Qué lo extendió o prolongó
- La máquina envió escrituras a servidores que ya no existían. La segunda vez, según GitHub, una tarea de mantenimiento automatizada volvió a poner la máquina al mando sin respetar una pausa.
- Cuánto duró
- Las escrituras fallaron durante unos diez minutos cada vez.
- Qué cambió el proveedor
- Las páginas de estado que cita este artículo no indican ningún cambio.
Cuatro incidentes
AWS, octubre de 2025
Este incidente tiene un año, pero es el relato más detallado que ha publicado AWS. En la región us-east-1, el registro DNS del endpoint regional de DynamoDB terminó vacío. AWS dice que una condición de carrera latente en su sistema de gestión de DNS permitió que un plan antiguo sobrescribiera otro más reciente, y que después un paso de limpieza eliminó el plan antiguo, lo que borró todas las direcciones del registro. La automatización no pudo repararse sola, así que los operadores tuvieron que intervenir.
El registro ya estaba restablecido a las 2:25 a. m., hora del Pacífico, del 20 de octubre, y aun así los clientes siguieron sufriendo fallos durante horas. No se pudieron lanzar nuevas instancias de EC2 hasta las 10:36 a. m., y el sistema que gestiona los hosts de EC2 había entrado en lo que AWS llama un colapso por congestión una vez que DynamoDB volvió. Los balanceadores de carga también se vieron afectados. AWS dice que las comprobaciones de estado alternaban entre fallo y estado sano, lo que retiraba nodos del DNS, y que en los balanceadores de carga repartidos entre zonas la conmutación por error automática retiró capacidad del servicio. Los ingenieros desactivaron esa conmutación por error a las 9:36 a. m.
Corregir la causa llevó menos de tres horas. Recuperarse de ella llevó unas doce más.
Google Cloud, 20 de octubre de 2026
Se interrumpió el suministro eléctrico del edificio que aloja una zona de Londres (europe-west2-b). Según el informe de Google, ni el controlador principal ni el de respaldo lograron arrancar los generadores, así que las baterías se agotaron y todo lo que había en esa zona se quedó sin energía. Las cargas de trabajo que solo existían en esa zona quedaron inaccesibles.
El daño se extendió más allá de la zona por culpa del plano de control. Google dice que las llamadas de los servicios regionales a la zona fuera de línea agotaron el tiempo de espera, y que el tráfico que pasó por conmutación por error a las otras zonas consumió su capacidad. La interrupción duró de 06:00 a 12:08 UTC, y la creación de nuevas máquinas virtuales se reanudó a las 04:46, hora del Pacífico, es decir, a las 11:46 UTC. El informe final de Google apunta a un error de configuración en los controladores, y su lista de reparaciones seguía abierta cuando se escribió este texto.
Azure, 30 de septiembre de 2026
Microsoft había pausado las actualizaciones del sistema operativo en un grupo de puertas de enlace de red. Cuando terminó la pausa, muchas actualizaciones empezaron a la vez e inundaron un plano de control regional compartido que un cambio reciente ya había hecho más lento. La revisión de Microsoft dice que su limitación de peticiones y su protección frente a la carga «no protegieron lo suficiente el procesamiento crítico».
En algunas puertas de enlace de ExpressRoute, una puerta de enlace que se estaba reiniciando se marcó como sana demasiado pronto, así que la actualización pasó a su respaldo. Algunas conexiones con redes locales se cortaron hasta que las puertas de enlace volvieron a su última configuración correcta. El impacto duró de 20:30 UTC a 02:15 UTC. La lista de reparaciones incluye reanudar por etapas las actualizaciones pausadas.
GitHub, 7 de octubre de 2026
Un servicio interno decide qué servidores de bases de datos reciben las escrituras. Durante un mantenimiento rutinario, una máquina de reemplazo arrancó con registros obsoletos que aún incluían servidores retirados, y envió escrituras a servidores que ya no existían. Las escrituras fallaron durante unos diez minutos cada vez. La segunda vez, según GitHub, una tarea de mantenimiento automatizada volvió a poner la máquina al mando sin respetar una pausa.
Este fue breve, pero encaja en el patrón.
Qué tienen en común los cuatro
Al leer los cuatro informes uno al lado del otro, aparecen tres patrones. Son nuestra lectura de los informes, no una conclusión que haya publicado ningún proveedor.
Primero, la parte que fallaba estaba en el camino hacia la recuperación. AWS necesitaba DynamoDB para reparar EC2. Los servicios de control regionales de Google seguían esperando a una zona que estaba apagada. La reparación de Azure necesitaba un plano de control que ya estaba sobrecargado.
Segundo, la automatización formó parte de la causa en tres de ellos: la gestión de DNS de AWS, las actualizaciones reanudadas de Azure y la tarea de mantenimiento de GitHub. Tercero, la propia conmutación por error generó carga: las zonas supervivientes de Google quedaron desbordadas y la conmutación por error de los balanceadores de carga de AWS retiró capacidad.
Nada de esto significa que la nube sea poco fiable en general. Son cuatro informes, de cuatro proveedores, escritos por los propios proveedores. Lo que sí significa es que «varias zonas» no es una respuesta completa si poner en marcha capacidad en las otras zonas depende de un plano de control que también está en apuros.
Cinco preguntas para tu propio diseño
- Si desapareciera una zona, ¿podrías seguir funcionando sin lanzar nada nuevo?
- ¿Cuáles de tus pasos de recuperación llaman a una API del proveedor: escalado automático, volver a desplegar, cambiar el DNS, iniciar sesión con un rol de la nube?
- ¿Tu conmutación por error empuja carga adicional hacia los lugares que siguen sanos, y tus reintentos hacen todavía más lento un sistema que ya va lento?
- ¿Tus propios cambios de configuración llegan a todos los servidores a la vez o por etapas?
- ¿Has probado el camino de recuperación con el plano de control del proveedor lento o no disponible, o solo cuando funciona?
La capacidad de reserva cuesta dinero, y muchos sistemas pueden permitirse una hora de inactividad. Lo importante es tomar esa decisión de forma deliberada. La pregunta 1 es la más difícil de probar, porque requiere un ensayo cuidadoso o un fallo real de una zona.
¿Conocer, usar o dominar?
Conocer: cualquiera que use servicios en la nube debería saber que estar en funcionamiento y ser gestionable son cosas distintas, y qué significan plano de control y plano de datos.
Usar: los ingenieros que operan producción en una nube deberían poder enumerar qué pasos de recuperación dependen de las API del proveedor y cuáles no.
Dominar: los arquitectos y los ingenieros de fiabilidad deciden cuánta capacidad se mantiene aprovisionada de antemano, cómo se limitan la conmutación por error y los reintentos, y cómo se despliega la configuración por etapas.
Qué puedes ignorar por ahora
Olvídate de clasificaciones de proveedores y de porcentajes de disponibilidad extraídos de estos cuatro eventos. Omite las cronologías exactas salvo que estés redactando una revisión, porque los proveedores ya las han publicado y algunas todavía se están revisando. No necesitas aprender los nombres de los servicios internos de cada proveedor para hacerte las cinco preguntas.
¿Qué deberías hacer a continuación?
Elige un servicio que operes. Anota qué habría que crear, cambiar o llamar en el plano de control del proveedor para mantenerlo en funcionamiento si mañana se apagara una zona. Todo lo que figure en esa lista es una dependencia que puedes probar, acortar o aceptar.
Antes de confiar en un plan de conmutación por error, averigua qué necesita del proveedor mientras el proveedor está en apuros.
Lo que sabemos y lo que no
| Afirmación | Tipo | Fuente |
|---|---|---|
| La interrupción de DNS de DynamoDB en AWS se produjo del 19 al 20 de octubre de 2025, causada por una condición de carrera que dejó vacío un registro DNS | Resumen propio de AWS | Resumen posterior al evento de AWS |
| El DNS ya estaba restablecido a las 2:25 a. m. PDT, pero los lanzamientos de EC2 fallaron hasta las 10:36 a. m. y los errores de los balanceadores de carga duraron hasta las 2:09 p. m. | Resumen propio de AWS | Resumen posterior al evento de AWS |
| AWS desactivó en todo el mundo la automatización DNS Planner y Enactor a la espera de una corrección | Declaración de AWS en su momento. Situación actual desconocida | Resumen posterior al evento de AWS |
| La interrupción de Google en europe-west2 duró de 06:00 a 12:08 UTC el 20 de octubre de 2026, tras un corte eléctrico y un fallo del controlador de los generadores | Informe de incidente de Google, leído a través de un resumen de la página | Incidente de Google Cloud |
| Las llamadas del plano de control entre zonas y la carga de la conmutación por error extendieron el impacto más allá de esa zona | Informe de incidente de Google, leído a través de un resumen de la página | Incidente de Google Cloud |
| El informe final de Google atribuye el fallo del controlador a un error de configuración de la lógica del controlador | Informe final de Google. La frase se comprobó en la página | Incidente de Google Cloud |
| El incidente de puertas de enlace de Azure del 30 de septiembre se debió a que las actualizaciones pausadas, al reanudarse, golpearon un plano de control compartido que ya iba más lento | Revisión posterior al incidente de Microsoft, leída a través de un resumen de la página | Historial de estado de Azure, entrada 7Q30-010 de la lista. La página no tiene un enlace permanente para ella |
| Las interrupciones de escritura de GitHub del 7 de octubre se debieron a una máquina con registros de enrutamiento obsoletos | Publicaciones de estado de GitHub | Incidente de GitHub del 7 de octubre, primera interrupción y reaparición |
Para profundizar
- AWS: Summary of the Amazon DynamoDB service disruption in the Northern Virginia region, para consultar la cronología completa y las medidas correctivas de AWS.
- Incidente de Google Cloud Xs2XTHzAVC9YnafnPyzj, para los informes preliminar y final.
- Historial de estado de Azure, para la revisión posterior al incidente 7Q30-010 del 30 de septiembre (búscala en la lista; no hay enlace directo).
- Estado de GitHub: incidente del 7 de octubre y la reaparición.
- Relacionado en este sitio: La capacidad en la nube no es lo mismo que la disponibilidad, que trata el lado de los fallos de lanzamiento del mismo problema.
Los datos de este artículo se comprobaron el 30 de octubre de 2026. Los proveedores siguen publicando y revisando sus análisis, así que consulta las fuentes anteriores antes de actuar.