

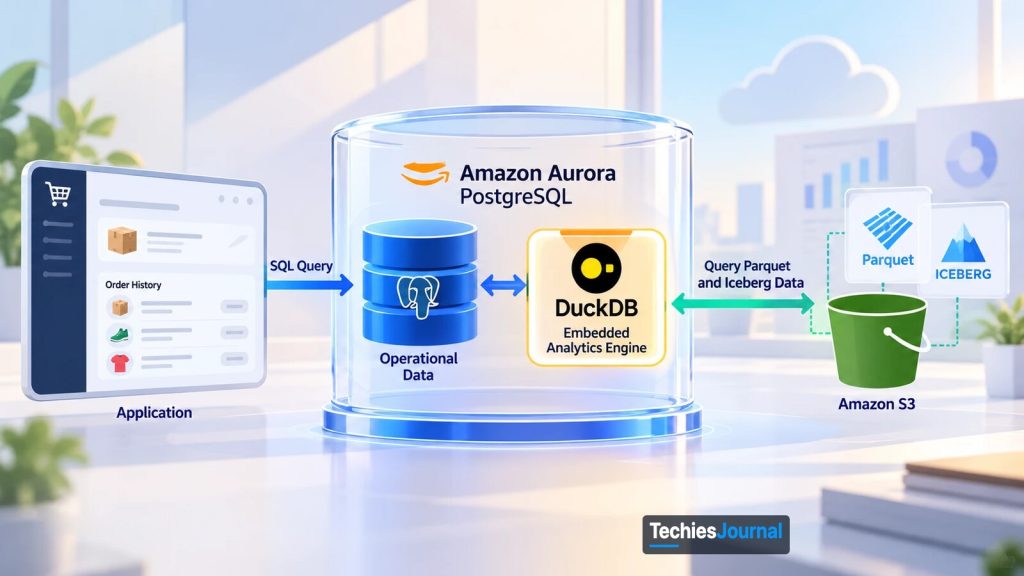
Illustration d’architecture fournie par le propriétaire du site. Les libellés de l’image sont en anglais, et les logos qui y figurent sont des représentations approximatives, utilisées uniquement pour nommer les technologies abordées.
Amazon Aurora PostgreSQL peut désormais interroger des données historiques stockées dans Amazon S3 grâce à un moteur DuckDB intégré. Cette évolution change la façon dont les applications accèdent aux données réparties entre bases opérationnelles et lacs de données. Elle peut supprimer certains processus de copie de données, sans remplacer pour autant l’ensemble du travail d’ingénierie des données.
Quand une application a besoin de données situées à deux endroits
Prenons un commerçant fictif qui exploite une boutique en ligne depuis plusieurs années. Son application utilise Amazon Aurora PostgreSQL pour gérer les clients, les commandes et les paiements. Ces enregistrements changent tout au long de la journée. Quand un client passe commande, la base de données doit enregistrer la transaction de manière fiable et mettre les informations à jour à la disposition de l’application.
L’entreprise conserve aussi plusieurs années de transactions historiques dans Amazon S3. Ces enregistrements sont rarement modifiés, mais ils restent utiles pour répondre aux demandes des clients, produire des rapports et comprendre les habitudes d’achat. Cette organisation fonctionne jusqu’au jour où l’application a besoin d’informations provenant des deux systèmes.
Supposons qu’un client contacte le service d’assistance au sujet d’un produit acheté il y a trois ans. Les commandes récentes se trouvent dans Aurora, mais l’enregistrement de cet achat plus ancien est stocké dans S3. L’équipe d’ingénierie doit faire apparaître cette information dans la vue existante de l’application d’assistance.
Une option consiste à maintenir un processus qui copie les transactions historiques de S3 vers Aurora. Une fois copiées, l’application peut les interroger avec les commandes en cours via PostgreSQL. Cela fonctionne, mais ajoute des responsabilités : l’équipe doit maintenir le processus de copie, gérer les échecs, administrer un stockage en double et garder les informations copiées cohérentes avec la source.
Une autre option consiste à interroger les enregistrements historiques au moyen d’un service analytique distinct, puis à combiner les résultats dans l’application. On évite ainsi de copier les données dans Aurora, mais on ajoute un service et une intégration de plus.
Aucune de ces approches n’est mauvaise en soi. Mais quand il s’agit simplement de retrouver l’historique d’achat d’un client, un déplacement de données ou une intégration supplémentaire peut représenter plus de travail que la fonctionnalité n’en demande. C’est le problème auquel répond la récente évolution d’Aurora chez Amazon.
Ce qu’est DuckDB et ce qui a changé dans Aurora
DuckDB est une base de données open source conçue pour le traitement analytique. Contrairement aux serveurs de bases de données traditionnels, qui fonctionnent généralement comme des services distincts, DuckDB peut s’exécuter directement à l’intérieur d’une application ou d’un outil d’analyse. Développeurs et analystes l’utilisent depuis des langages comme Python pour interroger des fichiers Parquet et des données placées dans un stockage objet cloud tel qu’Amazon S3. Source : DuckDB, Why DuckDB.
DuckDB traite efficacement les requêtes analytiques, en particulier sur de grands jeux de données organisés en colonnes. Avant ce lancement, une application qui voulait utiliser DuckDB à côté d’Aurora devait l’exécuter et l’intégrer séparément. En intégrant DuckDB à Aurora, AWS place le moteur analytique dans l’environnement PostgreSQL : les jeux de données externes pris en charge peuvent être interrogés par la connexion à la base de données que l’application utilise déjà.
Le 30 septembre 2026, AWS a annoncé la disponibilité générale de l’interrogation directe des données Apache Iceberg et Parquet dans Amazon Aurora PostgreSQL. La fonctionnalité est prise en charge à partir d’Aurora PostgreSQL 17.11 et 18.6, dans toutes les régions commerciales AWS et les régions GovCloud (US), sans frais supplémentaires. Source : AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data.
Pour comprendre ce changement, il est utile de distinguer le rôle de chacune des technologies en jeu. Aurora PostgreSQL reste la base de données opérationnelle. Elle gère les enregistrements que les applications lisent, insèrent et mettent à jour fréquemment, comme les commandes en cours et les informations clients.
Amazon S3 stocke les données historiques. Dans l’exemple, les transactions anciennes peuvent être enregistrées sous forme de fichiers Parquet. Parquet organise les données par colonnes, ce qui permet aux systèmes analytiques de lire certains champs sans lire tous les champs de chaque enregistrement. AWS permet aussi de faire pointer des tables distantes vers Amazon S3 Tables et vers l’AWS Glue Data Catalog, mais les fichiers S3 du commerçant suffisent pour suivre le raisonnement.
Apache Iceberg apporte des fonctions de gestion de tables au-dessus des fichiers de données. Il tient à jour des métadonnées qui décrivent le jeu de données et ses évolutions dans le temps, ce qui aide les systèmes analytiques à travailler de façon cohérente sur de grands ensembles de données. DuckDB se charge du traitement des requêtes analytiques. Avec la nouvelle intégration à Aurora, il peut lire les données Parquet et Iceberg prises en charge, tandis que les applications continuent d’utiliser PostgreSQL.
Les enregistrements historiques n’ont pas besoin d’être déplacés dans Aurora simplement parce qu’une application veut les interroger. Ce qui change, c’est le chemin par lequel l’application accède à ces enregistrements.
Comment s’exécute une requête sur l’historique d’un client
Revenons à l’application d’assistance du commerçant. L’équipe d’ingénierie crée dans Aurora une table distante (foreign table) qui représente les commandes historiques stockées dans S3. Une table distante est une définition de table PostgreSQL qui pointe vers des données stockées hors de la base. Elle décrit les colonnes et la source externe, mais n’exige pas que les enregistrements sous-jacents soient copiés dans le stockage Aurora ordinaire.
L’application a désormais accès à deux types de tables via PostgreSQL : des tables natives qui contiennent les commandes en cours, et des tables distantes qui représentent les enregistrements historiques dans S3.
Quand l’application d’assistance demande l’historique d’achat d’un client, elle envoie une requête SQL par sa connexion Aurora habituelle. PostgreSQL analyse et planifie la requête, puis délègue l’exécution au moteur DuckDB intégré, qui lit les données utiles dans S3. Selon AWS, des plans entiers, y compris les jointures entre tables distantes et tables PostgreSQL locales, peuvent être délégués au moteur. La requête renvoie des lignes PostgreSQL ordinaires et, toujours selon AWS, ces requêtes s’exécutent dans un seul processus et participent aux transactions de la session comme n’importe quelle autre requête PostgreSQL.
Suivre une requête sur l’historique d’un client
Sélectionnez une étape pour voir où se trouve la requête et ce qui s’y passe.
Aurora PostgreSQL
L’application d’assistance envoie une requête SQL ordinaire. Elle continue d’utiliser son pilote et sa connexion existants.
Aurora PostgreSQL
PostgreSQL analyse et planifie la requête, puis délègue l’exécution au moteur DuckDB intégré. Selon AWS, des plans entiers, y compris les jointures entre tables distantes et tables natives, peuvent lui être délégués.
Aurora PostgreSQL
DuckDB ne lit dans S3 que les plages d’octets dont il a besoin, avec le rôle IAM associé au cluster. L’élagage des colonnes et les filtres permettent d’ignorer les données que la requête ne référence pas.
Aurora PostgreSQL
Les données consultées fréquemment sont mises en cache sur le stockage local de l’instance et partagées entre les sessions, si bien que les requêtes répétées peuvent éviter S3. Le cache est vidé quand l’instance redémarre ou bascule (failover).
Aurora PostgreSQL
Les résultats reviennent sous forme de lignes PostgreSQL ordinaires. Selon AWS, les requêtes qui joignent tables distantes et tables natives s’exécutent dans un seul processus et participent aux transactions de la session.
Une vue simplifiée de la description que fait AWS du fonctionnement de la fonctionnalité. Ce n’est pas un modèle de performances.
La définition de la table distante reste dans Aurora, tandis que les données historiques restent dans S3. Aurora ne se contente pas d’importer tout le jeu de données historique avant de répondre à la requête. Pour les opérations prises en charge, le moteur ne lit que les plages d’octets dont il a besoin, en ignorant les colonnes que la requête ne référence pas et les fichiers dont les statistiques ne peuvent pas correspondre au filtre. Les données consultées fréquemment sont aussi mises en cache sur le stockage local de l’instance et partagées entre les sessions.
Le travail réellement effectué dépend de la requête et de son plan d’exécution, mais l’application n’a plus forcément besoin d’un processus de copie distinct ni d’une connexion à un service analytique pour ce type de demande. Source : AWS, fonctionnement des requêtes analytiques dans Aurora.
L’approche comporte une limite importante : les tables distantes sont en lecture seule. Elles permettent aux applications d’interroger des données externes, mais INSERT, UPDATE, DELETE, TRUNCATE et COPY FROM n’y sont pas pris en charge.
Pour modifier les données, mettez à jour les fichiers source dans S3, ou la table Iceberg au moyen d’AWS Glue ou d’autres outils. Pour l’historique des achats du commerçant, un accès en lecture seule peut suffire. D’autres applications peuvent exiger une conception différente.
Là où le pipeline de données se simplifie
Le commerçant a peut-être créé son processus de copie des données historiques pour une seule raison : l’application d’assistance avait besoin d’une copie des anciennes transactions accessible depuis PostgreSQL. Si l’interrogation directe d’Aurora répond aux exigences de performances et de fiabilité de l’application, ce processus de copie n’est peut-être plus nécessaire. L’entreprise pourrait conserver ses données historiques dans S3, les exposer par des tables distantes et supprimer la copie supplémentaire dans Aurora.
Copier dans Aurora ou interroger sur place
Passez d’une conception à l’autre pour comparer ce que l’équipe doit faire tourner.
Ce que l’équipe exploite et maintient
- Le processus de copie et la gestion de ses échecs
- Un stockage en double pour l’historique copié
- La cohérence de la copie avec la source
L’application interroge l’historique copié via PostgreSQL, avec les commandes en cours.
Ce que l’équipe exploite et maintient
- La définition de la table distante et l’accès à S3
- Les tests de performances et de consommation de ressources sur des requêtes représentatives
- La surveillance du CPU et de la mémoire d’Aurora, du taux de succès du cache et des lectures S3, et éventuellement une instance de lecture dédiée
- Le processus qui prépare des données propres et les dépose dans S3 (cette fonctionnalité ne le remplace pas)
L’historique reste dans S3 et l’application le lit via PostgreSQL. Que cette solution soit plus simple ou non dépend des performances et des coûts mesurés.
À titre d’illustration, pour le commerçant fictif de l’article. La possibilité de supprimer la copie dépend des tests.
Mais la distinction change quand le pipeline fait plus que copier des données. Supposons que le même commerçant reçoive des transactions de son site web, de ses magasins physiques et de places de marché externes. Ces systèmes peuvent utiliser des identifiants clients, des codes produits et des formats de transaction différents. L’équipe d’ingénierie doit toujours réconcilier ces différences, corriger les enregistrements incohérents et préparer des informations fiables.
DuckDB n’effectue pas automatiquement ces transformations métier simplement parce qu’il peut interroger les données qui en résultent. Le processus qui dépose les enregistrements historiques dans S3 peut lui aussi rester nécessaire.
La nouvelle fonctionnalité porte sur la façon dont Aurora accède à des données externes déjà préparées. Elle ne remplace pas l’ensemble du processus de collecte, de validation, de transformation et de gouvernance de ces données.
Comment Azure et Google Cloud abordent le même problème
AWS n’est pas le seul fournisseur à simplifier l’accès entre systèmes opérationnels et analytiques, mais les architectures diffèrent. Microsoft Azure permet la mise en miroir des données d’Azure Database for PostgreSQL dans OneLake, au sein de Microsoft Fabric, où, selon Microsoft, une copie répliquée en continu devient disponible pour l’analyse sans ETL complexe. Google Cloud propose les requêtes fédérées BigQuery, qui envoient une requête depuis BigQuery vers Cloud SQL, AlloyDB ou Spanner et renvoient le résultat sous forme de table temporaire, sans charger d’abord ces données dans le stockage BigQuery.
Aurora emprunte une troisième voie en intégrant DuckDB dans PostgreSQL pour interroger les données externes prises en charge d’un lac de données. Ce sont des solutions voisines à des problèmes d’accès aux données, pas des mises en œuvre interchangeables.
| Fournisseur | Approche | Où s’exécute la requête analytique | Les données sont-elles copiées ? |
|---|---|---|---|
| AWS | Tables distantes Aurora PostgreSQL sur des données Parquet et Iceberg | Dans le cluster Aurora, dans le moteur DuckDB intégré | Pas dans des tables Aurora. Les données sont lues sur place, et les données fréquemment utilisées sont mises en cache sur l’instance |
| Microsoft Azure | Mise en miroir d’Azure Database for PostgreSQL dans Microsoft Fabric | Dans Fabric, sur la copie répliquée dans OneLake | Oui, répliquées en continu par le service |
| Google Cloud | Requêtes fédérées BigQuery vers Cloud SQL, AlloyDB ou Spanner | L’instruction s’exécute sur la base source, et BigQuery reçoit le résultat | Pas de façon persistante. Les résultats reviennent sous forme de table temporaire, et Google indique que les performances peuvent être inférieures à celles d’une lecture du stockage BigQuery |
Le tableau montre pourquoi le choix ne se résume pas aux fonctionnalités. Chaque voie place le travail analytique à un endroit différent. Sources : Microsoft, mise en miroir de PostgreSQL dans Fabric et Google Cloud, requêtes fédérées BigQuery.
Les limites de l’analytique exécutée dans Aurora
L’interrogation directe peut simplifier une application, mais elle ne rend pas les charges de travail analytiques exemptes de conséquences opérationnelles. Aurora traite souvent des transactions pour lesquelles le temps de réponse compte. Les clients s’attendent à ce que commandes et paiements aboutissent de manière fiable pendant que l’application sert son trafic normal.
Les requêtes analytiques se comportent différemment. Elles peuvent lire de grands jeux de données, effectuer des calculs complexes et consommer beaucoup de mémoire ou de ressources de traitement. Même si DuckDB est optimisé pour le traitement analytique, son exécution intégrée utilise des ressources de calcul du cluster de base de données Aurora.
Une consultation occasionnelle de l’historique d’un client peut se prêter à l’interrogation directe. Des centaines de rapports simultanés parcourant plusieurs années de transactions pourraient créer une tout autre charge de travail, en concurrence avec les opérations normales de l’application pour le CPU et la mémoire.
AWS recommande d’exécuter les charges de travail qui sollicitent fortement les tables distantes sur une instance de lecture dédiée, plutôt qu’à côté des transactions de production. AWS indique aussi que les instances dotées d’un stockage NVMe local offrent un cache et un débordement sur disque plus rapides que les instances qui n’utilisent que EBS. Source : AWS, choisir la bonne classe d’instance de base de données.
D’autres restrictions comptent aussi. AWS indique dans sa documentation que certains types de données PostgreSQL, dont JSONB, SERIAL et les types tableau, n’ont pas de correspondance prise en charge. Une même requête ne peut pas lire des données S3 situées dans plus d’une région AWS, même si les données peuvent se trouver dans une autre région que celle du cluster.
Le cache sur disque est vidé quand une instance redémarre ou bascule, si bien que les requêtes suivantes relisent les données dans S3. Sur Aurora Serverless v2, plusieurs requêtes analytiques lourdes simultanées peuvent dépasser le rythme auquel l’instance peut augmenter sa capacité. Source : AWS, limites de l’analytique dans Aurora.
Le coût doit être évalué de la même manière. L’annonce d’AWS indique seulement que la fonctionnalité elle-même n’entraîne pas de frais supplémentaires. Les requêtes analytiques consomment toujours des ressources Aurora, et les frais Amazon S3 applicables, comme les requêtes et l’éventuel transfert de données, peuvent s’appliquer quand les données sont lues dans S3.
Supprimer un processus de copie de données peut réduire les coûts de stockage et de maintenance. Mais si les requêtes analytiques directes exigent des instances Aurora plus grandes ou des instances de lecture dédiées, le bénéfice financier global peut être différent. Ni un coût plus bas ni de meilleures performances ne doivent être tenus pour acquis sans avoir testé une charge de travail représentative.
Ce que cela signifie pour une application existante
Pour le commerçant, la décision technique est désormais plus ciblée. L’équipe n’a pas besoin de repenser toute sa plateforme de données. Elle doit examiner pourquoi le processus de copie des données historiques existe.
Si ce processus sert uniquement à rendre accessibles via Aurora des enregistrements de S3 déjà prêts à être interrogés, la nouvelle intégration de DuckDB offre une solution de rechange qui vaut la peine d’être testée. L’équipe peut comparer l’approche existante avec des requêtes directes sur des tables distantes, à partir de demandes d’historique client réalistes et du trafic attendu de l’application. Elle devrait mesurer :
- Les temps de réponse de la requête sur l’historique client, comparés à ceux de la version actuelle fondée sur la table copiée.
- L’utilisation du CPU et de la mémoire d’Aurora pendant l’exécution de la requête, y compris les métriques de mémoire analytique et de débordement sur disque qu’AWS publie dans Amazon CloudWatch.
- Les lectures S3 et le taux de succès du cache, qui montrent quelle part des données est servie localement après les premières requêtes.
- L’effet sur les transactions normales de commande et de paiement exécutées en même temps.
Le résultat déterminera si la suppression du processus de copie simplifie réellement l’exploitation. Les systèmes plus larges de préparation des données et de reporting peuvent rester inchangés.
Si les requêtes directes se révèlent trop lentes pour un chemin sensible à la latence, AWS décrit aussi une option intermédiaire : matérialiser les données Iceberg ou Parquet dans des tables Aurora natives avec du SQL standard, sans pipeline ETL.
Choisir comment interroger des données historiques depuis Aurora
Répondez à trois questions au plus. Cette aide à la décision est celle de TechiesJournal, pas une recommandation d’AWS, et elle n’est pas exhaustive.
Devez-vous insérer, mettre à jour ou supprimer les enregistrements historiques par la table distante ?
Les tables distantes sont en lecture seule. Mettez à jour les fichiers source dans S3, ou la table Iceberg au moyen d’AWS Glue ou d’autres outils, et adoptez une autre conception pour les données qui doivent être modifiées via PostgreSQL.
Les requêtes sur les tables distantes seront-elles lourdes ou fréquentes (grands balayages, nombreux rapports simultanés) plutôt que des consultations occasionnelles ?
Prévoyez l’isolement. AWS recommande d’exécuter les charges de travail lourdes sur tables distantes sur une instance de lecture dédiée, et conseille une classe dotée d’un stockage NVMe local pour les charges de travail de production sur tables distantes. Testez avec une charge de travail représentative.
Lors des tests, la requête directe atteint-elle votre objectif de latence sur le chemin normal des commandes ?
Conservez la table distante. Continuez à mesurer le CPU et la mémoire d’Aurora, le taux de succès du cache et les lectures S3, puis décidez si le processus de copie peut disparaître.
Envisagez la matérialisation. Pour les charges de travail sensibles à la latence, AWS décrit le chargement de données Iceberg ou Parquet dans des tables Aurora natives avec du SQL standard, sans pipeline ETL. Une copie revient alors dans le stockage Aurora, et c’est à vous de la tenir à jour (remarque de TechiesJournal).
Consultez aussi la liste des limites publiée par AWS : certains types de données ne sont pas pris en charge, une requête ne peut pas lire des données S3 situées dans plus d’une région, et Aurora Serverless v2 peut ne pas augmenter sa capacité assez vite pour plusieurs requêtes lourdes simultanées.
Le moteur DuckDB intégré à Amazon Aurora ne marque donc pas la fin des pipelines analytiques. Il déplace une frontière importante entre les bases de données opérationnelles et le stockage des données historiques. Pour les charges de travail prises en charge, les applications peuvent désormais réunir informations actuelles et historiques via PostgreSQL, sans maintenir une copie de plus des enregistrements historiques.
L’intérêt est de supprimer les déplacements de données qui ne servent plus à rien, tout en conservant les capacités de traitement des données et d’analyse dont l’entreprise a toujours besoin.
Pour aller plus loin
Recherches examinées le 21 octobre 2026. Le commerçant est un scénario fictif. L’article ne revendique aucun banc d’essai de performances indépendant ni aucune comparaison de coûts.
Annonce et documentation d’AWS
- AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data, 30 septembre 2026 : disponibilité de la fonctionnalité, versions du moteur et régions prises en charge.
- AWS, fonctionnement des requêtes analytiques dans Aurora : traitement des requêtes, DuckDB intégré, tables distantes et intégration au lac de données.
- AWS, choisir la bonne classe d’instance de base de données : mémoire, concurrence et isolement des charges de travail.
- AWS, limites de l’analytique dans Aurora : tables en lecture seule, types de données, régions et comportement du cache.
Contexte et autres fournisseurs cloud
- DuckDB, Why DuckDB : traitement analytique intégré et cas d’usage courants.
- Microsoft, Azure Database for PostgreSQL mirroring in Fabric : comment les données PostgreSQL opérationnelles sont répliquées dans OneLake.
- Google Cloud, Introduction to BigQuery federated queries : interroger des bases de données opérationnelles externes depuis BigQuery.
À lire aussi sur TechiesJournal
- Le réseau multicloud devient un service cloud : ce qu’AWS, Google et Azure standardisent (en anglais), sur la façon dont ces trois mêmes fournisseurs standardisent une autre couche du cloud.