

Un comercio en línea se prepara para la mayor campaña de ofertas del año. La aplicación superó sus pruebas de carga. El escalado automático está activado, se ampliaron las cuotas del servicio y la página de estado de la nube no muestra ningún problema.
Cuando arranca la campaña de ofertas, el tráfico crece según lo previsto. El escalador automático pide más máquinas virtuales, pero la plataforma de nube no puede suministrar el tipo de máquina elegido en esa zona. Algunas de las solicitudes de escalado fallan.
El proveedor no ha sufrido una interrupción regional. Otros clientes y servicios pueden estar funcionando con normalidad. Aun así, esta aplicación no consigue los recursos que necesita.
Esta situación sorprende a los equipos porque los servicios en la nube suelen parecer ilimitados. Pedimos infraestructura mediante una API y la recibimos en minutos. Cuando esto ha funcionado cientos de veces, es fácil tratar la capacidad como una propiedad permanente del servicio.
No lo es. La API sigue dependiendo de equipos físicos situados en un lugar real.
Qué hay detrás de una solicitud a la nube
Una solicitud de máquina virtual acaba necesitando un servidor con el procesador, la memoria y las conexiones locales adecuados. Una solicitud de GPU necesita un acelerador concreto y el hardware que lo acompaña. Ambas dependen del almacenamiento, las redes, la refrigeración, la electricidad y el espacio disponible en los centros de datos.
Esos recursos están instalados en ubicaciones concretas. Si la demanda crece en un lugar, el hardware sin usar de otra región no puede cubrirla de inmediato. Los proveedores pueden añadir infraestructura, pero la nueva capacidad de un centro de datos requiere tiempo para planificarla, darle suministro eléctrico, construirla y conectarla.
La escala de ese trabajo está creciendo. El análisis Energy and AI de la Agencia Internacional de la Energía prevé que el consumo eléctrico mundial de los centros de datos podría más que duplicarse hasta unos 945 teravatios hora en 2030. Esto no significa que la capacidad de la nube se esté agotando en general. Muestra que la expansión depende ahora de algo más que comprar servidores: la electricidad y la infraestructura de apoyo también tienen que llegar a los lugares adecuados.
La inversión global de un proveedor dice poco sobre si tu cuenta podrá lanzar mañana por la mañana una GPU concreta en una zona determinada.
«Disponible» puede significar varias cosas
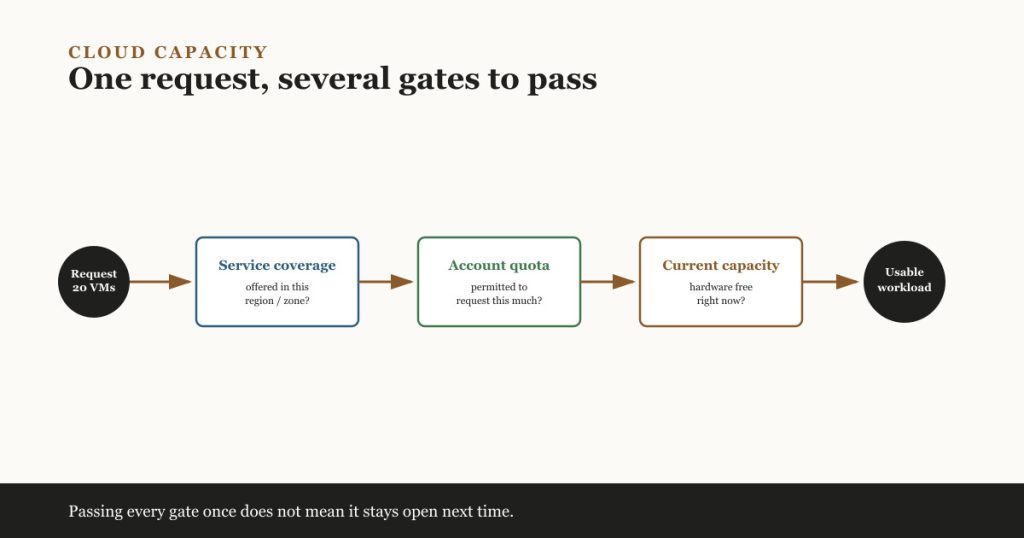
Supongamos que un equipo quiere veinte máquinas de un tipo en una zona concreta. Para que la solicitud prospere, deben cumplirse varias condiciones.
| Comprobación | Qué significa |
|---|---|
| Cobertura del servicio | La familia de máquinas y las funciones necesarias se ofrecen en esa región o zona. |
| Cuota de la cuenta | El proyecto o la suscripción tiene permiso para solicitar esa cantidad. |
| Capacidad actual | El proveedor tiene suficiente hardware adecuado libre en ese momento. |
| Garantía de capacidad | Una reserva válida o un acuerdo similar retiene los recursos necesarios. |
| Disponibilidad de la carga de trabajo | La aplicación puede seguir siendo utilizable o recuperarse cuando no se puede asignar un recurso. |
Estas comprobaciones están relacionadas, pero no son intercambiables.
Un tipo de máquina puede figurar en el catálogo regional aunque una zona no tenga capacidad libre. El hardware puede estar disponible y la cuota del cliente ser demasiado baja. Una reserva puede asegurar capacidad de cómputo en una zona y, al mismo tiempo, dejar la aplicación expuesta a un fallo de esa zona.
Por eso la frase «el servicio está disponible» es demasiado vaga para planificar la capacidad.
La aprobación de una cuota no confirma la capacidad física
Una cuota controla cuánto de un recurso puede usar una cuenta, un proyecto o una suscripción. Si una cuenta está limitada a 100 CPU virtuales, una solicitud que elevaría el uso a 120 puede fallar aunque el proveedor tenga hardware de sobra.
Los equipos suelen resolverlo solicitando un límite mayor, reduciendo el uso o trasladando parte de la carga de trabajo. Las comprobaciones de cuota deben formar parte de la planificación de versiones y eventos, porque las aprobaciones pueden tardar.
La capacidad física es otra cuestión. La cuenta puede tener una cuota de 500 CPU virtuales y aun así no conseguir 200 CPU de una familia de máquinas concreta en una zona.
No es un comportamiento inusual ni oculto. La documentación de AWS describe los errores InsufficientInstanceCapacity y sugiere probar otro tipo de instancia, otra zona de disponibilidad u otro momento. La guía de Microsoft para Azure explica que un tipo de VM preferido puede no estar disponible temporalmente en la ubicación elegida. Google Cloud documenta errores similares de disponibilidad de recursos para solicitudes como vCPU y GPU.
Una cuota aprobada significa que la cuenta tiene permiso para pedir. No promete que la respuesta vaya a ser sí.
Dónde llega a su límite el escalado automático
El escalado automático responde a la demanda solicitando más recursos. No puede fabricar hardware que no está disponible.
Volvamos al comercio en línea. Su política de escalado solo permite una familia de máquinas, porque el equipo probó esa configuración y la copió en producción. Todas las instancias deben ejecutarse en la misma zona que otra dependencia. Cuando la capacidad escasea, el escalador automático repite una solicitud que la plataforma no puede atender.
La aplicación tiene escalado automatizado, pero carece de flexibilidad.
Un diseño mejor podría admitir dos o tres familias de máquinas probadas, repartir la capacidad entre zonas, poner el trabajo entrante en una cola o reducir el procesamiento no esencial durante un pico. La elección correcta depende de la carga de trabajo. Un appliance de base de datos con licencia no puede cambiar de configuración tan fácilmente como un grupo de servidores web sin estado.
Las configuraciones especializadas y grandes merecen una atención especial. Los clústeres de GPU, las máquinas excepcionalmente grandes y las flotas de cómputo muy concentradas dejan al proveedor menos opciones de ubicación. La flexibilidad debe diseñarse y probarse antes de que llegue la demanda.
Cuándo tiene sentido una reserva
Los proveedores ofrecen reservas de capacidad para cargas de trabajo que no pueden depender de una asignación según disponibilidad (best-effort). AWS EC2 Capacity Reservations, por ejemplo, puede retener una configuración determinada en una zona de disponibilidad concreta. Las reservas de Google Cloud también verifican que la capacidad solicitada esté disponible antes de reservarla en una zona.
Esto puede ser útil para una migración planificada, una gran campaña de ofertas, un requisito de recuperación o una carga de trabajo que necesite aceleradores escasos. La organización paga por una mayor certeza y acepta las reglas de configuración y ubicación de la reserva.
Hay un límite importante: la capacidad de cómputo reservada no hace resiliente todo el servicio. Si todas las máquinas reservadas están en una sola zona, un problema en esa zona puede seguir afectando a la flota. La aplicación también puede depender de una única base de datos, un único servicio de identidad o una única ruta de red. Cada dependencia necesita su propio diseño de disponibilidad y recuperación.
La reserva ayuda a responder si se puede asignar capacidad de cómputo. No responde si el servicio de negocio sobrevivirá a un fallo.
La suposición de la máquina detenida
A veces los equipos detienen máquinas fuera del horario laboral o conservan recursos desasignados para la recuperación ante desastres. La configuración sigue visible en la consola, lo que puede dar la impresión de que el hardware sigue esperando.
Según el servicio y el acuerdo de reserva, detener o desasignar una máquina puede liberar su capacidad física. Volver a arrancarla más tarde puede requerir una nueva asignación. Si ese tipo de máquina escasea, el reinicio puede fallar aunque antes funcionara.
Por eso una prueba de recuperación debe hacer algo más que revisar plantillas y confirmar que existen copias de seguridad. El equipo debe arrancar o crear los recursos necesarios, restaurar los datos, volver a conectar las dependencias y medir cuánto tarda en ofrecer un servicio utilizable. Una prueba satisfactoria con una sola máquina pequeña no demuestra que se pueda recuperar una flota de producción completa.
Preguntas que hay que resolver antes del próximo pico
Empieza por enumerar las partes de la carga de trabajo que no se pueden mover. Las normas de residencia de datos pueden exigir una región concreta. Las licencias de software pueden restringir los tipos de instancia. Las necesidades de rendimiento pueden atar un servicio a una familia de GPU o al almacenamiento local. Estas restricciones determinan cuántas alternativas existen realmente.
Después, responde a lo siguiente:
- ¿Qué cuotas podrían bloquear el crecimiento y cuándo se comprobaron por última vez?
- ¿Qué tipos de máquina alternativos se han probado de verdad?
- ¿Puede la carga de trabajo usar otra zona sin incumplir los requisitos de datos, latencia o licencias?
- ¿Qué eventos requieren capacidad reservada en lugar de una asignación según disponibilidad?
- ¿Qué ocurre con el trabajo entrante mientras no hay nueva capacidad disponible?
- ¿Puede el plan de recuperación asignar toda la flota necesaria, y no solo una instancia de demostración?
- ¿Reconoce la automatización un error de capacidad y elige una alternativa aprobada, o simplemente reintenta sin fin?
No todos los sistemas necesitan varias regiones o hardware reservado. Un pequeño servicio interno puede aceptar más riesgo que una plataforma de pagos durante un pico estacional. La decisión debe ser deliberada y comparar el costo de la protección con el impacto en el negocio de tener que esperar a que haya capacidad.
Qué deberían aprender los equipos
Quienes aprueban o diseñan sistemas en la nube deberían entender la diferencia entre la cobertura regional del servicio, la cuota de la cuenta, la capacidad física actual, las reservas y la disponibilidad de la aplicación.
Los ingenieros de nube, de plataforma y de fiabilidad necesitan experiencia práctica con cuotas, configuraciones alternativas, comportamiento del escalado, reservas y pruebas de recuperación realistas. Los ingenieros responsables de grandes flotas de aceleradores o de plataformas críticas necesitan un conocimiento más profundo de las restricciones de ubicación y de los compromisos de capacidad, porque pequeñas decisiones de diseño pueden eliminar opciones de respaldo.
No se trata de predecir si un proveedor de nube se quedará sin infraestructura. Se trata de encontrar las suposiciones que esconde una carga de trabajo concreta.
Antes de la próxima migración, campaña de ofertas o simulacro de recuperación, plantea una pregunta precisa: si el recurso preferido no se puede asignar en la ubicación elegida, ¿qué hará el sistema?
Si nadie ha puesto a prueba la respuesta, el plan de capacidad está sin terminar.
Referencias y lecturas adicionales
- Energy demand from AI — Agencia Internacional de la Energía. Proyecciones del consumo eléctrico de los centros de datos y de la infraestructura que hay detrás de la expansión de la capacidad.
- Troubleshoot Amazon EC2 instance launch issues — AWS. Causas y respuestas ante errores de lanzamiento por capacidad insuficiente.
- Troubleshoot Azure VM allocation failures — Microsoft. Cómo afectan a la asignación la ubicación, el tamaño de la VM y las restricciones del despliegue.
- Troubleshooting resource availability errors — Google Cloud. Escasez de recursos por zona y respuestas posibles.
- EC2 On-Demand Capacity Reservations — AWS. Cómo funcionan las reservas de capacidad por zona.
- Compute Engine reservations overview — Google Cloud. Cómo verifica y retiene Compute Engine los recursos reservados.