

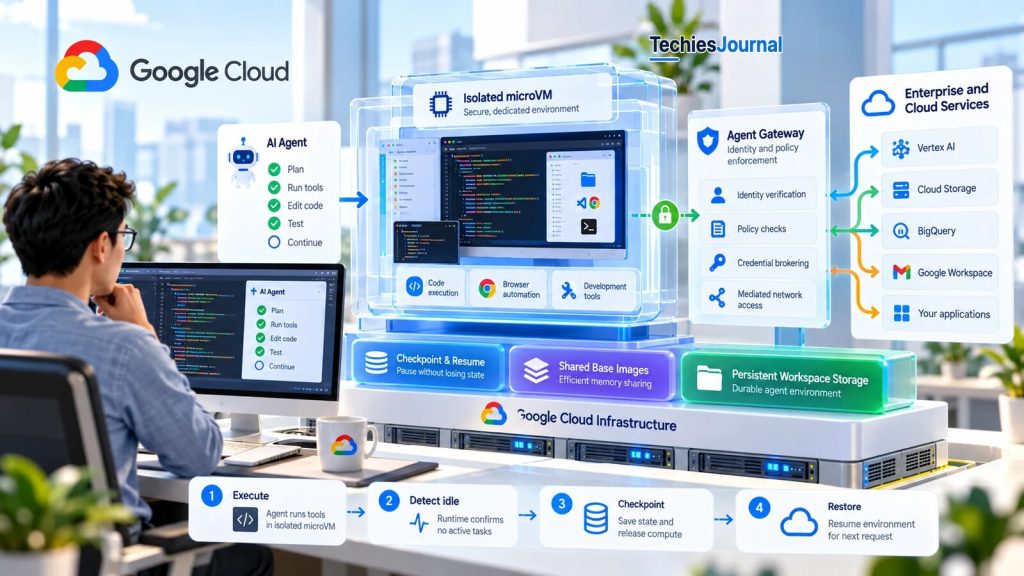
लेख में वर्णित आर्किटेक्चर का चित्र: एक agent, उसका isolated microVM, पहुँच को मध्यस्थ करने वाला gateway, और checkpoint, साझा image तथा workspace स्टोरेज। यह वैचारिक है, आधिकारिक Google Cloud डायग्राम नहीं है और मापा गया प्रदर्शन नहीं दिखाता।
Google का Agent Compute Engine हार्डवेयर-आइसोलेटेड microVMs, checkpoint-आधारित निष्पादन, साझा मेमोरी और बाहर से लागू की जाने वाली अनुमतियों को जोड़ता है। यह आर्किटेक्चर स्वायत्त agents के बड़े बेड़े चलाने की एक कठिन समस्या को संबोधित करता है: agent के काम करने वाले कंप्यूटर को सुरक्षित रखते हुए उन संसाधनों को कैसे छोड़ा जाए जिनकी उसे अब ज़रूरत नहीं।
agents को ऐसा कामकाजी कंप्यूटर चाहिए जो खाली रहते समय कंप्यूट न रोके
एक coding agent कई मिनट तक किसी प्रोजेक्ट को compile कर सकता है, tests चला सकता है, नतीजे जाँच सकता है और फिर डेवलपर के जवाब का इंतज़ार कर सकता है। डेवलपर लौटता है तो agent को अपनी फ़ाइलें, इंस्टॉल की गई dependencies और निष्पादन परिवेश ज्यों का त्यों चाहिए। उस परिवेश को एक समर्पित virtual machine पर चलाना सीधा है, लेकिन ऐसे सैकड़ों हज़ार परिवेशों को सँभालना एक अलग समस्या है।
हर agent को आइसोलेशन चाहिए क्योंकि वह जनरेट किया हुआ या अपरिचित कोड चला सकता है। उसे ऐसा workspace भी चाहिए जो कार्यों के बीच बचा रहे। लेकिन हर प्रतीक्षारत agent के लिए CPU और मेमोरी आवंटित रखने से इन्फ़्रास्ट्रक्चर लगातार महँगा होता जाता है, भले ही बहुत कम काम हो रहा हो।
October 22, 2026 को Google ने Agent Compute Engine पेश किया, जो ऐसी विशेषताओं वाले वर्कलोड के लिए विकसित एक managed कंप्यूटिंग आर्किटेक्चर है। यह प्लैटफ़ॉर्म पहले से Google के आंतरिक Gemini, Antigravity और agent-evaluation सिस्टम को सहारा देता है, और बाहरी ग्राहकों के लिए preview आने वाले महीनों में नियोजित है।
Google का तरीका इसलिए उल्लेखनीय है कि वह agent के निष्पादन परिवेश को एक स्थायी संसाधन मानता है जिसे उसे चलाने वाली भौतिक मशीन से अलग किया जा सकता है। हर सेशन के लिए कंप्यूट को लगातार आरक्षित रखने के बजाय, प्लैटफ़ॉर्म किसी परिवेश की स्थिति सुरक्षित रख सकता है, उसके सक्रिय संसाधन छोड़ सकता है और agent को आगे बढ़ना हो तो उसे बहाल कर सकता है। इसके पीछे की इंजीनियरिंग किसी AI agent को बस container में रख देने से कहीं ज़्यादा जटिल है।
harness अपने कमांड चलाने वाले sandbox के बाहर रहता है
Google का आर्किटेक्चर agent को पहले दो घटकों में बाँटता है। harness AI मॉडल के साथ बातचीत सँभालता है, और तय करता है कि कौन से tools बुलाने हैं और कौन सी कार्रवाइयाँ आज़मानी हैं। sandbox उन कार्रवाइयों को निष्पादित करता है, और कमांड चलाने, फ़ाइलें बदलने, सॉफ़्टवेयर इंस्टॉल करने और browser tools इस्तेमाल करने के लिए ज़रूरी ऑपरेटिंग-सिस्टम परिवेश देता है।
किसी सॉफ़्टवेयर रिपॉज़िटरी पर काम कर रहे agent की कल्पना कीजिए। harness test suite चलाने का फ़ैसला कर सकता है, लेकिन compilation और testing sandbox के अंदर होते हैं।
Agent Compute Engine उस निष्पादन परिवेश के लिए एक समर्पित microVM इस्तेमाल करता है। सामान्य container के उलट, जो आम तौर पर host ऑपरेटिंग-सिस्टम kernel साझा करता है, microVM का अपना guest kernel हार्डवेयर virtualization सीमा के पीछे होता है। यह तब मायने रखता है जब coding agents को root अधिकार, कस्टम डेवलपमेंट tools या ऐसा कोड चलाने की क्षमता चाहिए जिस पर भरोसा नहीं किया जा सकता।
Google अपने microVMs को single-tenant निष्पादन परिवेश बताता है, जिनकी सुरक्षा व्यवस्थाएँ Titanium इन्फ़्रास्ट्रक्चर से समर्थित हैं। harness sandbox के बाहर चलता है, इसलिए संभावित रूप से असुरक्षित कमांड चलाने वाला परिवेश भरोसेमंद orchestration प्रक्रिया को भी नियंत्रित नहीं करता। यह अलगाव एक उपयोगी परिचालन सीमा बनाता है, क्योंकि सिस्टम agent का काम निर्देशित करने वाले harness से स्वतंत्र रूप से किसी sandbox को सँभाल, रोक या बदल सकता है।
runtime जब बताता है कि कोई काम बाक़ी नहीं, तब agent निष्क्रिय होता है
agent की गतिविधि किसी पारंपरिक वेब सर्विस जैसी नहीं होती जो अनुरोध लेकर जवाब देती है और अपना निष्पादन परिवेश भूल जाती है। agent बार-बार tool निष्पादन और मॉडल inference, बाहरी सेवाओं या मानवीय इनपुट की प्रतीक्षा के बीच बदल सकता है। सामान्य-उद्देश्य वाला virtual-machine hypervisor संसाधन उपयोग देख सकता है, लेकिन ज़रूरी नहीं कि वह समझे कि guest अगले agent निर्देश का इंतज़ार कर रहा है या कोई वैध बैकग्राउंड जॉब चला रहा है।
Google इसे sandbox के कमांड runtime को host executor से जोड़कर हल करता है। किसी tool call के पूरा होने के बाद, runtime तय कर सकता है कि कोई सक्रिय कमांड या बैकग्राउंड टास्क बचा है या नहीं। परिवेश के सुरक्षित निष्क्रिय स्थिति में पहुँचने पर, sandbox वह स्थिति host को संकेत देता है।
तब host execution संसाधन आरक्षित रखने के बजाय microVM को checkpoint कर सकता है। harness जब अगला tool call करता है, परिवेश बहाल हो जाता है और निष्पादन फिर शुरू होता है।
महत्वपूर्ण तंत्र application-aware idle detection है। इन्फ़्रास्ट्रक्चर केवल कम CPU उपयोग देखकर अनुमान नहीं लगाता कि परिवेश को रोका जा सकता है, क्योंकि उसे agent-execution runtime से लाइफ़साइकिल जानकारी मिलती है। यह इसलिए मायने रखता है कि कोई प्रक्रिया नेटवर्क गतिविधि या बाहरी घटना की प्रतीक्षा करते हुए लगभग कोई CPU इस्तेमाल न करे और फिर भी ज़रूरी काम कर रही हो।
कम CPU का मतलब निष्क्रिय होना क्यों नहीं है
परिदृश्य: एक प्रक्रिया नेटवर्क गतिविधि या बाहरी घटना की प्रतीक्षा कर रही है। चुनिए कि इन्फ़्रास्ट्रक्चर कैसे तय करता है, और देखिए हर तरीका क्या बता सकता है।
केवल CPU से अनुमान
यह क्या देखता है
- प्रतीक्षा करती प्रक्रिया लगभग कोई CPU इस्तेमाल नहीं करती, इसलिए परिवेश निष्क्रिय दिखता है।
- सामान्य-उद्देश्य वाला hypervisor संसाधन उपयोग देख सकता है।
यह क्या नहीं बता सकता
- क्या प्रक्रिया अब भी ज़रूरी काम कर रही है, क्योंकि प्रक्रिया नेटवर्क गतिविधि या बाहरी घटना की प्रतीक्षा करते हुए भी ज़रूरी हो सकती है।
- क्या guest अगले agent निर्देश का इंतज़ार कर रहा है या कोई वैध बैकग्राउंड जॉब चला रहा है।
runtime द्वारा बताई निष्क्रिय स्थिति
यह क्या देखता है
- tool call पूरा होने के बाद, runtime जाँचता है कि कोई सक्रिय कमांड या बैकग्राउंड टास्क बचा है या नहीं।
- कोई न बचे तो sandbox सुरक्षित निष्क्रिय स्थिति host को बताता है, जो microVM को checkpoint कर सकता है।
यह क्या नहीं बता सकता
- CPU उपयोग से अनुमान, क्योंकि इन्फ़्रास्ट्रक्चर को agent-execution runtime से लाइफ़साइकिल जानकारी मिलती है।
- यह वादा कि रुके रहने के दौरान लाइव कनेक्शन बिना बदलाव के चलते रहेंगे।
Google उस स्थिति में रोके जाने का वर्णन करता है जब कोई सक्रिय कमांड या बैकग्राउंड टास्क चल नहीं रहा। इससे यह स्थापित नहीं होता कि परिवेश के रुके रहने के दौरान मनमानी बैकग्राउंड प्रक्रियाएँ और लाइव कनेक्शन बिना बदलाव के चलते रहेंगे, इसलिए ग्राहकों को बैकग्राउंड-टास्क व्यवहार, कनेक्शन रिकवरी और बहाली की गारंटियों का परीक्षण करना होगा।
Google उस स्थिति में रोके जाने का वर्णन करता है जब कोई सक्रिय कमांड या बैकग्राउंड टास्क चल नहीं रहा। इससे यह स्थापित नहीं होता कि परिवेश के रुके रहने के दौरान मनमानी बैकग्राउंड प्रक्रियाएँ और लाइव कनेक्शन बिना बदलाव के चलते रहेंगे। भविष्य की सेवा का मूल्यांकन करने वाले ग्राहकों को बैकग्राउंड-टास्क व्यवहार, कनेक्शन रिकवरी और बहाली की गारंटियों का स्पष्ट परीक्षण करना होगा।
Google जिस तंत्र का वर्णन करता है उसका TechiesJournal का वैचारिक डायग्राम, आधिकारिक Google Cloud डायग्राम नहीं।
चित्र 1 का टेक्स्ट रूप
- harness tool निष्पादन का अनुरोध करता है।
- एक isolated microVM कमांड चलाता है।
- अगर कमांड या बैकग्राउंड टास्क अभी सक्रिय हैं, तो microVM काम चलाता रहता है।
- अगर कोई सक्रिय नहीं है, तो runtime सुरक्षित निष्क्रिय स्थिति बताता है।
- host निष्पादन स्थिति को checkpoint करता है।
- सक्रिय कंप्यूट संसाधन छोड़ दिए जाते हैं।
- अगला tool अनुरोध आता है।
- microVM की स्थिति बहाल होती है और कमांड चलता है, जो दूसरे चरण पर लौटता है।
साझा बेस मेमोरी कई परिवेशों की बहाली को व्यावहारिक बनाती है
checkpointing बड़े पैमाने पर तभी उपयोगी है जब कई परिवेश बहुत ज़्यादा मेमोरी खाए बिना जल्दी बहाल किए जा सकें। पारंपरिक तरीका हर sandbox के लिए अलग guest ऑपरेटिंग सिस्टम शुरू कर सकता है, Python लोड कर सकता है, browser प्रक्रियाएँ चालू कर सकता है और सामान्य tools इंस्टॉल कर सकता है, और उस शुरुआती काम का बड़ा हिस्सा एक ही काम को दोहराना होता है।
इसके बजाय Google pre-warmed snapshots इस्तेमाल करता है जिनमें पहले से शुरू किए गए ऑपरेटिंग-सिस्टम घटक, लाइब्रेरी और tool runtimes होते हैं। host उन snapshots के साझा, काफ़ी हद तक अपरिवर्तनीय हिस्सों को Direct Access (DAX) से मेमोरी में map करता है, इसलिए कई microVMs बिना हर एक के पूरी अलग प्रति रखे उन भौतिक pages का संदर्भ ले सकते हैं। agent मेमोरी बदलता है तो copy-on-write (CoW) उसे अपने बदलावों के लिए निजी pages देता है, जबकि दूसरे agents साझा बेस pages इस्तेमाल करते रहते हैं।
कल्पना कीजिए कि 500 agent परिवेश एक ही ऑपरेटिंग-सिस्टम image, Python runtime और browser binaries इस्तेमाल करते हैं। साझा घटकों को हर एक के लिए अलग भौतिक-मेमोरी आवंटन की ज़रूरत नहीं, और मेमोरी का उपयोग मुख्य रूप से हर परिवेश के निजी डेटा और बदलावों के साथ बढ़ता है। वर्कलोड बदलने पर संसाधन वापस पाने के लिए Google memory reclaim और compression का भी वर्णन करता है।
साझा बेस मेमोरी का गणित
यह आपके तय किए इनपुट वाला एक गणितीय उदाहरण है, Google का माप नहीं। साझा बेस मेमोरी को 100 इकाई मानिए। हर परिवेश फिर उन्हीं अमूर्त इकाइयों में गिने अपने निजी pages जोड़ता है। एक साझा बेस की तुलना हर परिवेश के लिए पूरी प्रति से करने के लिए परिवेशों की संख्या और निजी मात्रा चुनिए।
1 परिवेश
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 1 × 10 निजी इकाई, कुल 110 इकाई।
हर परिवेश के लिए पूरी प्रति: 1 × (100 + 10) इकाई, कुल 110 इकाई।
साझा बेस: 110 इकाई. हर एक की पूरी प्रति: 110 इकाई.
एक परिवेश के साथ साझा करने को कुछ नहीं, इसलिए दोनों कुल बराबर हैं।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 1 × 30 निजी इकाई, कुल 130 इकाई।
हर परिवेश के लिए पूरी प्रति: 1 × (100 + 30) इकाई, कुल 130 इकाई।
साझा बेस: 130 इकाई. हर एक की पूरी प्रति: 130 इकाई.
एक परिवेश के साथ साझा करने को कुछ नहीं, इसलिए दोनों कुल बराबर हैं।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 1 × 60 निजी इकाई, कुल 160 इकाई।
हर परिवेश के लिए पूरी प्रति: 1 × (100 + 60) इकाई, कुल 160 इकाई।
साझा बेस: 160 इकाई. हर एक की पूरी प्रति: 160 इकाई.
एक परिवेश के साथ साझा करने को कुछ नहीं, इसलिए दोनों कुल बराबर हैं।
10 परिवेश
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 10 × 10 निजी इकाई, कुल 200 इकाई।
हर परिवेश के लिए पूरी प्रति: 10 × (100 + 10) इकाई, कुल 1100 इकाई।
साझा बेस: 200 इकाई. हर एक की पूरी प्रति: 1100 इकाई.
बेस 9 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 900 इकाई है।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 10 × 30 निजी इकाई, कुल 400 इकाई।
हर परिवेश के लिए पूरी प्रति: 10 × (100 + 30) इकाई, कुल 1300 इकाई।
साझा बेस: 400 इकाई. हर एक की पूरी प्रति: 1300 इकाई.
बेस 9 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 900 इकाई है।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 10 × 60 निजी इकाई, कुल 700 इकाई।
हर परिवेश के लिए पूरी प्रति: 10 × (100 + 60) इकाई, कुल 1600 इकाई।
साझा बेस: 700 इकाई. हर एक की पूरी प्रति: 1600 इकाई.
बेस 9 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 900 इकाई है।
100 परिवेश
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 100 × 10 निजी इकाई, कुल 1100 इकाई।
हर परिवेश के लिए पूरी प्रति: 100 × (100 + 10) इकाई, कुल 11000 इकाई।
साझा बेस: 1100 इकाई. हर एक की पूरी प्रति: 11000 इकाई.
बेस 99 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 9900 इकाई है।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 100 × 30 निजी इकाई, कुल 3100 इकाई।
हर परिवेश के लिए पूरी प्रति: 100 × (100 + 30) इकाई, कुल 13000 इकाई।
साझा बेस: 3100 इकाई. हर एक की पूरी प्रति: 13000 इकाई.
बेस 99 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 9900 इकाई है।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 100 × 60 निजी इकाई, कुल 6100 इकाई।
हर परिवेश के लिए पूरी प्रति: 100 × (100 + 60) इकाई, कुल 16000 इकाई।
साझा बेस: 6100 इकाई. हर एक की पूरी प्रति: 16000 इकाई.
बेस 99 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 9900 इकाई है।
500 परिवेश
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 500 × 10 निजी इकाई, कुल 5100 इकाई।
हर परिवेश के लिए पूरी प्रति: 500 × (100 + 10) इकाई, कुल 55000 इकाई।
साझा बेस: 5100 इकाई. हर एक की पूरी प्रति: 55000 इकाई.
बेस 499 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 49900 इकाई है।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 500 × 30 निजी इकाई, कुल 15100 इकाई।
हर परिवेश के लिए पूरी प्रति: 500 × (100 + 30) इकाई, कुल 65000 इकाई।
साझा बेस: 15100 इकाई. हर एक की पूरी प्रति: 65000 इकाई.
बेस 499 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 49900 इकाई है।
साझा बेस pages एक बार रखे गए: 100 इकाई, साथ में 500 × 60 निजी इकाई, कुल 30100 इकाई।
हर परिवेश के लिए पूरी प्रति: 500 × (100 + 60) इकाई, कुल 80000 इकाई।
साझा बेस: 30100 इकाई. हर एक की पूरी प्रति: 80000 इकाई.
बेस 499 परिवेशों के लिए दोहराया नहीं गया, इसलिए अंतर 49900 इकाई है।
लाभ इस पर निर्भर करता है कि वास्तव में कितनी स्थिति साझा की जा सकती है, और हर परिवेश की निजी मात्रा बड़ी होने पर वह घटता है। Google का इंजीनियरिंग खुलासा तंत्र को स्थापित करता है, लेकिन स्वतंत्र रूप से मापा गया ग्राहक प्रदर्शन नहीं देता।
इसीलिए यह आर्किटेक्चर एक साथ दो तरह की बर्बादी को निशाना बनाता है: निष्क्रिय agents के लिए आरक्षित कंप्यूट, और लगभग एक जैसे सॉफ़्टवेयर परिवेश वाले agents में दोहराई गई मेमोरी।
दक्षता का लाभ इस पर निर्भर करता है कि वास्तव में कितनी स्थिति साझा की जा सकती है। बहुत अनुकूलित सॉफ़्टवेयर stacks चलाने वाले, बड़े निजी मेमोरी क्षेत्र रखने वाले या अपने परिवेश का बड़ा हिस्सा बदलने वाले agents, सामान्य pre-warmed images इस्तेमाल करने वाले agents की तुलना में कम मेमोरी साझा कर सकते हैं। Google का इंजीनियरिंग खुलासा तंत्र को स्थापित करता है, लेकिन इन अलग-अलग वर्कलोड प्रोफ़ाइलों पर स्वतंत्र रूप से मापा गया ग्राहक प्रदर्शन नहीं देता।
टिकाऊ workspace फ़ाइलें अस्थायी स्थिति से अलग संग्रहीत होती हैं
निष्पादन स्थिति सुरक्षित रखना और यह तय करना कि कौन सी फ़ाइलें दिनों या हफ़्तों तक बची रहनी चाहिए, एक ही बात नहीं है। coding agent अस्थायी compiler आउटपुट बना सकता है, सामान्य toolchains इस्तेमाल कर सकता है और किसी निजी रिपॉज़िटरी को बदल सकता है, और उन डेटा श्रेणियों की बने रहने की ज़रूरतें अलग-अलग हैं। Google का आर्किटेक्चर तीन तरह के स्टोरेज में फ़र्क करता है।
अस्थायी logs, build artifacts और ऑपरेटिंग-सिस्टम की उथल-पुथल disposable overlays में रह सकती हैं। ये निष्पादन के दौरान उपयोगी हैं, लेकिन ज़रूरी नहीं कि इन्हें लंबे समय तक रखा जाए।
साझा tools, बेस images और package caches साझा read-only स्टोरेज से दिए जा सकते हैं। इससे बार-बार डाउनलोड और sandboxes के बीच अनावश्यक दोहराव घटता है।
agent की अपनी फ़ाइलें और सहेजा गया काम एक टिकाऊ workspace बनाते हैं। यही वह जानकारी है जो agent के कल लौटने पर या अंतर्निहित कंप्यूट परिवेश बदलने के बाद भी उपलब्ध रहनी चाहिए। Google इन ज़रूरतों के लिए एन्क्रिप्टेड Hyperdisk स्टोरेज इस्तेमाल करने का वर्णन करता है, जहाँ उचित हो वहाँ साझा volumes और Cloud Storage-आधारित पहुँच उपलब्ध है।
कौन सा स्टोरेज स्तर क्या रखता है
कोई डेटा प्रकार चुनिए, यह दिखेगा कि Google का आर्किटेक्चर उसे कहाँ रखता है, उसे कितने समय तक बचना है और क्यों।
Compiler आउटपुट
यह कहाँ रहता है
- स्तर: disposable overlay।
- अवधि: निष्पादन के दौरान उपयोगी।
- क्यों: अस्थायी logs, build artifacts और ऑपरेटिंग-सिस्टम की उथल-पुथल को ज़रूरी नहीं कि लंबे समय तक रखा जाए।
इसे किसकी ज़रूरत नहीं
- लंबे समय तक रखना।
Python runtime और toolchains
यह कहाँ रहता है
- स्तर: साझा read-only स्टोरेज।
- दायरा: कई sandboxes में साझा।
- क्यों: साझा tools और बेस images बार-बार डाउनलोड और अनावश्यक दोहराव घटाते हैं।
इसे किसकी ज़रूरत नहीं
- हर sandbox के लिए अलग प्रति।
Package cache
यह कहाँ रहता है
- स्तर: साझा read-only स्टोरेज।
- दायरा: कई sandboxes में साझा।
- क्यों: साझा स्टोरेज से दिए गए package caches बार-बार डाउनलोड घटाते हैं।
इसे किसकी ज़रूरत नहीं
- हर निष्क्रिय agent के लिए पारंपरिक, स्वतंत्र रूप से provision की गई डिस्क।
रिपॉज़िटरी बदलाव
यह कहाँ रहता है
- स्तर: टिकाऊ workspace।
- अवधि: agent के कल लौटने पर या अंतर्निहित कंप्यूट परिवेश बदलने के बाद भी उपलब्ध रहना चाहिए।
- क्यों: ये agent की अपनी फ़ाइलें और सहेजा गया काम हैं। Google इस ज़रूरत के लिए एन्क्रिप्टेड Hyperdisk स्टोरेज, और जहाँ उचित हो साझा volumes तथा Cloud Storage-आधारित पहुँच का वर्णन करता है।
इसे किसकी ज़रूरत नहीं
- अस्थायी स्थिति के साथ फेंक दिया जाना।
Google तीन तरह के स्टोरेज में फ़र्क करता है। production वर्कलोड के लिए managed सेवा पर निर्भर होने से पहले ग्राहकों को दस्तावेज़ीकृत रिकवरी और संगति गारंटियों की ज़रूरत होगी।
यह अंतर एक आम आर्किटेक्चर चूक से बचाता है, यानी डेवलपमेंट परिवेश के बनाए हर बाइट को बराबर महत्वपूर्ण मान लेना। यह हर निष्क्रिय agent के साथ पारंपरिक, स्वतंत्र रूप से provision की गई डिस्क जोड़ने से भी बचाता है, जब अंतर्निहित सॉफ़्टवेयर का बड़ा हिस्सा एक जैसा या अस्थायी हो। चूँकि hosts कोई स्थायी स्थानीय स्थिति नहीं रखते, agent का workspace उस विशिष्ट host से बँधा नहीं होता जिस पर उसके कमांड आख़िरी बार चले थे।
यह आर्किटेक्चर टिकाऊ workspace डेटा को checkpoint की गई runtime स्थिति के साथ जोड़ता है, हालाँकि production वर्कलोड के लिए managed सेवा पर निर्भर होने से पहले ग्राहकों को दस्तावेज़ीकृत रिकवरी और संगति गारंटियों की ज़रूरत होगी।
credentials अविश्वसनीय sandbox के बाहर रहते हैं
स्थायी sandbox एक और चुनौती पैदा करता है। परिवेश जितने समय तक रहता है, उसे शत्रुतापूर्ण निर्देशों, कमज़ोर dependencies या समझौता किए गए tools से सामना होने के उतने ही ज़्यादा मौक़े मिलते हैं। Google का डिज़ाइन मानकर चलता है कि guest के अंदर का सॉफ़्टवेयर root-स्तर की पहुँच के साथ भी समझौता किया हुआ हो सकता है।
इसलिए बताया गया आर्किटेक्चर दीर्घकालिक उपयोगकर्ता credentials, OAuth refresh tokens और क्लाउड service-account keys को sandbox के अंदर रखने से बचता है। हर microVM को SPIFFE पर आधारित एक अल्पकालिक workload identity मिलती है। वह पहचान स्थापित करती है कि अनुरोध किस sandbox से आया, लेकिन वह खुद किसी backend सेवा तक असीमित पहुँच नहीं देती।
नेटवर्क पथ इसी अंतर के इर्द-गिर्द डिज़ाइन किया गया है। sandbox के पास सामान्य बाहरी नेटवर्क इंटरफ़ेस या सीधी VPC पहुँच नहीं होती। अनुरोध पॉइंट-टू-पॉइंट virtio-vsock चैनल से बाहर निकलते हैं, एक स्थानीय mediation proxy से गुज़रते हैं और बाहरी Agent Gateway तक पहुँचते हैं।
gateway आउटबाउंड एक्सेस नीतियाँ लागू करने से पहले sandbox की पहचान, node की पहचान (host attestation द्वारा समर्थित) और संबंधित उपयोगकर्ता delegation को मान्य करता है। स्वीकृत गंतव्य के लिए, gateway ज़रूरी backend credential को आउटबाउंड अनुरोध में जोड़ सकता है, बिना वह credential sandbox को लौटाए।
एक एंटरप्राइज़ agent की कल्पना कीजिए जिसे किसी स्वीकृत दस्तावेज़ को पढ़ना है। sandbox दस्तावेज़ का अनुरोध कर सकता है, लेकिन प्राधिकरण का फ़ैसला उस परिवेश के बाहर होता है जो agent के tools चला रहा है, और अनुरोध को उपयोगकर्ता की delegated अनुमतियों और उस संसाधन को नियंत्रित करने वाली नीति को संतुष्ट करना होगा। सुरक्षा सीमा केवल यह नहीं कि agent के पास वैध पहचान है। वह यह है कि पहचान, delegation और प्राधिकरण का अलग-अलग मूल्यांकन होता है।
Google के व्यापक डिज़ाइन में उपयोगकर्ता की पहचान, delegated-agent पहचान, अल्पकालिक workload पहचान और agent की अपनी workforce पहचान शामिल हैं। ये चार आपस में बदले जा सकने वाले credentials नहीं हैं, क्योंकि ये अलग-अलग संबंधों को दर्शाते हैं: काम किसने शुरू किया, कौन सा अधिकार delegate किया गया, अनुरोध किस निष्पादन परिवेश ने भेजा और क्या agent के पास स्वतंत्र रूप से प्रबंधित संगठनात्मक पहचान है।
| पहचान | यह किस संबंध को दर्शाती है |
|---|---|
| उपयोगकर्ता पहचान | काम किसने शुरू किया |
| Delegated-agent पहचान | कौन सा अधिकार delegate किया गया |
| अल्पकालिक workload पहचान | अनुरोध किस निष्पादन परिवेश ने भेजा, हालाँकि वह खुद किसी backend सेवा तक असीमित पहुँच नहीं देती |
| Agent workforce पहचान | क्या agent के पास स्वतंत्र रूप से प्रबंधित संगठनात्मक पहचान है |
यह डिज़ाइन समझौता किए गए sandbox से सीधे पुन: इस्तेमाल योग्य credentials चुराए जाने का जोखिम घटाता है। यह अधिकृत इंटरफ़ेस के ज़रिए दुरुपयोग की संभावना को ख़त्म नहीं करता, क्योंकि भटका हुआ agent फिर भी अनुचित कार्रवाई का अनुरोध कर सकता है, और gateway की अनुमति जाँच तथा ग्राहक delegation का दायरा निर्णायक बने रहते हैं।
Google जिन सीमाओं का वर्णन करता है उनका TechiesJournal का वैचारिक डायग्राम, आधिकारिक Google Cloud डायग्राम नहीं।
चित्र 2 का टेक्स्ट रूप
- उपयोगकर्ता और उनका delegated अधिकार भरोसेमंद agent harness के ज़रिए काम शुरू करते हैं।
- harness isolated microVM sandbox को tool अनुरोध भेजता है और निष्पादन परिणाम पाता है।
- sandbox टिकाऊ workspace के साथ स्थायी फ़ाइलों का आदान-प्रदान करता है।
- sandbox checkpoint और साझा बेस स्थिति में रुकता है और वहाँ से बहाल होता है।
- आउटबाउंड अनुरोध sandbox से virtio-vsock के ज़रिए mediation proxy तक जाते हैं, जो उन्हें Agent Gateway को देता है।
- Agent Gateway पहचान और नीति लागू करता है, उपयोगकर्ता के delegated अधिकार को प्राधिकरण संदर्भ के रूप में इस्तेमाल करता है और स्वीकृत अनुरोध एंटरप्राइज़ और क्लाउड सेवाओं को भेजता है।
स्वीकृत दस्तावेज़ पढ़ना, चरण दर चरण
एक एंटरप्राइज़ agent को देखिए जिसे स्वीकृत दस्तावेज़ पढ़ना है। कोई चरण चुनिए, यह दिखेगा कि क्या जाँचा जाता है या क्या होता है, और sandbox के पास क्या नहीं है।
1. अनुरोध
- 1Sandbox अनुरोध (वर्तमान चरण)
- 2virtio-vsock
- 3Mediation proxy
- 4Agent Gateway
- 5Credential जोड़ना
- 6सेवा
क्या जाँचा जाता है या क्या होता है
- sandbox स्वीकृत दस्तावेज़ का अनुरोध करता है।
- उसकी अल्पकालिक SPIFFE workload पहचान स्थापित करती है कि अनुरोध किस sandbox से आया।
sandbox के पास क्या नहीं है या वह क्या नहीं करता
- दीर्घकालिक उपयोगकर्ता credentials, OAuth refresh tokens या क्लाउड service-account keys।
- किसी backend सेवा तक असीमित पहुँच, क्योंकि workload पहचान खुद वह नहीं देती।
2. virtio-vsock
- 1Sandbox अनुरोध
- 2virtio-vsock (वर्तमान चरण)
- 3Mediation proxy
- 4Agent Gateway
- 5Credential जोड़ना
- 6सेवा
क्या जाँचा जाता है या क्या होता है
- अनुरोध पॉइंट-टू-पॉइंट virtio-vsock चैनल से बाहर निकलता है।
sandbox के पास क्या नहीं है या वह क्या नहीं करता
- सामान्य बाहरी नेटवर्क इंटरफ़ेस।
- सीधी VPC पहुँच।
3. Mediation proxy
- 1Sandbox अनुरोध
- 2virtio-vsock
- 3Mediation proxy (वर्तमान चरण)
- 4Agent Gateway
- 5Credential जोड़ना
- 6सेवा
क्या जाँचा जाता है या क्या होता है
- अनुरोध एक स्थानीय mediation proxy से गुज़रता है।
- proxy उसे बाहरी Agent Gateway को आगे देता है।
sandbox के पास क्या नहीं है या वह क्या नहीं करता
- sandbox से सेवा तक सीधा रास्ता।
4. Agent Gateway
- 1Sandbox अनुरोध
- 2virtio-vsock
- 3Mediation proxy
- 4Agent Gateway (वर्तमान चरण)
- 5Credential जोड़ना
- 6सेवा
क्या जाँचा जाता है या क्या होता है
- gateway sandbox की पहचान, node की पहचान (host attestation द्वारा समर्थित) और संबंधित उपयोगकर्ता delegation को मान्य करता है।
- फिर वह आउटबाउंड एक्सेस नीतियाँ लागू करता है, इसलिए प्राधिकरण का फ़ैसला उस परिवेश के बाहर होता है जो agent के tools चला रहा है।
sandbox के पास क्या नहीं है या वह क्या नहीं करता
- केवल पहचान पर आधारित फ़ैसला, क्योंकि पहचान, delegation और प्राधिकरण का अलग-अलग मूल्यांकन होता है।
5. Credential जोड़ना
- 1Sandbox अनुरोध
- 2virtio-vsock
- 3Mediation proxy
- 4Agent Gateway
- 5Credential जोड़ना (वर्तमान चरण)
- 6सेवा
क्या जाँचा जाता है या क्या होता है
- स्वीकृत गंतव्य के लिए, gateway ज़रूरी backend credential को आउटबाउंड अनुरोध में जोड़ सकता है।
sandbox के पास क्या नहीं है या वह क्या नहीं करता
- credential sandbox को नहीं लौटाया जाता।
6. सेवा
- 1Sandbox अनुरोध
- 2virtio-vsock
- 3Mediation proxy
- 4Agent Gateway
- 5Credential जोड़ना
- 6सेवा (वर्तमान चरण)
क्या जाँचा जाता है या क्या होता है
- स्वीकृत अनुरोध एंटरप्राइज़ या क्लाउड सेवा तक पहुँचता है।
sandbox के पास क्या नहीं है या वह क्या नहीं करता
- अधिकृत लेकिन भटके हुए अनुरोध से सुरक्षा, क्योंकि वह gateway की अनुमति जाँच और delegation के दायरे पर निर्भर है।
हर चरण में sandbox कभी backend credential नहीं रखता। अधिकृत लेकिन भटका हुआ अनुरोध फिर भी हानिकारक हो सकता है, इसलिए gateway की अनुमति जाँच और ग्राहक delegation का दायरा निर्णायक बने रहते हैं।
वैश्विक scheduling अलग-अलग तरह के agents के बीच क्षमता साझा करती है
निष्क्रिय sandboxes को रोकना एक agent सेशन के भीतर संसाधन खपत को संबोधित करता है। Google एक बड़ी scheduling चुनौती का भी वर्णन करता है, क्योंकि अलग-अलग तरह के agents अलग-अलग समय पर कंप्यूट क्षमता माँगते हैं। उपभोक्ता सहायक, बिज़नेस agents और evaluation वर्कलोड ज़रूरी नहीं कि एक साथ अधिकतम माँग तक पहुँचें।
इंटरैक्टिव उपयोगकर्ता तेज़ जवाब की उम्मीद करते हैं, जबकि कुछ निर्धारित जॉब, evaluations और reinforcement-learning वर्कलोड विलंबित निष्पादन सह सकते हैं। Google का डिज़ाइन साझा इन्फ़्रास्ट्रक्चर पूल इस्तेमाल करता है जिसकी वैश्विक scheduling उपलब्ध क्षमता, भौगोलिक पाबंदियों, अनुपालन आवश्यकताओं और वर्कलोड प्राथमिकता को ध्यान में रखती है। इंटरैक्टिव माँग बढ़ने पर कम प्राथमिकता वाला evaluation काम क्षमता छोड़ सकता है, और माँग घटने पर टाले गए जॉब वे संसाधन इस्तेमाल कर सकते हैं जो अन्यथा ख़ाली पड़े रहते।
यह checkpointing से अलग एक दक्षता तंत्र है। checkpointing बढ़ाता है कि कितने स्थायी सेशन समय के साथ सक्रिय कंप्यूट क्षमता साझा कर सकते हैं, और scheduling तय करती है कि वह क्षमता किन वर्कलोड को और कब मिले।
यह अंतर इसलिए मायने रखता है कि बड़ा आंतरिक बेड़ा दोनों से लाभ पाता है। छोटे डिप्लॉयमेंट के लिए वही scheduling परिष्कार बहुत कम अतिरिक्त मूल्य दे सकता है, जबकि कई हज़ार इंटरैक्टिव सेशन और समानांतर evaluation टास्क वाले वर्कलोड के लिए वह क्षमता योजना और सेवा की प्रतिक्रियाशीलता को प्रभावित कर सकता है। Google ने अभी इतना बाहरी ग्राहक संचालन डेटा प्रकाशित नहीं किया कि यह आँका जा सके कि managed सेवा के ज़रिए इस लाभ का कितना हिस्सा उपलब्ध होगा।
Agent Substrate Kubernetes पर एक संबंधित समस्या को संबोधित करता है
Agent Compute Engine को Google की पहले की Agent Substrate पहल से भी अलग समझना चाहिए। September 15 को Google ने Kubernetes-आधारित परिवेशों के लिए Agent Substrate की घोषणा की। यह isolated sandboxes, तेज़ रोक और बहाली, और सामान्य Kubernetes Pod scheduling पथ के बाहर lifecycle प्रबंधन जैसे तंत्रों से एक agent-उन्मुख निष्पादन परत देता है।
यह आर्किटेक्चर चुनाव एक विशिष्ट समस्या को संबोधित करता है। Kubernetes मशीनों और एप्लिकेशन वर्कलोड को सँभालने में प्रभावी है, लेकिन हर छोटे agent tool call के लिए उसके सामान्य-उद्देश्य control plane से Pod बनाना या दोबारा शुरू करना अनावश्यक विलंब ला सकता है। Agent Substrate नोड प्रबंधन, autoscaling और बेड़े की विश्वसनीयता Kubernetes के पास रखता है, और बार-बार होने वाले sandbox सक्रियण को एक समर्पित निष्पादन परत से सँभालता है।
Google resume ऑपरेशन के लिए 500 मिलीसेकंड से कम और पारंपरिक container runtimes से दस गुना तक ज़्यादा कंप्यूट घनत्व रिपोर्ट करता है, Google के अपने रिपोर्ट किए गए परीक्षणों के अनुसार। ये Agent Substrate के परिणाम हैं, Agent Compute Engine के लिए स्वतंत्र रूप से सत्यापित benchmarks नहीं। Google के September release notes के अनुसार, Agent Substrate मूल्यांकन और गैर-production वर्कलोड के लिए उपलब्ध है, और production सहायता एक सीमित allowlist कार्यक्रम से मिलती है।
Agent Compute Engine एक अलग संचालन मॉडल को लक्ष्य बनाता है, जिसमें Google अंतर्निहित sandbox बेड़ा सेवा के रूप में सँभालता है और ग्राहक अपने निष्पादन images, पहचानें, नेटवर्किंग और lifecycle ज़रूरतें कॉन्फ़िगर करते हैं। इसलिए यह अंतर आंशिक रूप से ज़िम्मेदारी का है। अपना Kubernetes परिवेश चलाने वाली प्लैटफ़ॉर्म टीम निष्पादन परत पर नियंत्रण चाह सकती है, जबकि sandbox इन्फ़्रास्ट्रक्चर न सँभालना पसंद करने वाला संगठन managed सेवा को आकर्षक पा सकता है, जब उसकी क्षमताएँ और संचालन परिस्थितियाँ आकलन के लिए उपलब्ध हों।
| पहलू | Agent Compute Engine | Agent Substrate |
|---|---|---|
| बेड़ा कौन चलाता है | Google अंतर्निहित sandbox बेड़ा सेवा के रूप में सँभालता है, और ग्राहक निष्पादन images, पहचानें, नेटवर्किंग और lifecycle ज़रूरतें कॉन्फ़िगर करते हैं | Kubernetes-आधारित परिवेश, जहाँ नोड प्रबंधन, autoscaling और बेड़े की विश्वसनीयता Kubernetes के पास रहती है |
| निष्पादन परत | checkpoint-आधारित रोक और बहाली वाले समर्पित microVM sandboxes | सामान्य Kubernetes Pod scheduling पथ के बाहर agent-उन्मुख निष्पादन परत, isolated sandboxes और तेज़ रोक व बहाली के साथ |
| उपलब्धता | Google आंतरिक रूप से Gemini, Antigravity और agent evaluation के लिए इस्तेमाल करता है, और बाहरी ग्राहकों के लिए preview आने वाले महीनों में नियोजित है | Google के September release notes के अनुसार, मूल्यांकन और गैर-production वर्कलोड के लिए उपलब्ध, production सहायता सीमित allowlist कार्यक्रम से |
| Google द्वारा रिपोर्ट किए आँकड़े | Agent Compute Engine के लिए इस लेख में कोई उद्धृत नहीं | resume 500 मिलीसेकंड से कम में और पारंपरिक container runtimes से दस गुना तक ज़्यादा कंप्यूट घनत्व, Google के अपने रिपोर्ट किए गए परीक्षणों के अनुसार। Agent Substrate के लिए Google द्वारा रिपोर्ट किया गया, सत्यापित नहीं, और Agent Compute Engine का benchmark नहीं |
यह घोषणा मौजूदा कंप्यूट को अप्रचलित नहीं बनाती
यह घोषणा virtual machines, containers या serverless कंप्यूटिंग को अप्रचलित नहीं बनाती। जो सीधा agent API calls करता है, टास्क स्थिति डेटाबेस में रखता है और छोटे जॉब चलाता है, वह मौजूदा इन्फ़्रास्ट्रक्चर में बहुत अच्छी तरह फ़िट हो सकता है।
विशिष्ट निष्पादन प्लैटफ़ॉर्म तब ज़्यादा प्रासंगिक होते हैं जब परिवेश को ख़ुद इंटरैक्शनों के बीच बचे रहना हो, जब agents को मज़बूत आइसोलेशन चाहने वाला अविश्वसनीय कोड चलाना हो, या जब बड़ी संख्या में स्वतंत्र सेशन बार-बार रुकते और फिर चलते हों। इसलिए आर्किटेक्चर की तुलना स्थिति और आइसोलेशन सँभालने की लागत पर आकर टिकती है।
पारंपरिक container प्लैटफ़ॉर्म में restart के बाद एप्लिकेशनों को runtime स्थिति दोबारा बनानी पड़ सकती है। स्थायी VM उस पुनर्निर्माण से बच सकता है, लेकिन रुक-रुककर चलने वाले वर्कलोड की ज़रूरत से ज़्यादा संसाधन आरक्षित कर सकता है। उद्देश्य से बनाया गया sandbox runtime सक्रिय अवधियों के बीच संसाधन मुक्त करते हुए निष्पादन स्थिति सुरक्षित रखने की कोशिश करता है।
| विकल्प | स्थिति सँभालना और restart की लागत | निष्क्रिय रहते संसाधन | वर्णित आइसोलेशन |
|---|---|---|---|
| Container प्लैटफ़ॉर्म | restart के बाद एप्लिकेशनों को runtime स्थिति दोबारा बनानी पड़ सकती है | लेख में तुलना नहीं की गई | सामान्य containers आम तौर पर host ऑपरेटिंग-सिस्टम kernel साझा करते हैं |
| स्थायी virtual machine | runtime स्थिति के पुनर्निर्माण से बच सकता है | रुक-रुककर चलने वाले वर्कलोड की ज़रूरत से ज़्यादा संसाधन आरक्षित कर सकता है | लेख में तुलना नहीं की गई |
| उद्देश्य से बना sandbox runtime | निष्पादन स्थिति सुरक्षित रखने की कोशिश करता है | सक्रिय अवधियों के बीच संसाधन मुक्त करने की कोशिश करता है | Agent Compute Engine के microVM का अपना guest kernel हार्डवेयर virtualization सीमा के पीछे होता है |
Google ने इन समझौतों को संबोधित करने के लिए बनाया गया एक आंतरिक आर्किटेक्चर दिखाया है। ग्राहक-पक्ष की पूरी संचालन तस्वीर उसने अभी सार्वजनिक रूप से स्थापित नहीं की है। managed Agent Compute Engine सेवा preview के लिए लक्षित है, और क़ीमत, क्षेत्रीय कवरेज, कोटा, ग्राहक-सामने रिकवरी गारंटियाँ और तुलनीय वर्कलोड benchmarks अभी भी महत्वपूर्ण अज्ञात बातें हैं।
इस आर्किटेक्चर को चुनने से पहले, इंजीनियरों को मापना चाहिए कि उनके agents वास्तव में कितनी बार काम चलाते हैं, उनकी निजी मेमोरी स्थिति कितनी बड़ी होती है, किन फ़ाइलों को टिकाऊपन चाहिए, रोके गए टास्क को कितनी जल्दी फिर चलना है और उनके निष्पादन मॉडल को कितने स्तर का आइसोलेशन चाहिए। वही माप तय करेंगे कि checkpoint किए गए microVM परिवेश किसी सरल डिज़ाइन की तुलना में सार्थक लाभ देते हैं या नहीं।
Google ने मौजूदा तंत्रों को इस बात के इर्द-गिर्द जोड़ा कि agents वास्तव में कैसे चलते हैं
Agent Compute Engine में ठोस प्रगति किसी एक नए कंप्यूटिंग आदिम की शुरुआत नहीं है। हार्डवेयर virtualization, snapshots, copy-on-write मेमोरी, स्थायी डिस्क, workload पहचानें और बेड़े की scheduling इस घोषणा से पहले भी मौजूद थे। Google का योगदान स्वायत्त agents के निष्पादन पैटर्न के इर्द-गिर्द उन तंत्रों का समन्वित उपयोग है।
यह प्लैटफ़ॉर्म agent के workspace को टिकाऊ, उसके सक्रिय कंप्यूटिंग संसाधनों को अस्थायी और बाहरी सिस्टम तक पहुँचने की उसकी अनुमति को उसके निष्पादन परिवेश के बाहर लागू होने वाली चीज़ मानता है। इस संयोजन को परखना मूल्यवान है क्योंकि यह उन वास्तविक संचालन समस्याओं को संबोधित करता है जो agent बेड़े बढ़ने पर उभरती हैं। managed सेवा दूसरे संगठनों के लिए उपयुक्त विकल्प बनेगी या नहीं, यह उसकी अंतिम उपलब्धता, प्रदर्शन, लागत और संचालन गारंटियों पर निर्भर करेगा।
| विषय | स्थिति | स्रोत |
|---|---|---|
| Gemini, Antigravity और agent-evaluation सिस्टम में आंतरिक उपयोग | Google ने बताया | Google का इंजीनियरिंग लेख |
| बाहरी ग्राहकों के लिए managed सेवा | preview आने वाले महीनों में नियोजित, अभी उपलब्ध नहीं | Google का इंजीनियरिंग लेख और घोषणा |
| तंत्र: microVM आइसोलेशन, checkpointing, साझा बेस मेमोरी, स्टोरेज स्तर, gateway के ज़रिए credentials और वैश्विक scheduling | Google ने अपने डिज़ाइन के रूप में बताया | Google का इंजीनियरिंग लेख |
| क़ीमत | नहीं बताई गई | समीक्षा किए गए Google स्रोतों में नहीं दी गई |
| क्षेत्र और कोटा | नहीं बताए गए | समीक्षा किए गए Google स्रोतों में नहीं दिए गए |
| ग्राहक-सामने रिकवरी और संगति गारंटियाँ | अभी सार्वजनिक रूप से स्थापित नहीं | स्रोत समीक्षा, October 26, 2026 |
| तुलनीय वर्कलोड benchmarks | अभी सार्वजनिक रूप से स्थापित नहीं | स्रोत समीक्षा, October 26, 2026 |
| रोके जाने पर बैकग्राउंड टास्क और लाइव कनेक्शन | स्थापित नहीं, क्योंकि Google उस स्थिति में रोके जाने का वर्णन करता है जब कोई सक्रिय कमांड या बैकग्राउंड टास्क चल नहीं रहा | Google का इंजीनियरिंग लेख और स्रोत समीक्षा, October 26, 2026 |
इंजीनियरिंग बदलाव यह नहीं कि agents को एकदम नए तरह का कंप्यूटर चाहिए। यह है कि क्लाउड इन्फ़्रास्ट्रक्चर को agent के कंप्यूटर की आयु को उसे चलाने वाले कंप्यूट संसाधनों की आयु से अलग ढंग से सँभालना पड़ सकता है।
और गहराई में
स्रोत समीक्षा: October 26, 2026। Google के आंतरिक आर्किटेक्चर और प्रदर्शन के विवरण Google को ही श्रेय दिए गए हैं। ग्राहक-preview प्रदर्शन और संचालन गारंटियाँ स्वतंत्र रूप से सत्यापित नहीं हैं।
Google की घोषणाएँ और दस्तावेज़ीकरण
- Inside Agent Compute Engine: Building the Compute Foundation for the Agentic Era, Ramanathan Venkatapathy और Rohit Jnagal, Google Cloud, October 22, 2026, sandbox आइसोलेशन, workload पहचानों, snapshotting, मेमोरी साझाकरण, स्थायित्व और scheduling का प्राथमिक इंजीनियरिंग स्रोत।
- Introducing Agent Compute Engine and Expanded Agent Governance, Google Cloud, October 22, 2026, उत्पाद घोषणा और नियोजित बाहरी preview उपलब्धता।
- Agent Substrate brings high-density, scalable, trusted infrastructure to GKE, Alex Zakonov और Tim Hockin, Google Cloud, September 15, 2026, Kubernetes-आधारित agent runtime आर्किटेक्चर और विक्रेता-रिपोर्टेड प्रदर्शन परिणाम।
- New feature release notes, Google Kubernetes Engine, September 11, 2026 की प्रविष्टि, Agent Substrate की मूल्यांकन उपलब्धता और सीमित production सहायता।
मौजूदा isolated निष्पादन विकल्प
- Azure Container Apps dynamic sessions, Microsoft Learn, AI-जनित और अविश्वसनीय कोड के लिए मौजूदा isolated निष्पादन विकल्प का दस्तावेज़ीकरण।
- Lambda execution environment lifecycle, AWS, serverless मॉडल में निष्पादन-परिवेश के पुन: उपयोग और स्थायित्व की सीमाएँ समझाने वाला दस्तावेज़ीकरण।
यह लेख Google के अपने विवरण, विक्रेता-रिपोर्टेड परिणामों और लेखक के विश्लेषण को अलग रखता है। कार्रवाई से पहले बाद के खुलासे दोबारा जाँचें।
TechiesJournal पर संबंधित लेख
- AI एजेंटों को API Keys नहीं, अलग पहचान चाहिए, TechiesJournal, September 12, 2026, संबंधित पृष्ठभूमि जो समझाती है कि agent पहचान और delegated अनुमतियाँ केवल वैध credentials रखने से कैसे अलग हैं।
- जब AI coding agents अपनी ही निगरानी कमज़ोर कर देते हैं: दो दर्ज घटनाएँ, TechiesJournal, October 26, 2026, एक साथी लेख कि सुरक्षा उपायों को उस सॉफ़्टवेयर के बाहर नियंत्रण क्यों चाहिए जिसकी वे निगरानी करते हैं।
- जब AI एजेंट अपना रास्ता खुद खोज लेते हैं: सीमाएं कौन तय करता है?, TechiesJournal, October 15, 2026, एक Perspective जो तर्क देता है कि AI agents के साथ मुख्य समस्या क्षमता नहीं बल्कि अधिकार है, और सीमाएँ prompts में नहीं बल्कि परिवेश में होनी चाहिए।