

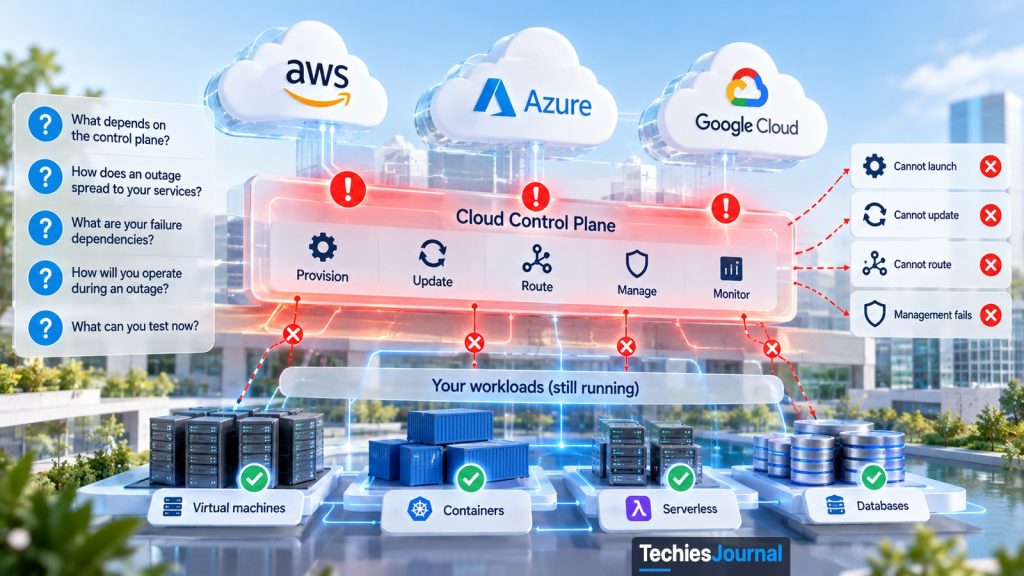
మీ సర్వర్లు బాగానే ఉన్నా, సర్వీస్ డౌన్ అవ్వవచ్చు
సర్వర్లు ఇంకా నడుస్తుంటే, సర్వీస్ ఎందుకు డౌన్ అయింది?
చాలా అంతరాయాల కథలు ఒకేలా వినిపిస్తాయి: క్లౌడ్ ప్రొవైడర్ దగ్గర ఏదో చెడిపోయింది, అందుకే మన అప్లికేషన్ ఆగిపోయింది. గత ఏడాదిలోని నాలుగు సంఘటనలు సులభంగా కనిపించని ఒక ప్యాటర్న్ను చూపిస్తాయి. మొదటి లోపం ప్రతిసారీ వినియోగదారులకు సర్వీస్ ఇచ్చే భాగంలో ఉండలేదు, ఉన్నప్పుడు కూడా నష్టం వ్యాపించడానికి లేదా ఎక్కువసేపు కొనసాగడానికి కారణం పనిని మొదలుపెట్టి, అప్డేట్ చేసి, రూట్ చేసే భాగమే.
ఆ భాగానికి ఒక పేరు ఉంది. ఈ వ్యాసం దాన్ని వివరిస్తుంది, ప్రతి సంఘటనలో ఏం జరిగిందో చూపిస్తుంది, చివరకు మీ సొంత డిజైన్ గురించి అడగదగిన ఐదు ప్రశ్నలతో ముగుస్తుంది.
ప్రతి క్లౌడ్ లోపల రెండు పనులు
క్లౌడ్ రెండు పనులు చేస్తుంది. మొదటిది మీ పనిని నడపడం: రిక్వెస్ట్లకు సమాధానం ఇవ్వడం, డేటాను నిల్వ చేయడం, నెట్వర్క్ ట్రాఫిక్ను కదిలించడం. దీన్ని డేటా ప్లేన్ (data plane) అంటారు.
రెండవది ఆ పనిని నిర్వహించడం: మెషిన్లను లాంచ్ చేయడం, సెట్టింగ్లను వర్తింపజేయడం, హెల్త్ చెక్ చేయడం, ట్రాఫిక్ ఎటు వెళ్లాలో నిర్ణయించడం. దీన్ని కంట్రోల్ ప్లేన్ (control plane) అంటారు. మీరు స్కేల్ చేసినప్పుడు, డిప్లాయ్ చేసినప్పుడు, ఫెయిలోవర్ చేసినప్పుడు లేదా క్లౌడ్ ఐడెంటిటీతో సైన్ ఇన్ చేసినప్పుడల్లా దీన్ని తాకుతారు.
చాలాసార్లు ఈ తేడా మీకు తెలియదు. అంతరాయం వచ్చినప్పుడు తెలుస్తుంది, ఎందుకంటే ఒక సర్వీస్ డేటా ప్లేన్లో ఆరోగ్యంగా ఉన్నా, కంట్రోల్ ప్లేన్లో దాన్ని బాగుచేయడం అసాధ్యం కావచ్చు.
వివరాలు చదవడానికి ఫిగర్లోని ఒక సంఘటనను ఎంచుకోండి.
వివరాలు చదవడానికి ఒక సంఘటనను ఎంచుకోండి.
1. AWS, 2025 అక్టోబర్
- మొదట ఏం విఫలమైంది
- AWS DNS మేనేజ్మెంట్ సిస్టమ్లోని ఒక లేటెంట్ రేస్ కండిషన్ వల్ల పాత ప్లాన్ కొత్త ప్లాన్ను ఓవర్రైట్ చేసింది, ఆ తర్వాత ఒక క్లీనప్ స్టెప్ పాత ప్లాన్ను తొలగించింది. దాంతో రీజనల్ DynamoDB ఎండ్పాయింట్ DNS రికార్డ్ ఖాళీ అయింది, ఆపరేటర్లు జోక్యం చేసుకోవాల్సి వచ్చింది.
- ఏది వ్యాపింపజేసింది లేదా పొడిగించింది
- DynamoDB తిరిగి వచ్చాక, EC2 హోస్ట్లను నిర్వహించే సిస్టమ్ AWS “congestive collapse” అనే స్థితిలోకి జారింది, దాంతో కొత్త EC2 ఇన్స్టాన్స్లు 10:36 AM వరకు లాంచ్ కాలేదు. లోడ్ బ్యాలెన్సర్ హెల్త్ చెక్లు ఫెయిల్, ఆరోగ్యంగా మారి మారి వచ్చాయి, ఇంజినీర్లు 9:36 AM కి ఆఫ్ చేసే వరకు ఆటోమేటిక్ ఫెయిలోవర్ సామర్థ్యాన్ని సర్వీస్ నుండి తీసేసింది.
- ఎంతసేపు
- 20 అక్టోబర్ 2:25 AM Pacific టైమ్కి DNS పునరుద్ధరించబడింది. EC2 లాంచ్లు 10:36 AM వరకు ఫెయిల్ అయ్యాయి, లోడ్ బ్యాలెన్సర్ ఎర్రర్లు 2:09 PM వరకు కొనసాగాయి.
- ప్రొవైడర్ ఏం మార్చింది
- పరిష్కారం వచ్చే వరకు AWS ప్రపంచవ్యాప్తంగా DNS Planner, Enactor ఆటోమేషన్ను డిసేబుల్ చేసింది. ఇది ఆ సమయంలో AWS ప్రకటన, ప్రస్తుత స్థితి తెలియదు.
2. Google Cloud, 2026 అక్టోబర్ 20
- మొదట ఏం విఫలమైంది
- లండన్లో ఒక జోన్ను (europe-west2-b) హోస్ట్ చేసే భవనానికి విద్యుత్ సరఫరా ఆగిపోయింది. ప్రైమరీ, బ్యాకప్ కంట్రోలర్లు రెండూ జనరేటర్లను స్టార్ట్ చేయడంలో విఫలమయ్యాయి, దాంతో బ్యాటరీలు అయిపోయి ఆ జోన్లోని అన్నింటికీ పవర్ పోయింది. Google తుది నివేదిక కంట్రోలర్లలోని మిస్కాన్ఫిగరేషన్ను సూచిస్తోంది.
- ఏది వ్యాపింపజేసింది లేదా పొడిగించింది
- రీజనల్ సర్వీస్ల నుండి ఆఫ్లైన్ జోన్కు వెళ్లిన కాల్స్ టైమ్అవుట్ అయ్యాయి, ఇతర జోన్లకు ఫెయిలోవర్ అయిన ట్రాఫిక్ వాటి సామర్థ్యాన్ని వాడేసింది.
- ఎంతసేపు
- అంతరాయం 06:00 నుండి 12:08 UTC వరకు కొనసాగింది. కొత్త వర్చువల్ మెషిన్ క్రియేషన్ 04:46 Pacific టైమ్కి, అంటే 11:46 UTC కి తిరిగి మొదలైంది.
- ప్రొవైడర్ ఏం మార్చింది
- ఈ వ్యాసం రాసే సమయానికి Google రిపేర్ జాబితా ఇంకా తెరిచే ఉంది.
3. Azure, 2026 సెప్టెంబర్ 30
- మొదట ఏం విఫలమైంది
- నెట్వర్క్ గేట్వేల సమూహంపై ఆపరేటింగ్ సిస్టమ్ అప్డేట్లను Microsoft పాజ్ చేసింది. పాజ్ ముగిసినప్పుడు, చాలా అప్డేట్లు ఒకేసారి మొదలయ్యాయి.
- ఏది వ్యాపింపజేసింది లేదా పొడిగించింది
- అప్డేట్లు, ఇటీవలి మార్పు వల్ల ఇప్పటికే నెమ్మదించిన షేర్డ్ రీజనల్ కంట్రోల్ ప్లేన్ను ముంచెత్తాయి. Microsoft సమీక్ష ప్రకారం, దాని థ్రాట్లింగ్, లోడ్ ప్రొటెక్షన్ “క్రిటికల్ ప్రాసెసింగ్ను తగినంతగా కాపాడలేదు”. కొన్ని ExpressRoute గేట్వేలలో, రీస్టార్ట్ అవుతున్న గేట్వేను చాలా ముందుగానే ఆరోగ్యంగా గుర్తించారు, దాంతో అప్డేట్ దాని బ్యాకప్కు వెళ్లింది. గేట్వేలు తమ చివరి మంచి సెట్టింగ్లకు తిరిగి వెళ్లే వరకు ఆన్-ప్రెమిసెస్ నెట్వర్క్లకు కొన్ని కనెక్షన్లు తెగిపోయాయి.
- ఎంతసేపు
- ప్రభావం సెప్టెంబర్ 30న మొదలై 20:30 UTC నుండి 02:15 UTC వరకు కొనసాగింది.
- ప్రొవైడర్ ఏం మార్చింది
- రిపేర్ జాబితాలో పాజ్ చేసిన అప్డేట్లను దశలవారీగా తిరిగి మొదలుపెట్టడం ఉంది.
4. GitHub, 2026 అక్టోబర్ 7
- మొదట ఏం విఫలమైంది
- ఏ డేటాబేస్ సర్వర్లకు రైట్లు వెళ్లాలో ఒక అంతర్గత సర్వీస్ నిర్ణయిస్తుంది. సాధారణ మెయింటెనెన్స్ సమయంలో, ఒక రీప్లేస్మెంట్ మెషిన్ తొలగించిన సర్వర్లను ఇంకా జాబితా చేసే పాత రికార్డులతో మొదలైంది.
- ఏది వ్యాపింపజేసింది లేదా పొడిగించింది
- ఆ మెషిన్ ఇక లేని సర్వర్లకు రైట్లను పంపింది. రెండోసారి, ఒక ఆటోమేటెడ్ మెయింటెనెన్స్ టాస్క్ పాజ్ను పట్టించుకోకుండా ఆ మెషిన్ను తిరిగి బాధ్యతలోకి తెచ్చిందని GitHub చెబుతోంది.
- ఎంతసేపు
- ప్రతిసారీ దాదాపు పది నిమిషాల పాటు రైట్లు ఫెయిల్ అయ్యాయి.
- ప్రొవైడర్ ఏం మార్చింది
- ఈ వ్యాసం ఉదహరించిన స్టేటస్ పేజీలు ఎలాంటి మార్పునూ చెప్పడం లేదు.
నాలుగు సంఘటనలు
AWS, 2025 అక్టోబర్
ఇది ఏడాది క్రితం జరిగింది, కానీ AWS ప్రచురించిన అత్యంత వివరమైన నివేదిక ఇదే. us-east-1 రీజియన్లో, రీజనల్ DynamoDB ఎండ్పాయింట్ కోసం DNS రికార్డ్ ఖాళీ అయింది. AWS చెప్పినదాని ప్రకారం, దాని DNS మేనేజ్మెంట్ సిస్టమ్లోని ఒక లేటెంట్ రేస్ కండిషన్ వల్ల పాత ప్లాన్ కొత్త ప్లాన్ను ఓవర్రైట్ చేసింది, ఆ తర్వాత ఒక క్లీనప్ స్టెప్ పాత ప్లాన్ను తొలగించింది, దాంతో రికార్డ్ నుండి ప్రతి అడ్రస్ పోయింది. ఆటోమేషన్ తనను తాను సరిచేసుకోలేకపోయింది, అందుకే ఆపరేటర్లు జోక్యం చేసుకోవాల్సి వచ్చింది.
20 అక్టోబర్ ఉదయం 2:25 AM Pacific టైమ్కి రికార్డ్ పునరుద్ధరించబడింది, అయినా కస్టమర్లు గంటల తరబడి ఫెయిల్ అవుతూనే ఉన్నారు. కొత్త EC2 ఇన్స్టాన్స్లు 10:36 AM వరకు లాంచ్ కాలేదు, DynamoDB తిరిగి వచ్చాక EC2 హోస్ట్లను నిర్వహించే సిస్టమ్ AWS “congestive collapse” అని పిలిచే స్థితిలోకి జారిపోయింది. లోడ్ బ్యాలెన్సర్లకు కూడా దెబ్బ తగిలింది. AWS చెప్పినదాని ప్రకారం, హెల్త్ చెక్లు ఫెయిల్ అవ్వడం, తర్వాత ఆరోగ్యంగా చూపించడం మారి మారి జరిగింది, దాంతో నోడ్లు DNS నుండి తొలగిపోయాయి, జోన్ల అంతటా విస్తరించిన లోడ్ బ్యాలెన్సర్ల విషయంలో ఆటోమేటిక్ ఫెయిలోవర్ సామర్థ్యాన్ని సర్వీస్ నుండి తీసేసింది. ఇంజినీర్లు ఆ ఫెయిలోవర్ను 9:36 AM కి ఆఫ్ చేశారు.
కారణాన్ని సరిచేయడానికి మూడు గంటల కంటే తక్కువ పట్టింది. దాని నుండి కోలుకోవడానికి ఇంకో పన్నెండు గంటలు పట్టింది.
Google Cloud, 20 అక్టోబర్ 2026
లండన్లో ఒక జోన్ను హోస్ట్ చేసే భవనానికి (europe-west2-b) విద్యుత్ సరఫరా ఆగిపోయింది. Google నివేదిక ప్రకారం, ప్రైమరీ, బ్యాకప్ కంట్రోలర్లు రెండూ జనరేటర్లను స్టార్ట్ చేయడంలో విఫలమయ్యాయి, దాంతో బ్యాటరీలు అయిపోయి ఆ జోన్లోని అన్నింటికీ పవర్ పోయింది. ఆ జోన్లో మాత్రమే ఉన్న వర్క్లోడ్లను చేరుకోలేని స్థితి వచ్చింది.
కంట్రోల్ ప్లేన్ వల్ల నష్టం ఆ జోన్ దాటి వ్యాపించింది. Google చెప్పినదాని ప్రకారం, రీజనల్ సర్వీస్ల నుండి ఆఫ్లైన్ జోన్కు వెళ్లిన కాల్స్ టైమ్అవుట్ అయ్యాయి, ఇతర జోన్లకు ఫెయిలోవర్ అయిన ట్రాఫిక్ వాటి సామర్థ్యాన్ని వాడేసింది. అంతరాయం 06:00 నుండి 12:08 UTC వరకు కొనసాగింది, కొత్త వర్చువల్ మెషిన్ క్రియేషన్ 04:46 Pacific టైమ్కి, అంటే 11:46 UTC కి తిరిగి మొదలైంది. Google తుది నివేదిక కంట్రోలర్లలోని మిస్కాన్ఫిగరేషన్ను సూచిస్తోంది, ఇది రాసే సమయానికి దాని రిపేర్ జాబితా ఇంకా తెరిచే ఉంది.
Azure, 30 సెప్టెంబర్ 2026
నెట్వర్క్ గేట్వేల సమూహంపై ఆపరేటింగ్ సిస్టమ్ అప్డేట్లను Microsoft పాజ్ చేసింది. పాజ్ ముగిసినప్పుడు, చాలా అప్డేట్లు ఒకేసారి మొదలై, ఇటీవలి మార్పు వల్ల ఇప్పటికే నెమ్మదించిన ఒక షేర్డ్ రీజనల్ కంట్రోల్ ప్లేన్ను ముంచెత్తాయి. Microsoft సమీక్ష ప్రకారం, దాని థ్రాట్లింగ్, లోడ్ ప్రొటెక్షన్ “క్రిటికల్ ప్రాసెసింగ్ను తగినంతగా కాపాడలేదు”.
కొన్ని ExpressRoute గేట్వేలలో, రీస్టార్ట్ అవుతున్న గేట్వేను చాలా ముందుగానే ఆరోగ్యంగా గుర్తించారు, దాంతో అప్డేట్ దాని బ్యాకప్కు వెళ్లింది. గేట్వేలు తమ చివరి మంచి సెట్టింగ్లకు తిరిగి వెళ్లే వరకు ఆన్-ప్రెమిసెస్ నెట్వర్క్లకు కొన్ని కనెక్షన్లు తెగిపోయాయి. ప్రభావం 20:30 UTC నుండి 02:15 UTC వరకు కొనసాగింది. రిపేర్ జాబితాలో పాజ్ చేసిన అప్డేట్లను దశలవారీగా తిరిగి మొదలుపెట్టడం కూడా ఉంది.
GitHub, 7 అక్టోబర్ 2026
ఏ డేటాబేస్ సర్వర్లకు రైట్లు వెళ్లాలో ఒక అంతర్గత సర్వీస్ నిర్ణయిస్తుంది. సాధారణ మెయింటెనెన్స్ సమయంలో, ఒక రీప్లేస్మెంట్ మెషిన్ తొలగించిన సర్వర్లను ఇంకా జాబితా చేసే పాత రికార్డులతో మొదలై, ఇక లేని సర్వర్లకు రైట్లను పంపింది. ప్రతిసారీ దాదాపు పది నిమిషాల పాటు రైట్లు ఫెయిల్ అయ్యాయి. రెండోసారి, ఒక ఆటోమేటెడ్ మెయింటెనెన్స్ టాస్క్ పాజ్ను పట్టించుకోకుండా ఆ మెషిన్ను తిరిగి బాధ్యతలోకి తెచ్చిందని GitHub చెబుతోంది.
ఇది చిన్నదే, కానీ ఈ ప్యాటర్న్కు సరిపోతుంది.
ఈ నాలుగింటిలో ఉమ్మడి అంశాలు
నాలుగు నివేదికలను పక్కపక్కన చదివితే, మూడు ప్యాటర్న్లు కనిపిస్తాయి. ఇవి నివేదికలపై మా అవగాహన మాత్రమే, ఏ ప్రొవైడర్ ప్రచురించిన నిర్ధారణ కాదు.
మొదటిది, విఫలమైన భాగం రికవరీ మార్గంలోనే ఉంది. EC2ని సరిచేయడానికి AWSకు DynamoDB అవసరమైంది. Google రీజనల్ కంట్రోల్ సర్వీస్లు చీకటిలో ఉన్న జోన్ కోసం వేచి ఉంటూనే ఉన్నాయి. Azure రిపేర్కు అప్పటికే ఓవర్లోడ్ అయిన కంట్రోల్ ప్లేన్ అవసరమైంది.
రెండవది, వీటిలో మూడింటిలో ఆటోమేషన్ కారణంలో భాగమైంది: AWS DNS మేనేజ్మెంట్, Azure తిరిగి మొదలైన అప్డేట్లు, GitHub మెయింటెనెన్స్ టాస్క్. మూడవది, ఫెయిలోవర్ స్వయంగా లోడ్ సృష్టించింది: Google మిగిలిన జోన్లు ముంచెత్తబడ్డాయి, AWS లోడ్ బ్యాలెన్సర్ ఫెయిలోవర్ సామర్థ్యాన్ని తొలగించింది.
దీని అర్థం క్లౌడ్ మొత్తంగా నమ్మదగనిదని కాదు. ఇవి నాలుగు నివేదికలు, నాలుగు ప్రొవైడర్ల నుండి, ప్రొవైడర్లే రాసినవి. కానీ ఇతర జోన్లలో సామర్థ్యాన్ని మొదలుపెట్టడం కూడా ఇబ్బంది పడుతున్న కంట్రోల్ ప్లేన్పై ఆధారపడితే, “మల్టిపుల్ జోన్లు” అనేది పూర్తి సమాధానం కాదని దీని అర్థం.
మీ సొంత డిజైన్ కోసం ఐదు ప్రశ్నలు
- ఒక జోన్ మాయమైతే, కొత్తగా ఏదీ లాంచ్ చేయకుండానే మీరు సర్వీస్ను నిలబెట్టగలరా?
- మీ రికవరీ స్టెప్లలో ఏవి ప్రొవైడర్ API ని పిలుస్తాయి: ఆటోస్కేలింగ్, రీడిప్లాయ్ చేయడం, DNS మార్చడం, క్లౌడ్ రోల్తో సైన్ ఇన్ చేయడం?
- మీ ఫెయిలోవర్ ఇంకా ఆరోగ్యంగా ఉన్న చోట్లపై అదనపు లోడ్ పెడుతోందా, మీ మళ్లీ ప్రయత్నాలు నెమ్మదిగా ఉన్న సిస్టమ్ను మరింత నెమ్మది చేస్తున్నాయా?
- మీ సొంత కాన్ఫిగరేషన్ మార్పులు ప్రతి సర్వర్కు ఒకేసారి చేరతాయా, లేక దశలవారీగా చేరతాయా?
- ప్రొవైడర్ కంట్రోల్ ప్లేన్ నెమ్మదిగా ఉన్నప్పుడు లేదా అందుబాటులో లేనప్పుడు రికవరీ మార్గాన్ని మీరు ప్రయత్నించారా, లేక అది పనిచేస్తున్నప్పుడు మాత్రమేనా?
అదనపు సామర్థ్యానికి డబ్బు ఖర్చవుతుంది, చాలా సిస్టమ్లు ఒక గంట డౌన్టైమ్తో కూడా సరిపోతాయి. ఆ ఎంపికను ఉద్దేశపూర్వకంగా చేయడమే అసలు విషయం. ప్రశ్న 1 పరీక్షించడం అన్నింటికంటే కష్టం, ఎందుకంటే దానికి జాగ్రత్తగా చేసిన రిహార్సల్ లేదా నిజమైన జోన్ ఫెయిల్యూర్ కావాలి.
దీన్ని ఎంత లోతుగా నేర్చుకోవాలి
తెలుసుకోవడం: క్లౌడ్ సర్వీస్లు వాడే ప్రతి ఒక్కరూ నడుస్తూ ఉండడం, నిర్వహించగలగడం వేర్వేరు విషయాలని, కంట్రోల్ ప్లేన్, డేటా ప్లేన్ అంటే ఏమిటో తెలుసుకోవాలి.
వాడడం: క్లౌడ్లో ప్రొడక్షన్ నడిపే ఇంజినీర్లు, ఏ రికవరీ స్టెప్లు ప్రొవైడర్ API లపై ఆధారపడతాయో, ఏవి ఆధారపడవో జాబితా చేయగలగాలి.
నైపుణ్యం సాధించడం: ఆర్కిటెక్ట్లు, రిలయబిలిటీ ఇంజినీర్లు ఎంత సామర్థ్యాన్ని ముందే ప్రొవిజన్ చేసి ఉంచాలో, ఫెయిలోవర్, మళ్లీ ప్రయత్నాలను ఎలా పరిమితం చేయాలో, కాన్ఫిగరేషన్ దశలవారీగా ఎలా రోల్ అవుట్ అవ్వాలో నిర్ణయిస్తారు.
ప్రస్తుతానికి వదిలేయదగినవి
ఈ నాలుగు సంఘటనల నుండి ప్రొవైడర్ల లీగ్ టేబుల్లను, అప్టైమ్ శాతాలను వదిలేయండి. మీరు రివ్యూ రాస్తుంటే తప్ప, ఖచ్చితమైన టైమ్లైన్లను వదిలేయండి, ఎందుకంటే ప్రొవైడర్లు వాటిని ప్రచురించారు, కొన్ని ఇంకా సవరించబడుతున్నాయి. ఐదు ప్రశ్నలు అడగడానికి ప్రతి ప్రొవైడర్ అంతర్గత సర్వీస్ పేర్లను నేర్చుకోవాల్సిన అవసరం లేదు.
తర్వాత ఏం చేయాలి
మీరు నడిపే ఒక సర్వీస్ను ఎంచుకోండి. రేపు ఒక జోన్ చీకటిలోకి వెళ్తే సర్వీస్ను నిలబెట్టడానికి, ప్రొవైడర్ కంట్రోల్ ప్లేన్లో ఏం క్రియేట్ చేయాలో, మార్చాలో లేదా పిలవాలో రాసుకోండి. ఆ జాబితాలోని ప్రతిదీ మీరు పరీక్షించగల, తగ్గించగల లేదా అంగీకరించగల డిపెండెన్సీ.
ఫెయిలోవర్ ప్లాన్ను నమ్ముకునే ముందు, ప్రొవైడర్ ఇబ్బంది పడుతున్నప్పుడు దానికి ప్రొవైడర్ నుండి ఏం కావాలో తెలుసుకోండి.
మనకు తెలిసినవి, తెలియనివి
| క్లెయిమ్ | రకం | మూలం |
|---|---|---|
| AWS DynamoDB DNS అంతరాయం 2025 అక్టోబర్ 19 నుండి 20 వరకు జరిగింది, రేస్ కండిషన్ వల్ల DNS రికార్డ్ ఖాళీ అయింది | AWS సొంత సారాంశం | AWS పోస్ట్-ఈవెంట్ సారాంశం |
| DNS 2:25 AM PDT కి పునరుద్ధరించబడింది, కానీ EC2 లాంచ్లు 10:36 AM వరకు, లోడ్ బ్యాలెన్సర్ ఎర్రర్లు 2:09 PM వరకు కొనసాగాయి | AWS సొంత సారాంశం | AWS పోస్ట్-ఈవెంట్ సారాంశం |
| పరిష్కారం వచ్చే వరకు DNS Planner, Enactor ఆటోమేషన్ను AWS ప్రపంచవ్యాప్తంగా డిసేబుల్ చేసింది | ఆ సమయంలో AWS ప్రకటన. ప్రస్తుత స్థితి తెలియదు | AWS పోస్ట్-ఈవెంట్ సారాంశం |
| Google europe-west2 అంతరాయం 2026 అక్టోబర్ 20న 06:00 నుండి 12:08 UTC వరకు కొనసాగింది, విద్యుత్ అంతరాయం, జనరేటర్ కంట్రోలర్ వైఫల్యం తర్వాత | Google ఇన్సిడెంట్ రిపోర్ట్, పేజీ సారాంశం ద్వారా చదివింది | Google Cloud ఇన్సిడెంట్ |
| జోన్ల మధ్య కంట్రోల్ ప్లేన్ కాల్స్, ఫెయిలోవర్ లోడ్ ప్రభావాన్ని ఒక్క జోన్ దాటి వ్యాపింపజేశాయి | Google ఇన్సిడెంట్ రిపోర్ట్, పేజీ సారాంశం ద్వారా చదివింది | Google Cloud ఇన్సిడెంట్ |
| కంట్రోలర్ వైఫల్యానికి కారణం కంట్రోలర్ లాజిక్ మిస్కాన్ఫిగరేషన్ అని Google తుది నివేదిక చెబుతోంది | Google తుది నివేదిక. పదబంధాన్ని పేజీలో తనిఖీ చేశారు | Google Cloud ఇన్సిడెంట్ |
| Azure 30 సెప్టెంబర్ గేట్వే సంఘటన, నెమ్మదించిన షేర్డ్ కంట్రోల్ ప్లేన్ను పాజ్ చేసిన అప్డేట్లు తిరిగి మొదలై తాకడం వల్ల వచ్చింది | Microsoft పోస్ట్ ఇన్సిడెంట్ రివ్యూ, పేజీ సారాంశం ద్వారా చదివింది | Azure స్టేటస్ హిస్టరీ, జాబితాలో 7Q30-010 ఎంట్రీ. దానికి పర్మాలింక్ పేజీలో లేదు |
| GitHub 7 అక్టోబర్ రైట్ అంతరాయాలు పాత రూటింగ్ రికార్డులున్న మెషిన్ వల్ల వచ్చాయి | GitHub స్టేటస్ పోస్ట్లు | GitHub 7 అక్టోబర్ సంఘటన, మొదటి అంతరాయం మరియు పునరావృతం |
మరింత లోతుగా
- AWS: నార్తర్న్ వర్జీనియా రీజియన్లో Amazon DynamoDB సర్వీస్ అంతరాయం సారాంశం, పూర్తి టైమ్లైన్ కోసం, AWS దిద్దుబాటు చర్యల కోసం.
- Google Cloud ఇన్సిడెంట్ Xs2XTHzAVC9YnafnPyzj, ప్రాథమిక, తుది నివేదికల కోసం.
- Azure స్టేటస్ హిస్టరీ, 30 సెప్టెంబర్ పోస్ట్ ఇన్సిడెంట్ రివ్యూ 7Q30-010 కోసం (జాబితాలో వెతకండి, నేరు లింక్ లేదు).
- GitHub స్టేటస్: 7 అక్టోబర్ సంఘటన మరియు పునరావృతం.
- ఈ సైట్లో సంబంధిత వ్యాసం: క్లౌడ్ కెపాసిటీ అంటే క్లౌడ్ అవైలబిలిటీ కాదు, ఇది అదే సమస్యలోని లాంచ్ ఫెయిల్యూర్ వైపును వివరిస్తుంది.
ఈ వ్యాసంలోని వాస్తవాలను 30 అక్టోబర్ 2026న తనిఖీ చేశాం. ప్రొవైడర్లు ఇంకా తమ సమీక్షలను ప్రచురిస్తూ, సవరిస్తూ ఉన్నారు, కాబట్టి చర్య తీసుకునే ముందు పైన ఉన్న మూలాలను చూడండి.