

आपके सर्वर ठीक हो सकते हैं और फिर भी आप डाउन हो सकते हैं
अगर सर्वर चल रहे हैं, तो सर्विस डाउन क्यों है?
कई आउटेज की कहानियाँ एक जैसी सुनाई देती हैं: क्लाउड प्रोवाइडर के यहाँ कुछ टूटा, इसलिए हमारा एप्लिकेशन बंद हो गया। पिछले एक साल की चार घटनाएँ एक ऐसा पैटर्न दिखाती हैं जिसे आसानी से अनदेखा किया जा सकता है। पहली गड़बड़ी हमेशा उस हिस्से में नहीं थी जो यूज़र्स को सर्व करता है, और जब थी भी, तब भी नुकसान उस हिस्से की वजह से फैला या लंबा चला जो काम को शुरू करता है, अपडेट करता है और रूट करता है।
इस हिस्से का एक नाम है। यह लेख उसे समझाता है, हर घटना में क्या हुआ यह बताता है, और अंत में पाँच सवाल देता है जो आप अपने डिज़ाइन के बारे में पूछ सकते हैं।
हर क्लाउड के अंदर दो काम
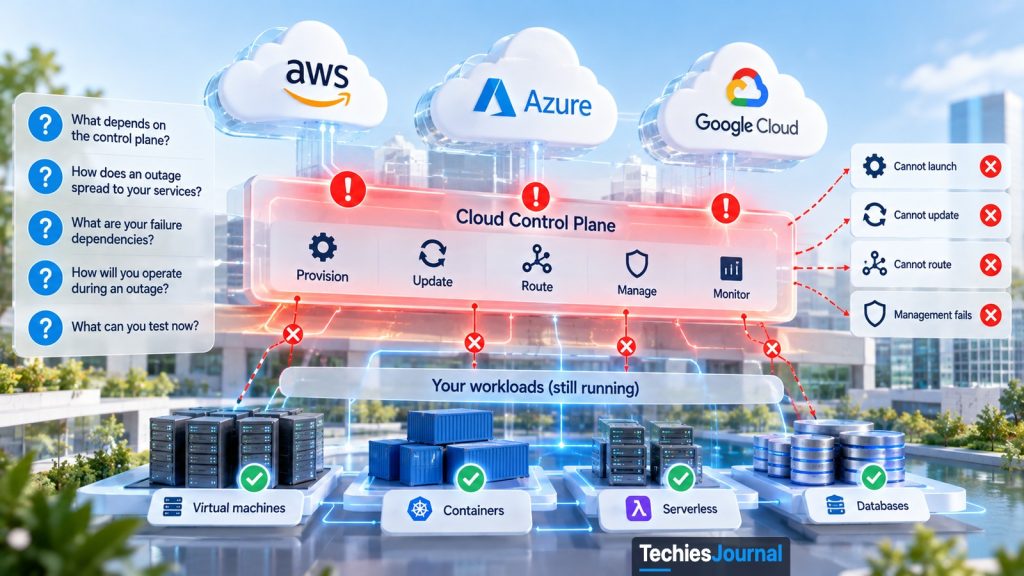
क्लाउड दो काम करता है। पहला है आपके काम को चलाना: रिक्वेस्ट का जवाब देना, डेटा स्टोर करना और नेटवर्क ट्रैफ़िक को आगे बढ़ाना। इसे डेटा प्लेन कहते हैं।
दूसरा है उस काम को मैनेज करना: मशीनें लॉन्च करना, सेटिंग्स लागू करना, हेल्थ चेक करना और तय करना कि ट्रैफ़िक कहाँ जाएगा। इसे कंट्रोल प्लेन कहते हैं। जब भी आप स्केल अप करते हैं, डिप्लॉय करते हैं, फ़ेलओवर करते हैं या क्लाउड आइडेंटिटी से साइन इन करते हैं, आप इसे छूते हैं।
ज़्यादातर समय आपको इस फ़र्क का पता नहीं चलता। आउटेज में चलता है, क्योंकि कोई सर्विस डेटा प्लेन पर ठीक हो सकती है और फिर भी कंट्रोल प्लेन पर उसे ठीक करना नामुमकिन हो सकता है।
विवरण पढ़ने के लिए चित्र में कोई घटना चुनें।
विवरण पढ़ने के लिए कोई घटना चुनें।
1. AWS, अक्टूबर 2025
- पहले क्या फ़ेल हुआ
- AWS के DNS मैनेजमेंट सिस्टम में एक छिपी रेस कंडीशन ने पुराने प्लान को नए प्लान पर ओवरराइट होने दिया, और फिर एक क्लीनअप स्टेप ने पुराना प्लान डिलीट कर दिया। इससे रीजनल DynamoDB एंडपॉइंट का DNS रिकॉर्ड खाली रह गया, और ऑपरेटर्स को दखल देना पड़ा।
- किसने इसे फैलाया या लंबा किया
- DynamoDB लौटने के बाद, EC2 होस्ट्स को मैनेज करने वाला सिस्टम उस हालत में पहुँच गया जिसे AWS कंजेस्टिव कोलैप्स कहता है, इसलिए नए EC2 इंस्टेंस 10:36 AM तक लॉन्च नहीं हो सके। लोड बैलेंसर हेल्थ चेक कभी फ़ेल और कभी हेल्दी दिखाते रहे, और ऑटोमैटिक फ़ेलओवर ने कैपेसिटी को सर्विस से बाहर कर दिया, जब तक इंजीनियरों ने उसे 9:36 AM पर बंद नहीं किया।
- कितनी देर
- DNS 20 अक्टूबर को 2:25 AM Pacific टाइम तक बहाल हो गया। EC2 लॉन्च 10:36 AM तक फ़ेल रहे और लोड बैलेंसर एरर 2:09 PM तक चले।
- प्रोवाइडर ने क्या बदला
- AWS ने फ़िक्स आने तक दुनिया भर में DNS Planner और Enactor ऑटोमेशन बंद कर दिया। यह उस समय का AWS का बयान है, और मौजूदा स्थिति अज्ञात है।
2. Google Cloud, 20 अक्टूबर 2026
- पहले क्या फ़ेल हुआ
- लंदन में एक ज़ोन (europe-west2-b) को होस्ट करने वाली इमारत की बिजली बाधित हो गई। प्राइमरी और बैकअप दोनों कंट्रोलर जनरेटर शुरू करने में फ़ेल रहे, इसलिए बैटरियाँ खत्म हो गईं और उस ज़ोन की हर चीज़ की बिजली चली गई। Google की फ़ाइनल रिपोर्ट कंट्रोलरों में एक मिसकॉन्फ़िगरेशन की ओर इशारा करती है।
- किसने इसे फैलाया या लंबा किया
- रीजनल सर्विसेज़ से ऑफ़लाइन ज़ोन को जाने वाली कॉल टाइमआउट हो गईं, और जो ट्रैफ़िक बाकी ज़ोन्स में फ़ेलओवर हुआ, उसने उनकी कैपेसिटी खत्म कर दी।
- कितनी देर
- आउटेज 06:00 से 12:08 UTC तक चला। नई वर्चुअल मशीन बनाना 04:46 Pacific टाइम पर फिर शुरू हुआ, जो 11:46 UTC है।
- प्रोवाइडर ने क्या बदला
- यह लेख लिखे जाते समय Google की रिपेयर लिस्ट अभी खुली थी।
3. Azure, 30 सितंबर 2026
- पहले क्या फ़ेल हुआ
- Microsoft ने नेटवर्क गेटवे के एक समूह पर ऑपरेटिंग सिस्टम अपडेट रोक रखे थे। जब रोक खत्म हुई, तो कई अपडेट एक साथ शुरू हो गए।
- किसने इसे फैलाया या लंबा किया
- अपडेट ने एक साझा रीजनल कंट्रोल प्लेन को भर दिया, जिसे हाल के एक बदलाव ने पहले ही धीमा कर दिया था। Microsoft की समीक्षा कहती है कि उसकी थ्रॉटलिंग और लोड प्रोटेक्शन “क्रिटिकल प्रोसेसिंग को पर्याप्त रूप से सुरक्षित नहीं कर पाई”। कुछ ExpressRoute गेटवे पर, रीस्टार्ट हो रहे एक गेटवे को बहुत जल्दी हेल्दी मार्क कर दिया गया, इसलिए अपडेट उसके बैकअप पर चला गया, और ऑन-प्रेमिसेस नेटवर्क से कुछ कनेक्शन तब तक टूटे रहे जब तक गेटवे अपनी आखिरी सही सेटिंग्स पर वापस नहीं लौट गए।
- कितनी देर
- असर 30 सितंबर से शुरू होकर 20:30 UTC से 02:15 UTC तक रहा।
- प्रोवाइडर ने क्या बदला
- रिपेयर लिस्ट में रोके गए अपडेट को चरणों में फिर शुरू करना शामिल है।
4. GitHub, 7 अक्टूबर 2026
- पहले क्या फ़ेल हुआ
- एक इंटरनल सर्विस तय करती है कि किन डेटाबेस सर्वरों को राइट्स मिलेंगे। रूटीन मेंटेनेंस के दौरान, एक रिप्लेसमेंट मशीन पुराने रिकॉर्ड के साथ शुरू हुई जिनमें हटाए जा चुके सर्वर अब भी दर्ज थे।
- किसने इसे फैलाया या लंबा किया
- मशीन ने राइट्स ऐसे सर्वरों को भेज दिए जो अब थे ही नहीं। दूसरी बार, GitHub के अनुसार एक ऑटोमेटेड मेंटेनेंस टास्क ने मशीन को फिर से कमान सौंप दी, जबकि रोक का सम्मान नहीं किया गया।
- कितनी देर
- हर बार राइट्स लगभग दस मिनट तक फ़ेल रहे।
- प्रोवाइडर ने क्या बदला
- इस लेख में दिए गए स्टेटस पेज कोई बदलाव नहीं बताते।
चार घटनाएँ
AWS, अक्टूबर 2025
यह एक साल पुरानी है, लेकिन AWS ने अब तक का सबसे विस्तृत ब्योरा इसी का प्रकाशित किया है। us-east-1 रीजन में, रीजनल DynamoDB एंडपॉइंट का DNS रिकॉर्ड खाली हो गया। AWS के अनुसार उसके DNS मैनेजमेंट सिस्टम में एक छिपी हुई रेस कंडीशन थी, जिससे एक पुराना प्लान नए प्लान को ओवरराइट कर गया, और फिर एक क्लीनअप स्टेप ने पुराना प्लान डिलीट कर दिया, जिससे रिकॉर्ड से हर एड्रेस हट गया। ऑटोमेशन खुद को ठीक नहीं कर पाया, इसलिए ऑपरेटर्स को दखल देना पड़ा।
रिकॉर्ड 20 अक्टूबर को 2:25 AM Pacific टाइम तक बहाल हो गया, फिर भी ग्राहकों के यहाँ घंटों तक फ़ेल होता रहा। नए EC2 इंस्टेंस 10:36 AM तक लॉन्च नहीं हो पाए, और EC2 होस्ट्स को मैनेज करने वाला सिस्टम, DynamoDB के लौटते ही, उस हालत में पहुँच गया जिसे AWS कंजेस्टिव कोलैप्स कहता है। लोड बैलेंसर भी प्रभावित हुए। AWS के अनुसार हेल्थ चेक कभी फ़ेल और कभी हेल्दी दिखाते रहे, जिससे नोड्स DNS से हटते गए, और ज़ोन्स में फैले लोड बैलेंसरों के लिए ऑटोमैटिक फ़ेलओवर ने कैपेसिटी को सर्विस से बाहर कर दिया। इंजीनियरों ने उस फ़ेलओवर को 9:36 AM पर बंद किया।
कारण को ठीक करने में तीन घंटे से कम लगे। उससे उबरने में लगभग बारह घंटे और लगे।
Google Cloud, 20 अक्टूबर 2026
लंदन में एक ज़ोन (europe-west2-b) को होस्ट करने वाली इमारत की बिजली बाधित हो गई। Google की रिपोर्ट के अनुसार प्राइमरी और बैकअप दोनों कंट्रोलर जनरेटर शुरू करने में फ़ेल रहे, इसलिए बैटरियाँ खत्म हो गईं और उस ज़ोन की हर चीज़ की बिजली चली गई। जो वर्कलोड सिर्फ़ उसी ज़ोन में थे, वे पहुँच से बाहर हो गए।
नुकसान ज़ोन से आगे कंट्रोल प्लेन की वजह से फैला। Google के अनुसार रीजनल सर्विसेज़ से ऑफ़लाइन ज़ोन को जाने वाली कॉल टाइमआउट हो गईं, और जो ट्रैफ़िक बाकी ज़ोन्स में फ़ेलओवर हुआ, उसने उनकी कैपेसिटी खत्म कर दी। आउटेज 06:00 से 12:08 UTC तक चला, और नई वर्चुअल मशीन बनाना 04:46 Pacific टाइम पर फिर शुरू हुआ, जो 11:46 UTC है। Google की फ़ाइनल रिपोर्ट कंट्रोलरों में एक मिसकॉन्फ़िगरेशन की ओर इशारा करती है, और इसे लिखे जाते समय उसकी रिपेयर लिस्ट अभी खुली थी।
Azure, 30 सितंबर 2026
Microsoft ने नेटवर्क गेटवे के एक समूह पर ऑपरेटिंग सिस्टम अपडेट रोक रखे थे। जब रोक खत्म हुई, तो कई अपडेट एक साथ शुरू हो गए और उन्होंने एक साझा रीजनल कंट्रोल प्लेन को भर दिया, जिसे हाल के एक बदलाव ने पहले ही धीमा कर दिया था। Microsoft की समीक्षा कहती है कि उसकी थ्रॉटलिंग और लोड प्रोटेक्शन “क्रिटिकल प्रोसेसिंग को पर्याप्त रूप से सुरक्षित नहीं कर पाई”।
कुछ ExpressRoute गेटवे पर, रीस्टार्ट हो रहे एक गेटवे को बहुत जल्दी हेल्दी मार्क कर दिया गया, इसलिए अपडेट उसके बैकअप पर चला गया। ऑन-प्रेमिसेस नेटवर्क से कुछ कनेक्शन तब तक टूटे रहे जब तक गेटवे अपनी आखिरी सही सेटिंग्स पर वापस नहीं लौट गए। असर 20:30 UTC से 02:15 UTC तक रहा। रिपेयर लिस्ट में रोके गए अपडेट को चरणों में फिर शुरू करना शामिल है।
GitHub, 7 अक्टूबर 2026
एक इंटरनल सर्विस तय करती है कि किन डेटाबेस सर्वरों को राइट्स मिलेंगे। रूटीन मेंटेनेंस के दौरान, एक रिप्लेसमेंट मशीन पुराने रिकॉर्ड के साथ शुरू हुई जिनमें हटाए जा चुके सर्वर अब भी दर्ज थे, और उसने राइट्स ऐसे सर्वरों को भेज दिए जो अब थे ही नहीं। हर बार राइट्स लगभग दस मिनट तक फ़ेल रहे। दूसरी बार, GitHub के अनुसार एक ऑटोमेटेड मेंटेनेंस टास्क ने मशीन को फिर से कमान सौंप दी, जबकि रोक का सम्मान नहीं किया गया।
यह घटना छोटी थी, लेकिन इसी पैटर्न में बैठती है।
चारों में क्या समान है
चारों रिपोर्ट साथ-साथ पढ़ने पर तीन पैटर्न दिखते हैं। ये रिपोर्टों की हमारी अपनी व्याख्या हैं, किसी प्रोवाइडर का प्रकाशित निष्कर्ष नहीं।
पहला, फ़ेल होने वाला हिस्सा रिकवरी के रास्ते में बैठा था। AWS को EC2 ठीक करने के लिए DynamoDB चाहिए था। Google की रीजनल कंट्रोल सर्विसेज़ ऐसे ज़ोन का इंतज़ार करती रहीं जो अंधेरे में था। Azure की रिपेयर के लिए ऐसा कंट्रोल प्लेन चाहिए था जो पहले से ओवरलोड था।
दूसरा, तीन में ऑटोमेशन कारण का हिस्सा था: AWS का DNS मैनेजमेंट, Azure के फिर शुरू किए गए अपडेट और GitHub का मेंटेनेंस टास्क। तीसरा, फ़ेलओवर ने खुद लोड पैदा किया: Google के बचे हुए ज़ोन पर बोझ पड़ गया और AWS के लोड बैलेंसर फ़ेलओवर ने कैपेसिटी हटा दी।
इसका मतलब यह नहीं कि क्लाउड कुल मिलाकर अविश्वसनीय है। ये चार रिपोर्ट हैं, चार प्रोवाइडर्स की, और प्रोवाइडर्स ने ही लिखी हैं। इसका मतलब यह ज़रूर है कि “कई ज़ोन” पूरा जवाब नहीं है, अगर बाकी ज़ोन में कैपेसिटी शुरू करना ऐसे कंट्रोल प्लेन पर निर्भर है जो खुद भी जूझ रहा है।
अपने डिज़ाइन के लिए पाँच सवाल
- अगर कोई ज़ोन गायब हो जाए, तो क्या आप कुछ भी नया लॉन्च किए बिना चालू रह सकते हैं?
- आपके रिकवरी स्टेप्स में से कौन से प्रोवाइडर API को कॉल करते हैं: ऑटोस्केलिंग, दोबारा डिप्लॉय करना, DNS बदलना, क्लाउड रोल से साइन इन करना?
- क्या आपका फ़ेलओवर बचे हुए स्वस्थ हिस्सों पर अतिरिक्त लोड डालता है, और क्या आपकी दोबारा कोशिशें धीमे सिस्टम को और धीमा कर देती हैं?
- क्या आपके अपने कॉन्फ़िगरेशन बदलाव सभी सर्वरों तक एक साथ पहुँचते हैं, या चरणों में?
- क्या आपने रिकवरी का रास्ता तब आज़माया है जब प्रोवाइडर का कंट्रोल प्लेन धीमा या अनुपलब्ध हो, या सिर्फ़ तब जब वह ठीक चल रहा हो?
अतिरिक्त कैपेसिटी पर पैसा खर्च होता है, और कई सिस्टम एक घंटे के डाउनटाइम के साथ ठीक रहते हैं। बात बस इतनी है कि यह चुनाव जानबूझकर किया जाए। सवाल 1 को टेस्ट करना सबसे मुश्किल है, क्योंकि इसके लिए सावधानी से किया गया रिहर्सल या असली ज़ोन फ़ेल्योर चाहिए।
इसे कितनी गहराई से सीखें
जानना: क्लाउड सर्विसेज़ इस्तेमाल करने वाले हर व्यक्ति को जानना चाहिए कि चल रहा होना और मैनेज हो सकना अलग बातें हैं, और कंट्रोल प्लेन व डेटा प्लेन का क्या मतलब है।
इस्तेमाल करना: जो इंजीनियर क्लाउड पर प्रोडक्शन चलाते हैं, उन्हें गिनाना आना चाहिए कि कौन से रिकवरी स्टेप्स प्रोवाइडर API पर निर्भर हैं और कौन से नहीं।
महारत हासिल करना: आर्किटेक्ट और रिलायबिलिटी इंजीनियर तय करते हैं कि कितनी कैपेसिटी पहले से प्रोविज़न रहे, फ़ेलओवर और दोबारा कोशिशों को कैसे सीमित किया जाए, और कॉन्फ़िगरेशन चरणों में कैसे रोलआउट हो।
फ़िलहाल क्या अनदेखा कर सकते हैं
इन चार घटनाओं से प्रोवाइडर्स की रैंकिंग और अपटाइम प्रतिशत को छोड़ दें। सटीक टाइमलाइन भी तब तक छोड़ दें जब तक आप रिव्यू नहीं लिख रहे, क्योंकि प्रोवाइडर्स ने उन्हें प्रकाशित किया है और कुछ अब भी संशोधित हो रही हैं। पाँच सवाल पूछने के लिए आपको हर प्रोवाइडर की इंटरनल सर्विस के नाम सीखने की ज़रूरत नहीं है।
आगे क्या करें
अपनी चलाई कोई एक सर्विस चुनें। लिख लें कि अगर कल कोई ज़ोन अंधेरे में चला जाए, तो उसे चालू रखने के लिए प्रोवाइडर के कंट्रोल प्लेन में क्या बनाना, बदलना या कॉल करना पड़ेगा। इस सूची की हर चीज़ एक डिपेंडेंसी है जिसे आप टेस्ट कर सकते हैं, छोटा कर सकते हैं या स्वीकार कर सकते हैं।
फ़ेलओवर प्लान पर भरोसा करने से पहले जान लें कि प्रोवाइडर के जूझते समय उसे प्रोवाइडर से क्या चाहिए।
हम क्या जानते हैं और क्या नहीं
| दावा | प्रकार | स्रोत |
|---|---|---|
| AWS का DynamoDB DNS आउटेज 19 से 20 अक्टूबर 2025 को हुआ, जिसकी वजह एक रेस कंडीशन थी जिसने DNS रिकॉर्ड खाली छोड़ दिया | AWS का अपना सारांश | AWS पोस्ट-इवेंट सारांश |
| DNS 2:25 AM PDT तक बहाल हो गया, लेकिन EC2 लॉन्च 10:36 AM तक फ़ेल रहे और लोड बैलेंसर एरर 2:09 PM तक चले | AWS का अपना सारांश | AWS पोस्ट-इवेंट सारांश |
| AWS ने फ़िक्स आने तक दुनिया भर में DNS Planner और Enactor ऑटोमेशन बंद कर दिया | उस समय का AWS का बयान। मौजूदा स्थिति अज्ञात | AWS पोस्ट-इवेंट सारांश |
| Google का europe-west2 आउटेज 20 अक्टूबर 2026 को 06:00 से 12:08 UTC तक चला, बिजली बाधित होने और जनरेटर कंट्रोलर फ़ेल होने के बाद | Google की इंसिडेंट रिपोर्ट, पेज के सारांश के ज़रिए पढ़ी गई | Google Cloud इंसिडेंट |
| ज़ोन के बीच कंट्रोल प्लेन कॉल और फ़ेलओवर लोड ने असर को एक ज़ोन से आगे फैलाया | Google की इंसिडेंट रिपोर्ट, पेज के सारांश के ज़रिए पढ़ी गई | Google Cloud इंसिडेंट |
| Google की फ़ाइनल रिपोर्ट कंट्रोलर के फ़ेल होने का कारण कंट्रोलर लॉजिक का मिसकॉन्फ़िगरेशन बताती है | Google की फ़ाइनल रिपोर्ट। वाक्यांश पेज पर जाँचा गया | Google Cloud इंसिडेंट |
| Azure का 30 सितंबर का गेटवे इंसिडेंट रोके गए अपडेट के फिर शुरू होने से हुआ, जो धीमे साझा कंट्रोल प्लेन से टकराए | Microsoft की पोस्ट इंसिडेंट रिव्यू, पेज के सारांश के ज़रिए पढ़ी गई | Azure स्टेटस हिस्ट्री, सूची में एंट्री 7Q30-010। इसके लिए पेज पर कोई परमालिंक नहीं है |
| GitHub के 7 अक्टूबर के राइट आउटेज पुराने रूटिंग रिकॉर्ड वाली एक मशीन से हुए | GitHub स्टेटस पोस्ट | 7 अक्टूबर का GitHub इंसिडेंट, पहला आउटेज और दोबारा हुआ आउटेज |
और गहराई में जाएँ
- AWS: Summary of the Amazon DynamoDB service disruption in the Northern Virginia region, पूरी टाइमलाइन और AWS के सुधारात्मक कदमों के लिए।
- Google Cloud incident Xs2XTHzAVC9YnafnPyzj, प्रारंभिक और फ़ाइनल रिपोर्ट के लिए।
- Azure स्टेटस हिस्ट्री, 30 सितंबर की पोस्ट इंसिडेंट रिव्यू 7Q30-010 के लिए (इसे सूची में खोजें, कोई सीधा लिंक नहीं है)।
- GitHub स्टेटस: 7 अक्टूबर का इंसिडेंट और दोबारा हुआ आउटेज।
- इसी साइट पर संबंधित: Cloud Capacity Is Not Cloud Availability, जो इसी समस्या के लॉन्च फ़ेल होने वाले पहलू को कवर करता है।
इस लेख के तथ्य 30 अक्टूबर 2026 को जाँचे गए थे। प्रोवाइडर्स अब भी अपनी समीक्षाएँ प्रकाशित और संशोधित कर रहे हैं, इसलिए कुछ भी करने से पहले ऊपर के स्रोत देख लें।