

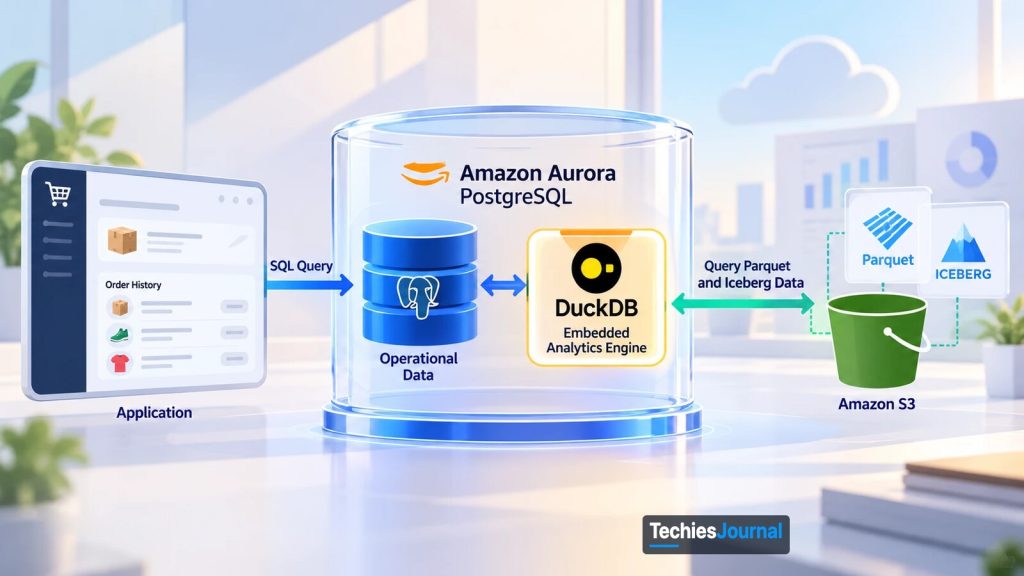
Ilustración de arquitectura proporcionada por el propietario del sitio. Las etiquetas de la imagen están en inglés, y los logotipos que aparecen son representaciones aproximadas que solo sirven para nombrar las tecnologías tratadas.
Amazon Aurora PostgreSQL ya puede consultar datos históricos almacenados en Amazon S3 mediante un motor DuckDB integrado. La novedad cambia la forma en que las aplicaciones acceden a los datos repartidos entre bases de datos operacionales y lagos de datos (data lakes), y podría eliminar algunos procesos de copia de datos sin sustituir el trabajo más amplio de la ingeniería de datos.
Cuando una aplicación necesita datos de dos lugares
Piensa en un comercio minorista ficticio que gestiona una tienda en línea desde hace varios años. Su aplicación usa Amazon Aurora PostgreSQL para administrar clientes, pedidos y pagos. Estos registros cambian a lo largo del día. Cuando un cliente hace un pedido, la base de datos debe guardar la transacción de forma fiable y poner la información actualizada a disposición de la aplicación.
La empresa también conserva varios años de transacciones históricas en Amazon S3. Esos registros casi nunca se modifican, pero siguen siendo útiles para atender consultas de clientes, elaborar informes y entender los patrones de compra. Este esquema funciona hasta que la aplicación necesita información de ambos sistemas.
Supón que un cliente contacta con el equipo de soporte por un producto que compró hace tres años. Los pedidos recientes están en Aurora, pero el registro de esa compra antigua está almacenado en S3. El equipo de ingeniería necesita llevar esa información a la vista que ya tiene la aplicación de soporte.
Una opción es mantener un proceso que copie las transacciones históricas de S3 a Aurora. Una vez copiadas, la aplicación puede consultarlas junto con los pedidos actuales a través de PostgreSQL. Funciona, pero añade responsabilidades: el equipo debe mantener el proceso de copia, gestionar los fallos, administrar el almacenamiento duplicado y mantener la información copiada coherente con el origen.
Otra opción es consultar los registros históricos mediante un servicio analítico independiente y combinar los resultados en la aplicación. Así se evita copiar los datos a Aurora, pero se añade otro servicio y otra integración.
Ninguno de los dos enfoques es incorrecto en sí mismo. Pero cuando lo único que se necesita es recuperar el historial de compras de un cliente, mover más datos o añadir otra integración puede suponer más trabajo del que exige la funcionalidad. Este es el problema que hay detrás de la reciente novedad de Amazon en Aurora.
Qué es DuckDB y qué ha cambiado en Aurora
DuckDB es una base de datos de código abierto diseñada para el procesamiento analítico. A diferencia de los servidores de bases de datos tradicionales, que suelen ejecutarse como servicios independientes, DuckDB puede ejecutarse directamente dentro de una aplicación o de una herramienta analítica. Desarrolladores y analistas lo han usado desde lenguajes como Python para consultar archivos Parquet y datos guardados en almacenamiento de objetos en la nube, como Amazon S3. Fuente: DuckDB, Why DuckDB.
Procesa consultas analíticas con eficiencia, sobre todo cuando trabaja con grandes conjuntos de datos organizados por columnas. Antes de este lanzamiento, una aplicación que quisiera usar DuckDB junto con Aurora habría tenido que ejecutarlo e integrarlo por separado. Integrar DuckDB en Aurora lleva el motor analítico al entorno de PostgreSQL, de modo que los conjuntos de datos externos compatibles pueden consultarse a través de la conexión a la base de datos que la aplicación ya usa.
El 30 de septiembre de 2026, AWS anunció la disponibilidad general de la consulta directa de datos de Apache Iceberg y Parquet en Amazon Aurora PostgreSQL. La función es compatible con Aurora PostgreSQL 17.11 y 18.6 y versiones posteriores, en todas las regiones comerciales de AWS y en las regiones GovCloud (US), sin cargo adicional. Fuente: AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data.
Para entender el cambio, conviene separar el papel de cada tecnología. Aurora PostgreSQL sigue siendo la base de datos operacional. Gestiona los registros que las aplicaciones leen, insertan y actualizan con frecuencia, como los pedidos actuales y la información de los clientes.
Amazon S3 almacena los datos históricos. En el ejemplo, las transacciones más antiguas pueden guardarse como archivos Parquet. Parquet organiza los datos por columnas, lo que permite a los sistemas analíticos leer los campos seleccionados sin leer todos los campos de cada registro. AWS también permite que las tablas externas apunten a Amazon S3 Tables y al AWS Glue Data Catalog, pero los archivos en S3 del comercio bastan para seguir la idea.
Apache Iceberg aporta funciones de gestión de tablas sobre archivos de datos. Mantiene metadatos que describen el conjunto de datos y sus cambios a lo largo del tiempo, lo que ayuda a los sistemas analíticos a trabajar de forma coherente con grandes colecciones de datos. DuckDB se encarga del procesamiento de las consultas analíticas. Con la nueva integración en Aurora, puede leer datos Parquet e Iceberg compatibles mientras las aplicaciones siguen usando PostgreSQL.
Los registros históricos no tienen que trasladarse a Aurora solo porque una aplicación quiera consultarlos. Lo que cambia es el camino por el que la aplicación accede a esos registros.
Cómo se ejecuta una consulta del historial de un cliente
Volvamos a la aplicación de soporte del comercio. El equipo de ingeniería crea en Aurora una tabla externa (foreign table) que representa los pedidos históricos almacenados en S3. Una tabla externa es una definición de tabla de PostgreSQL que apunta a datos almacenados fuera de la base de datos. Aporta información sobre las columnas y el origen externo, pero no exige copiar los registros subyacentes al almacenamiento normal de Aurora.
La aplicación tiene ahora acceso a dos tipos de tablas a través de PostgreSQL: tablas nativas con los pedidos actuales y tablas externas que representan los registros históricos en S3.
Cuando la aplicación de soporte solicita el historial de compras de un cliente, envía una consulta SQL por su conexión habitual con Aurora. PostgreSQL analiza y planifica la consulta y luego delega la ejecución en el motor DuckDB integrado, que lee de S3 los datos pertinentes. Según AWS, pueden delegarse al motor planes completos, incluidas las combinaciones (joins) entre tablas externas y tablas locales de PostgreSQL. La consulta devuelve filas normales de PostgreSQL y, según AWS, estas consultas se ejecutan en un único proceso y participan en las transacciones de la sesión como cualquier otra consulta de PostgreSQL.
Sigue una consulta del historial de un cliente
Selecciona un paso para ver dónde está la consulta y qué ocurre allí.
Aurora PostgreSQL
La aplicación de soporte envía una consulta SQL normal. Sigue usando su controlador (driver) y su conexión actuales.
Aurora PostgreSQL
PostgreSQL analiza y planifica la consulta y luego delega la ejecución en el motor DuckDB integrado. Según AWS, pueden delegarse a ese motor planes completos, incluidas las combinaciones entre tablas externas y nativas.
Aurora PostgreSQL
DuckDB lee de S3 solo los rangos de bytes que necesita, con el rol de IAM asociado al clúster. La poda de columnas y los filtros omiten los datos a los que la consulta no hace referencia.
Aurora PostgreSQL
Los datos a los que se accede con frecuencia se guardan en caché en el almacenamiento local de la instancia y se comparten entre sesiones, de modo que las consultas repetidas pueden evitar S3. La caché se vacía cuando la instancia se reinicia o se produce una conmutación por error (failover).
Aurora PostgreSQL
Los resultados vuelven como filas normales de PostgreSQL. Según AWS, las consultas que combinan tablas externas y nativas se ejecutan en un único proceso y participan en las transacciones de la sesión.
Una vista simplificada de cómo describe AWS el funcionamiento de la función. No es un modelo de rendimiento.
La definición de la tabla externa permanece dentro de Aurora, mientras que los datos históricos se quedan en S3. Aurora no se limita a importar todo el conjunto de datos histórico antes de responder a la consulta. En las operaciones compatibles, el motor lee solo los rangos de bytes que necesita y omite las columnas a las que la consulta no hace referencia y los archivos cuyas estadísticas no pueden coincidir con el filtro. Además, los datos a los que se accede con frecuencia se guardan en caché en el almacenamiento local de la instancia y se comparten entre sesiones.
El trabajo real depende de la consulta y de su plan de ejecución, pero la aplicación ya no necesita forzosamente un proceso de copia de datos independiente ni una conexión con un servicio analítico para este tipo de solicitud. Fuente: AWS, cómo funcionan las consultas analíticas en Aurora.
El enfoque tiene un límite importante: las tablas externas son de solo lectura. Permiten a las aplicaciones consultar datos externos, pero no admiten INSERT, UPDATE, DELETE, TRUNCATE ni COPY FROM.
Para cambiar los datos, actualiza los archivos de origen en S3 o la tabla Iceberg mediante AWS Glue u otras herramientas. Para los registros históricos de compras del comercio, el acceso de solo lectura puede ser suficiente. Otras aplicaciones pueden requerir un diseño distinto.
Dónde se simplifica el pipeline de datos
Puede que el comercio creara su proceso de copia de datos históricos por un único motivo: la aplicación de soporte necesitaba una copia de las transacciones antiguas accesible desde PostgreSQL. Si la consulta directa de Aurora cumple los requisitos de rendimiento y fiabilidad de la aplicación, ese proceso de copia podría dejar de ser necesario. La empresa podría conservar sus datos históricos en S3, exponerlos mediante tablas externas y eliminar la copia adicional en Aurora.
Copiar a Aurora o consultar en origen
Cambia entre los dos diseños para comparar lo que el equipo tiene que operar.
Lo que el equipo opera y mantiene
- El proceso de copia y la gestión de sus fallos
- El almacenamiento duplicado del historial copiado
- Mantener la copia coherente con el origen
La aplicación consulta el historial copiado a través de PostgreSQL, junto con los pedidos actuales.
Lo que el equipo opera y mantiene
- La definición de la tabla externa y el acceso a S3
- Probar el rendimiento y el uso de recursos con consultas representativas
- Supervisar la CPU y la memoria de Aurora, la tasa de aciertos de la caché y las lecturas de S3, y posiblemente una instancia de lectura dedicada
- El proceso que prepara los datos limpios y los deposita en S3 (esta función no lo sustituye)
El historial se queda en S3 y la aplicación lo lee a través de PostgreSQL. Que esto resulte más sencillo depende del rendimiento y del costo medidos.
Ilustrativo, para el comercio ficticio del artículo. Que la copia pueda eliminarse depende de las pruebas.
Pero la situación cambia cuando el pipeline hace algo más que copiar datos. Supón que el mismo comercio recibe transacciones de su sitio web, de sus tiendas físicas y de marketplaces externos. Estos sistemas pueden usar identificadores de cliente, códigos de producto y formatos de transacción diferentes. El equipo de ingeniería sigue teniendo que conciliar esas diferencias, corregir los registros incoherentes y preparar información fiable.
DuckDB no realiza automáticamente esas transformaciones de negocio solo porque pueda consultar los datos resultantes. El proceso que deposita los registros históricos en S3 también puede seguir siendo necesario.
La nueva función resuelve cómo accede Aurora a datos externos ya preparados. No sustituye el proceso completo de recopilar, validar, transformar y gobernar esos datos.
Cómo abordan Azure y Google Cloud el mismo problema
AWS no es el único proveedor que simplifica el acceso entre sistemas operacionales y analíticos, pero las arquitecturas difieren. Microsoft Azure admite la replicación (mirroring) de datos de Azure Database for PostgreSQL en OneLake, de Microsoft Fabric, donde, según Microsoft, una copia replicada de forma continua queda disponible para análisis sin procesos ETL complejos. Google Cloud ofrece las consultas federadas de BigQuery, que envían una consulta desde BigQuery a Cloud SQL, AlloyDB o Spanner y devuelven el resultado como una tabla temporal, sin cargar antes esos datos en el almacenamiento de BigQuery.
Aurora sigue una tercera vía: integra DuckDB dentro de PostgreSQL para consultar datos externos compatibles del lago de datos. Son soluciones relacionadas para problemas de acceso a datos, no implementaciones intercambiables.
| Proveedor | Enfoque | Dónde se ejecuta la consulta analítica | ¿Se copian los datos? |
|---|---|---|---|
| AWS | Tablas externas de Aurora PostgreSQL sobre datos Parquet e Iceberg | Dentro del clúster de Aurora, en el motor DuckDB integrado | No en tablas de Aurora. Los datos se leen en origen, y los de uso frecuente se guardan en caché en la instancia |
| Microsoft Azure | Replicación (mirroring) de Azure Database for PostgreSQL en Microsoft Fabric | En Fabric, sobre la copia replicada en OneLake | Sí, el servicio los replica de forma continua |
| Google Cloud | Consultas federadas de BigQuery a Cloud SQL, AlloyDB o Spanner | La instrucción se ejecuta en la base de datos de origen y BigQuery recibe el resultado | No de forma persistente. Los resultados vuelven como una tabla temporal, y Google advierte de que el rendimiento puede ser menor que al leer el almacenamiento de BigQuery |
La tabla muestra por qué la elección no depende solo de las funciones. Cada vía sitúa el trabajo analítico en un lugar distinto. Fuentes: Microsoft, PostgreSQL mirroring in Fabric y Google Cloud, BigQuery federated queries.
Los límites de ejecutar análisis dentro de Aurora
La consulta directa puede simplificar una aplicación, pero no libera a las cargas de trabajo analíticas de consecuencias operativas. Aurora suele encargarse de transacciones en las que el tiempo de respuesta importa. Los clientes esperan que los pedidos y los pagos se completen de forma fiable mientras la aplicación atiende el tráfico normal.
Las consultas analíticas se comportan de otra manera. Pueden leer grandes conjuntos de datos, hacer cálculos complejos y consumir mucha memoria o muchos recursos de procesamiento. Aunque DuckDB está optimizado para el procesamiento analítico, su ejecución integrada consume recursos de cómputo dentro del clúster de base de datos de Aurora.
Una consulta ocasional del historial de un cliente puede ser adecuada para la consulta directa. Cientos de informes simultáneos que recorren varios años de transacciones podrían generar una carga de trabajo distinta que compita por la CPU y la memoria con las operaciones normales de la aplicación.
La recomendación de AWS es que las cargas de trabajo que consultan intensivamente tablas externas se ejecuten en una instancia de lectura (reader) dedicada, y no junto a las transacciones de producción. También señala que las instancias con almacenamiento NVMe local guardan en caché y vuelcan a disco (spill) más rápido que las instancias que solo usan EBS. Fuente: AWS, choosing the right DB instance class.
Otras restricciones también importan. AWS documenta que algunos tipos de datos de PostgreSQL, entre ellos JSONB, SERIAL y los tipos de matriz (array), no tienen una correspondencia compatible. Una misma consulta no puede leer datos de S3 de más de una región de AWS, aunque los datos pueden estar en una región distinta de la del clúster.
La caché en disco se vacía cuando una instancia se reinicia o se produce una conmutación por error, así que las consultas posteriores vuelven a leer de S3. En Aurora Serverless v2, varias consultas analíticas pesadas a la vez pueden superar el ritmo al que la instancia es capaz de escalar. Fuente: AWS, limitaciones de los análisis en Aurora.
El costo debe evaluarse de la misma manera. El anuncio de AWS solo afirma que la función en sí no tiene cargo adicional. Las consultas analíticas siguen consumiendo recursos de Aurora, y al leer datos de S3 pueden aplicarse los cargos correspondientes de Amazon S3, como las solicitudes y cualquier transferencia de datos.
Eliminar un proceso de copia de datos puede reducir los costos de almacenamiento y de mantenimiento. Pero si las consultas analíticas directas requieren instancias de Aurora más grandes o instancias de lectura dedicadas, el beneficio económico global puede ser distinto. No hay que dar por supuestos ni un menor costo ni un mejor rendimiento sin probar una carga de trabajo representativa.
Qué significa esto para una aplicación existente
Para el comercio, la decisión técnica está ahora más acotada. El equipo no necesita rediseñar toda su plataforma de datos. Necesita examinar por qué existe el proceso de copia de datos históricos.
Si ese proceso solo sirve para que los registros de S3 ya listos para consultar sean accesibles a través de Aurora, la nueva integración con DuckDB ofrece una alternativa que vale la pena probar. El equipo puede comparar el enfoque actual con consultas directas a tablas externas, usando solicitudes realistas de historial de clientes y el tráfico previsto de la aplicación. Debería medir:
- Los tiempos de respuesta de la consulta del historial de clientes, comparados con la versión actual basada en la tabla copiada.
- El uso de CPU y memoria de Aurora mientras se ejecuta la consulta, incluidas las métricas de memoria analítica y de volcado a disco que AWS publica en Amazon CloudWatch.
- Las lecturas de S3 y la tasa de aciertos de la caché, que muestran qué parte de los datos se sirve localmente después de las primeras consultas.
- El efecto sobre las transacciones normales de pedidos y pagos que se ejecutan al mismo tiempo.
El resultado determinará si eliminar el proceso de copia simplifica de verdad las operaciones. Los sistemas más amplios de preparación de datos y de informes pueden seguir sin cambios.
Si las consultas directas resultan demasiado lentas para una ruta sensible a la latencia, AWS describe también una opción intermedia: materializar los datos de Iceberg o Parquet en tablas nativas de Aurora con SQL estándar, sin un pipeline ETL.
Elige cómo consultar datos históricos desde Aurora
Responde hasta tres preguntas. Es una ayuda para decidir de TechiesJournal, no una recomendación de AWS, y no es exhaustiva.
¿Necesitas insertar, actualizar o eliminar los registros históricos a través de la tabla externa?
Las tablas externas son de solo lectura. Actualiza los archivos de origen en S3, o la tabla Iceberg mediante AWS Glue u otras herramientas, y usa un diseño distinto para los datos que deban cambiar a través de PostgreSQL.
¿Las consultas a la tabla externa serán pesadas o frecuentes, como grandes recorridos o muchos informes simultáneos, en lugar de consultas ocasionales?
Planifica el aislamiento. La recomendación de AWS es que las cargas de trabajo intensivas sobre tablas externas se ejecuten en una instancia de lectura dedicada, y aconseja una clase con almacenamiento NVMe local para las cargas de trabajo de producción sobre tablas externas. Prueba con una carga de trabajo representativa.
En las pruebas, ¿cumple la consulta directa tu objetivo de latencia en la ruta normal de pedidos?
Mantén la tabla externa. Sigue midiendo la CPU y la memoria de Aurora, la tasa de aciertos de la caché y las lecturas de S3, y después decide si el proceso de copia puede desaparecer.
Plantéate materializar. Para las cargas de trabajo sensibles a la latencia, AWS describe la carga de datos de Iceberg o Parquet en tablas nativas de Aurora con SQL estándar, sin un pipeline ETL. Eso vuelve a poner una copia en el almacenamiento de Aurora, así que mantenerla actualizada pasa a ser tarea tuya (nota de TechiesJournal).
Revisa también la lista de limitaciones de AWS: algunos tipos de datos no son compatibles, una consulta no puede leer datos de S3 de más de una región y es posible que Aurora Serverless v2 no escale con la rapidez suficiente para varias consultas pesadas a la vez.
Por tanto, la integración de DuckDB en Amazon Aurora no marca el fin de los pipelines de análisis. Cambia una frontera importante entre las bases de datos operacionales y el almacenamiento de datos históricos. En las cargas de trabajo compatibles, las aplicaciones ya pueden reunir la información actual y la histórica a través de PostgreSQL sin mantener otra copia de los registros históricos.
El valor está en eliminar el movimiento de datos que ya no cumple ninguna función, y conservar al mismo tiempo las capacidades de procesamiento de datos y de análisis que la empresa sigue necesitando.
Para profundizar
Investigación revisada el 21 de octubre de 2026. El comercio minorista es un escenario ficticio. No se presenta ninguna prueba de rendimiento (benchmark) independiente ni comparación de costos.
Anuncio y documentación de AWS
- AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data, 30 de septiembre de 2026: disponibilidad de la función, versiones del motor compatibles y regiones.
- AWS, cómo funcionan las consultas analíticas en Aurora: procesamiento de consultas, DuckDB integrado, tablas externas e integración con el lago de datos.
- AWS, choosing the right DB instance class: memoria, concurrencia y aislamiento de cargas de trabajo.
- AWS, limitaciones de los análisis en Aurora: tablas de solo lectura, tipos de datos, regiones y comportamiento de la caché.
Contexto y otros proveedores de nube
- DuckDB, Why DuckDB: procesamiento analítico integrado y patrones de uso habituales.
- Microsoft, Azure Database for PostgreSQL mirroring in Fabric: cómo se replican en OneLake los datos operacionales de PostgreSQL.
- Google Cloud, Introduction to BigQuery federated queries: consulta de bases de datos operacionales externas desde BigQuery.
Lecturas relacionadas en TechiesJournal
- Las redes multinube se convierten en un servicio en la nube: lo que AWS, Google y Azure están estandarizando (en inglés), sobre cómo esos mismos tres proveedores están estandarizando otra capa de la nube.