

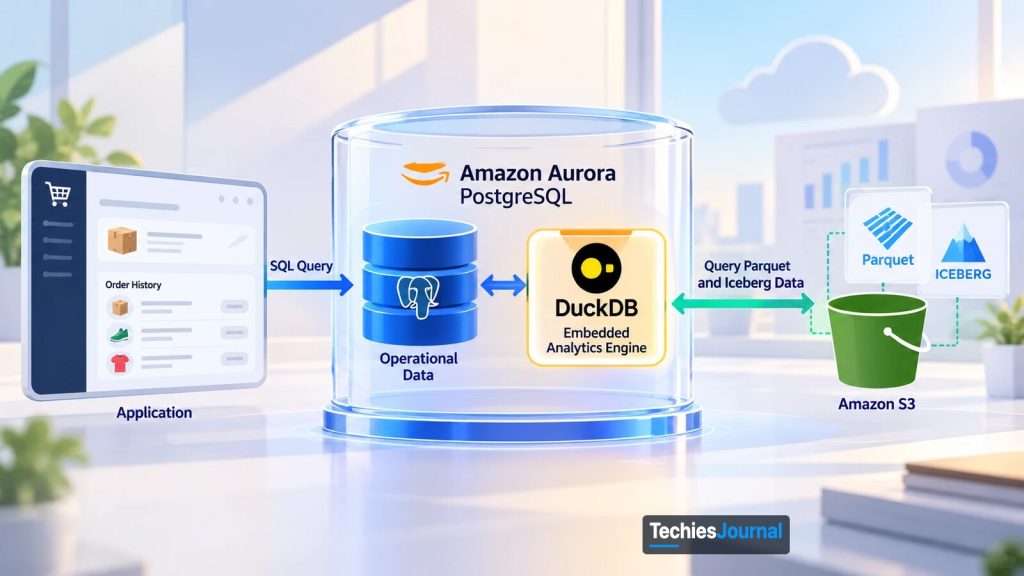
సారాంశ చిత్రం. ఇది ఆర్కిటెక్చర్ను చూపించడానికి యజమాని అందించిన ఇలస్ట్రేషన్. చిత్రంలోని లేబుళ్లు ఆంగ్లంలో ఉన్నాయి.
Amazon Aurora PostgreSQL ఇప్పుడు ఎంబెడెడ్ DuckDB ఇంజిన్ను ఉపయోగించి Amazon S3 లో నిల్వ ఉన్న చారిత్రక డేటాను క్వెరీ చేయగలదు. ఈ పరిణామం అప్లికేషన్లు ఆపరేషనల్ డేటాబేస్లు, డేటా లేక్ల మధ్య డేటాను ఎలా యాక్సెస్ చేస్తాయో మారుస్తుంది, డేటా ఇంజనీరింగ్ విస్తృత పనిని భర్తీ చేయకుండానే కొన్ని డేటా-కాపీయింగ్ ప్రక్రియలను తొలగించే అవకాశం ఇస్తుంది.
అప్లికేషన్కు రెండు చోట్ల నుంచి డేటా అవసరమైనప్పుడు
కొన్ని సంవత్సరాలుగా ఆన్లైన్ స్టోర్ను నడుపుతున్న ఒక కల్పిత రిటైల్ వ్యాపారాన్ని ఊహించండి. దాని అప్లికేషన్ కస్టమర్లను, ఆర్డర్లను, చెల్లింపులను నిర్వహించడానికి Amazon Aurora PostgreSQL ను ఉపయోగిస్తుంది. ఈ రికార్డులు రోజంతా మారుతూ ఉంటాయి. కస్టమర్ ఆర్డర్ చేసినప్పుడు, డేటాబేస్ ఆ లావాదేవీని నమ్మదగిన విధంగా సేవ్ చేయాలి, అప్డేట్ అయిన సమాచారాన్ని అప్లికేషన్కు అందుబాటులో ఉంచాలి.
ఆ వ్యాపారం అనేక సంవత్సరాల చారిత్రక లావాదేవీలను కూడా Amazon S3 లో ఉంచుతుంది. ఆ రికార్డులు అరుదుగా మాత్రమే మారతాయి, అయినా కస్టమర్ విచారణలకు, రిపోర్టింగ్కు, కొనుగోలు తీరులను అర్థం చేసుకోవడానికి ఉపయోగపడతాయి. అప్లికేషన్కు రెండు సిస్టమ్ల నుంచీ సమాచారం అవసరమయ్యే వరకు ఈ ఏర్పాటు బాగానే పనిచేస్తుంది.
మూడు సంవత్సరాల క్రితం కొన్న ఉత్పత్తి గురించి ఒక కస్టమర్ సపోర్ట్ టీమ్ను సంప్రదించారనుకోండి. ఇటీవలి ఆర్డర్లు Aurora లో ఉన్నాయి, కానీ పాత కొనుగోలు రికార్డు S3 లో ఉంది. ఆ సమాచారాన్ని సపోర్ట్ అప్లికేషన్ ప్రస్తుత వ్యూలోకి తీసుకురావాల్సిన అవసరం ఇంజనీరింగ్ టీమ్కు ఉంది.
ఒక మార్గం, చారిత్రక లావాదేవీలను S3 నుంచి Aurora లోకి కాపీ చేసే ప్రక్రియను నిర్వహించడం. కాపీ అయ్యాక, అప్లికేషన్ వాటిని ప్రస్తుత ఆర్డర్లతో కలిపి PostgreSQL ద్వారా క్వెరీ చేయవచ్చు. ఇది పనిచేస్తుంది, కానీ బాధ్యతలు పెరుగుతాయి: టీమ్ ఆ కాపీయింగ్ ప్రక్రియను నిర్వహించాలి, వైఫల్యాలను చూసుకోవాలి, డూప్లికేట్ స్టోరేజ్ను నిర్వహించాలి, కాపీ చేసిన సమాచారాన్ని మూలంతో ఒకే విధంగా ఉంచాలి.
మరొక మార్గం, చారిత్రక రికార్డులను ప్రత్యేక అనలిటికల్ సర్వీస్ ద్వారా క్వెరీ చేసి, ఫలితాలను అప్లికేషన్లో కలపడం. దీనివల్ల డేటాను Aurora లోకి కాపీ చేయాల్సిన అవసరం ఉండదు, కానీ మరొక సర్వీస్, ఇంటిగ్రేషన్ వచ్చి చేరతాయి.
ఈ రెండు పద్ధతుల్లో ఏదీ సహజంగా తప్పు కాదు. కానీ అవసరం కేవలం ఒక కస్టమర్ కొనుగోలు చరిత్రను తీసుకురావడమే అయినప్పుడు, అదనపు డేటా తరలింపు లేదా ఇంటిగ్రేషన్ ఆ ఫీచర్కు అవసరమైన దానికంటే ఎక్కువ పని కావచ్చు. Amazon ఇటీవలి Aurora పరిణామం వెనుక ఉన్న సమస్య ఇదే.
DuckDB అంటే ఏమిటి, Aurora లో ఏం మారింది
DuckDB అనేది అనలిటికల్ ప్రాసెసింగ్ కోసం రూపొందించిన ఓపెన్-సోర్స్ డేటాబేస్. సాధారణంగా ప్రత్యేక సర్వీస్లుగా నడిచే సంప్రదాయ డేటాబేస్ సర్వర్లకు భిన్నంగా, DuckDB నేరుగా అప్లికేషన్ లేదా అనలిటికల్ టూల్ లోపలే నడవగలదు. డెవలపర్లు, అనలిస్ట్లు దీన్ని Python వంటి భాషల నుంచి Parquet ఫైల్లను, Amazon S3 వంటి క్లౌడ్ ఆబ్జెక్ట్ స్టోరేజ్లో ఉన్న డేటాను క్వెరీ చేయడానికి వాడుతున్నారు. మూలం: DuckDB, Why DuckDB.
ఇది అనలిటికల్ క్వెరీలను సమర్థవంతంగా ప్రాసెస్ చేస్తుంది, ముఖ్యంగా నిలువు వరుసల (columns) ప్రకారం అమర్చిన పెద్ద డేటాసెట్లతో పనిచేసేటప్పుడు. ఈ లాంచ్కు ముందు, Aurora తో పాటు DuckDB ను కూడా వాడాలనుకున్న అప్లికేషన్ దాన్ని విడిగా నడిపి, ఇంటిగ్రేట్ చేసుకోవాల్సి వచ్చేది. DuckDB ను Aurora లో ఎంబెడ్ చేయడం వల్ల అనలిటికల్ ఇంజిన్ PostgreSQL వాతావరణంలోకి వస్తుంది, అప్లికేషన్ ఇప్పటికే వాడుతున్న డేటాబేస్ కనెక్షన్ ద్వారానే సపోర్ట్ ఉన్న బాహ్య డేటాసెట్లను క్వెరీ చేయడానికి వీలవుతుంది.
September 30, 2026 నాడు, Amazon Aurora PostgreSQL లో Apache Iceberg, Parquet డేటాను నేరుగా క్వెరీ చేసే సామర్థ్యం సాధారణ అందుబాటులోకి వచ్చిందని AWS ప్రకటించింది. ఈ సామర్థ్యం Aurora PostgreSQL 17.11, 18.6 మరియు ఆపై వెర్షన్లలో, అన్ని AWS కమర్షియల్ మరియు GovCloud (US) Region లలో, అదనపు ఛార్జీ లేకుండా సపోర్ట్ చేస్తుంది. మూలం: AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data.
ఈ మార్పును అర్థం చేసుకోవడానికి, ఇందులో ఉన్న టెక్నాలజీల పాత్రలను వేరు చేసి చూడటం ఉపయోగపడుతుంది. Aurora PostgreSQL ఆపరేషనల్ డేటాబేస్గానే ఉంటుంది. ప్రస్తుత ఆర్డర్లు, కస్టమర్ సమాచారం వంటి, అప్లికేషన్లు తరచుగా చదివే, ఇన్సర్ట్ చేసే, అప్డేట్ చేసే రికార్డులను అది నిర్వహిస్తుంది.
Amazon S3 చారిత్రక డేటాను నిల్వ చేస్తుంది. ఉదాహరణలో, పాత లావాదేవీలు Parquet ఫైల్లుగా సేవ్ అయి ఉండవచ్చు. Parquet డేటాను నిలువు వరుసల ప్రకారం అమరుస్తుంది, దాంతో అనలిటికల్ సిస్టమ్లు ప్రతి రికార్డులోని ప్రతి ఫీల్డ్నూ చదవకుండా ఎంచుకున్న ఫీల్డ్లను మాత్రమే చదవగలవు. Amazon S3 Tables, AWS Glue Data Catalog లను చూపేలా కూడా ఫారిన్ టేబుల్లను AWS అనుమతిస్తుంది, కానీ ఆలోచనను అర్థం చేసుకోవడానికి రిటైలర్ S3 ఫైల్లు సరిపోతాయి.
Apache Iceberg డేటా ఫైల్లపై టేబుల్-మేనేజ్మెంట్ సామర్థ్యాలను అందిస్తుంది. ఇది డేటాసెట్ను, కాలక్రమేణా దానిలో వచ్చే మార్పులను వివరించే మెటాడేటాను నిర్వహిస్తుంది, పెద్ద డేటా సముదాయాలతో అనలిటికల్ సిస్టమ్లు స్థిరంగా పనిచేయడానికి తోడ్పడుతుంది. DuckDB అనలిటికల్ క్వెరీ ప్రాసెసింగ్ చేస్తుంది. కొత్త Aurora ఇంటిగ్రేషన్తో, అప్లికేషన్లు PostgreSQL ను వాడుతూనే, సపోర్ట్ ఉన్న Parquet, Iceberg డేటాను అది చదవగలదు.
అప్లికేషన్ క్వెరీ చేయాలనుకుంటోంది కాబట్టి మాత్రమే చారిత్రక రికార్డులు Aurora లోకి తరలాల్సిన అవసరం లేదు. మారేది, ఆ రికార్డులను అప్లికేషన్ యాక్సెస్ చేసే మార్గం మాత్రమే.
కస్టమర్-హిస్టరీ క్వెరీ ఎలా నడుస్తుంది
రిటైలర్ సపోర్ట్ అప్లికేషన్కు తిరిగి వెళ్దాం. S3 లో ఉన్న చారిత్రక ఆర్డర్లను సూచించే ఫారిన్ టేబుల్ను ఇంజనీరింగ్ టీమ్ Aurora లో సృష్టిస్తుంది. ఫారిన్ టేబుల్ అంటే డేటాబేస్ బయట నిల్వ ఉన్న డేటాను చూపే PostgreSQL టేబుల్ నిర్వచనం. ఇది కాలమ్ల గురించి, బాహ్య మూలం గురించి సమాచారం ఇస్తుంది, కానీ అంతర్లీన రికార్డులను సాధారణ Aurora స్టోరేజ్లోకి కాపీ చేయాల్సిన అవసరం ఉండదు.
ఇప్పుడు అప్లికేషన్కు PostgreSQL ద్వారా రెండు రకాల టేబుల్లు అందుబాటులో ఉన్నాయి: ప్రస్తుత ఆర్డర్లు ఉన్న నేటివ్ టేబుల్లు, S3 లోని చారిత్రక రికార్డులను సూచించే ఫారిన్ టేబుల్లు.
ఒక కస్టమర్ కొనుగోలు చరిత్రను సపోర్ట్ అప్లికేషన్ అడిగినప్పుడు, అది తన సాధారణ Aurora కనెక్షన్ ద్వారా ఒక SQL క్వెరీని సమర్పిస్తుంది. PostgreSQL ఆ క్వెరీని పార్స్ చేసి ప్లాన్ చేస్తుంది, తర్వాత అమలును ఎంబెడెడ్ DuckDB ఇంజిన్కు అప్పగిస్తుంది, అది S3 నుంచి సంబంధిత డేటాను చదువుతుంది. ఫారిన్ టేబుల్లు, లోకల్ PostgreSQL టేబుల్ల మధ్య జాయిన్లతో సహా మొత్తం ప్లాన్లను ఆ ఇంజిన్కు పుష్ డౌన్ చేయవచ్చని AWS తెలిపింది. క్వెరీ సాధారణ PostgreSQL రోలను తిరిగి ఇస్తుంది, అలాంటి క్వెరీలు ఒకే ప్రాసెస్లో నడుస్తాయని, ఇతర PostgreSQL క్వెరీ లాగే సెషన్ ట్రాన్సాక్షన్లలో పాల్గొంటాయని AWS తెలిపింది.
ఒక కస్టమర్-హిస్టరీ క్వెరీని అనుసరించండి
క్వెరీ ఎక్కడ ఉందో, అక్కడ ఏం జరుగుతుందో చూడటానికి ఒక స్టెప్ను ఎంచుకోండి.
Aurora PostgreSQL
సపోర్ట్ అప్లికేషన్ ఒక సాధారణ SQL క్వెరీని పంపుతుంది. అది తన ప్రస్తుత డ్రైవర్ను, కనెక్షన్ను వాడుతూనే ఉంటుంది.
Aurora PostgreSQL
PostgreSQL క్వెరీని పార్స్ చేసి ప్లాన్ చేస్తుంది, తర్వాత అమలును ఎంబెడెడ్ DuckDB ఇంజిన్కు అప్పగిస్తుంది. ఫారిన్, నేటివ్ టేబుల్ల మధ్య జాయిన్లతో సహా మొత్తం ప్లాన్లను ఆ ఇంజిన్కు పుష్ డౌన్ చేయవచ్చని AWS తెలిపింది.
Aurora PostgreSQL
క్లస్టర్కు జోడించిన IAM రోల్ను ఉపయోగించి, DuckDB S3 నుంచి తనకు అవసరమైన బైట్ రేంజ్లను మాత్రమే చదువుతుంది. కాలమ్ ప్రూనింగ్, ఫిల్టర్లు క్వెరీ ప్రస్తావించని డేటాను దాటవేస్తాయి.
Aurora PostgreSQL
తరచుగా యాక్సెస్ చేసే డేటా ఇన్స్టెన్స్ లోకల్ స్టోరేజ్లో కాష్ అవుతుంది, సెషన్ల మధ్య పంచుకోబడుతుంది, కాబట్టి పునరావృత క్వెరీలు S3 ని తప్పించుకోవచ్చు. ఇన్స్టెన్స్ రీస్టార్ట్ అయినప్పుడు లేదా ఫెయిల్ఓవర్ అయినప్పుడు కాష్ క్లియర్ అవుతుంది.
Aurora PostgreSQL
ఫలితాలు సాధారణ PostgreSQL వరుసలుగా తిరిగి వస్తాయి. ఫారిన్, నేటివ్ టేబుల్లను జాయిన్ చేసే క్వెరీలు ఒకే ప్రాసెస్లో నడుస్తాయని, సెషన్ ట్రాన్సాక్షన్లలో పాల్గొంటాయని AWS తెలిపింది.
ఈ సామర్థ్యం ఎలా పనిచేస్తుందో AWS వివరణకు సరళీకృత రూపం. ఇది పనితీరు మోడల్ కాదు.
ఫారిన్-టేబుల్ నిర్వచనం Aurora లోపల ఉంటుంది, చారిత్రక డేటా S3 లోనే ఉంటుంది. క్వెరీకి సమాధానం ఇచ్చే ముందు Aurora మొత్తం చారిత్రక డేటాసెట్ను దిగుమతి చేసుకోవడం లేదు. సపోర్ట్ ఉన్న ఆపరేషన్ల కోసం, ఇంజిన్ తనకు అవసరమైన బైట్ రేంజ్లను మాత్రమే చదువుతుంది, క్వెరీ ప్రస్తావించని కాలమ్లను, ఫిల్టర్కు సరిపోలలేని స్టాటిస్టిక్స్ ఉన్న ఫైల్లను దాటవేస్తుంది. తరచుగా యాక్సెస్ చేసే డేటాను ఇన్స్టెన్స్ లోకల్ స్టోరేజ్లో కాష్ చేసి, సెషన్ల మధ్య పంచుకుంటారు.
అసలు పని క్వెరీపై, దాని ఎగ్జిక్యూషన్ ప్లాన్పై ఆధారపడి ఉంటుంది, కానీ ఈ రకమైన అభ్యర్థనకు అప్లికేషన్కు ప్రత్యేక డేటా-కాపీయింగ్ ప్రక్రియ లేదా అనలిటికల్-సర్వీస్ కనెక్షన్ ఇక అవసరం ఉండకపోవచ్చు. మూలం: AWS, how Aurora analytical querying works.
ఈ విధానానికి ఒక ముఖ్యమైన పరిమితి ఉంది: ఫారిన్ టేబుల్లు రీడ్-ఓన్లీ. అవి అప్లికేషన్లు బాహ్య డేటాను క్వెరీ చేయడానికి అనుమతిస్తాయి, కానీ వాటిపై INSERT, UPDATE, DELETE, TRUNCATE, COPY FROM సపోర్ట్ చేయవు.
డేటాను మార్చడానికి, S3 లోని సోర్స్ ఫైల్లను లేదా AWS Glue ద్వారా లేదా ఇతర టూల్స్ ద్వారా Iceberg టేబుల్ను అప్డేట్ చేయాలి. రిటైలర్ చారిత్రక కొనుగోలు రికార్డులకు రీడ్-ఓన్లీ యాక్సెస్ సరిపోవచ్చు. ఇతర అప్లికేషన్లకు వేరే డిజైన్ అవసరం కావచ్చు.
డేటా పైప్లైన్ ఎక్కడ సరళమవుతుంది
రిటైలర్ తన చారిత్రక-డేటా కాపీయింగ్ ప్రక్రియను ఒకే కారణంతో సృష్టించి ఉండవచ్చు: పాత లావాదేవీల PostgreSQL-యాక్సెస్ చేయగల కాపీ సపోర్ట్ అప్లికేషన్కు అవసరమైంది. Aurora డైరెక్ట్-క్వెరీ సామర్థ్యం అప్లికేషన్ పనితీరు, విశ్వసనీయత అవసరాలను తీరిస్తే, ఆ కాపీయింగ్ ప్రక్రియ ఇక అవసరం లేకపోవచ్చు. వ్యాపారం తన చారిత్రక డేటాను S3 లో ఉంచుకుని, ఫారిన్ టేబుల్ల ద్వారా అందుబాటులోకి తెచ్చి, అదనపు Aurora కాపీని తొలగించవచ్చు.
Aurora లోకి కాపీ చేయండి, లేదా అక్కడికక్కడే క్వెరీ చేయండి
టీమ్ ఏం నడపాలో పోల్చడానికి రెండు డిజైన్ల మధ్య మారండి.
టీమ్ నడిపేవి, నిర్వహించేవి
- కాపీయింగ్ ప్రక్రియ, దాని వైఫల్య నిర్వహణ
- కాపీ చేసిన చరిత్ర కోసం డూప్లికేట్ స్టోరేజ్
- కాపీని మూలంతో ఒకే విధంగా ఉంచడం
అప్లికేషన్ కాపీ చేసిన చరిత్రను, ప్రస్తుత ఆర్డర్లతో పాటు, PostgreSQL ద్వారా క్వెరీ చేస్తుంది.
టీమ్ నడిపేవి, నిర్వహించేవి
- ఫారిన్-టేబుల్ నిర్వచనం, S3 కి యాక్సెస్
- ప్రాతినిధ్య క్వెరీలపై పనితీరు, వనరుల వినియోగాన్ని పరీక్షించడం
- Aurora CPU, మెమరీ, కాష్ హిట్ రేషియో, S3 రీడ్లను పర్యవేక్షించడం, అవసరమైతే ప్రత్యేక రీడర్
- శుభ్రమైన డేటాను సిద్ధం చేసి S3 లో ఉంచే ప్రక్రియ (ఈ సామర్థ్యం దాన్ని భర్తీ చేయదు)
చరిత్ర S3 లోనే ఉంటుంది, అప్లికేషన్ దాన్ని PostgreSQL ద్వారా చదువుతుంది. ఇది సరళమా కాదా అనేది కొలిచిన పనితీరు, ఖర్చుపై ఆధారపడి ఉంటుంది.
ఉదాహరణ కోసం మాత్రమే, వ్యాసంలోని కల్పిత రిటైలర్కు సంబంధించినది. కాపీని తొలగించవచ్చా అనేది పరీక్షపై ఆధారపడి ఉంటుంది.
కానీ పైప్లైన్ డేటాను కాపీ చేయడం కంటే ఎక్కువ చేస్తున్నప్పుడు పరిస్థితి మారుతుంది. అదే రిటైలర్ తన వెబ్సైట్ నుంచి, భౌతిక స్టోర్ల నుంచి, బాహ్య మార్కెట్ప్లేస్ల నుంచి లావాదేవీలు అందుకుంటుందనుకోండి. ఈ సిస్టమ్లు వేర్వేరు కస్టమర్ ఐడెంటిఫైయర్లు, ఉత్పత్తి కోడ్లు, లావాదేవీ ఫార్మాట్లను వాడవచ్చు. ఆ తేడాలను సమన్వయం చేయడం, అస్థిరమైన రికార్డులను సరిచేయడం, నమ్మదగిన సమాచారాన్ని సిద్ధం చేయడం ఇంజనీరింగ్ టీమ్ ఇప్పటికీ చేయాలి.
ఫలితంగా వచ్చిన డేటాను క్వెరీ చేయగలదు కాబట్టి మాత్రమే DuckDB ఆ వ్యాపార ట్రాన్స్ఫర్మేషన్లను ఆటోమేటిక్గా చేయదు. చారిత్రక రికార్డులను S3 లో ఉంచే ప్రక్రియ కూడా అవసరంగానే ఉండవచ్చు.
కొత్త సామర్థ్యం సిద్ధం చేసిన బాహ్య డేటాను Aurora ఎలా యాక్సెస్ చేస్తుందనే విషయాన్ని పరిష్కరిస్తుంది. ఆ డేటాను సేకరించడం, ధ్రువీకరించడం, ట్రాన్స్ఫర్మ్ చేయడం, గవర్న్ చేయడం అనే పూర్తి ప్రక్రియను అది భర్తీ చేయదు.
Azure, Google Cloud ఇదే సమస్యను ఎలా సమీపిస్తున్నాయి
ఆపరేషనల్, అనలిటికల్ సిస్టమ్ల మధ్య యాక్సెస్ను సరళం చేస్తున్న ఏకైక ప్రొవైడర్ AWS కాదు, కానీ ఆర్కిటెక్చర్లు భిన్నంగా ఉంటాయి. Microsoft Azure, Azure Database for PostgreSQL డేటాను Microsoft Fabric యొక్క OneLake లోకి మిర్రర్ చేయడాన్ని సపోర్ట్ చేస్తుంది, అక్కడ నిరంతరం రెప్లికేట్ అయ్యే కాపీ సంక్లిష్టమైన ETL లేకుండా అనలిటిక్స్ కోసం అందుబాటులోకి వస్తుందని Microsoft తెలిపింది. Google Cloud, BigQuery ఫెడరేటెడ్ క్వెరీలను అందిస్తుంది, అవి BigQuery నుంచి Cloud SQL, AlloyDB లేదా Spanner కు క్వెరీని పంపి, ఫలితాన్ని తాత్కాలిక టేబుల్గా తిరిగి ఇస్తాయి, ఆ డేటాను ముందుగా BigQuery స్టోరేజ్లోకి లోడ్ చేయాల్సిన అవసరం ఉండదు.
సపోర్ట్ ఉన్న బాహ్య లేక్ డేటాను క్వెరీ చేయడానికి PostgreSQL లోపల DuckDB ను ఎంబెడ్ చేయడం ద్వారా Aurora మూడో మార్గం తీసుకుంటుంది. ఇవి డేటా-యాక్సెస్ సమస్యలకు సంబంధిత పరిష్కారాలు, పరస్పరం మార్చుకోగల ఇంప్లిమెంటేషన్లు కావు.
| ప్రొవైడర్ | విధానం | అనలిటికల్ క్వెరీ ఎక్కడ నడుస్తుంది | డేటా కాపీ అవుతుందా? |
|---|---|---|---|
| AWS | Parquet, Iceberg డేటాపై Aurora PostgreSQL ఫారిన్ టేబుల్లు | Aurora క్లస్టర్ లోపల, ఎంబెడెడ్ DuckDB ఇంజిన్లో | Aurora టేబుల్లలోకి కాదు. డేటా అక్కడికక్కడే చదవబడుతుంది, తరచుగా వాడే డేటా ఇన్స్టెన్స్పై కాష్ అవుతుంది |
| Microsoft Azure | Azure Database for PostgreSQL ను Microsoft Fabric లోకి మిర్రరింగ్ | Fabric లో, OneLake లోని రెప్లికేట్ కాపీపై | అవును, సర్వీస్ నిరంతరం రెప్లికేట్ చేస్తుంది |
| Google Cloud | Cloud SQL, AlloyDB లేదా Spanner కు BigQuery ఫెడరేటెడ్ క్వెరీలు | స్టేట్మెంట్ సోర్స్ డేటాబేస్పై నడుస్తుంది, BigQuery ఫలితాన్ని అందుకుంటుంది | శాశ్వతంగా కాదు. ఫలితాలు తాత్కాలిక టేబుల్గా తిరిగి వస్తాయి, BigQuery స్టోరేజ్ చదవడం కంటే పనితీరు తక్కువగా ఉండవచ్చని Google పేర్కొంది |
ఎంపిక కేవలం ఫీచర్లకు సంబంధించినది కాదని ఈ పట్టిక చూపిస్తుంది. ప్రతి మార్గం అనలిటికల్ పనిని వేర్వేరు చోట్ల ఉంచుతుంది. మూలాలు: Microsoft, PostgreSQL mirroring in Fabric మరియు Google Cloud, BigQuery federated queries.
Aurora లోపల అనలిటిక్స్ నడపడంలోని పరిమితులు
డైరెక్ట్ క్వెరీయింగ్ అప్లికేషన్ను సరళం చేయగలదు, కానీ అనలిటికల్ వర్క్లోడ్లకు ఆపరేషనల్ పర్యవసానాలు లేకుండా చేయదు. ప్రతిస్పందన సమయం ముఖ్యమైన లావాదేవీలకు Aurora తరచుగా బాధ్యత వహిస్తుంది. అప్లికేషన్ సాధారణ ట్రాఫిక్ను అందిస్తున్నప్పుడు ఆర్డర్లు, చెల్లింపులు నమ్మదగిన విధంగా పూర్తవుతాయని కస్టమర్లు ఆశిస్తారు.
అనలిటికల్ క్వెరీలు వేరే విధంగా ప్రవర్తిస్తాయి. అవి పెద్ద డేటాసెట్లను చదవవచ్చు, సంక్లిష్టమైన లెక్కలు చేయవచ్చు, గణనీయమైన మెమరీని లేదా ప్రాసెసింగ్ వనరులను వాడవచ్చు. DuckDB అనలిటికల్ ప్రాసెసింగ్ కోసం ఆప్టిమైజ్ చేయబడినప్పటికీ, దాని ఎంబెడెడ్ ఎగ్జిక్యూషన్ Aurora డేటాబేస్ క్లస్టర్ లోపలి కంప్యూటింగ్ వనరులను వాడుతుంది.
అప్పుడప్పుడు చేసే కస్టమర్-హిస్టరీ లుకప్కు డైరెక్ట్ క్వెరీయింగ్ తగినది కావచ్చు. అనేక సంవత్సరాల లావాదేవీలను స్కాన్ చేసే వందలాది ఏకకాల రిపోర్ట్లు వేరే రకమైన వర్క్లోడ్ను సృష్టించవచ్చు, అది CPU, మెమరీ కోసం అప్లికేషన్ సాధారణ కార్యకలాపాలతో పోటీ పడుతుంది.
ఫారిన్ టేబుల్లను ఎక్కువగా క్వెరీ చేసే వర్క్లోడ్లు ప్రొడక్షన్ లావాదేవీలతో కలిపి కాకుండా ప్రత్యేక రీడర్ ఇన్స్టెన్స్పై నడపాలనేది AWS మార్గదర్శకం. లోకల్ NVMe స్టోరేజ్ ఉన్న ఇన్స్టెన్స్లు, EBS-మాత్రమే ఉన్న ఇన్స్టెన్స్ల కంటే వేగంగా కాష్ చేసి స్పిల్ చేస్తాయని కూడా అది పేర్కొంటుంది. మూలం: AWS, choosing the right DB instance class.
ఇతర పరిమితులు కూడా ముఖ్యమే. JSONB, SERIAL, అరే టైప్లతో సహా కొన్ని PostgreSQL డేటా టైప్లకు సపోర్ట్ ఉన్న మ్యాపింగ్ లేదని AWS పేర్కొంది. ఒకే క్వెరీ ఒకటి కంటే ఎక్కువ AWS Region ల నుంచి S3 డేటాను చదవలేదు, అయితే డేటా క్లస్టర్ Region కంటే వేరే Region లో ఉండవచ్చు.
ఇన్స్టెన్స్ రీస్టార్ట్ అయినప్పుడు లేదా ఫెయిల్ఓవర్ అయినప్పుడు ఆన్-డిస్క్ కాష్ క్లియర్ అవుతుంది, కాబట్టి తర్వాతి క్వెరీలు S3 నుంచి మళ్లీ చదువుతాయి. Aurora Serverless v2 లో, ఒకేసారి అనేక భారీ అనలిటికల్ క్వెరీలు ఇన్స్టెన్స్ స్కేల్ అప్ అయ్యే వేగాన్ని మించిపోవచ్చు. మూలం: AWS, Aurora analytics limitations.
ఖర్చును కూడా ఇదే విధంగా మూల్యాంకనం చేయాలి. ఈ సామర్థ్యానికి మాత్రమే అదనపు ఛార్జీ లేదని AWS ప్రకటన పేర్కొంటుంది. అనలిటికల్ క్వెరీలు Aurora వనరులను వినియోగిస్తూనే ఉంటాయి, S3 నుంచి డేటా చదివినప్పుడు రిక్వెస్ట్లు, ఏదైనా డేటా ట్రాన్స్ఫర్ వంటి వర్తించే Amazon S3 ఛార్జీలు పడవచ్చు.
డేటా-కాపీయింగ్ ప్రక్రియను తొలగించడం స్టోరేజ్, నిర్వహణ ఖర్చులను తగ్గించవచ్చు. కానీ డైరెక్ట్ అనలిటికల్ క్వెరీలకు పెద్ద Aurora ఇన్స్టెన్స్లు లేదా ప్రత్యేక రీడర్లు అవసరమైతే, మొత్తం ఆర్థిక ప్రయోజనం వేరేగా ఉండవచ్చు. ప్రాతినిధ్య వర్క్లోడ్ను పరీక్షించకుండా తక్కువ ఖర్చును గానీ మెరుగైన పనితీరును గానీ ఊహించకూడదు.
ఇప్పటికే ఉన్న అప్లికేషన్కు ఇది ఏమిటి అర్థం
రిటైలర్కు, ఇంజనీరింగ్ నిర్ణయం ఇప్పుడు మరింత కేంద్రీకృతమైంది. టీమ్ తన మొత్తం డేటా ప్లాట్ఫామ్ను మళ్లీ డిజైన్ చేయాల్సిన అవసరం లేదు. చారిత్రక-డేటా కాపీయింగ్ ప్రక్రియ ఎందుకు ఉందో పరిశీలించాలి.
ఆ ప్రక్రియ కేవలం S3 లోని క్వెరీకి సిద్ధంగా ఉన్న రికార్డులను Aurora ద్వారా అందుబాటులోకి తేవడానికే ఉపయోగపడితే, కొత్త DuckDB ఇంటిగ్రేషన్ పరీక్షించదగిన ప్రత్యామ్నాయాన్ని అందిస్తుంది. వాస్తవిక కస్టమర్-హిస్టరీ అభ్యర్థనలను, ఊహించిన అప్లికేషన్ ట్రాఫిక్ను ఉపయోగించి, ప్రస్తుత విధానాన్ని డైరెక్ట్ ఫారిన్-టేబుల్ క్వెరీలతో టీమ్ పోల్చవచ్చు. ఇది కొలవాలి:
- కస్టమర్-హిస్టరీ క్వెరీ ప్రతిస్పందన సమయాలు, ప్రస్తుత కాపీ చేసిన-టేబుల్ వెర్షన్తో పోల్చి.
- క్వెరీ నడుస్తున్నప్పుడు Aurora CPU, మెమరీ వినియోగం, Amazon CloudWatch లో AWS ప్రచురించే అనలిటిక్స్ మెమరీ, డిస్క్-స్పిల్ మెట్రిక్స్తో సహా.
- S3 రీడ్లు, కాష్ హిట్ రేషియో, ఇవి మొదటి క్వెరీల తర్వాత డేటాలో ఎంత భాగం లోకల్గా అందుతోందో చూపిస్తాయి.
- అదే సమయంలో నడిచే సాధారణ ఆర్డర్, చెల్లింపు లావాదేవీలపై ప్రభావం.
కాపీయింగ్ ప్రక్రియను తొలగించడం నిజంగా కార్యకలాపాలను సరళం చేస్తుందో లేదో ఫలితం నిర్ణయిస్తుంది. విస్తృత డేటా తయారీ, రిపోర్టింగ్ సిస్టమ్లు మారకుండా ఉండవచ్చు.
లేటెన్సీకి సున్నితమైన మార్గానికి డైరెక్ట్ క్వెరీలు చాలా నెమ్మదిగా ఉంటే, మధ్యస్థ ఎంపికను కూడా AWS వివరిస్తుంది: ETL పైప్లైన్ లేకుండా, ప్రామాణిక SQL తో Iceberg లేదా Parquet డేటాను నేటివ్ Aurora టేబుల్లలోకి మెటీరియలైజ్ చేయడం.
Aurora నుంచి చారిత్రక డేటాను ఎలా క్వెరీ చేయాలో ఎంచుకోండి
గరిష్ఠంగా మూడు ప్రశ్నలకు సమాధానం ఇవ్వండి. ఇది TechiesJournal నిర్ణయ సహాయకం, AWS మార్గదర్శకం కాదు, పూర్తి జాబితా కూడా కాదు.
ఫారిన్ టేబుల్ ద్వారా చారిత్రక రికార్డులను ఇన్సర్ట్, అప్డేట్ లేదా డిలీట్ చేయాల్సిన అవసరం మీకు ఉందా?
ఫారిన్ టేబుల్లు రీడ్-ఓన్లీ. S3 లోని సోర్స్ ఫైల్లను, లేదా AWS Glue ద్వారా లేదా ఇతర టూల్స్ ద్వారా Iceberg టేబుల్ను అప్డేట్ చేయండి, PostgreSQL ద్వారా మారాల్సిన డేటాకు వేరే డిజైన్ వాడండి.
ఫారిన్-టేబుల్ క్వెరీలు అప్పుడప్పుడు చేసే లుకప్లుగా కాకుండా, పెద్ద స్కాన్లు లేదా అనేక ఏకకాల రిపోర్ట్ల వంటి భారీ లేదా తరచు క్వెరీలుగా ఉంటాయా?
ఐసోలేషన్ కోసం ప్లాన్ చేయండి. భారీ ఫారిన్-టేబుల్ వర్క్లోడ్లను ప్రత్యేక రీడర్ ఇన్స్టెన్స్పై నడపాలనేది AWS మార్గదర్శకం, ప్రొడక్షన్ ఫారిన్-టేబుల్ వర్క్లోడ్ల కోసం లోకల్ NVMe స్టోరేజ్ ఉన్న క్లాస్ను అది సిఫార్సు చేస్తుంది. ప్రాతినిధ్య వర్క్లోడ్తో పరీక్షించండి.
పరీక్షలో, డైరెక్ట్ క్వెరీ సాధారణ ఆర్డర్ మార్గంలో మీ లేటెన్సీ లక్ష్యాన్ని అందుకుంటోందా?
ఫారిన్ టేబుల్ను కొనసాగించండి. Aurora CPU, మెమరీ, కాష్ హిట్ రేషియో, S3 రీడ్లను కొలుస్తూ ఉండండి, తర్వాత కాపీ ప్రక్రియను తొలగించవచ్చో నిర్ణయించండి.
మెటీరియలైజ్ చేయడాన్ని పరిగణించండి. లేటెన్సీకి సున్నితమైన వర్క్లోడ్ల కోసం, ETL పైప్లైన్ లేకుండా, ప్రామాణిక SQL తో Iceberg లేదా Parquet డేటాను నేటివ్ Aurora టేబుల్లలోకి లోడ్ చేయడాన్ని AWS వివరిస్తుంది. అది Aurora స్టోరేజ్లో మళ్లీ ఒక కాపీని ఉంచుతుంది, కాబట్టి దాన్ని తాజాగా ఉంచడం మీ బాధ్యత అవుతుంది (TechiesJournal గమనిక).
AWS పరిమితుల జాబితాను కూడా చూడండి: కొన్ని డేటా టైప్లకు సపోర్ట్ లేదు, ఒక క్వెరీ ఒకటి కంటే ఎక్కువ Region ల నుంచి S3 డేటాను చదవలేదు, ఒకేసారి అనేక భారీ క్వెరీలు వస్తే Aurora Serverless v2 తగినంత వేగంగా స్కేల్ అప్ కాకపోవచ్చు.
కాబట్టి Amazon Aurora ఎంబెడెడ్ DuckDB సామర్థ్యం అనలిటిక్స్ పైప్లైన్ల అంతానికి సూచిక కాదు. ఇది ఆపరేషనల్ డేటాబేస్లకు, చారిత్రక డేటా స్టోరేజ్కు మధ్య ఉన్న ఒక ముఖ్యమైన సరిహద్దును మారుస్తుంది. సపోర్ట్ ఉన్న వర్క్లోడ్ల కోసం, చారిత్రక రికార్డుల మరో కాపీని నిర్వహించకుండానే అప్లికేషన్లు ఇప్పుడు ప్రస్తుత, చారిత్రక సమాచారాన్ని PostgreSQL ద్వారా కలిపి తీసుకురాగలవు.
ఇకపై ప్రయోజనం లేని డేటా తరలింపును తొలగించడంలో, అదే సమయంలో వ్యాపారానికి ఇంకా అవసరమైన డేటా-ప్రాసెసింగ్, అనలిటికల్ సామర్థ్యాలను నిలుపుకోవడంలో విలువ ఉంది.
మరింత లోతుగా
పరిశోధన సమీక్షించిన తేదీ: October 21, 2026. రిటైల్ వ్యాపారం ఒక కల్పిత సందర్భం. స్వతంత్ర పనితీరు బెంచ్మార్క్ లేదా ఖర్చు పోలిక ఏదీ క్లెయిమ్ చేయడం లేదు.
AWS ప్రకటన, డాక్యుమెంటేషన్
- AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data, September 30, 2026, ఫీచర్ లభ్యత, సపోర్ట్ ఉన్న ఇంజిన్ వెర్షన్లు, Region లు.
- AWS, how Aurora analytical querying works, క్వెరీ ప్రాసెసింగ్, ఎంబెడెడ్ DuckDB, ఫారిన్ టేబుల్లు, డేటా-లేక్ ఇంటిగ్రేషన్.
- AWS, choosing the right DB instance class, మెమరీ, కాన్కరెన్సీ, వర్క్లోడ్ ఐసోలేషన్.
- AWS, Aurora analytics limitations, రీడ్-ఓన్లీ టేబుల్లు, డేటా టైప్లు, Region లు, కాష్ ప్రవర్తన.
నేపథ్యం, ఇతర క్లౌడ్ ప్రొవైడర్లు
- DuckDB, Why DuckDB, ఎంబెడెడ్ అనలిటికల్ ప్రాసెసింగ్, సాధారణ వినియోగ తీరులు.
- Microsoft, Azure Database for PostgreSQL mirroring in Fabric, ఆపరేషనల్ PostgreSQL డేటా OneLake లోకి ఎలా రెప్లికేట్ అవుతుంది.
- Google Cloud, Introduction to BigQuery federated queries, BigQuery నుంచి బాహ్య ఆపరేషనల్ డేటాబేస్లను క్వెరీ చేయడం.
TechiesJournalలో సంబంధిత రచనలు
- మల్టీక్లౌడ్ నెట్వర్కింగ్ ఒక క్లౌడ్ సర్వీస్గా మారుతోంది: AWS, Google, Azure ఏమి ప్రామాణికం చేస్తున్నాయి అదే మూడు ప్రొవైడర్లు క్లౌడ్లోని మరో పొరను ఎలా ప్రమాణీకరిస్తున్నాయో తెలుసుకోవడానికి.