

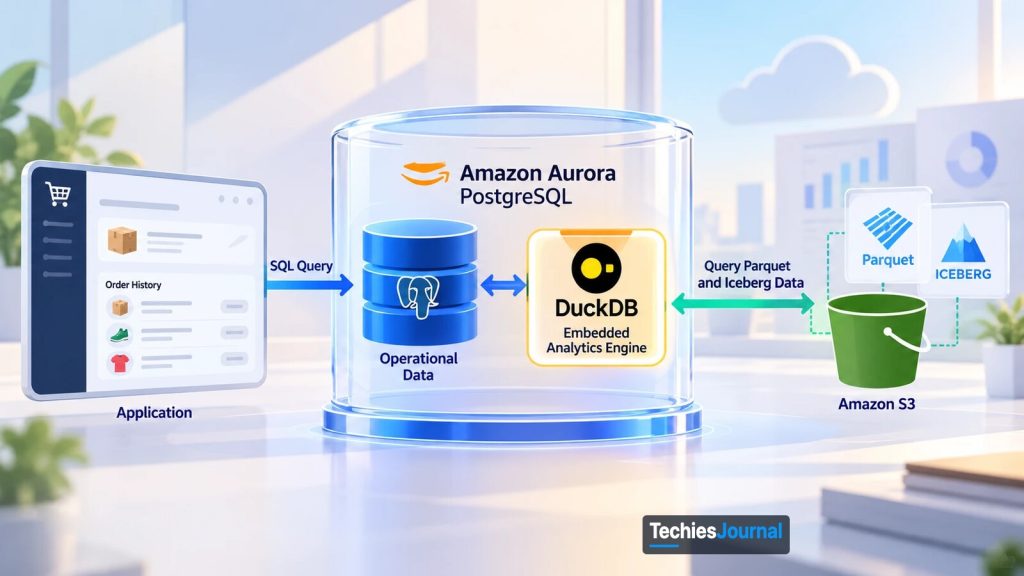
यह आर्किटेक्चर का चित्र मालिक द्वारा उपलब्ध कराया गया सार-चित्र है, और इसके लेबल अंग्रेज़ी में हैं।
Amazon Aurora PostgreSQL अब embedded DuckDB इंजन की मदद से Amazon S3 में रखे ऐतिहासिक डेटा पर क्वेरी चला सकता है। यह बदलाव बदलता है कि एप्लिकेशन ऑपरेशनल डेटाबेस और data lake के डेटा तक कैसे पहुँचते हैं। इससे डेटा कॉपी करने की कुछ प्रक्रियाएँ हट सकती हैं, लेकिन डेटा इंजीनियरिंग का व्यापक काम इससे खत्म नहीं होता।
जब एप्लिकेशन को दो जगहों से डेटा चाहिए
एक काल्पनिक रिटेल कंपनी की कल्पना कीजिए जो कई वर्षों से ऑनलाइन स्टोर चला रही है। उसका एप्लिकेशन ग्राहकों, ऑर्डर और भुगतान को सँभालने के लिए Amazon Aurora PostgreSQL का उपयोग करता है। ये रिकॉर्ड दिन भर बदलते रहते हैं। जब कोई ग्राहक ऑर्डर देता है, तो डेटाबेस को लेन-देन भरोसेमंद ढंग से सहेजना होता है और अद्यतन जानकारी एप्लिकेशन को उपलब्ध करानी होती है।
कंपनी कई वर्षों के पुराने लेन-देन का रिकॉर्ड Amazon S3 में भी रखती है। ये रिकॉर्ड शायद ही कभी बदले जाते हैं, लेकिन ग्राहकों की पूछताछ, रिपोर्टिंग और खरीदारी के पैटर्न समझने में काम आते हैं। यह व्यवस्था तब तक ठीक चलती है जब तक एप्लिकेशन को दोनों सिस्टम की जानकारी एक साथ नहीं चाहिए।
मान लीजिए कोई ग्राहक तीन साल पहले खरीदे गए उत्पाद के बारे में सपोर्ट टीम से संपर्क करता है। हाल के ऑर्डर Aurora में हैं, लेकिन पुराना खरीद रिकॉर्ड S3 में रखा है। इंजीनियरिंग टीम को वह जानकारी सपोर्ट एप्लिकेशन के मौजूदा व्यू में लानी होती है।
एक विकल्प यह है कि S3 से ऐतिहासिक लेन-देन को Aurora में कॉपी करने वाली एक प्रक्रिया चलाई जाए। कॉपी होने के बाद एप्लिकेशन उन्हें PostgreSQL के ज़रिए मौजूदा ऑर्डर के साथ क्वेरी कर सकता है। यह काम करता है, लेकिन इससे ज़िम्मेदारियाँ बढ़ती हैं। टीम को कॉपी करने की प्रक्रिया सँभालनी होती है, विफलताओं से निपटना होता है, दोहरे स्टोरेज का प्रबंधन करना होता है और कॉपी की गई जानकारी को स्रोत के अनुरूप रखना होता है।
दूसरा विकल्प यह है कि ऐतिहासिक रिकॉर्ड को किसी अलग analytical सेवा से क्वेरी किया जाए और नतीजों को एप्लिकेशन में जोड़ा जाए। इससे डेटा को Aurora में कॉपी करने की ज़रूरत नहीं पड़ती, लेकिन एक और सेवा और इंटीग्रेशन जुड़ जाता है।
इनमें से कोई भी तरीका अपने आप में गलत नहीं है। लेकिन जब ज़रूरत केवल किसी ग्राहक का खरीद इतिहास निकालने की हो, तब अतिरिक्त डेटा मूवमेंट या इंटीग्रेशन उस फ़ीचर की ज़रूरत से ज़्यादा काम हो सकता है। यही उस समस्या की पृष्ठभूमि है जिस पर Amazon का हालिया Aurora बदलाव आधारित है।
DuckDB क्या है और Aurora में क्या बदला
DuckDB एक ओपन-सोर्स डेटाबेस है जो analytical processing के लिए बनाया गया है। पारंपरिक डेटाबेस सर्वर आमतौर पर अलग सेवा के रूप में चलते हैं, जबकि DuckDB सीधे किसी एप्लिकेशन या analytical टूल के भीतर चल सकता है। डेवलपर और एनालिस्ट इसे Python जैसी भाषाओं से Parquet फ़ाइलों और Amazon S3 जैसे क्लाउड ऑब्जेक्ट स्टोरेज में रखे डेटा को क्वेरी करने के लिए इस्तेमाल करते रहे हैं। स्रोत: DuckDB, Why DuckDB।
यह analytical क्वेरी को कुशलता से प्रोसेस करता है, खासकर तब जब बड़े डेटासेट कॉलम के आधार पर व्यवस्थित हों। इस लॉन्च से पहले, जो एप्लिकेशन Aurora के साथ DuckDB भी चाहता, उसे DuckDB को अलग से चलाना और जोड़ना पड़ता। DuckDB को Aurora में embed करने से analytical इंजन PostgreSQL वातावरण के भीतर आ जाता है, और समर्थित बाहरी डेटासेट को उसी डेटाबेस कनेक्शन से क्वेरी किया जा सकता है जिसका एप्लिकेशन पहले से उपयोग करता है।
September 30, 2026 को AWS ने Amazon Aurora PostgreSQL में Apache Iceberg और Parquet डेटा की सीधी क्वेरी की general availability की घोषणा की। यह सुविधा Aurora PostgreSQL 17.11 और 18.6 तथा उससे ऊपर के संस्करणों पर, सभी AWS commercial और GovCloud (US) Regions में, बिना किसी अतिरिक्त शुल्क के समर्थित है। स्रोत: AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data।
इस बदलाव को समझने के लिए इसमें शामिल टेक्नोलॉजी की भूमिकाओं को अलग-अलग देखना मददगार है। Aurora PostgreSQL ऑपरेशनल डेटाबेस बना रहता है। यह उन रिकॉर्ड को सँभालता है जिन्हें एप्लिकेशन बार-बार पढ़ते, जोड़ते और अपडेट करते हैं, जैसे मौजूदा ऑर्डर और ग्राहक की जानकारी।
Amazon S3 ऐतिहासिक डेटा रखता है। उदाहरण में पुराने लेन-देन Parquet फ़ाइलों के रूप में सहेजे जा सकते हैं। Parquet डेटा को कॉलम के हिसाब से व्यवस्थित करता है, जिससे analytical सिस्टम हर रिकॉर्ड के हर फ़ील्ड को पढ़े बिना चुने हुए फ़ील्ड पढ़ सकते हैं। AWS foreign tables को Amazon S3 Tables और AWS Glue Data Catalog की ओर भी इंगित करने देता है, लेकिन इस विचार को समझने के लिए रिटेल कंपनी की S3 फ़ाइलें ही काफ़ी हैं।
Apache Iceberg डेटा फ़ाइलों के ऊपर table-management क्षमताएँ देता है। यह डेटासेट और समय के साथ उसमें हुए बदलावों का वर्णन करने वाला metadata सँभालता है, जिससे analytical सिस्टम डेटा के बड़े संग्रह के साथ एकरूपता से काम कर पाते हैं। DuckDB analytical क्वेरी प्रोसेसिंग करता है। नए Aurora इंटीग्रेशन के साथ यह समर्थित Parquet और Iceberg डेटा पढ़ सकता है, जबकि एप्लिकेशन PostgreSQL का ही उपयोग करते रहते हैं।
ऐतिहासिक रिकॉर्ड को सिर्फ़ इसलिए Aurora में ले जाने की ज़रूरत नहीं कि कोई एप्लिकेशन उन्हें क्वेरी करना चाहता है। जो बदलता है, वह है वह रास्ता जिससे एप्लिकेशन उन रिकॉर्ड तक पहुँचता है।
ग्राहक-इतिहास की क्वेरी कैसे चलती है
रिटेल कंपनी के सपोर्ट एप्लिकेशन पर लौटें। इंजीनियरिंग टीम Aurora में एक foreign table बनाती है जो S3 में रखे ऐतिहासिक ऑर्डर का प्रतिनिधित्व करती है। foreign table एक PostgreSQL table परिभाषा है जो डेटाबेस के बाहर रखे डेटा की ओर इंगित करती है। यह कॉलम और बाहरी स्रोत की जानकारी देती है, लेकिन इसके लिए ज़रूरी नहीं कि मूल रिकॉर्ड सामान्य Aurora स्टोरेज में कॉपी किए जाएँ।
अब एप्लिकेशन के पास PostgreSQL के ज़रिए दो तरह की tables हैं: मौजूदा ऑर्डर वाली native tables और S3 के ऐतिहासिक रिकॉर्ड का प्रतिनिधित्व करने वाली foreign tables।
जब सपोर्ट एप्लिकेशन किसी ग्राहक का खरीद इतिहास माँगता है, तो वह अपने सामान्य Aurora कनेक्शन से एक SQL क्वेरी भेजता है। PostgreSQL क्वेरी को parse और plan करता है, फिर execution को embedded DuckDB इंजन को सौंप देता है, जो S3 से संबंधित डेटा पढ़ता है। AWS के अनुसार पूरे plans, जिनमें foreign tables और स्थानीय PostgreSQL tables के बीच joins भी शामिल हैं, उस इंजन तक push down किए जा सकते हैं। क्वेरी सामान्य PostgreSQL rows लौटाती है, और AWS के अनुसार ऐसी क्वेरी एक ही process में चलती हैं और किसी भी अन्य PostgreSQL क्वेरी की तरह session के transactions में शामिल होती हैं।
एक ग्राहक-इतिहास क्वेरी को चरण दर चरण देखें
कोई चरण चुनें और देखें कि क्वेरी कहाँ है और वहाँ क्या होता है।
Aurora PostgreSQL
सपोर्ट एप्लिकेशन एक साधारण SQL क्वेरी भेजता है। वह अपना मौजूदा driver और कनेक्शन ही इस्तेमाल करता रहता है।
Aurora PostgreSQL
PostgreSQL क्वेरी को parse और plan करता है, फिर execution को embedded DuckDB इंजन को सौंप देता है। AWS के अनुसार पूरे plans, जिनमें foreign और native tables के बीच joins भी शामिल हैं, उस इंजन तक push down किए जा सकते हैं।
Aurora PostgreSQL
DuckDB क्लस्टर से जुड़ी IAM role का उपयोग करके S3 से सिर्फ़ ज़रूरी byte ranges पढ़ता है। Column pruning और filters उस डेटा को छोड़ देते हैं जिसका क्वेरी में उल्लेख नहीं है।
Aurora PostgreSQL
बार-बार उपयोग होने वाला डेटा instance के लोकल स्टोरेज पर cache किया जाता है और sessions के बीच साझा होता है, इसलिए दोहराई गई क्वेरी S3 से बच सकती हैं। instance के restart या failover होने पर cache साफ़ हो जाता है।
Aurora PostgreSQL
नतीजे सामान्य PostgreSQL rows के रूप में लौटते हैं। AWS के अनुसार foreign और native tables को जोड़ने वाली क्वेरी एक ही process में चलती हैं और session के transactions में शामिल होती हैं।
यह AWS के वर्णन पर आधारित इस क्षमता के काम करने का सरल चित्र है। यह परफ़ॉर्मेंस का मॉडल नहीं है।
foreign table की परिभाषा Aurora के भीतर रहती है, जबकि ऐतिहासिक डेटा S3 में ही रहता है। Aurora क्वेरी का जवाब देने से पहले पूरा ऐतिहासिक डेटासेट केवल आयात नहीं कर रहा होता। समर्थित ऑपरेशन के लिए इंजन सिर्फ़ ज़रूरी byte ranges पढ़ता है, उन कॉलम को छोड़ देता है जिनका क्वेरी में उल्लेख नहीं है, और उन फ़ाइलों को भी छोड़ देता है जिनके आँकड़े filter से मेल नहीं खा सकते। बार-बार उपयोग होने वाला डेटा instance के लोकल स्टोरेज पर cache किया जाता है और sessions के बीच साझा होता है।
असल काम क्वेरी और उसके execution plan पर निर्भर करता है, लेकिन इस तरह के अनुरोध के लिए एप्लिकेशन को अब ज़रूरी नहीं कि अलग डेटा-कॉपी प्रक्रिया या analytical-सेवा कनेक्शन चाहिए। स्रोत: AWS, how Aurora analytical querying works।
इस तरीके की एक अहम सीमा है: foreign tables केवल पढ़ने के लिए (read-only) हैं। ये एप्लिकेशन को बाहरी डेटा क्वेरी करने देती हैं, लेकिन इन पर INSERT, UPDATE, DELETE, TRUNCATE और COPY FROM समर्थित नहीं हैं।
डेटा बदलने के लिए S3 की स्रोत फ़ाइलें या AWS Glue अथवा अन्य टूल के ज़रिए Iceberg table अपडेट करनी होगी। रिटेल कंपनी के ऐतिहासिक खरीद रिकॉर्ड के लिए read-only पहुँच पर्याप्त हो सकती है। अन्य एप्लिकेशन को अलग डिज़ाइन चाहिए हो सकता है।
डेटा पाइपलाइन कहाँ सरल होती है
रिटेल कंपनी ने ऐतिहासिक डेटा कॉपी करने की अपनी प्रक्रिया शायद एक ही कारण से बनाई हो: सपोर्ट एप्लिकेशन को पुराने लेन-देन की ऐसी कॉपी चाहिए थी जिस तक PostgreSQL से पहुँचा जा सके। अगर Aurora की सीधी क्वेरी की क्षमता एप्लिकेशन की परफ़ॉर्मेंस और भरोसेमंदी की ज़रूरतें पूरी करती है, तो वह कॉपी प्रक्रिया शायद अब ज़रूरी न रहे। कंपनी अपना ऐतिहासिक डेटा S3 में रख सकती है, उसे foreign tables के ज़रिए उपलब्ध करा सकती है और Aurora की अतिरिक्त कॉपी हटा सकती है।
Aurora में कॉपी करें, या वहीं क्वेरी करें
दोनों डिज़ाइन के बीच बदलकर देखें कि टीम को क्या चलाना पड़ता है।
टीम क्या चलाती और सँभालती है
- कॉपी करने की प्रक्रिया और उसकी विफलताओं का प्रबंधन
- कॉपी किए गए इतिहास के लिए दोहरा स्टोरेज
- कॉपी को स्रोत के अनुरूप बनाए रखना
एप्लिकेशन कॉपी किए गए इतिहास को PostgreSQL के ज़रिए मौजूदा ऑर्डर के साथ क्वेरी करता है।
टीम क्या चलाती और सँभालती है
- foreign-table की परिभाषा और S3 तक पहुँच
- प्रतिनिधि क्वेरी पर परफ़ॉर्मेंस और संसाधन उपयोग का परीक्षण
- Aurora CPU, मेमोरी, cache hit ratio और S3 reads की निगरानी, और संभवतः एक समर्पित reader
- साफ़ डेटा तैयार करके S3 में रखने वाली प्रक्रिया (यह क्षमता उसकी जगह नहीं लेती)
इतिहास S3 में ही रहता है और एप्लिकेशन उसे PostgreSQL के ज़रिए पढ़ता है। यह सरल है या नहीं, यह मापी गई परफ़ॉर्मेंस और लागत पर निर्भर करता है।
यह लेख की काल्पनिक रिटेल कंपनी के लिए उदाहरण मात्र है। कॉपी हटाई जा सकती है या नहीं, यह परीक्षण पर निर्भर करता है।
लेकिन तस्वीर तब बदल जाती है जब पाइपलाइन डेटा कॉपी करने से ज़्यादा काम करती है। मान लीजिए यही कंपनी अपनी वेबसाइट, फ़िज़िकल स्टोर और बाहरी marketplaces से लेन-देन पाती है। इन सिस्टम में ग्राहक पहचानकर्ता, उत्पाद कोड और लेन-देन के फ़ॉर्मेट अलग हो सकते हैं। इंजीनियरिंग टीम को फिर भी इन अंतरों को मिलाना, असंगत रिकॉर्ड सुधारना और भरोसेमंद जानकारी तैयार करनी होती है।
DuckDB केवल इसलिए ये बिज़नेस transformations अपने आप नहीं करता कि वह नतीजे के रूप में बने डेटा को क्वेरी कर सकता है। ऐतिहासिक रिकॉर्ड को S3 में रखने वाली प्रक्रिया भी ज़रूरी बनी रह सकती है।
यह नई क्षमता इस सवाल का हल देती है कि Aurora तैयार बाहरी डेटा तक कैसे पहुँचता है। यह उस डेटा को इकट्ठा करने, जाँचने, बदलने और उसका गवर्नेंस करने की पूरी प्रक्रिया की जगह नहीं लेती।
Azure और Google Cloud इसी समस्या को कैसे सुलझाते हैं
AWS अकेला प्रदाता नहीं है जो ऑपरेशनल और analytical सिस्टम के बीच पहुँच को सरल बना रहा है, लेकिन इनके आर्किटेक्चर अलग हैं। Microsoft Azure, Azure Database for PostgreSQL के डेटा को Microsoft Fabric के OneLake में mirror करने का समर्थन करता है, जहाँ, Microsoft के अनुसार, लगातार replicate की गई कॉपी बिना जटिल ETL के analytics के लिए उपलब्ध हो जाती है। Google Cloud BigQuery federated queries देता है, जो BigQuery से Cloud SQL, AlloyDB या Spanner को क्वेरी भेजती हैं और नतीजा अस्थायी table के रूप में लौटाती हैं, वह भी उस डेटा को पहले BigQuery स्टोरेज में लोड किए बिना।
Aurora तीसरा रास्ता अपनाता है, यानी समर्थित बाहरी lake डेटा को क्वेरी करने के लिए PostgreSQL के भीतर DuckDB को embed करना। ये डेटा-पहुँच की समस्याओं के संबंधित समाधान हैं, आपस में बदले जा सकने वाले implementation नहीं।
| प्रदाता | तरीका | analytical क्वेरी कहाँ चलती है | क्या डेटा कॉपी होता है? |
|---|---|---|---|
| AWS | Parquet और Iceberg डेटा पर Aurora PostgreSQL foreign tables | Aurora क्लस्टर के भीतर, embedded DuckDB इंजन में | Aurora tables में नहीं। डेटा वहीं पढ़ा जाता है जहाँ वह रखा है, और बार-बार उपयोग होने वाला डेटा instance पर cache किया जाता है |
| Microsoft Azure | Azure Database for PostgreSQL का Microsoft Fabric में mirroring | Fabric में, OneLake की replicate की गई कॉपी पर | हाँ, सेवा उसे लगातार replicate करती है |
| Google Cloud | BigQuery federated queries से Cloud SQL, AlloyDB या Spanner तक | स्टेटमेंट स्रोत डेटाबेस पर चलता है और BigQuery को नतीजा मिलता है | स्थायी रूप से नहीं। नतीजा अस्थायी table के रूप में लौटता है, और Google के अनुसार परफ़ॉर्मेंस BigQuery स्टोरेज पढ़ने से कम हो सकती है |
यह table दिखाती है कि चुनाव सिर्फ़ फ़ीचर का नहीं है। हर रास्ता analytical काम को अलग जगह रखता है। स्रोत: Microsoft, PostgreSQL mirroring in Fabric और Google Cloud, BigQuery federated queries।
Aurora के भीतर analytics चलाने की सीमाएँ
सीधी क्वेरी किसी एप्लिकेशन को सरल बना सकती है, लेकिन इससे analytical workload ऑपरेशनल प्रभावों से मुक्त नहीं हो जाते। Aurora अक्सर उन लेन-देन के लिए ज़िम्मेदार होता है जहाँ response time मायने रखता है। ग्राहक उम्मीद करते हैं कि एप्लिकेशन के सामान्य ट्रैफ़िक के दौरान भी ऑर्डर और भुगतान भरोसेमंद ढंग से पूरे हों।
analytical क्वेरी अलग तरह से व्यवहार करती हैं। वे बड़े डेटासेट पढ़ सकती हैं, जटिल गणनाएँ कर सकती हैं और काफ़ी मेमोरी या प्रोसेसिंग संसाधन इस्तेमाल कर सकती हैं। DuckDB analytical processing के लिए optimized है, फिर भी उसका embedded execution Aurora डेटाबेस क्लस्टर के भीतर के कंप्यूटिंग संसाधन इस्तेमाल करता है।
कभी-कभार होने वाली ग्राहक-इतिहास की खोज सीधी क्वेरी के लिए उपयुक्त हो सकती है। कई वर्षों के लेन-देन को स्कैन करने वाली सैकड़ों एक साथ चलती रिपोर्ट एक अलग workload बना सकती हैं, जो CPU और मेमोरी के लिए एप्लिकेशन के सामान्य कामकाज से होड़ करे।
AWS का मार्गदर्शन है कि जो workload foreign tables को भारी मात्रा में क्वेरी करते हैं, उन्हें production लेन-देन के साथ चलाने के बजाय समर्पित reader instance पर चलाना चाहिए। AWS यह भी बताता है कि लोकल NVMe स्टोरेज वाले instances केवल EBS वाले instances की तुलना में cache और spill तेज़ी से करते हैं। स्रोत: AWS, choosing the right DB instance class।
अन्य पाबंदियाँ भी मायने रखती हैं। AWS बताता है कि JSONB, SERIAL और array types सहित कुछ PostgreSQL डेटा टाइप का कोई समर्थित mapping नहीं है। एक क्वेरी एक से अधिक AWS Region से S3 डेटा नहीं पढ़ सकती, हालाँकि डेटा क्लस्टर से अलग Region में हो सकता है।
instance के restart या failover होने पर on-disk cache साफ़ हो जाता है, इसलिए बाद की क्वेरी S3 से दोबारा पढ़ती हैं। Aurora Serverless v2 पर एक साथ कई भारी analytical क्वेरी चलाने से वह दर पार हो सकती है जिस पर instance scale up कर सकता है। स्रोत: AWS, Aurora analytics limitations।
लागत का मूल्यांकन भी इसी तरह होना चाहिए। AWS की घोषणा केवल यह कहती है कि इस क्षमता पर अपने आप में कोई अतिरिक्त शुल्क नहीं है। analytical क्वेरी फिर भी Aurora के संसाधन इस्तेमाल करती हैं, और S3 से डेटा पढ़ने पर लागू Amazon S3 शुल्क, जैसे requests और कोई भी डेटा ट्रांसफ़र, लग सकते हैं।
डेटा-कॉपी प्रक्रिया हटाने से स्टोरेज और रखरखाव की लागत घट सकती है। लेकिन अगर सीधी analytical क्वेरी के लिए बड़े Aurora instances या समर्पित readers चाहिए हों, तो कुल आर्थिक लाभ अलग हो सकता है। प्रतिनिधि workload पर परीक्षण किए बिना न कम लागत मान लेनी चाहिए और न बेहतर परफ़ॉर्मेंस।
मौजूदा एप्लिकेशन के लिए इसका क्या मतलब है
रिटेल कंपनी के लिए अब इंजीनियरिंग का फ़ैसला ज़्यादा केंद्रित है। टीम को अपना पूरा डेटा प्लेटफ़ॉर्म दोबारा डिज़ाइन करने की ज़रूरत नहीं है। उसे यह जाँचना है कि ऐतिहासिक डेटा की कॉपी करने वाली प्रक्रिया मौजूद क्यों है।
अगर वह प्रक्रिया सिर्फ़ S3 में रखे query-ready रिकॉर्ड को Aurora से उपलब्ध कराने के काम आती है, तो नया DuckDB इंटीग्रेशन परखने लायक विकल्प देता है। टीम मौजूदा तरीके की तुलना सीधी foreign-table क्वेरी से, वास्तविक ग्राहक-इतिहास अनुरोधों और अपेक्षित एप्लिकेशन ट्रैफ़िक के साथ कर सकती है। उसे ये मापना चाहिए:
- ग्राहक-इतिहास क्वेरी के response time, मौजूदा copied-table संस्करण की तुलना में।
- क्वेरी चलते समय Aurora का CPU और मेमोरी उपयोग, जिसमें AWS द्वारा Amazon CloudWatch में प्रकाशित analytics मेमोरी और disk-spill मेट्रिक्स शामिल हैं।
- S3 reads और cache hit ratio, जो दिखाते हैं कि शुरुआती क्वेरी के बाद कितना डेटा लोकल रूप से परोसा जाता है।
- साथ-साथ चल रहे सामान्य ऑर्डर और भुगतान लेन-देन पर पड़ने वाला असर।
नतीजे से तय होगा कि कॉपी प्रक्रिया हटाने से संचालन सचमुच सरल होता है या नहीं। डेटा तैयारी और रिपोर्टिंग के व्यापक सिस्टम जस के तस रह सकते हैं।
अगर सीधी क्वेरी latency-संवेदनशील रास्ते के लिए बहुत धीमी साबित हों, तो AWS एक बीच का विकल्प भी बताता है: ETL पाइपलाइन के बिना, standard SQL से Iceberg या Parquet डेटा को native Aurora tables में materialize करना।
चुनें कि Aurora से ऐतिहासिक डेटा कैसे क्वेरी करना है
अधिकतम तीन सवालों के जवाब दें। यह TechiesJournal का निर्णय-सहायक है, AWS का मार्गदर्शन नहीं, और यह पूर्ण सूची नहीं है।
क्या आपको foreign table के ज़रिए ऐतिहासिक रिकॉर्ड insert, update या delete करने हैं?
Foreign tables केवल पढ़ने के लिए हैं। S3 की स्रोत फ़ाइलें, या AWS Glue अथवा अन्य टूल से Iceberg table, अपडेट करें, और जिस डेटा को PostgreSQL के ज़रिए बदलना है उसके लिए अलग डिज़ाइन अपनाएँ।
क्या foreign-table क्वेरी भारी या बार-बार चलने वाली होंगी, जैसे बड़े scans या कई एक साथ चलती रिपोर्ट, न कि कभी-कभार के लुकअप?
अलगाव की योजना बनाएँ। AWS का मार्गदर्शन है कि foreign-table के भारी workload समर्पित reader instance पर चलने चाहिए, और production foreign-table workload के लिए वह लोकल NVMe स्टोरेज वाली class की सिफ़ारिश करता है। प्रतिनिधि workload से परीक्षण करें।
परीक्षण में क्या सीधी क्वेरी सामान्य ऑर्डर पथ पर आपका latency लक्ष्य पूरा करती है?
Foreign table रखें। Aurora CPU, मेमोरी, cache hit ratio और S3 reads को मापते रहें, फिर तय करें कि कॉपी प्रक्रिया हट सकती है या नहीं।
Materialize करने पर विचार करें। AWS latency-संवेदनशील workload के लिए, ETL पाइपलाइन के बिना, standard SQL से Iceberg या Parquet डेटा को native Aurora tables में लोड करने का वर्णन करता है। इससे Aurora स्टोरेज में फिर एक कॉपी आ जाती है, इसलिए उसे अद्यतन रखना आपका काम बन जाता है (TechiesJournal की टिप्पणी)।
AWS की limitations सूची भी देखें। कुछ डेटा टाइप समर्थित नहीं हैं, एक क्वेरी एक से अधिक Region से S3 डेटा नहीं पढ़ सकती, और Aurora Serverless v2 एक साथ कई भारी क्वेरी के लिए पर्याप्त तेज़ी से scale up नहीं कर पाए, ऐसा हो सकता है।
इसलिए Amazon Aurora की embedded DuckDB क्षमता analytics पाइपलाइन का अंत नहीं है। यह ऑपरेशनल डेटाबेस और ऐतिहासिक डेटा स्टोरेज के बीच की एक अहम सीमा को बदलती है। समर्थित workload के लिए एप्लिकेशन अब ऐतिहासिक रिकॉर्ड की एक और कॉपी रखे बिना PostgreSQL के ज़रिए मौजूदा और ऐतिहासिक जानकारी को साथ ला सकते हैं।
असली मूल्य उस डेटा मूवमेंट को हटाने में है जिसका अब कोई उद्देश्य नहीं रहा, और साथ ही उन डेटा-प्रोसेसिंग और analytical क्षमताओं को बनाए रखने में जिनकी कंपनी को अब भी ज़रूरत है।
और गहराई में
शोध की समीक्षा October 21, 2026 को की गई। रिटेल कंपनी एक काल्पनिक परिदृश्य है। कोई स्वतंत्र परफ़ॉर्मेंस benchmark या लागत की तुलना का दावा नहीं किया गया है।
AWS की घोषणा और दस्तावेज़
- AWS, Aurora PostgreSQL now supports querying of Apache Iceberg and Parquet data, September 30, 2026, सुविधा की उपलब्धता, समर्थित इंजन संस्करण और Regions।
- AWS, how Aurora analytical querying works, क्वेरी प्रोसेसिंग, embedded DuckDB, foreign tables और data-lake इंटीग्रेशन।
- AWS, choosing the right DB instance class, मेमोरी, concurrency और workload isolation।
- AWS, Aurora analytics limitations, read-only tables, डेटा टाइप, Regions और cache का व्यवहार।
पृष्ठभूमि और अन्य क्लाउड प्रदाता
- DuckDB, Why DuckDB, embedded analytical processing और उपयोग के सामान्य पैटर्न।
- Microsoft, Azure Database for PostgreSQL mirroring in Fabric, ऑपरेशनल PostgreSQL डेटा को OneLake में कैसे replicate किया जाता है।
- Google Cloud, Introduction to BigQuery federated queries, BigQuery से बाहरी ऑपरेशनल डेटाबेस को क्वेरी करना।
TechiesJournal पर संबंधित लेख
- मल्टीक्लाउड नेटवर्किंग अब एक क्लाउड सेवा बन रही है: AWS, Google और Azure क्या मानकीकृत कर रहे हैं यह समझने के लिए कि यही तीन प्रदाता क्लाउड की एक अलग परत को कैसे मानकीकृत कर रहे हैं।