

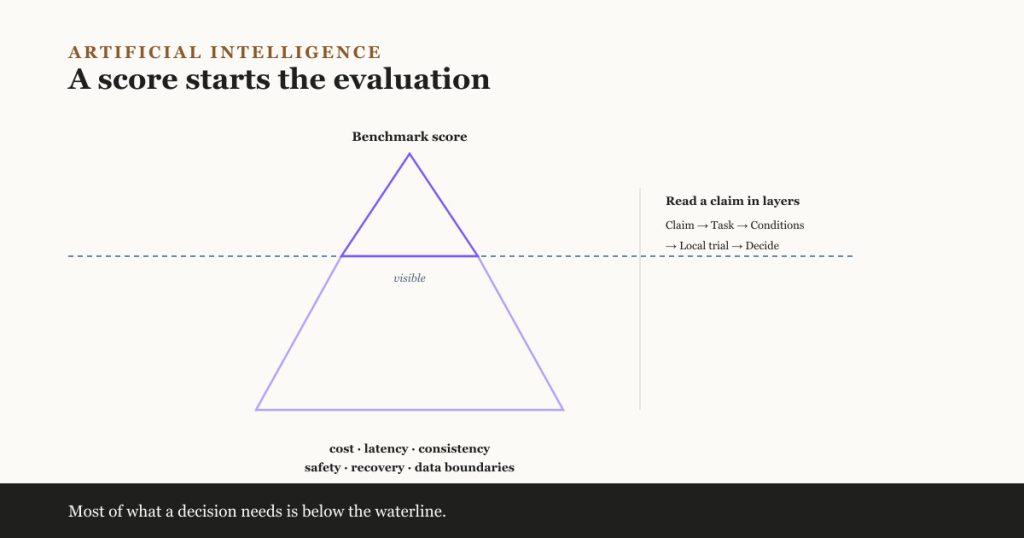
ఒక లీడర్బోర్డ్ మీరు దేన్ని పరీక్షించాలో ఎంచుకోవడంలో సహాయపడగలదు. మీ వాతావరణంలో ఏ మోడల్ పనిచేస్తుందో అది చెప్పలేదు.
చార్ట్ మీరు అనుకుంటున్నదానికంటే చిన్న ప్రశ్నకు సమాధానం ఇస్తోంది
ఒక కొత్త AI మోడల్ తన పోటీదారులను అధిగమించిందని చూపే చార్ట్తో వస్తుంది. మరొక ల్యాబ్ అదే మోడల్ను పరీక్షించి వేరే ఫలితాన్ని నివేదిస్తుంది. రెండు సంఖ్యలు కూడా చెల్లుబాటు అయ్యేవే కావచ్చు.
ఈ తేడా ప్రాంప్ట్, మోడల్ వెర్షన్, టూల్ యాక్సెస్, స్కోరింగ్ పద్ధతి, ప్రయత్నాల సంఖ్య లేదా జవాబు ఎంపికల క్రమం నుండి కూడా రావచ్చు. మరింత ముఖ్యంగా, బెంచ్మార్క్ ఒక క్లీన్, ఇరుకైన పనిని పరీక్షిస్తుండగా మీ పని గజిబిజిగా, ప్రైవేట్ డేటాతో అనుసంధానమై, ఖర్చు, లేటెన్సీ మరియు రిస్క్తో పరిమితం కావచ్చు.
ఒక బెంచ్మార్క్ స్కోర్ ఒక ప్రశ్నకు సమాధానం ఇస్తుంది: ఈ టెస్ట్ పరిస్థితుల్లో ఈ సిస్టమ్ ఎలా పనిచేసింది? మీరు పట్టించుకునే ప్రశ్నకు అది స్వయంచాలకంగా సమాధానం ఇవ్వదు: మేము ఈ మోడల్ను వాడాలా?
ఒక బెంచ్మార్క్ నిజంగా దేన్ని కొలుస్తుంది
ఒక AI బెంచ్మార్క్ అనేది స్కోరింగ్ పద్ధతితో కూడిన పునరావృతమయ్యే టాస్క్ల సమితి. ఎవరో ప్రశ్నలను ఎంచుకుంటారు, ఏది సరైనదిగా లెక్కించాలో నిర్ణయిస్తారు మరియు మోడల్ నడిచే పరిస్థితులను నిర్దేశిస్తారు.
ఆ ఎంపికలే కొలతను సృష్టిస్తాయి. ఒక కోడింగ్ బెంచ్మార్క్ టెస్ట్లు పాస్ అయ్యాయో లేదో తనిఖీ చేయవచ్చు కానీ మెయింటెయినర్లు ఆ కోడ్ను అంగీకరిస్తారో లేదో కాదు. ఒక రీజనింగ్ బెంచ్మార్క్ చిన్న పజిల్స్ను వాడవచ్చు కానీ ప్రొడక్షన్ ఇన్సిడెంట్ను డీబగ్ చేయడం గురించి చాలా తక్కువ చెబుతుంది. ఒక మల్టీలింగ్వల్ స్కోర్ మీ కస్టమర్లు వాడే భాషలో బలహీనమైన పనితీరును దాచవచ్చు.
దీని వల్ల బెంచ్మార్క్లు నిజాయితీ లేనివి కావు. కానీ వాటి పరిమితులు ముఖ్యమైనవిగా మారతాయి.
బెంచ్మార్క్ థియేటర్ ఎక్కడ మొదలవుతుంది
ఒక పరిమిత ఫలితాన్ని విస్తృత విజయంగా చూపినప్పుడు బెంచ్మార్క్ థియేటర్ మొదలవుతుంది. సాధారణ హెచ్చరిక సంకేతాలు:
- కొత్త మోడల్ గెలిచిన టెస్ట్లు మాత్రమే చూపించడం;
- ఖచ్చితమైన మోడల్ వెర్షన్ లేదా సెట్టింగ్లు లేకపోవడం;
- ఒక చిన్న స్కోర్ తేడాను అనిశ్చితి లేకుండా అర్థవంతమైనదిగా పరిగణించడం;
- పబ్లిషర్ టెస్ట్ను డిజైన్ చేసి, నడిపి, గెలుపును ప్రకటించడం;
- ఖర్చు, లేటెన్సీ, స్థిరత్వం మరియు వైఫల్య తీవ్రత లేకపోవడం;
- “రీజనింగ్” వంటి బెంచ్మార్క్ కేటగిరీని ఒక సాధారణ సామర్థ్యంగా పరిగణించడం.
ఒక ఫలితం ఇప్పటికీ ఉపయోగకరంగా ఉండగలదు. సమస్య “ఇక్కడ ఎక్కువ స్కోర్” నుండి “ప్రతిచోటా మెరుగైన మోడల్” అనే దూకుడు.
క్లెయిమ్ను పొరలుగా చదవండి
| తనిఖీ | అడగాల్సిన ప్రశ్న | ఇది ఎందుకు ముఖ్యం |
|---|---|---|
| టాస్క్ | మోడల్ నిజంగా ఏమి చేయాల్సి వచ్చింది? | విస్తృత లేబుల్ ఒక ఇరుకైన టెస్ట్ను దాచవచ్చు |
| కండిషన్స్ | ఏ వెర్షన్, ప్రాంప్ట్, టూల్స్ మరియు ఎన్ని ప్రయత్నాలు వాడారు? | చిన్న సెటప్ మార్పులు ఫలితాన్ని మార్చగలవు |
| స్కోరింగ్ | విజయాన్ని ఖచ్చితమైన మ్యాచ్, టెస్ట్లు, ఒక మోడల్ జడ్జి లేదా మనుషులు నిర్ణయించారా? | ప్రతి పద్ధతి వేర్వేరు వైఫల్యాలను మిస్ చేస్తుంది |
| స్వతంత్రత | మూల్యాంకనాన్ని ఎవరు డిజైన్ చేసి, నడిపారు? | స్వీయ-మూల్యాంకనానికి పునరుత్పత్తి చేయగల వివరాలు అవసరం |
| అనిశ్చితి | కాన్ఫిడెన్స్ ఇంటర్వల్స్ లేదా పునరావృత రన్లు నివేదించారా? | ఒక చిన్న తేడా నిజమైన లీడ్ కంటే నాయిస్ కావచ్చు |
| ఫిట్ | టెస్ట్ మీ యూజర్లు, డేటా మరియు పరిమితులను పోలి ఉందా? | లీడర్బోర్డ్ స్థానం కంటే సంబంధిత ఔచిత్యమే ముఖ్యం |
| మిస్ అయిన కొలతలు | ఖర్చు, లేటెన్సీ, సేఫ్టీ మరియు స్థిరత్వం సంగతేంటి? | నాణ్యత అనేది ఆపరేషనల్ ఎంపికలో ఒక భాగం మాత్రమే |
ఒక ఆచరణాత్మక ఉదాహరణ
ఈ క్రిందిది ఒక కల్పిత, ఉదాహరణాత్మక ఉదాహరణ, నిజమైన బెంచ్మార్క్ పోలిక కాదు.
Model A ఒక కోడింగ్ బెంచ్మార్క్పై 88% మరియు Model B 84% స్కోర్ చేశాయని అనుకుందాం. Model Aను ఎంచుకోవాలని అనిపించడం సహజం.
ఇప్పుడు మీ నిజమైన పరిస్థితులను జోడించండి. మీ బృందం ఒక పెద్ద ప్రైవేట్ రిపోజిటరీలో పనిచేస్తుంది, జనరేట్ చేసిన మార్పులు సెక్యూరిటీ రివ్యూను పాస్ కావాలని కోరుతుంది మరియు సోర్స్ కోడ్ను ఒక నిర్దిష్ట ప్రాంతం వెలుపలికి పంపలేదు. Model A నెమ్మదిగా ఉంటుంది, రెండింతలు ఖర్చవుతుంది మరియు రిక్వెస్ట్ చేసిన స్కోప్ వెలుపల ఫైల్స్ను పదే పదే మారుస్తుంది. Model Bను నియంత్రించడం సులభం మరియు తక్కువ రివ్యూ కామెంట్లను ఇస్తుంది.
బెంచ్మార్క్ తప్పు కాదు. అది ఏదో ఉపయోగకరమైనదాన్నే కొలిచింది. కానీ అది పూర్తి నిర్ణయాన్ని కొలవలేదు.
నిజమైన పని నుండి ఒక చిన్న మూల్యాంకనాన్ని నిర్మించండి
మీకు ఒక రీసెర్చ్ ల్యాబ్ అవసరం లేదు. మీ సంస్థ బాగా అర్థం చేసుకున్న 20–50 ప్రాతినిధ్య టాస్క్లతో మొదలుపెట్టండి. రొటీన్ కేసులు, కష్టమైన కేసులు మరియు మీరు అంగీకరించలేని వైఫల్యాలను చేర్చండి.
మోడళ్లను నడిపే ముందు మూల్యాంకనాన్ని నిర్వచించండి:
- ఏ ఫలితం సరైనదిగా లెక్కించబడుతుంది?
- ఏ తప్పులు హానికరం కానివి, ఖరీదైనవి లేదా ప్రమాదకరమైనవి?
- మోడల్ ఏ కంటెక్స్ట్ మరియు టూల్స్ను వాడవచ్చు?
- వ్యక్తిత్వ ఆధారిత అవుట్పుట్ను మనుషులు ఎలా సమీక్షిస్తారు?
- ఖర్చు మరియు లేటెన్సీ పరిమితులు ఏమిటి?
- అస్థిరతను బహిర్గతం చేయడానికి ఎన్ని పునరావృత రన్లు అవసరం?
సాధ్యమైనచోట ప్రాంప్ట్లను ట్యూన్ చేసే వ్యక్తుల నుండి టెస్ట్ సెట్ను దూరంగా ఉంచండి. మోడల్ వెర్షన్ మరియు సెట్టింగ్లను రికార్డ్ చేయండి. సగటు స్కోర్ను మాత్రమే కాకుండా వైఫల్యాలను సమీక్షించండి. మొత్తంగా కొంచెం బలహీనమైన మోడల్దైనా దాని తప్పులను గుర్తించడం మరియు వాటి నుండి కోలుకోవడం సులభమైతే అది మెరుగైన ఎంపిక కావచ్చు.
తెలుసుకోండి, వాడండి, లేదా నైపుణ్యం సాధించండి?
తెలుసుకోండి: ప్రతి బెంచ్మార్క్కు ఒక టాస్క్, స్కోరింగ్ పద్ధతి మరియు పరిమితి ఉంటుందని అర్థం చేసుకోండి. ఒక స్కోర్ సార్వత్రిక గ్రేడ్ కాదు.
వాడండి: మీరు AI టూల్స్ను ఎంచుకుంటే, మెథడాలజీని చదవండి మరియు షార్ట్లిస్ట్ తయారు చేయడానికి పబ్లిక్ బెంచ్మార్క్లను వాడండి. ఆ షార్ట్లిస్ట్ను ప్రాతినిధ్య పనిపై పరీక్షించండి.
నైపుణ్యం సాధించండి: మోడల్ పనితీరు మీ ప్రొడక్ట్కు కేంద్రమైతే, వెర్షన్ చేసిన మూల్యాంకనాలను నిర్మించండి, అనిశ్చితిని కొలవండి మరియు ప్రొడక్షన్ ప్రవర్తన టెస్ట్ నుండి డ్రిఫ్ట్ అవుతుందో లేదో పర్యవేక్షించండి.
మీరు తర్వాత ఏమి చేయాలి?
మీ ప్రస్తుత మోడల్ ఎంపిక వెనుక ఉన్న అత్యంత ముఖ్యమైన బెంచ్మార్క్ క్లెయిమ్ను తీసుకోండి. అది ఏమి కొలిచింది మరియు అది కొలవని మూడు విషయాలను రాసుకోండి. తర్వాత ఆ మిస్ అయిన డైమెన్షన్లలో ఒకదాన్ని బహిర్గతం చేసే ఒక నిజమైన టాస్క్ను నడపండి.
బెంచ్మార్క్లు ఉపయోగకరమైన మ్యాప్లు. మ్యాప్ను భూభాగంగా చూపినప్పుడు బెంచ్మార్క్ థియేటర్ మొదలవుతుంది. ఏది దగ్గరగా పరిశీలించదగినదో నిర్ణయించడానికి పబ్లిక్ స్కోర్లను వాడండి—తుది నిర్ణయాన్ని అవుట్సోర్స్ చేయడానికి కాదు.
మరింత లోతుగా
- HELM: Holistic Evaluation of Language Models — Stanford Center for Research on Foundation Models. సినారియోలు, మెట్రిక్లు మరియు ట్రేడ్-ఆఫ్లను కవర్ చేసే పారదర్శక మూల్యాంకన ఫ్రేమ్వర్క్. సెప్టెంబర్ 2026లో సమీక్షించబడింది.
- SWE-bench — Princeton NLP. నిజమైన GitHub ఇష్యూలను పరిష్కరించడంపై ఆధారపడిన ఒక బెంచ్మార్క్; దీని డాక్యుమెంటేషన్ టాస్క్ నిర్మాణం మరియు స్కోరింగ్ను వివరించడంలో సహాయపడుతుంది. సెప్టెంబర్ 2026లో సమీక్షించబడింది.
- Research Update: Algorithmic vs. Holistic Evaluation — METR, 13 ఆగస్టు 2025. టెస్ట్లను పాస్ చేసే కోడ్ ఇంకా ప్రొడక్షన్ నాణ్యతకు తక్కువగా ఉండవచ్చు అనే దాన్ని చూపిస్తుంది. సెప్టెంబర్ 2026లో సమీక్షించబడింది.
- Artificial Intelligence Risk Management Framework: Generative AI Profile — NIST, జూలై 2024. ఒకే నాణ్యత స్కోర్ దాటి జనరేటివ్ AIని మూల్యాంకనం చేయడానికి మార్గదర్శకత్వం. సెప్టెంబర్ 2026లో సమీక్షించబడింది.