

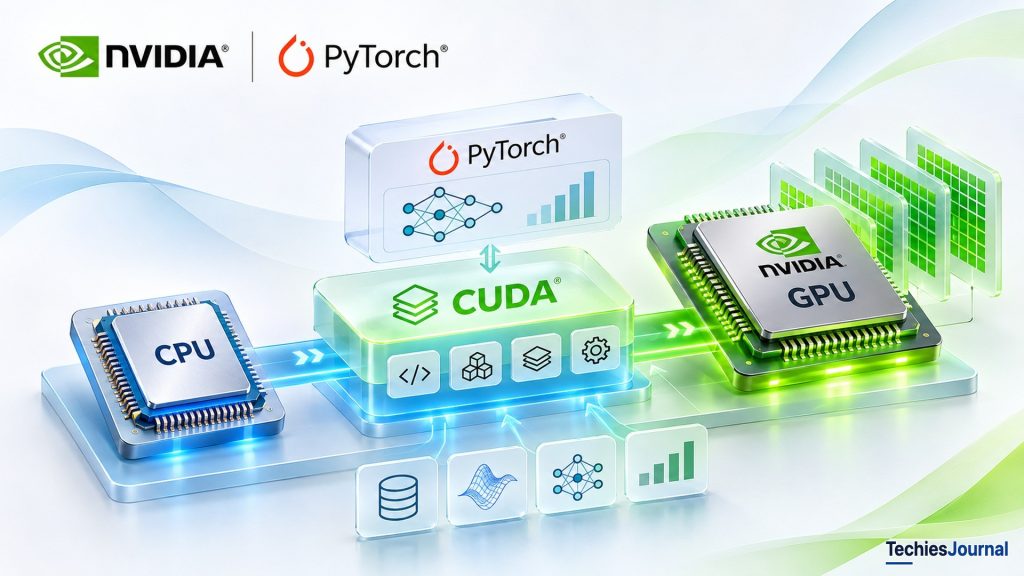
CPU और GPU मिलकर कैसे काम करते हैं, CUDA क्या जोड़ता है, AI फ़्रेमवर्क इसका उपयोग कैसे करते हैं और अलग-अलग भूमिकाओं को इसे कितनी गहराई तक सीखना चाहिए।
कोई कंप्यूटर बेहद शक्तिशाली होकर भी कुछ तरह की गणनाओं में अटक सकता है।
मान लीजिए एक इंजीनियरिंग टीम ऐसा सॉफ़्टवेयर बना रही है जो विमान के किसी पुर्ज़े में गर्मी के फैलाव का सिमुलेशन करता है। सिमुलेशन पुर्ज़े को लाखों छोटे क्षेत्रों में बाँटता है और बार-बार गणना करता है कि इन क्षेत्रों में तापमान कैसे बदलता है।
हर गणना अपने आप में अपेक्षाकृत सीधी हो सकती है। चुनौती यह है कि कितनी गणनाएँ करनी हैं। टीम सिमुलेशन को एक सामान्य कंप्यूटर प्रोसेसर पर चला सकती है। लेकिन जैसे-जैसे सिमुलेशन ज़्यादा बारीक होता है, गणना की माँग बढ़ती जाती है। जो काम पहले मिनटों में पूरा हो जाता था, उसमें आख़िरकार घंटे लग सकते हैं। यह मॉडल, एल्गोरिदम और उपलब्ध हार्डवेयर पर निर्भर करता है।
ज़्यादा तेज़ प्रोसेसर लगाने से मदद मिल सकती है। लेकिन एक और सवाल लगातार अहम होता जाता है: अगर समस्या को कई छोटी गणनाओं में बाँटकर समानांतर रूप से प्रोसेस किया जा सके, तो क्या होगा?
यहीं CPU और GPU का अंतर महत्वपूर्ण हो जाता है।
कंप्यूटरों में CPU क्यों होता है
हर सामान्य-उद्देश्य वाला कंप्यूटर निर्देशों को चलाने और तरह-तरह के संचालनों का समन्वय करने के लिए सेंट्रल प्रोसेसिंग यूनिट (CPU) पर निर्भर करता है। जब आप ब्राउज़र खोलते हैं, कोई दस्तावेज़ सहेजते हैं, कोई बिज़नेस एप्लिकेशन चलाते हैं या कोई प्रोग्राम चलाते हैं, तो इन संचालनों को संभव बनाने में CPU की अहम भूमिका होती है।
आधुनिक CPU में कई प्रोसेसिंग कोर होते हैं। हर कोर निर्देशों को कुशलता से चलाने के लिए बना होता है, और CPU उन वर्कलोड में ख़ास तौर पर प्रभावी होते हैं जिनमें अलग-अलग तरह के संचालन, निर्णय लेना, बदलते निष्पादन पथ और पहले के निर्देशों के नतीजों पर निर्भर काम शामिल हों।
CPU समानांतर प्रोसेसिंग भी कर सकते हैं। कई कोर वाला प्रोसेसर एक साथ कई काम या वर्कलोड के कई हिस्से चला सकता है, और आधुनिक CPU कोर एक साथ कई गणितीय संचालन भी कर सकते हैं। लेकिन CPU कई अलग-अलग कंप्यूटिंग ज़रूरतों के बीच संतुलन बनाने के लिए डिज़ाइन किए जाते हैं। वे बहुत बड़ी संख्या में एक जैसी गणनाएँ चलाने के लिए ही ऑप्टिमाइज़ नहीं किए गए होते।
अपने हीट सिमुलेशन पर लौटिए। कुछ हिस्सों में डेटा का समन्वय करना, निर्णय लेना और पूरे प्रोग्राम को संभालना शामिल है। CPU ये ज़िम्मेदारियाँ अच्छी तरह निभाता है। दूसरे हिस्सों में लाखों क्षेत्रों पर बार-बार गणितीय संचालन लगाए जाते हैं। इससे एक अलग तरह के प्रोसेसर के लिए मौका बनता है।
GPU अलग क्यों हैं
ग्राफ़िक्स प्रोसेसिंग यूनिट (GPU) ऐसा प्रोसेसर है जिसे शुरू में ग्राफ़िक्स से जुड़ी गणना तेज़ करने के लिए बनाया गया था। किसी त्रि-आयामी दृश्य को रेंडर करने में बड़ी संख्या में पिक्सल, सतहों, टेक्सचर और ज्यामितीय तत्वों का रूप निकालना पड़ता है। इनमें से कई गणनाएँ समानांतर रूप से की जा सकती हैं।
GPU आर्किटेक्चर इसी विशेषता वाले वर्कलोड के लिए उच्च कंप्यूटेशनल थ्रूपुट देने के लिए विकसित हुए। CPU अपने हार्डवेयर संसाधनों का काफ़ी हिस्सा कई तरह के कामों को कुशलता से चलाने में लगाता है। इसके उलट GPU अपने आर्किटेक्चर का बड़ा हिस्सा उपयुक्त काम की बड़ी मात्रा को समानांतर रूप से प्रोसेस करने में लगाता है।
इस अंतर के कारण GPU सिर्फ़ ग्राफ़िक्स दिखाने से कहीं ज़्यादा काम के हैं। हमारे इंजीनियरिंग सिमुलेशन में भी आपस में जुड़े बहुत से गणितीय संचालन हैं। उपयुक्त एल्गोरिदम के साथ, इनमें से कई संचालन संभवतः GPU पर चल सकते हैं।
सिमुलेशन को फिर भी CPU चाहिए। GPU उस प्रोसेसर की जगह नहीं लेता जो पूरा एप्लिकेशन चलाता है। इसके बजाय CPU और GPU मिलकर काम कर सकते हैं, और हर एक वर्कलोड के उस हिस्से को संभालता है जो उसके आर्किटेक्चर के अनुकूल है।
इस चित्र का सुलभ पाठ विकल्प
डायग्राम चार चित्रात्मक CPU कोर की तुलना GPU की अनेक अमूर्त निष्पादन इकाइयों से करता है। यह पैमाने के अनुसार नहीं है।
चित्र में दिखाया गया पाठ: 1. CPU और GPU के डिज़ाइन अलग क्यों हैं | दोनों गणना करते हैं। उनकी ताकतें अलग हैं, कोई सार्वभौमिक गति क्रम नहीं। | CPU · सामान्य-उद्देश्य प्रोसेसिंग | GPU · समानांतर थ्रूपुट | कोर 1 | कोर 2 | कोर 3 | कोर 4 | विविध काम · जटिल नियंत्रण प्रवाह | कई एक जैसी गणनाएँ समानांतर | केवल चित्रण: बक्से भौतिक कोर संख्या की तुलना नहीं हैं।
यह निष्कर्ष निकाल लेना आसान है कि GPU बस ज़्यादा तेज़ CPU हैं। ऐसा नहीं है। उपयुक्त समानांतर वर्कलोड पर GPU, CPU से काफ़ी बेहतर प्रदर्शन कर सकता है। लेकिन जिन एप्लिकेशन में जटिल क्रमिक निर्भरताएँ हों, अनियमित संचालन हों या बहुत थोड़ा काम हो, उन्हें शायद बहुत कम लाभ मिले।
CPU और GPU की मेमोरी के बीच डेटा ले जाना, निष्पादन का समन्वय करना और GPU संसाधन आवंटित करना भी लागत जोड़ते हैं। प्रदर्शन समस्या की प्रकृति, इम्प्लीमेंटेशन और हार्डवेयर पर निर्भर करता है, सिर्फ़ इस पर नहीं कि GPU उपलब्ध है या नहीं।
अगर GPU इतने शक्तिशाली हैं, तो CUDA की ज़रूरत क्यों है?
अब हम समझ गए कि कोई इंजीनियर GPU का उपयोग क्यों करना चाहेगा। लेकिन ऐसा हार्डवेयर पहचान लेना, जो गणना चला सके, चुनौती का सिर्फ़ एक हिस्सा है। इंजीनियरिंग टीम के पास एक एप्लिकेशन है जो सिमुलेशन को गणितीय संचालनों, डेटा संरचनाओं और प्रोग्राम निर्देशों के रूप में बताता है। GPU का निष्पादन आर्किटेक्चर और मेमोरी सिस्टम अलग है।
एप्लिकेशन यह मानकर नहीं चल सकता कि कोई सामान्य CPU फ़ंक्शन हज़ारों GPU थ्रेड पर कुशलता से चलेगा। उसे यह बताने का तरीका चाहिए कि कौन-सी गणनाएँ GPU पर चलें, वह काम कैसे संगठित हो, डेटा कैसे उपलब्ध हो और निष्पादन का समन्वय कैसे हो।
उपयुक्त प्रोग्रामिंग इंटरफ़ेस, कंपाइलर, लाइब्रेरी और सहायक सॉफ़्टवेयर के बिना, GPU की कंप्यूटेशनल क्षमता का बड़ा हिस्सा सामान्य-उद्देश्य वाले एप्लिकेशन के लिए इस्तेमाल करना मुश्किल रहता। यही समस्या CUDA को महत्वपूर्ण बनाती है।
जब NVIDIA ने नवंबर 2006 में CUDA की घोषणा की, तो उसने संगत NVIDIA GPU को केवल पारंपरिक ग्राफ़िक्स प्रोसेसिंग के बजाय सामान्य-उद्देश्य वाली कंप्यूटिंग के लिए प्रोग्राम करने योग्य बनाने में मदद की। CUDA का मूल पूर्ण रूप Compute Unified Device Architecture था।
इसका महत्व यह नहीं है कि यह GPU को शक्तिशाली बनाता है। कंप्यूटेशनल क्षमता हार्डवेयर आर्किटेक्चर देता है। CUDA सॉफ़्टवेयर डेवलपर को उस क्षमता का उपयोग करके काम व्यक्त करने और चलाने में मदद करता है।
समय के साथ आसपास का इकोसिस्टम बढ़ा और उसमें गणितीय लाइब्रेरी, कंपाइलर, डीबगिंग टूल, प्रदर्शन विश्लेषण टूल और उच्च-स्तरीय सॉफ़्टवेयर के साथ इंटीग्रेशन शामिल हो गए। यह नींव आगे चलकर आर्टिफ़िशियल इंटेलिजेंस के लिए ख़ास तौर पर अहम बन गई।
आज कोई डेवलपर Python और PyTorch से न्यूरल नेटवर्क ट्रेन कर सकता है, और ज़रूरी नहीं कि उसे सीधे CUDA कोड लिखना पड़े। फिर भी Python एप्लिकेशन के नीचे CUDA-सक्षम सॉफ़्टवेयर NVIDIA GPU हार्डवेयर पर गणना के बड़े हिस्से को चलाने के लिए ज़िम्मेदार हो सकता है।
इस संबंध को समझने के लिए हमें देखना होगा कि कोई एप्लिकेशन साधारण प्रोग्राम निर्देशों से समानांतर GPU निष्पादन तक कैसे पहुँचता है।
एप्लिकेशन से GPU तक: CUDA के आर्किटेक्चर को समझना
इंजीनियरिंग सिमुलेशन पर लौटिए। एप्लिकेशन को सिमुलेशन तैयार करना, शुरुआती मान लोड करना, गणनाएँ संभालना और अंत में नतीजे दिखाना या सहेजना है। इस सारे काम में से सब कुछ GPU का नहीं है।
मुख्य एप्लिकेशन चलाना, संचालनों का समन्वय करना और उपयुक्त GPU गणनाएँ शुरू करना CPU की ज़िम्मेदारी बनी रहती है। CUDA की शब्दावली में एप्लिकेशन के CPU वाले हिस्से को host कहते हैं, जबकि GPU को device कहते हैं। यह अंतर अहम है क्योंकि host और device के निष्पादन संसाधन और मेमोरी स्पेस अलग हो सकते हैं।
सिमुलेशन का CPU-साइड कोड लाखों तापमान मान तैयार कर सकता है। फिर उसे इन मानों को GPU कोड के लिए सुलभ बनाना होता है। एक सामान्य CUDA एप्लिकेशन runtime का उपयोग करके GPU-सुलभ मेमोरी आवंटित कर सकता है, डेटा ट्रांसफ़र कर सकता है, GPU पर गणनाएँ लॉन्च कर सकता है, निष्पादन को सिंक्रनाइज़ कर सकता है और नतीजे वापस ला सकता है। एप्लिकेशन के सामने दिखने वाले इन इंटरफ़ेस के नीचे NVIDIA का सॉफ़्टवेयर और ड्राइवर इन्फ्रास्ट्रक्चर GPU हार्डवेयर के साथ संपर्क को संभालता है।
इस चित्र का सुलभ पाठ विकल्प
एप्लिकेशन CPU host और CUDA इंटरफ़ेस से जुड़ता है, जो ड्राइवर इन्फ्रास्ट्रक्चर के ज़रिए NVIDIA GPU तक पहुँचते हैं। सरलीकृत वैचारिक आर्किटेक्चर।
चित्र में दिखाया गया पाठ: 2. एप्लिकेशन आर्किटेक्चर में CUDA | CUDA एक प्लेटफ़ॉर्म और इकोसिस्टम है। यह स्वयं GPU या कोई एक अनिवार्य सॉफ़्टवेयर परत नहीं है। | इंजीनियरिंग सिमुलेशन एप्लिकेशन | CPU / host | प्रोग्राम नियंत्रण और समन्वय | CUDA इंटरफ़ेस / लाइब्रेरी | kernel लॉन्च, डेटा और कंप्यूट API | NVIDIA ड्राइवर + संगत GPU | device निष्पादन | host और device सहयोग करते हैं। API, लाइब्रेरी और ड्राइवर की भूमिकाएँ अलग हैं।
यहाँ एक आर्किटेक्चरल अंतर है। CUDA हर एप्लिकेशन और GPU के बीच बैठा कोई एक सॉफ़्टवेयर घटक नहीं है। यह एक व्यापक प्रोग्रामिंग प्लेटफ़ॉर्म और इकोसिस्टम है, जिसमें अलग-अलग ज़िम्मेदारियों वाले इंटरफ़ेस, टूल और लाइब्रेरी हैं। कुछ एप्लिकेशन CUDA API को सीधे कॉल करते हैं। दूसरे ऐसी लाइब्रेरी या फ़्रेमवर्क पर निर्भर करते हैं जो भीतर से CUDA का उपयोग करते हैं।
यह संबंध तब और साफ़ होता है जब हम एक असली गणना को शुरू से अंत तक देखते हैं।
CUDA कोई गणना चलाए तो क्या होता है?
कल्पना कीजिए कि हमारी इंजीनियरिंग टीम क्षेत्रों के एक बड़े समूह में तापमान के बदलाव की गणना करना चाहती है। उदाहरण के लिए मान लें कि कोई उपयुक्त चरण पिछले सिमुलेशन चरण के मानों का उपयोग करके कई क्षेत्रों के लिए स्वतंत्र रूप से चलाया जा सकता है।
एप्लिकेशन पहले इनपुट डेटा तैयार करता है। फिर वह सुनिश्चित करता है कि GPU उन इनपुट तक पहुँच सके। पारंपरिक explicit-memory वर्कफ़्लो में एप्लिकेशन device मेमोरी आवंटित करता है और डेटा को CPU मेमोरी से GPU मेमोरी में कॉपी करता है। managed memory समेत दूसरे तरीके भी मौजूद हैं, लेकिन बुनियादी ज़रूरत वही है: डेटा वहाँ सुलभ होना चाहिए जहाँ गणना होती है।
डेटा तैयार होने पर एप्लिकेशन ऐसा फ़ंक्शन लॉन्च करता है जो GPU पर चलने के लिए बना है। CUDA इस फ़ंक्शन को kernel कहता है। kernel कोई पूरा एप्लिकेशन नहीं होता। वह एक ख़ास गणना बताता है जिसे GPU थ्रेड चलाएँगे।
हमारे सिमुलेशन में kernel आसपास के मानों का उपयोग करके हर क्षेत्र का अद्यतन तापमान निकाल सकता है। एक CPU निष्पादन पथ से एक के बाद एक गणना चलाने के बजाय, एप्लिकेशन उपयुक्त काम को समानांतर रूप से करने के लिए GPU थ्रेड का एक बड़ा समूह लॉन्च करता है।
kernel पूरा होने पर नतीजे अगले सिमुलेशन चरण के लिए GPU मेमोरी में बने रह सकते हैं। केवल जब CPU को मान चाहिए (उदाहरण के लिए, रिपोर्ट लिखने या नतीजा दिखाने के लिए), तभी एप्लिकेशन उन्हें host मेमोरी में वापस ट्रांसफ़र कर सकता है।
इस चित्र का सुलभ पाठ विकल्प
पाँच चरण: डेटा तैयार करना, डेटा को GPU-सुलभ बनाना, kernel लॉन्च करना, device पर गणना करना, नतीजे इस्तेमाल करना। सिंक्रनाइज़ेशन का नोट भी है।
चित्र में दिखाया गया पाठ: 3. एक CUDA गणना, चरण दर चरण | इंजीनियरिंग हीट-सिमुलेशन उदाहरण। GPU नतीजे अगले चरणों के लिए device पर रह सकते हैं। | 1 · तैयारी | CPU इनपुट बनाता है | 2 · डेटा सुलभ करें | आवंटन/कॉपी या managed मेमोरी | 3 · kernel लॉन्च | host GPU काम सौंपता है | 4 · गणना | device थ्रेड गणना करते हैं | 5 · नतीजा इस्तेमाल | GPU का अगला चरण या CPU पढ़े | GPU काम asynchronous हो सकता है। ज़रूरत पर सिंक्रनाइज़ करें। | डेटा ट्रांसफ़र शर्तों पर है: unified/managed मेमोरी और GPU पर दोबारा उपयोग से पथ बदलता है।
ध्यान दीजिए कि बीच के नतीजों को GPU पर रखना कितना अहम है। अगर किसी सिमुलेशन में हज़ारों प्रोसेसिंग चरण हैं, तो हर चरण के बाद पूरे डेटासेट को CPU पर लौटाने से काफ़ी ओवरहेड आ सकता है। बेहतर डिज़ाइन कई संचालन GPU पर चला सकता है और केवल वही ट्रांसफ़र कर सकता है जो CPU को सचमुच चाहिए।
इससे एक बड़ा सिद्धांत सामने आता है: GPU एक्सेलरेशन का मतलब सिर्फ़ अलग-अलग गणितीय संचालनों को तेज़ करना नहीं है। इसके लिए यह भी डिज़ाइन करना पड़ता है कि गणना और डेटा सिस्टम में कैसे घूमते हैं।
क्या GPU के काम करते समय CPU इंतज़ार करता है?
ज़रूरी नहीं। कई CUDA संचालन asynchronous रूप से लॉन्च किए जा सकते हैं, जिससे GPU पहले सौंपे गए संचालनों को प्रोसेस करता रहता है और CPU दूसरा काम जारी रख सकता है। CUDA, GPU के कतार में लगे संचालनों को व्यवस्थित करने के लिए streams का उपयोग करता है।
एक ही stream में सौंपे गए संचालनों के क्रम के नियम होते हैं, जबकि अलग-अलग stream के स्वतंत्र संचालन निर्भरताओं और हार्डवेयर क्षमताओं के आधार पर आपस में ओवरलैप हो सकते हैं। जब एप्लिकेशन को यह जानना हो कि कोई ख़ास काम पूरा हो गया है, या कोई दूसरा संचालन उसके नतीजों पर निर्भर हो, तब उसे सिंक्रनाइज़ करना होता है।
हमारा सिमुलेशन मौजूदा बैच को GPU पर प्रोसेस करते समय इनपुट का अगला बैच तैयार कर सकता है। लेकिन अगर अगली गणना पिछले नतीजों पर निर्भर है, तो प्रोग्राम को वह निर्भरता बनाए रखनी होगी। Asynchronous निष्पादन उपयोग बेहतर कर सकता है। यह सही समन्वय की ज़रूरत को ख़त्म नहीं करता।
CUDA हज़ारों GPU थ्रेड में काम कैसे बाँटता है?
हमने kernel को ऐसा फ़ंक्शन बताया है जो GPU पर चलता है। लेकिन GPU को कैसे पता चलता है कि कौन-सा थ्रेड किस क्षेत्र की गणना करे? CUDA एक तार्किक निष्पादन पदानुक्रम देता है: थ्रेड, थ्रेड ब्लॉक और ग्रिड।
थ्रेड, kernel के एक तार्किक निष्पादन इंस्टेंस को दर्शाता है। हर थ्रेड के पास ऐसे आइडेंटिफ़ायर होते हैं जो तय करने में मदद करते हैं कि वह वर्कलोड का कौन-सा हिस्सा प्रोसेस करे। थ्रेड को थ्रेड ब्लॉक नाम के समूहों में संगठित किया जाता है। थ्रेड ब्लॉक का एक संग्रह ग्रिड बनाता है।
मान लीजिए एक सरलीकृत सिमुलेशन में 1,024 क्षेत्र हैं, जिन्हें एक गणना चरण के लिए स्वतंत्र रूप से प्रोसेस किया जाता है। डेवलपर चार थ्रेड ब्लॉक लॉन्च कर सकता है, जिनमें से हर एक में 256 थ्रेड हों। इससे 1,024 तार्किक थ्रेड बनते हैं, और हर थ्रेड संभवतः एक क्षेत्र के लिए ज़िम्मेदार होता है। हर थ्रेड kernel कोड चलाता है, लेकिन यह पहचानने के लिए अपने इंडेक्स का उपयोग करता है कि उसे किस क्षेत्र को अपडेट करना है।
इस चित्र का सुलभ पाठ विकल्प
ग्रिड में 256 थ्रेड वाले चार ब्लॉक हैं। अलग GPU हार्डवेयर पैनल streaming multiprocessors पर शेड्यूलिंग समझाता है।
चित्र में दिखाया गया पाठ: 4. CUDA का तार्किक निष्पादन पदानुक्रम | उदाहरण: 1,024 तार्किक थ्रेड = 4 ब्लॉक × 256 थ्रेड। 1,024 समर्पित भौतिक कोर नहीं। | एक kernel लॉन्च · ग्रिड | थ्रेड ब्लॉक 1 · 256 थ्रेड | थ्रेड ब्लॉक 2 · 256 थ्रेड | थ्रेड ब्लॉक 3 · 256 थ्रेड | थ्रेड ब्लॉक 4 · 256 थ्रेड | GPU हार्डवेयर | Streaming multiprocessors | उपलब्ध ब्लॉक शेड्यूल करें | warp थ्रेड चलाते हैं | ब्लॉक और थ्रेड सॉफ़्टवेयर संगठन हैं। SM और warp हार्डवेयर निष्पादन अवधारणाएँ हैं। | चित्र में: हर ब्लॉक के 256 में से 16 थ्रेड
उद्देश्य यह है कि हर गणना को किसी अलग भौतिक प्रोसेसिंग यूनिट को हाथ से सौंपे बिना एक बड़े समानांतर वर्कलोड को बताया जा सके। एक ही ब्लॉक के थ्रेड बीच का डेटा साझा करने के लिए समर्थित सिंक्रनाइज़ेशन तंत्र और shared memory का उपयोग कर सकते हैं।
हमारे सिमुलेशन में यह मूल्यवान हो सकता है। किसी क्षेत्र का नया तापमान आसपास के क्षेत्रों पर निर्भर कर सकता है। सावधानी से डिज़ाइन किया गया kernel सहयोग करने वाले थ्रेड को धीमी मेमोरी से बार-बार वही जानकारी लाने के बजाय आसपास के मान दोबारा इस्तेमाल करने दे सकता है।
लेकिन सामान्य थ्रेड-ब्लॉक प्रोग्रामिंग में डेवलपर यह नहीं मान सकते कि सभी ब्लॉक एक साथ चलते हैं या कोई एक ब्लॉक हर दूसरे ब्लॉक के साथ खुलकर सिंक्रनाइज़ हो सकता है। जिस एल्गोरिदम को वैश्विक समन्वय चाहिए, उसे इन सीमाओं का ध्यान रखना होगा या उपयुक्त तंत्र इस्तेमाल करने होंगे।
क्या CUDA थ्रेड भौतिक GPU कोर के बराबर हैं?
नहीं। थ्रेड और ब्लॉक बताते हैं कि सॉफ़्टवेयर काम को कैसे संगठित करता है। GPU में भौतिक कंप्यूटिंग संसाधन होते हैं जो उस काम को चलाते हैं। NVIDIA GPU में Streaming Multiprocessors (SM) नाम की हार्डवेयर यूनिटें होती हैं, जो संसाधन सीमाओं के भीतर ब्लॉक को शेड्यूल और निष्पादित करती हैं।
एक ब्लॉक के भीतर थ्रेड को warp नाम की निष्पादन इकाइयों में समूहित किया जाता है। पारंपरिक CUDA warp में 32 थ्रेड होते हैं, जबकि शेड्यूलिंग और निष्पादन का ठीक-ठीक व्यवहार आर्किटेक्चर पर निर्भर करता है। हज़ारों थ्रेड वाले ग्रिड का मतलब यह नहीं कि हर थ्रेड को समर्पित भौतिक प्रोसेसर मिलता है, और न यह कि सभी थ्रेड एक साथ चलते हैं।
डेवलपर समानांतर काम को बताता है। उपलब्ध संसाधनों का उपयोग वह काम कैसे करे, यह GPU का हार्डवेयर और निष्पादन तंत्र तय करता है। यह अंतर CUDA के सबसे महत्वपूर्ण आर्किटेक्चरल विचारों में से एक है।
मेमोरी भी उतनी ही मायने रखती है जितनी प्रोसेसिंग क्षमता
अगर कोई एप्लिकेशन मेमोरी को अकुशल ढंग से एक्सेस करता है, तो तेज़ प्रोसेसर भी डेटा के इंतज़ार में काफ़ी समय बिता सकता है। इसलिए GPU थ्रूपुट को सहारा देने के लिए बनी कई मेमोरी संरचनाएँ देते हैं।
सिमुलेशन का बड़ा डेटासेट GPU की global memory में रह सकता है। थ्रेड global memory को एक्सेस कर सकते हैं, लेकिन बार-बार या बेतरतीब एक्सेस महँगे पड़ सकते हैं। एक ब्लॉक के थ्रेड सहयोग करने और डेटा दोबारा इस्तेमाल करने के लिए shared memory का उपयोग कर सकते हैं। हर थ्रेड काम के मानों के लिए रजिस्टर इस्तेमाल कर सकता है, जो हार्डवेयर सीमाओं के अधीन है।
मुद्दा हर मेमोरी प्रकार को रटना नहीं है। मुद्दा यह है कि प्रदर्शन गणना और डेटा एक्सेस, दोनों पर निर्भर करता है।
अगर पास के क्षेत्रों को बार-बार वही तापमान चाहिए, तो अकुशल इम्प्लीमेंटेशन वही मान अनावश्यक रूप से कई बार लोड कर सकता है। बेहतर इम्प्लीमेंटेशन एक्सेस को व्यवस्थित कर सकता है या साझा डेटा दोबारा इस्तेमाल कर सकता है। GPU में अपार अंकगणितीय क्षमता हो सकती है और फिर भी निराशाजनक प्रदर्शन मिल सकता है, अगर सॉफ़्टवेयर डेटा कुशलता से उपलब्ध नहीं करा पाता।
CUDA सॉफ़्टवेयर इकोसिस्टम कैसे बना
ज़्यादातर इंजीनियर हर गणितीय संचालन शुरू से नहीं बनाना चाहते। सिमुलेशन में ऐसे मैट्रिक्स संचालन और संख्यात्मक रूपांतरण हो सकते हैं जो कई एप्लिकेशन में आम हैं। हर एक को अलग से विकसित और ट्यून करना महँगा होगा।
CUDA का इकोसिस्टम दोबारा इस्तेमाल होने वाली लाइब्रेरी और टूल देता है। cuBLAS रैखिक बीजगणित के संचालन लागू करता है, और cuFFT तेज़ फ़ूरियर ट्रांसफ़ॉर्म को सपोर्ट करता है। CUDA Toolkit में प्रोग्रामिंग इंटरफ़ेस, कंपाइलर और डेवलपर टूल शामिल हैं, जिनमें CUDA C++ के लिए nvcc कंपाइलर भी है।
runtime API एप्लिकेशन को आम निष्पादन तंत्रों तक सुविधाजनक पहुँच देता है। driver API निचले स्तर पर संसाधन और निष्पादन का नियंत्रण देता है। प्रोफ़ाइलर और डीबगर इंजीनियरों को समस्याएँ और प्रदर्शन जाँचने में मदद करते हैं। NVIDIA ड्राइवर संगत हार्डवेयर के साथ संपर्क को सपोर्ट करता है।
इस चित्र का सुलभ पाठ विकल्प
चार समानांतर CUDA इकोसिस्टम घटक वैचारिक रूप से NVIDIA ड्राइवर और GPU हार्डवेयर से जुड़ते हैं, साथ में टूल हैं।
चित्र में दिखाया गया पाठ: 5. CUDA एक सॉफ़्टवेयर इकोसिस्टम है | घटक क्षमताएँ और पथ हैं, कोई एक अनिवार्य रैखिक श्रृंखला नहीं। | एप्लिकेशन · CUDA C++ प्रोग्राम · GPU-त्वरित लाइब्रेरी | कंपाइलर / nvcc | CUDA kernel बनाएँ | Runtime API | सामान्य निष्पादन इंटरफ़ेस | Driver API | निचले स्तर का संसाधन नियंत्रण | CUDA लाइब्रेरी | cuBLAS · cuFFT · अन्य लाइब्रेरी | NVIDIA ड्राइवर और समर्थित GPU हार्डवेयर | प्रोफ़ाइलर और डीबगर इन घटकों में निष्पादन देखते हैं।
कोई एप्लिकेशन कस्टम kernel कंपाइल किए बिना पहले से बनी GPU लाइब्रेरी को कॉल कर सकता है। उच्च-स्तरीय फ़्रेमवर्क मेमोरी और निष्पादन प्रबंधन का बड़ा हिस्सा छिपा सकता है। डेवलपर कंप्यूटर और क्लाउड GPU वातावरण को कॉन्फ़िगर करते समय ये अंतर मायने रखते हैं: संगत ड्राइवर और फ़्रेमवर्क बिल्ड होना, हर एप्लिकेशन डेवलपर से पूरा toolkit इंस्टॉल करवाने और इस्तेमाल करवाने के बराबर नहीं है।
किसी एक्सेलरेटर का मूल्य सिर्फ़ हार्डवेयर प्रदर्शन से नहीं, बल्कि उसे इस्तेमाल करने के लिए उपलब्ध सॉफ़्टवेयर से भी तय होता है। लाइब्रेरी, फ़्रेमवर्क, कंपाइलर, ट्रबलशूटिंग टूल या संगत एप्लिकेशन न हों, तो प्रभावशाली हार्डवेयर स्पेसिफ़िकेशन से व्यावहारिक मूल्य बहुत कम मिलता है।
आधुनिक AI, CUDA को डेवलपर के सामने लाए बिना उसका उपयोग कैसे करता है
AI इंजीनियर आम तौर पर हाथ से लिखे GPU kernel के बजाय फ़्रेमवर्क से शुरुआत करता है। PyTorch में डेवलपर मॉडल की परतें तय करता है, डेटा तैयार करता है और tensor पर काम करता है, जो बहु-आयामी संख्यात्मक संरचनाएँ हैं।
न्यूरल नेटवर्क tensor पर मैट्रिक्स गुणन जैसे रूपांतरण बार-बार लागू करते हैं। इनमें से कई संचालनों को GPU समानांतरता से लाभ मिल सकता है। जब PyTorch किसी NVIDIA GPU पर कोई समर्थित संचालन चलाता है, तो उसका CUDA-सक्षम backend उपयुक्त kernel और त्वरित लाइब्रेरी के ज़रिए काम भेजता है।
इस चित्र का सुलभ पाठ विकल्प
PyTorch एप्लिकेशन से CUDA backend, फिर kernel और लाइब्रेरी, फिर NVIDIA GPU। संचालन-विशिष्ट चेतावनी शामिल है।
चित्र में दिखाया गया पाठ: 6. AI फ़्रेमवर्क के नीचे CUDA | PyTorch डेवलपर कस्टम CUDA kernel लिखे बिना NVIDIA GPU कंप्यूट उपयोग कर सकता है। | Python मॉडल / PyTorch | Tensor और संचालन | CUDA-सक्षम PyTorch backend | समर्थित device संचालन भेजें | Kernel और ऑप्टिमाइज़्ड लाइब्रेरी | इम्प्लीमेंटेशन संचालन पर निर्भर | NVIDIA GPU + ड्राइवर | समर्थित GPU काम चलाएँ | हर संचालन का kernel/लाइब्रेरी पथ या GPU सपोर्ट एक जैसा नहीं।
यह कोई एक तय इम्प्लीमेंटेशन पथ नहीं है। अलग-अलग PyTorch संचालन अलग-अलग kernel, लाइब्रेरी या कंपाइल किए गए इम्प्लीमेंटेशन इस्तेमाल कर सकते हैं। कुछ संचालन CPU पर चल सकते हैं। क्या होगा, यह device प्लेसमेंट, समर्थित सॉफ़्टवेयर और फ़्रेमवर्क के व्यवहार से तय होता है।
एक जानबूझकर छोटे Python उदाहरण पर विचार कीजिए:
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"

a = torch.tensor([1.0, 2.0, 3.0], device=device)
b = torch.tensor([4.0, 5.0, 6.0], device=device)

result = a + b
print(result.cpu())
अगर PyTorch, CUDA का उपयोग कर सकता है, तो tensor और जोड़ चुने गए CUDA device पर चलते हैं। अन्यथा यह उदाहरण CPU का उपयोग करता है। यह device चुनना दिखाता है, गति का फ़ायदा नहीं। डेवलपर ने कोई कस्टम CUDA kernel नहीं लिखा है। संबंधित इम्प्लीमेंटेशन फ़्रेमवर्क देता है।
जब PyTorch यह सब संभालता है, तो CUDA को क्यों समझें?
एब्स्ट्रैक्शन GPU कंप्यूटिंग को ज़्यादा सुलभ बनाता है, लेकिन आर्किटेक्चरल निर्भरताओं को ख़त्म नहीं करता।
कल्पना कीजिए कि कोई AI मॉडल वर्कस्टेशन पर चलता है लेकिन क्लाउड GPU सर्वर पर फ़ेल हो जाता है। Python मॉडल सही हो सकता है, जबकि डिप्लॉय किए गए वातावरण में संगत ड्राइवर, फ़्रेमवर्क बिल्ड या समर्थित GPU आर्किटेक्चर नहीं है। या मॉडल सही चलता है लेकिन CPU से GPU के बीच ज़रूरत से ज़्यादा ट्रांसफ़र, छोटे संचालनों या अनावश्यक सिंक्रनाइज़ेशन के कारण ख़राब प्रदर्शन करता है।
इन समस्याओं के लिए हमेशा CUDA C++ लिखने की ज़रूरत नहीं पड़ती। लेकिन इतनी समझ ज़रूर चाहिए कि पहचाना जा सके कि गड़बड़ी मॉडल कोड में है, फ़्रेमवर्क के device व्यवहार में, इंस्टॉल किए सॉफ़्टवेयर में या डेटा की आवाजाही में।
क्लाउड इंजीनियरों, AI प्लेटफ़ॉर्म टीमों और प्रोडक्शन एप्लिकेशन डेवलपरों के लिए यह आर्किटेक्चरल समझ निचले स्तर की kernel प्रोग्रामिंग से तुरंत ज़्यादा उपयोगी हो सकती है।
CUDA सॉफ़्टवेयर को अपने आप तेज़ क्यों नहीं बनाता
सिमुलेशन के दो संस्करणों पर विचार कीजिए। पहला लाखों क्षेत्रों को बार-बार प्रोसेस करता है और समानांतर संख्यात्मक संचालनों पर काफ़ी समय बिताता है। उपयुक्त एल्गोरिदम के साथ, उसे GPU एक्सेलरेशन से काफ़ी लाभ मिल सकता है।
दूसरा केवल कुछ सौ गणनाएँ करता है और उसे नतीजे तुरंत CPU पर चाहिए। डेटा ट्रांसफ़र, काम सौंपना और सिंक्रनाइज़ेशन, गणना से ज़्यादा महँगे पड़ सकते हैं। बड़ा वर्कलोड भी क्रमिक निर्भरताओं, असंतुलित काम या अकुशल मेमोरी एक्सेस के कारण ख़राब प्रदर्शन कर सकता है।
गंभीर तुलना में end-to-end वर्कलोड को मापा जाता है: इनपुट की तैयारी, डेटा प्लेसमेंट, गणना, सिंक्रनाइज़ेशन, आउटपुट और संचालन की लागत। साथ ही तुलना एक मज़बूत, व्यावहारिक CPU इम्प्लीमेंटेशन से की जाती है, किसी जानबूझकर कमज़ोर बेसलाइन से नहीं।
उद्देश्य GPU उपयोग को अधिकतम करना नहीं है। उद्देश्य एक असली कंप्यूटेशनल नतीजे को बेहतर करना है।
क्या AI कंप्यूटिंग पूरी तरह NVIDIA CUDA पर निर्भर है?
नहीं। CUDA कई NVIDIA GPU वर्कलोड के लिए केंद्रीय है, लेकिन त्वरित कंप्यूटिंग CUDA से व्यापक है। AMD ROCm सॉफ़्टवेयर इकोसिस्टम विकसित करता है, जबकि SYCL और दूसरे तरीके हेटरोजीनियस और एक्सेलरेटर प्रोग्रामिंग के अतिरिक्त मॉडल को सपोर्ट करते हैं। AI एप्लिकेशन CPU और दूसरे एक्सेलरेटर पर भी चल सकते हैं।
ये विकल्प एक व्यावहारिक आर्किटेक्चर सवाल खड़ा करते हैं। उच्च-स्तरीय फ़्रेमवर्क अलग-अलग device पर मिलते-जुलते API दे सकता है, फिर भी लाइब्रेरी, संगतता, समर्थित संचालन, प्रदर्शन और डिप्लॉयमेंट व्यवहार अलग हो सकते हैं। एप्लिकेशन सोर्स की पोर्टेबिलिटी, समान प्रदर्शन या संचालन की समान सरलता की गारंटी नहीं देती।
प्रोडक्शन AI सिस्टम के लिए हार्डवेयर चुनते समय टीम को असली वर्कलोड, समर्थित फ़्रेमवर्क और लाइब्रेरी, उपलब्धता, क़ीमत, कौशल और दीर्घकालिक रखरखाव का मूल्यांकन करना चाहिए। CUDA की सॉफ़्टवेयर परिपक्वता प्रासंगिक साक्ष्य है, NVIDIA हार्डवेयर चुनने का सार्वभौमिक आदेश नहीं।
CUDA किसे सीखना चाहिए?
AI सीखने वाले विद्यार्थी को प्रोग्रामिंग, Python, डेटा हैंडलिंग, गणित और किसी प्रासंगिक मशीन-लर्निंग फ़्रेमवर्क से शुरुआत करनी चाहिए। GPU और CUDA क्या करते हैं, यह समझना उपयोगी है, लेकिन CUDA C++ ऑप्टिमाइज़ेशन आम तौर पर पहली प्राथमिकता नहीं है।
एप्लिकेशन डेवलपर को device चयन और डिप्लॉयमेंट निर्भरताएँ समझनी चाहिए। क्लाउड इंजीनियर को पता होना चाहिए कि संगत ड्राइवर, फ़्रेमवर्क और GPU संसाधन आपस में कैसे बैठते हैं। ML परफ़ॉर्मेंस इंजीनियर को kernel, मेमोरी, सिंक्रनाइज़ेशन और प्रोफ़ाइलिंग की जाँच करनी पड़ सकती है। वैज्ञानिक कंप्यूटिंग और GPU विशेषज्ञों को CUDA kernel सीधे डिज़ाइन और ट्यून करने पड़ सकते हैं।
TechiesJournal का Know → Use → Master अंतर उपयुक्त गहराई तय करने में मदद करता है:
- Know (जानना): CPU बनाम GPU, host बनाम device, kernel और AI फ़्रेमवर्क के नीचे CUDA की जगह समझाना।
- Use (उपयोग करना): CUDA-सक्षम वातावरण कॉन्फ़िगर करना और उनकी समस्याएँ सुलझाना, और मेमोरी या निष्पादन की बुनियादी समस्याओं की जाँच करना।
- Master (महारत): GPU kernel विकसित और ऑप्टिमाइज़ करना, हार्डवेयर संसाधनों पर तर्क करना और प्रदर्शन के विस्तृत ट्रेड-ऑफ़ तय करना।
हर किसी को आख़िरी चरण की ज़रूरत नहीं है। कई पेशेवरों को निचले स्तर का CUDA सिंटैक्स रटने से ज़्यादा तुरंत फ़ायदा सटीक आर्किटेक्चरल समझ से मिलता है।
CUDA आधुनिक कंप्यूटिंग के बारे में कुछ बड़ा बताता है
इंजीनियरिंग सिमुलेशन पर लौटिए। मूल समस्या कंप्यूटेशनल शक्ति की कमी लगती थी। लेकिन अकेले GPU ने उसे हल नहीं किया। एप्लिकेशन को समानांतर काम बताने, मेमोरी प्रबंधित करने, निष्पादन का समन्वय करने, ऑप्टिमाइज़ किए गणितीय संचालन इस्तेमाल करने और नतीजे सत्यापित करने का तरीका चाहिए था।
यही संबंध AI में भी दिखता है। डेवलपर जाने-पहचाने Python इंटरफ़ेस से मॉडल ट्रेन कर सकता है, क्योंकि उनके नीचे सॉफ़्टवेयर और हार्डवेयर की कई परतें मिलकर काम करती हैं।
यह सरलता निचली परतों को अप्रासंगिक नहीं बनाती। यह सक्षम हार्डवेयर पर बने एब्स्ट्रैक्शन के मूल्य को दिखाती है।
CUDA इसलिए मायने रखता है क्योंकि त्वरित हार्डवेयर तब सचमुच उपयोगी बनता है जब प्रोग्रामिंग मॉडल, इंटरफ़ेस, लाइब्रेरी और टूल सॉफ़्टवेयर को उसका प्रभावी ढंग से उपयोग करने देते हैं।
ज़्यादातर पाठकों के लिए इन संबंधों को समझना ही सही शुरुआत है। गहरे प्रोग्रामिंग विवरण तब सीखने चाहिए जब उनके काम को सचमुच उनकी ज़रूरत पड़े।
संदर्भ और आगे पढ़ने के लिए
- NVIDIA CUDA Programming Guide: host/device मॉडल, kernel, ग्रिड, मेमोरी और निष्पादन।
- NVIDIA CUDA Toolkit Documentation: API, toolkit के घटक, समर्थित टूल और लाइब्रेरी।
- NVIDIA CUDA C++ Best Practices Guide: मेमोरी की आवाजाही, प्रदर्शन मापन और ऑप्टिमाइज़ेशन।
- PyTorch CUDA Semantics: device, tensor, संचालन और सिंक्रनाइज़ेशन।
- AMD ROCm Documentation: तुलना के लिए वैकल्पिक GPU कंप्यूटिंग इकोसिस्टम।
- Khronos SYCL: क्रॉस-प्लेटफ़ॉर्म हेटरोजीनियस प्रोग्रामिंग मानक।
तकनीकी समीक्षा की तारीख़: 17 नवंबर 2026। प्रकाशन के समय सोर्स URL, सॉफ़्टवेयर क्षमताओं और रिलीज़-विशिष्ट कथनों की दोबारा पुष्टि करें।