

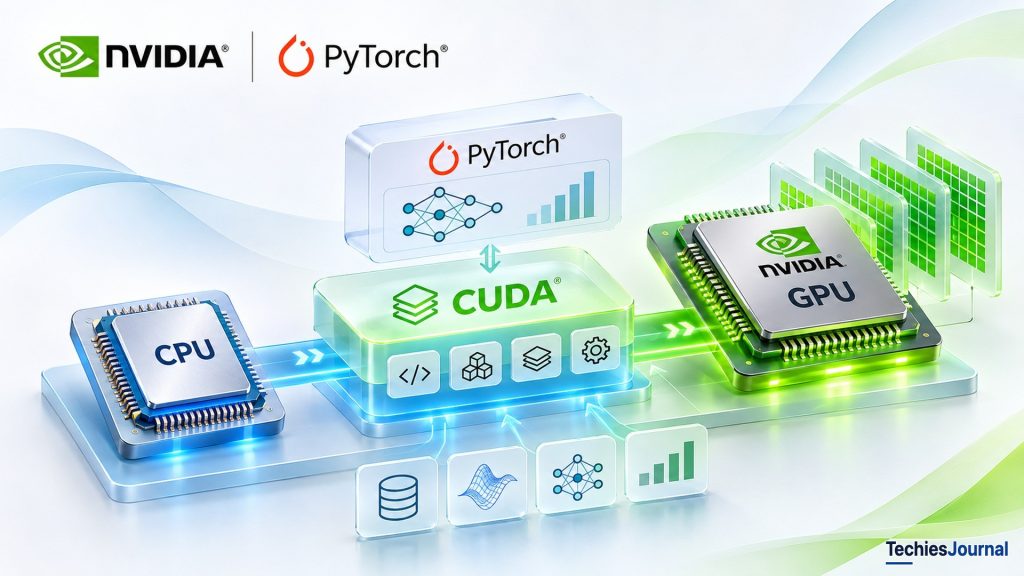
Comment les CPU et les GPU travaillent ensemble, ce qu’apporte CUDA, comment les frameworks d’IA l’utilisent et jusqu’où chaque métier doit l’approfondir.
Un ordinateur peut être extrêmement puissant et pourtant peiner sur certains types de calculs.
Prenons une équipe d’ingénieurs qui développe un logiciel pour simuler la façon dont la chaleur se propage dans une pièce d’avion. La simulation découpe la pièce en millions de petites régions et calcule de façon répétée l’évolution de la température dans chacune d’elles.
Chaque calcul peut être relativement simple. La difficulté tient au nombre de calculs à effectuer. L’équipe pourrait exécuter la simulation sur un processeur d’ordinateur classique. Mais à mesure que la simulation devient plus détaillée, la demande de calcul augmente. Une tâche qui prenait autrefois quelques minutes peut finir par en demander plusieurs heures, selon le modèle, les algorithmes et le matériel disponible.
Un processeur plus rapide peut aider. Mais une autre question prend de plus en plus d’importance : et si le problème pouvait être découpé en de nombreux calculs plus petits, traités en parallèle ?
C’est ici que la différence entre un CPU et un GPU devient importante.
Pourquoi les ordinateurs ont un CPU
Tout ordinateur à usage général s’appuie sur une unité centrale de traitement (CPU, Central Processing Unit) pour exécuter des instructions et coordonner une grande variété d’opérations. Quand vous ouvrez un navigateur, enregistrez un document, utilisez une application métier ou lancez un programme, le CPU joue un rôle important pour que ces opérations aient lieu.
Un CPU moderne contient plusieurs cœurs de traitement. Chaque cœur est conçu pour exécuter efficacement des instructions, et les CPU sont particulièrement efficaces pour les charges de travail qui comportent des opérations variées, des prises de décision, des chemins d’exécution changeants et des tâches qui dépendent des résultats d’instructions précédentes.
Les CPU peuvent aussi effectuer des traitements parallèles. Un processeur à plusieurs cœurs peut exécuter plusieurs tâches, ou plusieurs parties d’une charge de travail, en même temps, et les cœurs de CPU modernes peuvent effectuer plusieurs opérations mathématiques simultanément. Mais les CPU sont conçus pour concilier des besoins de calcul très différents. Ils ne sont pas optimisés exclusivement pour exécuter d’énormes quantités de calculs semblables.
Revenons à notre simulation thermique. Certaines parties exigent de coordonner des données, de prendre des décisions et de gérer l’ensemble du programme. Un CPU s’acquitte bien de ces responsabilités. D’autres parties consistent à appliquer de façon répétée des opérations mathématiques à des millions de régions. Cela ouvre la porte à un autre type de processeur.
Pourquoi les GPU sont différents
Un processeur graphique (GPU, Graphics Processing Unit) est un processeur conçu à l’origine pour accélérer les calculs liés aux graphismes. Le rendu d’une scène en trois dimensions suppose de calculer l’apparence d’un grand nombre de pixels, de surfaces, de textures et d’éléments géométriques. Beaucoup de ces calculs peuvent être effectués en parallèle.
Les architectures de GPU ont évolué pour offrir un débit de calcul élevé aux charges de travail qui présentent cette caractéristique. À la différence d’un CPU, qui consacre des ressources matérielles considérables à exécuter efficacement un large éventail de tâches, un GPU consacre une grande partie de son architecture au traitement parallèle de grandes quantités de travail adapté.
Cette différence rend les GPU précieux au-delà de l’affichage graphique. Notre simulation d’ingénierie contient elle aussi de grandes quantités d’opérations mathématiques apparentées. Avec un algorithme approprié, beaucoup de ces opérations peuvent potentiellement s’exécuter sur un GPU.
La simulation a toujours besoin d’un CPU. Le GPU ne remplace pas le processeur chargé d’exécuter l’application dans son ensemble. Le CPU et le GPU peuvent plutôt collaborer, chacun prenant en charge les parties de la charge de travail adaptées à son architecture.
Alternative textuelle accessible de cette figure
Le schéma compare quatre cœurs de CPU illustratifs à de nombreuses unités d’exécution GPU abstraites. Il n’est pas à l’échelle.
Texte affiché dans la figure : 1. Pourquoi les CPU et les GPU diffèrent | Les deux exécutent des calculs. Leurs points forts diffèrent, sans classement universel de vitesse. | CPU · Traitement généraliste | GPU · Débit parallèle | Cœur 1 | Cœur 2 | Cœur 3 | Cœur 4 | Tâches variées · flux de contrôle complexe | Nombreux calculs semblables en parallèle | Illustration seule : les cases ne comparent pas de vrais nombres de cœurs.
Il est tentant de conclure que les GPU sont simplement des CPU plus rapides. Ce n’est pas le cas. Un GPU peut surpasser nettement un CPU sur une charge de travail parallèle adaptée. Mais les applications qui comportent des dépendances séquentielles complexes, des opérations irrégulières ou de très petites quantités de travail peuvent en tirer peu de bénéfice.
Le déplacement des données entre la mémoire du CPU et celle du GPU, la coordination de l’exécution et l’allocation des ressources du GPU entraînent aussi des coûts. La performance dépend de la nature du problème, de l’implémentation et du matériel, et pas seulement de la disponibilité d’un GPU.
Si les GPU sont puissants, pourquoi a-t-on besoin de CUDA ?
Nous comprenons maintenant pourquoi un ingénieur voudrait utiliser un GPU. Mais repérer un matériel capable d’exécuter un calcul ne règle qu’une partie du problème. L’équipe d’ingénieurs dispose d’une application qui décrit la simulation au moyen d’opérations mathématiques, de structures de données et d’instructions de programme. Le GPU a une architecture d’exécution et un système de mémoire différents.
L’application ne peut pas simplement supposer qu’une fonction ordinaire de CPU s’exécutera efficacement sur des milliers de threads de GPU. Il lui faut un moyen de décrire quels calculs doivent s’exécuter sur le GPU, comment ce travail doit être organisé, comment les données deviennent disponibles et comment l’exécution est coordonnée.
Sans interfaces de programmation, compilateurs, bibliothèques et logiciels de support adaptés, une grande partie de la capacité de calcul du GPU resterait difficile à exploiter pour des applications à usage général. C’est le problème qui rend CUDA important.
Lorsque NVIDIA a annoncé CUDA en novembre 2006, l’entreprise a contribué à rendre les GPU NVIDIA compatibles programmables pour le calcul à usage général, et plus seulement pour le traitement graphique traditionnel. CUDA était à l’origine l’acronyme de Compute Unified Device Architecture.
Son importance ne tient pas au fait qu’il rend les GPU puissants. C’est l’architecture matérielle qui fournit la capacité de calcul. CUDA aide les développeurs de logiciels à exprimer et à exécuter du travail en s’appuyant sur cette capacité.
Avec le temps, l’écosystème qui l’entoure s’est étendu pour inclure des bibliothèques mathématiques, des compilateurs, des outils de débogage, des outils d’analyse des performances et des intégrations avec des logiciels de plus haut niveau. Ce socle est finalement devenu particulièrement important pour l’intelligence artificielle.
Aujourd’hui, un développeur peut entraîner un réseau de neurones avec Python et PyTorch sans nécessairement écrire de code CUDA directement. Pourtant, sous l’application Python, des logiciels compatibles avec CUDA peuvent être responsables de l’exécution d’une part substantielle du calcul sur le matériel GPU NVIDIA.
Pour comprendre cette relation, il faut examiner comment une application passe d’instructions de programme ordinaires à une exécution parallèle sur GPU.
De l’application au GPU : comprendre l’architecture de CUDA
Revenons à la simulation d’ingénierie. L’application doit préparer la simulation, charger les valeurs initiales, gérer les calculs et, au bout du compte, afficher ou stocker les résultats. Tout ce travail n’a pas sa place sur le GPU.
Le CPU reste chargé d’exécuter l’application principale, de coordonner les opérations et de lancer les calculs adaptés sur le GPU. Dans la terminologie CUDA, le côté CPU de l’application s’appelle l’hôte (host), tandis que le GPU s’appelle le périphérique (device). Cette distinction est importante, car l’hôte et le périphérique peuvent avoir des ressources d’exécution et des espaces mémoire différents.
Le code de la simulation côté CPU peut préparer des millions de valeurs de température. Il doit ensuite rendre ces valeurs accessibles au code du GPU. Une application CUDA typique peut utiliser le runtime pour allouer de la mémoire accessible au GPU, transférer des données, lancer des calculs sur le GPU, synchroniser l’exécution et récupérer les résultats. Sous ces interfaces destinées à l’application, les logiciels et le pilote de NVIDIA gèrent les interactions avec le matériel GPU.
Alternative textuelle accessible de cette figure
L’application se relie à l’hôte CPU et aux interfaces CUDA, qui accèdent au GPU NVIDIA par l’infrastructure du pilote. Architecture conceptuelle simplifiée.
Texte affiché dans la figure : 2. CUDA dans l’architecture de l’application | CUDA est une plateforme et un écosystème. Ce n’est ni un GPU ni une couche logicielle unique obligatoire. | Application de simulation d’ingénierie | CPU / Hôte | Contrôle et orchestration du programme | Interfaces / bibliothèques CUDA | Lancements de kernels, API de données et de calcul | Pilote NVIDIA + GPU compatible | Exécution périphérique | L’hôte et le périphérique coopèrent. Les API, les bibliothèques et le pilote ont des rôles différents.
Il y a ici une distinction d’architecture. CUDA n’est pas un composant logiciel unique placé entre chaque application et le GPU. C’est une plateforme et un écosystème de programmation plus larges, qui contiennent des interfaces, des outils et des bibliothèques aux responsabilités différentes. Certaines applications appellent directement les API CUDA. D’autres s’appuient sur des bibliothèques ou des frameworks qui utilisent CUDA en interne.
La relation devient plus claire quand on suit un calcul concret.
Que se passe-t-il quand CUDA exécute un calcul ?
Imaginons que notre équipe d’ingénieurs veuille calculer les variations de température sur un grand ensemble de régions. À titre d’illustration, supposons qu’une étape adaptée puisse être effectuée indépendamment pour de nombreuses régions, à partir des valeurs de l’étape de simulation précédente.
L’application prépare d’abord les données d’entrée. Elle s’assure ensuite que le GPU peut y accéder. Dans un flux de travail classique à mémoire explicite, l’application alloue de la mémoire sur le périphérique et copie les données de la mémoire du CPU vers celle du GPU. D’autres approches existent, dont la mémoire gérée (managed memory), mais l’exigence essentielle est la même : les données doivent être accessibles là où le calcul a lieu.
Une fois les données prêtes, l’application lance une fonction conçue pour s’exécuter sur le GPU. CUDA appelle cette fonction un kernel. Un kernel n’est pas une application complète. Il décrit un calcul particulier que des threads de GPU vont exécuter.
Pour notre simulation, un kernel peut calculer une valeur de température mise à jour pour chaque région à partir des valeurs voisines. Au lieu d’exécuter un calcul après l’autre sur un seul chemin d’exécution du CPU, l’application lance un grand ensemble de threads de GPU qui effectuent le travail adapté en parallèle.
Quand le kernel se termine, les résultats peuvent rester dans la mémoire du GPU pour une autre étape de simulation. Ce n’est que lorsque le CPU a besoin des valeurs (par exemple pour écrire un rapport ou afficher un résultat) que l’application peut les transférer vers la mémoire de l’hôte.
Alternative textuelle accessible de cette figure
Cinq étapes : préparer les données, les rendre accessibles au GPU, lancer le kernel, calculer sur le périphérique, exploiter les résultats. Une note sur la synchronisation est incluse.
Texte affiché dans la figure : 3. Un calcul CUDA, étape par étape | Exemple de simulation thermique en ingénierie. Les résultats GPU peuvent rester sur le périphérique pour les étapes suivantes. | 1 · Préparer | Le CPU crée les entrées | 2 · Rendre accessible | Allouer/copier ou mémoire gérée | 3 · Lancer le kernel | L’hôte soumet le travail GPU | 4 · Calculer | Les threads calculent | 5 · Exploiter | Étape GPU suivante ou lecture CPU | Le travail GPU peut être asynchrone. Synchronisez si nécessaire. | Le transfert est conditionnel : la mémoire unifiée/gérée et la réutilisation sur GPU changent le chemin.
Mesurez l’intérêt de conserver les résultats intermédiaires sur le GPU. Si une simulation exige des milliers d’étapes de traitement, renvoyer l’ensemble des données au CPU après chaque étape peut entraîner un surcoût considérable. Une meilleure conception peut effectuer de nombreuses opérations sur le GPU et ne transférer que ce dont le CPU a réellement besoin.
Cela illustre un principe plus large : l’accélération par GPU ne consiste pas seulement à rendre chaque opération mathématique plus rapide. Elle exige aussi de concevoir la façon dont le calcul et les données circulent dans le système.
Le CPU attend-il pendant que le GPU travaille ?
Pas nécessairement. De nombreuses opérations CUDA peuvent être lancées de façon asynchrone, ce qui permet au CPU de poursuivre d’autres tâches pendant que le GPU traite les opérations soumises auparavant. CUDA utilise des streams pour organiser les opérations GPU mises en file d’attente.
Les opérations soumises au même stream obéissent à des règles d’ordre, tandis que des opérations indépendantes placées dans des streams différents peuvent parfois se chevaucher, selon les dépendances et les capacités du matériel. L’application doit synchroniser quand elle a besoin de savoir qu’un travail donné est terminé ou quand une autre opération dépend de ses résultats.
Notre simulation peut préparer le lot d’entrées suivant pendant que le GPU traite le lot en cours. Mais si le calcul suivant dépend des résultats précédents, le programme doit préserver cette dépendance. L’exécution asynchrone peut améliorer l’utilisation des ressources. Elle ne supprime pas la nécessité d’une coordination correcte.
Comment CUDA répartit-il le travail sur des milliers de threads de GPU ?
Nous avons décrit un kernel comme une fonction qui s’exécute sur le GPU. Mais comment le GPU sait-il quel thread doit calculer quelle région ? CUDA fournit une hiérarchie d’exécution logique : les threads, les blocs de threads et les grilles.
Un thread représente une instance d’exécution logique d’un kernel. Chaque thread a accès à des identifiants qui l’aident à déterminer quelle partie de la charge de travail il doit traiter. Les threads sont organisés en groupes appelés blocs de threads. Un ensemble de blocs de threads forme une grille.
Prenons une simulation simplifiée de 1024 régions, traitées indépendamment pour une étape de calcul. Un développeur peut lancer quatre blocs de threads de 256 threads chacun. On obtient 1024 threads logiques, chacun potentiellement responsable d’une région. Chaque thread exécute le code du kernel, mais utilise son propre indice pour identifier la région qu’il doit mettre à jour.
Alternative textuelle accessible de cette figure
La grille comprend quatre blocs de 256 threads chacun. Un panneau matériel GPU distinct explique la planification sur les multiprocesseurs de flux.
Texte affiché dans la figure : 4. Hiérarchie d’exécution logique de CUDA | Exemple : 1024 threads logiques = 4 blocs × 256 threads. Pas 1024 cœurs physiques dédiés. | Un lancement de kernel · Grille | Bloc de threads 1 · 256 threads | Bloc de threads 2 · 256 threads | Bloc de threads 3 · 256 threads | Bloc de threads 4 · 256 threads | Matériel GPU | Multiprocesseurs de flux | planifient les blocs disponibles | Les warps exécutent les threads | Blocs et threads sont une organisation logicielle. SM et warps sont des notions d’exécution matérielle. | Dessinés : 16 des 256 threads de chaque bloc
L’objectif est de décrire une grande charge de travail parallèle sans affecter manuellement chaque calcul à une unité de traitement physique particulière. Les threads d’un même bloc peuvent utiliser les mécanismes de synchronisation pris en charge et la mémoire partagée pour échanger des données intermédiaires.
Cela peut être précieux dans notre simulation. La nouvelle température d’une région peut dépendre des régions voisines. Un kernel soigneusement conçu peut permettre à des threads coopérants de réutiliser des valeurs proches plutôt que de récupérer sans cesse les mêmes informations dans une mémoire plus lente.
Mais la programmation ordinaire par blocs de threads ne permet pas aux développeurs de supposer que tous les blocs s’exécutent simultanément, ni qu’un bloc peut se synchroniser librement avec tous les autres. Un algorithme qui exige une coordination globale doit tenir compte de ces restrictions ou recourir à des mécanismes appropriés.
Les threads CUDA sont-ils identiques aux cœurs physiques du GPU ?
Non. Les threads et les blocs décrivent la façon dont le logiciel organise le travail. Le GPU contient des ressources de calcul physiques qui exécutent ce travail. Les GPU NVIDIA contiennent des unités matérielles appelées multiprocesseurs de flux (SM, Streaming Multiprocessors), qui planifient et exécutent les blocs dans la limite des ressources disponibles.
Au sein d’un bloc, les threads sont regroupés en unités d’exécution appelées warps. Un warp CUDA classique contient 32 threads, tandis que le comportement précis de la planification et de l’exécution dépend de l’architecture. Une grille de plusieurs milliers de threads ne signifie pas que chaque thread reçoit un processeur physique dédié, ni que tous les threads s’exécutent simultanément.
Le développeur décrit le travail parallèle. Le matériel du GPU et ses mécanismes d’exécution déterminent la façon dont ce travail utilise les ressources disponibles. Cette distinction est l’une des idées d’architecture les plus importantes de CUDA.
La mémoire compte autant que la puissance de calcul
Un processeur rapide peut passer beaucoup de temps à attendre des données si une application accède à la mémoire de façon inefficace. Les GPU proposent donc plusieurs structures de mémoire conçues pour favoriser le débit.
Un grand jeu de données de simulation peut résider dans la mémoire globale du GPU. Les threads peuvent accéder à la mémoire globale, mais des accès répétés ou mal organisés peuvent être coûteux. Les threads d’un même bloc peuvent utiliser la mémoire partagée pour coopérer et réutiliser des données. Chaque thread peut utiliser des registres pour ses valeurs de travail, dans la limite du matériel.
L’idée n’est pas de mémoriser chaque type de mémoire. C’est que la performance dépend du calcul et de l’accès aux données.
Si des régions voisines ont sans cesse besoin des mêmes températures, une implémentation inefficace peut charger inutilement les mêmes valeurs un très grand nombre de fois. Une meilleure implémentation peut organiser les accès ou réutiliser des données partagées. Un GPU peut avoir une énorme capacité arithmétique et décevoir malgré tout sur le plan des performances si le logiciel ne parvient pas à lui fournir les données efficacement.
Comment CUDA est devenu un écosystème logiciel
La plupart des ingénieurs ne veulent pas implémenter chaque opération mathématique à partir de zéro. La simulation peut utiliser des opérations matricielles et des transformations numériques communes à de nombreuses applications. Développer et optimiser chacune séparément serait coûteux.
L’écosystème de CUDA fournit des bibliothèques et des outils réutilisables. cuBLAS implémente des opérations d’algèbre linéaire, et cuFFT prend en charge les transformées de Fourier rapides. Le CUDA Toolkit comprend des interfaces de programmation, des compilateurs et des outils pour développeurs, dont le compilateur nvcc pour CUDA C++.
L’API runtime donne aux applications un accès pratique aux mécanismes d’exécution courants. L’API pilote offre un contrôle de plus bas niveau sur les ressources et l’exécution. Les profileurs et les débogueurs aident les ingénieurs à inspecter les problèmes et les performances. Le pilote NVIDIA prend en charge l’interaction avec le matériel compatible.
Alternative textuelle accessible de cette figure
Quatre composants parallèles de l’écosystème CUDA se relient conceptuellement au pilote NVIDIA et au matériel GPU, avec des outils à côté.
Texte affiché dans la figure : 5. CUDA est un écosystème logiciel | Les composants sont des capacités et des chemins, pas une chaîne linéaire obligatoire. | Applications · Programmes CUDA C++ · Bibliothèques accélérées par GPU | Compilateur / nvcc | Construit les kernels CUDA | API runtime | Interface d’exécution courante | API pilote | Contrôle des ressources de plus bas niveau | Bibliothèques CUDA | cuBLAS · cuFFT · autres bibliothèques | Pilote NVIDIA et matériel GPU pris en charge | Profileurs et débogueurs observent l’exécution de ces composants.
Une application peut appeler une bibliothèque GPU préconstruite sans compiler de kernel personnalisé. Un framework de haut niveau peut masquer une grande partie de la gestion sous-jacente de la mémoire et de l’exécution. Ces différences comptent lors de la configuration des ordinateurs de développement et des environnements GPU dans le cloud : disposer d’un pilote et d’une version de framework compatibles n’équivaut pas à exiger de chaque développeur d’application qu’il installe et utilise le toolkit complet.
La valeur d’un accélérateur dépend non seulement des performances du matériel, mais aussi des logiciels disponibles pour l’exploiter. Des spécifications matérielles impressionnantes apportent peu de valeur pratique quand les bibliothèques, les frameworks, les compilateurs, les outils de diagnostic ou les applications compatibles manquent.
Comment l’IA moderne utilise CUDA sans l’exposer aux développeurs
Un ingénieur en IA commence généralement par un framework plutôt que par des kernels GPU écrits à la main. Dans PyTorch, le développeur définit les couches du modèle, prépare les données et opère sur des tenseurs, des structures numériques multidimensionnelles.
Les réseaux de neurones appliquent de façon répétée des transformations, comme la multiplication de matrices, à des tenseurs. Beaucoup de ces opérations peuvent tirer parti du parallélisme des GPU. Quand PyTorch effectue une opération prise en charge sur un GPU NVIDIA, son backend compatible avec CUDA répartit le travail entre des kernels adaptés et des bibliothèques accélérées.
Alternative textuelle accessible de cette figure
Application PyTorch vers backend CUDA, puis kernels et bibliothèques, puis GPU NVIDIA. Inclut une réserve propre à chaque opération.
Texte affiché dans la figure : 6. CUDA sous un framework d’IA | Un développeur PyTorch peut utiliser le calcul GPU NVIDIA sans écrire de kernels CUDA personnalisés. | Modèle Python / PyTorch | Tenseurs et opérations | Backend PyTorch compatible CUDA | Répartit les opérations prises en charge | Kernels et bibliothèques optimisées | L’implémentation varie selon l’opération | GPU NVIDIA + pilote | Exécute le travail GPU pris en charge | Toutes les opérations ne suivent pas le même chemin kernel/bibliothèque ni ne sont prises en charge sur GPU.
Il ne s’agit pas d’un chemin d’implémentation unique et figé. Selon les opérations PyTorch, des kernels, des bibliothèques ou des implémentations compilées différents peuvent être utilisés. Certaines opérations peuvent s’exécuter sur le CPU. Le placement sur le périphérique, les logiciels pris en charge et le comportement du framework déterminent ce qui se passe.
Prenons un exemple Python volontairement minimal :
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"

a = torch.tensor([1.0, 2.0, 3.0], device=device)
b = torch.tensor([4.0, 5.0, 6.0], device=device)

result = a + b
print(result.cpu())
Si PyTorch peut utiliser CUDA, les tenseurs et l’addition s’exécutent sur le périphérique CUDA sélectionné. Sinon, l’exemple utilise le CPU. Cela illustre le choix du périphérique, pas un gain de vitesse. Le développeur n’a pas écrit de kernel CUDA personnalisé. C’est le framework qui fournit l’implémentation correspondante.
Pourquoi comprendre CUDA si PyTorch s’en charge déjà ?
L’abstraction rend le calcul sur GPU plus accessible, mais elle n’élimine pas les dépendances d’architecture.
Imaginons qu’un modèle d’IA fonctionne sur un poste de travail mais échoue sur un serveur GPU dans le cloud. Le modèle Python peut être valide, alors qu’il manque à l’environnement déployé un pilote compatible, une version de framework compatible ou une architecture de GPU prise en charge. Ou bien le modèle peut fonctionner correctement mais offrir de mauvaises performances à cause de transferts excessifs entre CPU et GPU, d’opérations trop petites ou d’une synchronisation inutile.
Ces problèmes n’exigent pas toujours d’écrire du CUDA C++. Ils exigent en revanche une compréhension suffisante pour déterminer si la faute vient du code du modèle, du comportement du framework vis-à-vis du périphérique, des logiciels installés ou des déplacements de données.
Pour les ingénieurs cloud, les équipes de plateformes d’IA et les développeurs d’applications de production, cette compréhension de l’architecture peut être plus utile qu’une programmation immédiate de kernels de bas niveau.
Pourquoi CUDA ne rend pas automatiquement un logiciel plus rapide
Considérons deux versions de la simulation. La première traite des millions de régions de façon répétée et passe un temps substantiel en opérations numériques parallèles. Avec un algorithme adapté, elle peut bénéficier considérablement de l’accélération par GPU.
La seconde n’effectue que quelques centaines de calculs et a immédiatement besoin des résultats sur le CPU. Les transferts de données, la soumission du travail et la synchronisation peuvent coûter plus cher que le calcul lui-même. Même une grande charge de travail peut donner de mauvaises performances à cause de dépendances séquentielles, d’un travail mal équilibré ou d’un accès inefficace à la mémoire.
Une comparaison sérieuse mesure la charge de travail de bout en bout : préparation des entrées, placement des données, calcul, synchronisation, sortie et coût d’exploitation. Elle compare aussi avec une implémentation CPU solide et réaliste, et non avec une référence volontairement faible.
L’objectif n’est pas de maximiser l’utilisation du GPU. Il est d’améliorer un résultat de calcul réel.
Le calcul d’IA dépend-il entièrement de NVIDIA CUDA ?
Non. CUDA est central pour de nombreuses charges de travail sur GPU NVIDIA, mais le calcul accéléré va au-delà de CUDA. AMD développe l’écosystème logiciel ROCm, tandis que SYCL et d’autres approches prennent en charge d’autres modèles de programmation hétérogène et d’accélérateurs. Les applications d’IA peuvent aussi s’exécuter sur des CPU et sur d’autres accélérateurs.
Ces alternatives posent une question pratique d’architecture. Un framework de haut niveau peut proposer des API semblables d’un périphérique à l’autre, mais les bibliothèques, la compatibilité, les opérations prises en charge, les performances et le comportement au déploiement peuvent différer. La portabilité du code source de l’application ne garantit ni des performances équivalentes ni une simplicité d’exploitation équivalente.
Lorsqu’elle choisit du matériel pour un système d’IA en production, une équipe doit évaluer la charge de travail réelle, le framework et les bibliothèques pris en charge, la disponibilité, le prix, les compétences et la maintenance à long terme. La maturité logicielle de CUDA est un élément d’appréciation pertinent, pas un mandat universel de choisir du matériel NVIDIA.
Qui doit apprendre CUDA ?
Un étudiant qui apprend l’IA devrait commencer par la programmation, Python, la manipulation des données, les mathématiques et un framework d’apprentissage automatique pertinent. Comprendre ce que font un GPU et CUDA est utile, mais l’optimisation en CUDA C++ n’est généralement pas la première priorité.
Un développeur d’applications devrait comprendre le choix du périphérique et les dépendances de déploiement. Un ingénieur cloud devrait savoir comment s’articulent les pilotes compatibles, les frameworks et les ressources GPU. Un ingénieur en performance du ML peut avoir à examiner les kernels, la mémoire, la synchronisation et le profilage. Les spécialistes du calcul scientifique et des GPU peuvent avoir à concevoir et à optimiser directement des kernels CUDA.
La distinction Savoir → Utiliser → Maîtriser (Know → Use → Master) de TechiesJournal aide à définir le niveau de profondeur approprié :
- Savoir : expliquer CPU et GPU, hôte et périphérique, les kernels et la place de CUDA sous les frameworks d’IA.
- Utiliser : configurer et dépanner des environnements compatibles avec CUDA, et examiner des problèmes élémentaires de mémoire ou d’exécution.
- Maîtriser : développer et optimiser des kernels GPU, raisonner sur les ressources matérielles et arbitrer finement les compromis de performance.
Tout le monde n’a pas besoin de la dernière étape. Beaucoup de professionnels gagnent plus rapidement à acquérir une compréhension exacte de l’architecture qu’à mémoriser la syntaxe CUDA de bas niveau.
CUDA révèle quelque chose de plus large sur l’informatique moderne
Revenons à la simulation d’ingénierie. Le problème initial semblait être un manque de puissance de calcul. Mais le GPU seul ne l’a pas résolu. L’application avait besoin d’un moyen de décrire le travail parallèle, de gérer la mémoire, de coordonner l’exécution, d’utiliser des opérations mathématiques optimisées et de vérifier les résultats.
La même relation apparaît en IA. Un développeur peut entraîner un modèle avec des interfaces Python familières parce que plusieurs couches logicielles et matérielles collaborent en dessous.
Cette simplicité ne rend pas les couches inférieures sans importance. Elle démontre la valeur d’abstractions construites sur un matériel performant.
CUDA est important parce que le matériel d’accélération ne devient réellement utile que grâce aux modèles de programmation, aux interfaces, aux bibliothèques et aux outils qui permettent au logiciel de l’exploiter efficacement.
Pour la plupart des lecteurs, comprendre ces relations est le bon point de départ. Les détails plus profonds de la programmation viendront ensuite, quand leur travail l’exigera réellement.
Références et lectures complémentaires
- NVIDIA CUDA Programming Guide : modèle hôte et périphérique, kernels, grilles, mémoire et exécution.
- NVIDIA CUDA Toolkit Documentation : API, composants du toolkit, outils et bibliothèques pris en charge.
- NVIDIA CUDA C++ Best Practices Guide : déplacement des données, mesure des performances et optimisation.
- PyTorch CUDA Semantics : périphériques, tenseurs, opérations et synchronisation.
- AMD ROCm Documentation : écosystème alternatif de calcul sur GPU, à titre de comparaison.
- Khronos SYCL : standard de programmation hétérogène multiplateforme.
Date de la revue technique : 17 novembre 2026. Revérifiez les URL des sources, les capacités des logiciels et les affirmations propres à une version au moment de la publication.