

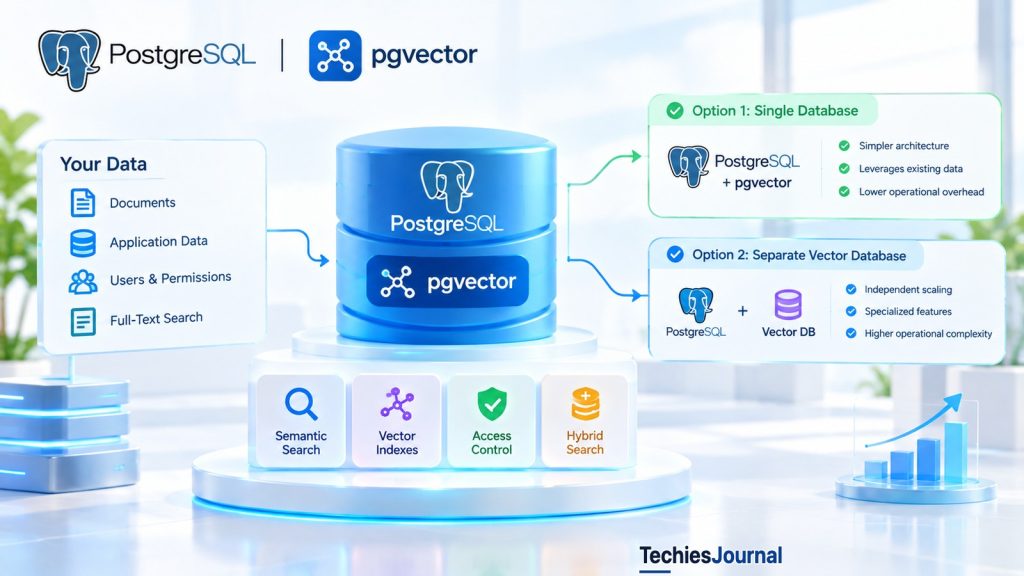
Une application d’IA peut conserver ses enregistrements métier, ses embeddings et ses documents consultables dans PostgreSQL, ou adopter un système vectoriel dédié. Le bon choix dépend de la qualité de la récupération, des contrôles d’accès, des besoins de montée en charge et du coût de la synchronisation de plusieurs systèmes de stockage de données.
Une organisation qui construit un assistant de connaissances fondé sur l’IA stocke peut-être déjà ses documents, ses utilisateurs et ses permissions dans PostgreSQL. Pour rendre ces documents consultables par leur sens, l’application a besoin de représentations vectorielles (embeddings). Il s’agit de représentations numériques du contenu qui permettent à un logiciel de trouver des passages sémantiquement proches.
Une première option consiste à stocker les embeddings avec les données de l’application grâce à l’extension pgvector. Une autre consiste à maintenir un système de recherche vectorielle distinct. Les deux architectures peuvent prendre en charge la génération augmentée par récupération (retrieval-augmented generation, RAG).
La question est de savoir si une base de données distincte résout un problème mesurable ou si elle introduit une complexité dont l’application n’a pas encore besoin.
Ce que pgvector apporte à PostgreSQL
PostgreSQL fournit déjà le stockage relationnel, les transactions, les jointures, l’indexation et la recherche plein texte (full-text search). pgvector ajoute des types de données vectoriels, des opérateurs de similarité et des index de recherche approximative des plus proches voisins, qui trouvent rapidement des correspondances proches sans examiner chaque vecteur.
Une application peut stocker dans PostgreSQL des fragments de documents, leurs embeddings et les métadonnées associées. Lorsqu’un utilisateur pose une question, l’application crée un embedding de cette question et recherche des embeddings de documents similaires. Les passages récupérés peuvent ensuite fournir du contexte à un modèle de langage qui génère une réponse.
pgvector ne génère pas d’embeddings, ne garantit pas l’exactitude des réponses produites par un modèle et ne détermine pas automatiquement si un document peut être lu sans risque par un utilisateur donné. Ces tâches restent de la responsabilité de l’application et de son architecture de sécurité.
Point important, pgvector est une extension, et non une fonctionnalité de PostgreSQL 19. Ses capacités existantes fonctionnent avec les versions de PostgreSQL prises en charge, et le README de pgvector indique la prise en charge de PostgreSQL 13 et des versions ultérieures : vérifiez donc quelles versions votre version de pgvector prend en charge. Pour ce qui change dans PostgreSQL lui-même, consultez notre article sur PostgreSQL 19 et sa version candidate.
Source : pgvector official documentation.
Comment une application RAG d’entreprise récupère les documents
Prenons un assistant de connaissances interne fictif, utilisé par les employés des services Finance et Ressources humaines. L’organisation stocke les documents et les métadonnées d’accès dans PostgreSQL. Chaque document est découpé en passages consultables, chacun étant associé à un embedding.
Une opération de récupération typique comporte plusieurs étapes.
1. Authentifier l’utilisateur. L’application établit l’identité de l’utilisateur et son contexte organisationnel autorisé.
2. Déterminer le périmètre documentaire autorisé. Le serveur identifie les documents auxquels l’utilisateur a le droit d’accéder, à partir de données d’autorisation fiables plutôt que d’instructions fournies par l’utilisateur.
3. Générer l’embedding de la question. Un modèle d’embedding convertit la question de l’utilisateur dans la même représentation vectorielle compatible que celle utilisée pour les passages stockés.
4. Récupérer les passages correspondants. PostgreSQL recherche du contenu sémantiquement similaire tout en appliquant les conditions d’accès aux documents appropriées.
5. Faire respecter la frontière d’accès. L’application vérifie que seul du contenu autorisé peut être transmis au modèle. La sécurité au niveau des lignes (row-level security) côté base de données peut fournir une couche de contrôle supplémentaire lorsqu’elle est correctement configurée.
6. Générer la réponse. Le modèle de langage utilise les passages autorisés comme contexte d’appui. L’application peut conserver les références des sources à des fins de traçabilité.
Authentifier
L’application établit l’identité de l’utilisateur et son contexte organisationnel autorisé.
Accès autorisé
Le serveur identifie les documents auxquels l’utilisateur a le droit d’accéder, à partir de données d’autorisation fiables plutôt que d’instructions fournies par l’utilisateur.
Encoder la requête
Un modèle d’embedding convertit la question de l’utilisateur dans la même représentation vectorielle compatible que celle utilisée pour les passages stockés.
Extraire
PostgreSQL recherche du contenu sémantiquement similaire tout en appliquant les conditions d’accès aux documents appropriées.
Un document des Ressources humaines peut être sémantiquement similaire, mais la similarité ne rend pas ce document autorisé.
Imposer la frontière
L’application vérifie que seul du contenu autorisé peut être transmis au modèle.
La sécurité au niveau des lignes (row-level security) côté base de données peut fournir une couche de contrôle supplémentaire lorsqu’elle est correctement configurée.
Générer
Le modèle de langage utilise les passages autorisés comme contexte d’appui.
L’application peut conserver les références des sources à des fins de traçabilité.
Supposons qu’un employé du service Finance pose une question sur une politique d’approbation des dépenses. Un document des Ressources humaines peut être sémantiquement similaire, mais la similarité ne rend pas ce document autorisé. La requête en base de données et les contrôles applicatifs qui l’entourent doivent empêcher les contenus restreints d’entrer dans le contexte du modèle.
Sécurité au niveau des lignes dans PostgreSQL
La sécurité au niveau des lignes (row-level security, RLS) de PostgreSQL peut restreindre les enregistrements qu’un rôle de base de données a le droit de lire ou de modifier. Elle peut aider à faire respecter les frontières entre locataires (tenants) ou entre documents, indépendamment du filtrage ordinaire effectué par l’application.
Cependant, activer la RLS ne rend pas automatiquement chaque connexion sûre. Les superutilisateurs et les rôles dotés de BYPASSRLS contournent les politiques. Les propriétaires de table contournent normalement la RLS, sauf si FORCE ROW LEVEL SECURITY est configuré. Les applications doivent aussi établir le contexte d’autorisation de manière sûre, en particulier lorsque les connexions sont mutualisées (pooling) ou réutilisées.
La RLS doit être testée avec des rôles d’utilisateur réalistes, y compris par des tests négatifs prouvant que les documents non autorisés ne peuvent pas être récupérés. Une clause ordinaire WHERE tenant_id = ... est utile pour filtrer les requêtes, mais ne doit pas être considérée comme une frontière de sécurité complète lorsque l’application appelante peut la modifier ou l’omettre.
Source : PostgreSQL, Row Security Policies.
La recherche exacte et les index approximatifs résolvent des problèmes différents
Par défaut, pgvector effectue une recherche exacte des plus proches voisins. Celle-ci trouve les vecteurs les plus proches selon la mesure de distance choisie, ce qui fournit une référence utile pour évaluer les résultats approximatifs. À mesure que les collections de vecteurs et les volumes de requêtes augmentent, la recherche exacte peut devenir plus coûteuse.
pgvector prend en charge deux principales méthodes d’indexation approximative.
| Index | Fonctionnement | Compromis important |
|---|---|---|
| HNSW | Organise les vecteurs en un graphe navigable | Bonnes caractéristiques de vitesse et de rappel pour de nombreuses charges de travail, avec un temps de construction et des besoins en mémoire supplémentaires |
| IVFFlat | Regroupe les vecteurs en listes et explore les listes sélectionnées | Nécessite des données d’entraînement adaptées et un réglage de l’étendue de la recherche |
Les index approximatifs peuvent renvoyer des résultats différents de ceux de la recherche exacte. C’est pourquoi la latence seule est une mesure de performance insuffisante. Les équipes doivent aussi mesurer le rappel (recall), qui indique combien des plus proches voisins attendus ont été récupérés par rapport à une référence de recherche exacte.
Pour un assistant d’IA, un résultat plus rapide peut être moins utile si un document important est systématiquement omis.
Le filtrage peut affecter la qualité de la récupération
Les recherches en entreprise dépendent rarement de la seule similarité vectorielle. Les résultats peuvent aussi être filtrés par organisation, type de document, projet ou périmètre d’accès. Avec les index approximatifs, PostgreSQL peut appliquer le filtrage après que le parcours d’index a sélectionné des candidats, ce qui peut renvoyer moins de résultats que demandé.
Par exemple, si une recherche examine 40 candidats et que seuls 10 % d’entre eux satisfont un filtre de catégorie, environ quatre peuvent rester en moyenne. Il s’agit d’une illustration de la sélectivité, et non d’un résultat garanti pour chaque recherche.
pgvector a introduit les parcours d’index itératifs (iterative index scans) dans la version 0.8.0, le 30 octobre 2024. Les parcours itératifs peuvent continuer à examiner davantage de candidats de l’index lorsque le filtrage élimine trop de résultats, dans la limite des ressources et des seuils de parcours configurés. D’autres approches incluent les index PostgreSQL ordinaires, les index vectoriels partiels et le partitionnement des tables, selon les schémas de requêtes. Ces mécanismes doivent être choisis à partir de mesures.
Les locataires qui partagent un même index approximatif peuvent aussi s’influencer mutuellement. La documentation de pgvector indique que les vecteurs d’un locataire peuvent modifier le rappel et la vitesse pour les autres locataires, et recommande le partitionnement par liste ou des tables distinctes pour isoler les locataires.
Un filtre d’autorisation correctement appliqué ne doit jamais être affaibli dans le seul but d’augmenter le nombre de résultats de recherche. Un système de récupération qui renvoie moins de passages autorisés peut produire une réponse moins complète. Renvoyer des passages non autorisés est une défaillance différente et plus grave.
Sources : pgvector changelog, pgvector filtering guidance et pgvector multitenancy.
La recherche hybride combine différentes formes de pertinence
La similarité sémantique est utile lorsque les utilisateurs décrivent un concept sans employer les termes exacts d’un document. La recherche par mots-clés reste importante pour les identifiants, les noms de produits, les numéros de politiques internes et les termes techniques.
PostgreSQL prend en charge la recherche plein texte au moyen de fonctionnalités telles que tsvector et tsquery. Les applications peuvent combiner ces résultats avec la recherche par similarité de pgvector. Par exemple, un assistant de connaissances qui recherche un numéro d’incident précis peut tirer parti d’une correspondance textuelle exacte, tandis qu’une question de dépannage plus large peut tirer parti d’une récupération sémantique.
Les résultats classés peuvent être combinés à l’aide de techniques telles que la fusion par rang réciproque (reciprocal rank fusion), qui fusionne deux listes classées selon la position, puis éventuellement reclassés à l’aide d’un autre modèle de pertinence. Cependant, la recherche hybride ne garantit pas une meilleure récupération dans chaque application. Les équipes doivent évaluer des questions représentatives, les documents attendus et la qualité du classement final.
Sources : PostgreSQL full-text search et pgvector hybrid search.
Quand une base de données vectorielle distincte devient-elle utile ?
Un système vectoriel dédié peut devenir pertinent lorsque les besoins de récupération d’une application dépassent ce que son environnement PostgreSQL existant peut prendre en charge efficacement. Il peut s’agir d’un trafic de recherche vectorielle à faire monter en charge indépendamment, d’une indexation distribuée spécialisée, de très grandes collections de recherche ou de fonctionnalités de récupération indisponibles dans le déploiement PostgreSQL choisi.
Mais déplacer les embeddings vers un autre système crée des responsabilités supplémentaires.
Prenons la mise à jour d’un document. L’application modifie le document source dans PostgreSQL. Elle doit aussi régénérer les embeddings concernés et mettre à jour l’index vectoriel. Tant que la synchronisation n’est pas terminée, les recherches peuvent récupérer du contenu obsolète.
La suppression pose un problème voisin. Supprimer un document de la base de données transactionnelle doit aussi supprimer ou invalider ses représentations vectorielles.
Les changements de permissions sont particulièrement importants. Si l’accès d’un utilisateur est révoqué, des métadonnées d’accès obsolètes dans un autre système de recherche ne doivent pas permettre à du contenu restreint d’atteindre le modèle.
Une architecture à deux systèmes de stockage de données a donc besoin d’un moyen fiable de propager les modifications, de gérer les défaillances, de réessayer sans risque et de déterminer quand les données de recherche sont à jour. La capture des modifications de données (change-data capture), qui diffuse les modifications hors de la base de données, les modèles de boîte d’envoi transactionnelle (transactional outbox), qui enregistrent l’événement de modification dans la même transaction que les données, et le traitement d’événements peuvent aider, mais chacun exige une mise en œuvre et une responsabilité d’exploitation clairement attribuée. La vérification d’autorisation qui fait foi doit rester applicable même lorsque l’index de recherche est en retard.
Un document change
L’application modifie le document source dans PostgreSQL.
Elle doit aussi régénérer les embeddings concernés et mettre à jour l’index vectoriel.
Tant que la synchronisation n’est pas terminée, les recherches peuvent récupérer du contenu obsolète.
Document supprimé
Supprimer un document de la base de données transactionnelle doit aussi supprimer ou invalider ses représentations vectorielles.
Permission révoquée
Si l’accès d’un utilisateur est révoqué, des métadonnées d’accès obsolètes dans un autre système de recherche ne doivent pas permettre à du contenu restreint d’atteindre le modèle.
Index en retard
Une architecture à deux systèmes de stockage de données a donc besoin d’un moyen fiable de propager les modifications, de gérer les défaillances, de réessayer sans risque et de déterminer quand les données de recherche sont à jour.
La vérification d’autorisation qui fait foi doit rester applicable même lorsque l’index de recherche est en retard.
Ces frontières de synchronisation font partie du coût de l’adoption d’un système vectoriel distinct.
Les modèles d’embedding introduisent une autre frontière de migration
Un embedding est généré à l’aide d’un modèle et d’une représentation donnés. Changer de modèle d’embedding peut modifier les dimensions des vecteurs, leurs distributions et le comportement de la similarité. Les embeddings produits par des modèles incompatibles ne doivent pas être combinés comme si leurs distances étaient directement comparables.
Les organisations doivent consigner les identifiants des modèles d’embedding, leurs versions et les paramètres de génération pertinents. Une migration de modèle peut exiger de générer de nouveaux embeddings, de reconstruire les index et d’évaluer la qualité de la récupération avant de basculer les requêtes de production. Pendant une transition, les anciennes et les nouvelles représentations peuvent devoir coexister.
pgvector présente aussi des limites d’indexation qui dépendent de la représentation. Sa prise en charge documentée de HNSW couvre les valeurs vector jusqu’à 2000 dimensions et les valeurs halfvec jusqu’à 4000 dimensions. Ces limites portent sur la représentation d’index en question, et non sur une restriction universelle applicable à toutes les stratégies de stockage ou de recherche possibles. Le choix du modèle d’embedding par l’application influe donc sur la conception des index.
Source : pgvector, Vector Types and Indexing Limits.
Comment une équipe doit-elle choisir ?
Une évaluation utile compare l’approche PostgreSQL existante à un système vectoriel distinct sur la même charge de travail représentative.
| Domaine d’évaluation | Question à se poser |
|---|---|
| Qualité de la récupération | Les passages pertinents attendus sont-ils trouvés de manière constante ? |
| Autorisation | Des documents non autorisés peuvent-ils, à un moment quelconque, atteindre le contexte du modèle ? |
| Performances | La latence de recherche atteint-elle l’objectif avec une concurrence réaliste ? |
| Filtrage | Les conditions sélectives sur les locataires et les métadonnées préservent-elles un rappel acceptable ? |
| Mises à jour et suppressions | À quelle vitesse l’index de recherche reflète-t-il les modifications des sources ? |
| Exploitation | Quels sont les besoins en matière d’indexation, de sauvegarde, de supervision et de reprise ? |
| Montée en charge | La demande de récupération peut-elle croître sans nuire aux charges de travail transactionnelles ? |
| Coût | Quelle est la dépense combinée d’infrastructure et de maintenance ? |
La comparaison ne doit pas supposer que la technologie la plus spécialisée est automatiquement la plus adaptée. Une application petite ou de taille moyenne peut constater que PostgreSQL avec pgvector répond à ses besoins avec moins de systèmes à gérer. Une application plus grande peut justifier un niveau de recherche indépendant lorsque l’isolation des charges de travail, des fonctionnalités spécialisées ou une montée en charge indépendante apportent des bénéfices mesurables. Ces résultats dépendent de la charge de travail et doivent être établis par des tests, et non par des seuils génériques de taille de base de données.
L’exploitation comprend aussi l’application des correctifs à l’extension. Le changelog de pgvector consigne des corrections pour une possible corruption d’index pendant le vacuum HNSW dans la version 0.8.3 du 17 juin 2026, et pour des dépassements de tampon (buffer overflows) lors de la construction d’index IVFFlat dans les versions 0.8.6 du 29 juillet (sur les systèmes 32 bits) et 0.8.7 du 1er octobre 2026. Les équipes doivent utiliser une version corrective récente et tester la maintenance des index, comme le vacuum et les reconstructions, avant de s’appuyer sur un index en production.
Ce à quoi se résume la décision d’architecture
PostgreSQL et pgvector permettent de conserver les enregistrements de l’application, les embeddings, les métadonnées et la recherche textuelle dans un seul environnement de base de données. Cela peut simplifier les applications d’IA qui dépendent déjà fortement de données relationnelles. Un système vectoriel distinct peut offrir des capacités précieuses, mais exige une attention particulière à la synchronisation, aux suppressions, à l’autorisation et à la responsabilité d’exploitation.
Aucune des deux architectures ne garantit automatiquement la pertinence de la recherche ni la sécurité de la récupération.
Partez d’exigences vérifiées en matière de récupération et de contrôle d’accès. Utilisez PostgreSQL avec pgvector lorsqu’il y répond efficacement, et introduisez un système vectoriel distinct lorsque les mesures justifient la complexité supplémentaire.
Références et lectures complémentaires
- pgvector, Official Repository. Types vectoriels pris en charge, recherche par similarité, indexation, filtrage et multilocataire (multitenancy).
- pgvector, Changelog. Historique des versions, parcours d’index itératifs et versions correctives.
- PostgreSQL, Row Security Policies. Comportement des autorisations en base de données et conditions de contournement.
- PostgreSQL, Full Text Search. Recherche par mots-clés et classement.
- PostgreSQL, Full Text Search Introduction. Les types
tsvectorettsquery. - PostgreSQL, EXPLAIN. Inspection des plans d’exécution et évaluation des performances.
- pgvector, Release and Security History. Versions de l’extension et mises à jour de maintenance.
Sources vérifiées le 6 novembre 2026. pgvector publie souvent de nouvelles versions, et la version 0.8.7 du 1er octobre 2026 a corrigé un bogue de construction d’index IVFFlat et n’est pas présentée comme introduisant les capacités d’architecture abordées ici : vérifiez donc les sources ci-dessus avant d’agir. Les conseils de performance et d’architecture sont des recommandations analytiques, et non des résultats de benchmark indépendants réalisés par TechiesJournal.