

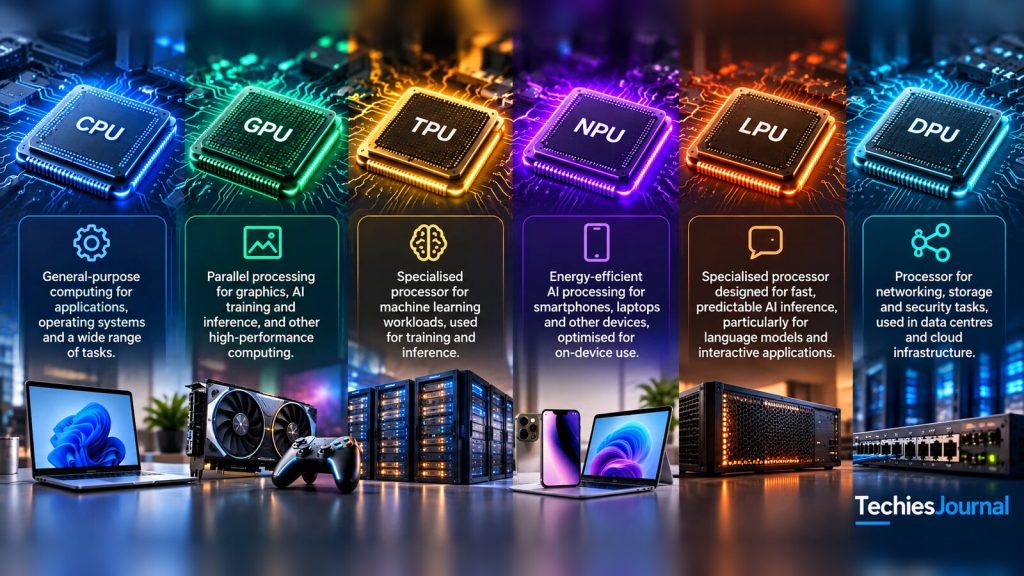
छह तरह के प्रोसेसर रोज़मर्रा की भाषा में समझाए गए हैं, फ़ोन, कंप्यूटर और AI सिस्टम के उदाहरणों के साथ।
छह तरह के प्रोसेसरों का AI-जनित वैचारिक चित्रण। चिप, डिवाइस और चित्र के लेबल कलात्मक चित्रण हैं, असली उत्पादों की तस्वीरें नहीं। चित्र का अंग्रेज़ी पाठ चित्रण का हिस्सा है।
जब आप ब्राउज़र खोलते हैं, गेम खेलते हैं, फ़ोन पर किसी फ़ोटो को बेहतर बनाते हैं या किसी AI असिस्टेंट से सवाल पूछते हैं, तब आपके डिवाइस या ऑनलाइन सेवा को अलग-अलग तरह के काम करने पड़ते हैं। कुछ कामों में लचीलापन चाहिए। कुछ में एक जैसी गणनाएँ हज़ारों बार दोहरानी होती हैं। कुछ में बहुत कम बिजली खर्च करनी होती है, या सर्वरों के बीच जानकारी कुशलता से पहुँचानी होती है।
इसीलिए कंप्यूटर और AI सेवाएँ अलग-अलग प्रोसेसर इस्तेमाल करती हैं। CPU और GPU के बारे में आपने शायद सुना होगा। TPU, NPU, LPU और DPU कम जाने-पहचाने हैं, और इनके नाम एक ही उत्पाद के प्रतिस्पर्धी संस्करणों जैसे लग सकते हैं। लेकिन ऐसा नहीं है।
कुछ AI मॉडल चलाते हैं, कुछ सामान्य एप्लिकेशन का काम संभालते हैं, और कुछ उन मॉडलों को सहारा देने वाले इन्फ्रास्ट्रक्चर की देखभाल करते हैं। आइए देखें कि हर एक कैसे काम करता है और आप उससे कहाँ मिल सकते हैं।
CPU: सामान्य-उद्देश्य वाला प्रोसेसर
CPU का मतलब है Central Processing Unit। यह लचीला प्रोसेसर है जो कई तरह के कंप्यूटर निर्देश संभालता है। आपका ऑपरेटिंग सिस्टम, ब्राउज़र, बिज़नेस एप्लिकेशन और कई सर्वर प्रक्रियाएँ CPU पर निर्भर करती हैं।
CPU में कई कोर होते हैं। हर कोर अलग निर्देश चला सकता है, प्रोग्राम के फ़ैसलों पर प्रतिक्रिया दे सकता है और मेमोरी तथा बाकी हिस्सों के साथ काम का तालमेल बिठा सकता है। एक कुशल रसोइये की कल्पना कीजिए जो ऑर्डर पढ़ता है, एक व्यंजन से दूसरे पर जाता है और अचानक आई माँगें भी संभाल लेता है। यह केवल एक उपमा है, लेकिन इससे समझ आता है कि लचीलापन क्यों मायने रखता है।
सामान्य उपयोग: Windows, macOS या Linux जैसा ऑपरेटिंग सिस्टम चलाना, एप्लिकेशन और डेटाबेस का लॉजिक निष्पादित करना, वेब अनुरोध प्रोसेस करना और AI एप्लिकेशन का तालमेल बिठाना। प्रदर्शन पर्याप्त हो तो CPU छोटे AI मॉडल भी चला सकते हैं।
ताकत: कई तरह के काम अच्छे से संभालता है। सीमा: समानांतर रूप से किए जा सकने वाले विशाल AI गणनाओं के लिए आमतौर पर समर्पित एक्सेलेरेटरों की तुलना में कम कुशल।
GPU: समानांतर प्रोसेसिंग का विशेषज्ञ
GPU का मतलब है Graphics Processing Unit। इसकी शुरुआत ग्राफ़िक्स के हार्डवेयर के रूप में हुई, जहाँ पिक्सेल और 3D वस्तुओं पर एक जैसी कई गणनाएँ करनी पड़ती हैं। यही क्षमता इसे AI के लिए उपयोगी बनाती है।
कल्पना कीजिए कि एक अकेला रसोइया असंबंधित कामों के बीच बदलने के बजाय, रसोई की एक टीम सैकड़ों एक जैसे व्यंजन एक साथ तैयार कर रही है। GPU उपयुक्त काम को कई समानांतर संक्रियाओं में बाँट देते हैं। आधुनिक GPU में मैट्रिक्स गणनाओं के लिए समर्पित हार्डवेयर भी होता है, यानी न्यूरल नेटवर्क में भारी मात्रा में इस्तेमाल होने वाली संख्यात्मक संक्रियाओं के लिए।
सामान्य उपयोग: गेम और 3D ग्राफ़िक्स, वैज्ञानिक सिमुलेशन, AI मॉडल का प्रशिक्षण और प्रशिक्षित मॉडल चलाकर टेक्स्ट, चित्र और अन्य परिणाम बनाना।
क्लाउड AI सेवा में उपयोगकर्ता का अनुरोध CPU संभाल सकता है और मॉडल GPU चला सकता है। GPU इसलिए महत्वपूर्ण हैं कि वे पर्याप्त समानांतर कंप्यूटिंग शक्ति और व्यापक सॉफ़्टवेयर इकोसिस्टम, दोनों एक साथ देते हैं।
ताकत: उपयुक्त गणनाओं को समानांतर रूप से करता है। सीमा: जब काम छोटा हो या उपलब्ध समानांतरता का उपयोग न कर सके, तब अधिक बिजली खाने वाला हार्डवेयर व्यर्थ हो सकता है। समानांतर निष्पादन मॉडल को और गहराई से NVIDIA की CUDA प्रोग्रामिंग गाइड समझाती है।
TPU: Google का विशेष AI एक्सेलेरेटर
TPU का मतलब है Tensor Processing Unit। यह मशीन-लर्निंग गणनाओं के लिए बनाए गए Google के प्रोसेसरों का परिवार है। टेन्सर संख्याओं का एक संग्रह है, और जाना-पहचाना मैट्रिक्स उसका एक उदाहरण है।
न्यूरल नेटवर्क इन्हीं संख्या-संग्रहों से बार-बार गणनाएँ करते हैं। TPU उस काम को तेज़ करने के लिए विशेष मैट्रिक्स-प्रोसेसिंग हार्डवेयर इस्तेमाल करते हैं। एक अहम डिज़ाइन में गणना इकाइयों का एक ग्रिड होता है जो मान एक इकाई से दूसरी को सौंपता है, कुछ-कुछ असेंबली लाइन की तरह। इसका तकनीकी नाम सिस्टोलिक ऐरे है। आधुनिक TPU में अन्य प्रोसेसिंग, मेमोरी और संचार घटक भी होते हैं।
सामान्य उपयोग: मशीन-लर्निंग मॉडल का प्रशिक्षण, AI इन्फ़रेंस चलाना और Google Cloud के ज़रिए समर्थित वर्कलोड तैनात करना।
ताकत: समर्थित मशीन-लर्निंग संक्रियाओं का कुशल निष्पादन। सीमा: आपको समर्थित सॉफ़्टवेयर और वर्कलोड पर विचार करना होगा, क्योंकि TPU अपने आप GPU से बेहतर विकल्प नहीं होता। Google का Cloud TPU परिचय साफ़ चर्चा करता है कि किन स्थितियों में CPU या GPU बेहतर हो सकते हैं।
NPU: डिवाइस पर कुशल AI प्रोसेसिंग
NPU का मतलब है Neural Processing Unit। यह न्यूरल-नेटवर्क को तेज़ करने वाला समर्पित हार्डवेयर है, जो अक्सर फ़ोन, लैपटॉप और एम्बेडेड डिवाइस में बना होता है। कई NPU समर्थित AI संक्रियाओं को किसी बड़े, सामान्य-उद्देश्य प्रोसेसर जितनी बिजली खर्च किए बिना करने के लिए डिज़ाइन किए जाते हैं।
फ़ोन फ़ोटो सुधारने या बोली प्रोसेस करने के लिए समर्पित AI हार्डवेयर इस्तेमाल कर सकता है। लैपटॉप संगत वीडियो-कॉल या एक्सेसिबिलिटी फ़ीचर के लिए NPU का उपयोग कर सकता है। NPU पर वास्तव में कौन से काम चलते हैं, यह डिवाइस, मॉडल और सॉफ़्टवेयर पर निर्भर करता है। बाकी हिस्से CPU या GPU संभाल सकते हैं।
सामान्य उपयोग: फ़ोन कैमरे, समर्थित बोली और भाषा फ़ीचर, वीडियो-कॉल इफ़ेक्ट, और एम्बेडेड तथा एज AI।
ताकत: संगत ऑन-डिवाइस वर्कलोड के लिए बिजली-कुशल AI त्वरण। सीमा: मॉडल का आकार, मेमोरी और समर्थित संक्रियाएँ डिवाइस के अनुसार बदलती हैं।
AI को स्थानीय रूप से चलाने से डेटा को किसी दूरस्थ सेवा को भेजने की ज़रूरत कम हो सकती है, लेकिन NPU होने भर से कोई एप्लिकेशन अपने आप निजी नहीं हो जाता। ऐप फिर भी जानकारी कहीं और भेज सकता है। Apple का Core ML दस्तावेज़ बताता है कि समर्थित मॉडल डिवाइस के अलग-अलग प्रोसेसर कैसे इस्तेमाल कर सकते हैं।
LPU: Groq का भाषा-मॉडल इन्फ़रेंस आर्किटेक्चर
LPU का मतलब है Groq की शब्दावली में Language Processing Unit। CPU या GPU के विपरीत, यह पूरे उद्योग में मान्य सामान्य प्रोसेसर परिवार नहीं है, बल्कि किसी एक कंपनी के इन्फ़रेंस आर्किटेक्चर से जुड़ा नाम है।
इन्फ़रेंस का मतलब है पहले से प्रशिक्षित मॉडल का उपयोग करके परिणाम बनाना। Groq अपनी LPU तकनीक को समर्थित मॉडलों के तेज़ और पूर्वानुमेय निष्पादन के लिए डिज़ाइन करता है। इसका कंपाइलर पहले से तय करता है कि कौन सी गणना कब होगी और जानकारी कहाँ जाएगी। यह आर्किटेक्चर तेज़ ऑन-चिप मेमोरी पर भी काफ़ी निर्भर है।
एक सावधानी से समय-निर्धारित असेंबली लाइन की कल्पना कीजिए, जहाँ हर स्टेशन जानता है कि जानकारी कब आएगी और आगे क्या करना है। इस डिज़ाइन के बारे में सोचने का यह एक आरंभिक तरीका है, हर संक्रिया का शाब्दिक वर्णन नहीं।
सामान्य उपयोग: समर्थित भाषा-मॉडल सेवा, इंटरैक्टिव AI एप्लिकेशन, और ऐसे सिस्टम जहाँ कम प्रतिक्रिया-विलंब मायने रखता है।
ताकत: उपयुक्त वर्कलोड पर पूर्वानुमेय निष्पादन और संभवतः बहुत तेज़ इन्फ़रेंस। सीमा: मॉडल की संगतता, मेमोरी क्षमता और कई चिप जोड़ने की ज़रूरत व्यावहारिक प्रदर्शन को प्रभावित करती है। टोकन तेज़ी से बनाने का मतलब यह नहीं कि पूरा एप्लिकेशन सस्ता या तेज़ होगा। कंपनी के आर्किटेक्चर विवरण के लिए Groq की LPU व्याख्या देखें।
DPU: इन्फ्रास्ट्रक्चर ऑफ़लोड प्रोसेसर
DPU का मतलब है Data Processing Unit। इसकी भूमिका ऊपर बताए प्रोसेसरों से अलग है। बड़े सर्वरों और डेटा सेंटरों को एप्लिकेशन चलते रहने के दौरान ही नेटवर्क ट्रैफ़िक ले जाना, स्टोरेज संक्रियाएँ संभालना और सुरक्षा नियंत्रण लागू करना होता है।
DPU, होस्ट CPU से चुने हुए इन्फ्रास्ट्रक्चर कार्य अपने ऊपर ले सकता है। एक लॉजिस्टिक्स टीम की कल्पना कीजिए जो डिलीवरी, प्रवेश-जाँच और माल की आवाजाही संभालती है, ताकि ऑर्डर तैयार करने वाले लोग अपने काम पर ध्यान दे सकें।
सामान्य उपयोग: डेटा-सेंटर नेटवर्किंग, चुनी हुई एन्क्रिप्शन और सुरक्षा प्रोसेसिंग, स्टोरेज I/O, इन्फ्रास्ट्रक्चर आइसोलेशन और बड़े AI क्लस्टरों का समर्थन।
ताकत: सहायक इन्फ्रास्ट्रक्चर संक्रियाओं को ऑफ़लोड करता है। सीमा: AI मॉडल की मुख्य गणनाएँ करने वाला प्रोसेसर यह सामान्यतः नहीं होता। एक कार्यान्वयन उदाहरण के रूप में NVIDIA का BlueField प्लेटफ़ॉर्म दस्तावेज़ उपलब्ध है।
छहों एक नज़र में
| प्रोसेसर | मुख्य काम | आप इसे कहाँ देख सकते हैं | AI में भूमिका |
|---|---|---|---|
| CPU | सामान्य-उद्देश्य कंप्यूटिंग | फ़ोन, लैपटॉप, सर्वर | एप्लिकेशन चलाता है, प्रोसेसिंग का तालमेल बिठाता है और मॉडल भी चला सकता है |
| GPU | समानांतर कंप्यूटिंग | PC, वर्कस्टेशन, AI सर्वर | प्रशिक्षण और इन्फ़रेंस |
| TPU | विशेष मशीन-लर्निंग गणना | Google इन्फ्रास्ट्रक्चर और Google Cloud | प्रशिक्षण और इन्फ़रेंस |
| NPU | कुशल न्यूरल-नेटवर्क त्वरण | फ़ोन, लैपटॉप, स्मार्ट डिवाइस | समर्थित ऑन-डिवाइस AI |
| LPU | Groq का विशेष इन्फ़रेंस निष्पादन | AI इन्फ़रेंस इन्फ्रास्ट्रक्चर | समर्थित कम-विलंब मॉडल सेवा |
| DPU | नेटवर्क, स्टोरेज और सुरक्षा ऑफ़लोड | डेटा सेंटर और बड़े सर्वर | AI वर्कलोड के आसपास के इन्फ्रास्ट्रक्चर को सहारा देता है |
ये सभी नाम समान श्रेणी के नहीं हैं। CPU, GPU, NPU और DPU व्यापक श्रेणियाँ बताते हैं। TPU Google का प्रोसेसर परिवार है, और LPU Groq की शब्दावली है। AWS Trainium समेत अन्य AI एक्सेलेरेटर भी मौजूद हैं। यह तालिका एक परिचय है, संपूर्ण सूची नहीं।
रोज़मर्रा की तकनीक में ये कहाँ दिखते हैं
स्मार्टफ़ोन में: CPU सामान्य एप्लिकेशन का काम संभालता है, GPU ग्राफ़िक्स और संगत गणनाएँ, और NPU या कोई समान न्यूरल एक्सेलेरेटर समर्थित AI फ़ीचर चला सकता है। हर फ़ोन में एक जैसे घटक या क्षमताएँ नहीं होतीं।
लैपटॉप या डेस्कटॉप में: CPU ऑपरेटिंग सिस्टम और एप्लिकेशन चलाता है। GPU ग्राफ़िक्स को तेज़ करता है, और उपयुक्त होने पर AI मॉडल को भी। कुछ नए लैपटॉप में स्थानीय AI फ़ीचर के लिए NPU होते हैं।
क्लाउड AI सेवा में: CPU एप्लिकेशन और उपयोगकर्ता अनुरोध संभालते हैं। GPU, TPU, LPU या अन्य समर्थित एक्सेलेरेटर मॉडल चला सकते हैं। बड़े पैमाने पर, सर्वरों के आसपास के कुछ नेटवर्किंग, सुरक्षा या स्टोरेज कार्यों में DPU मदद कर सकते हैं।
इस चित्र का सुलभ टेक्स्ट विकल्प
Figure 1 प्रोसेसर ज़िम्मेदारियों के तीन समूह दिखाता है। ये समूह मिलते हैं, इसलिए यह किसी ऐसे एक सिस्टम का आरेख नहीं है जिसमें सभी प्रोसेसर हों।
डिवाइस और ऐप्स, रोज़मर्रा की कंप्यूटिंग: CPU, GPU और NPU। एप्लिकेशन, ग्राफ़िक्स और समर्थित स्थानीय AI।
AI मॉडल निष्पादन, प्रशिक्षण या इन्फ़रेंस: GPU, TPU और LPU। मॉडल और वर्कलोड के अनुकूल हार्डवेयर चुनें।
इन्फ्रास्ट्रक्चर, बड़े सिस्टमों का सहारा: CPU और DPU। सर्वर प्रबंधन, नेटवर्क, सुरक्षा और स्टोरेज।
CPU डिवाइस समूह और इन्फ्रास्ट्रक्चर समूह दोनों में दिखता है। GPU डिवाइस समूह और AI मॉडल निष्पादन समूह दोनों में दिखता है।
हर प्रोसेसर के साथ एक छोटा काम-लेबल है: CPU सामान्य काम, GPU समानांतर गणित, TPU टेन्सर गणित, NPU ऑन-डिवाइस AI, LPU निर्धारित इन्फ़रेंस, DPU नेटवर्क और स्टोरेज ऑफ़लोड।
ये श्रेणियाँ उदाहरण हैं। उपयोग होने वाले प्रोसेसर डिवाइस और डिप्लॉयमेंट पर निर्भर करते हैं।
अलग-अलग प्रोसेसर मिलकर कैसे काम करते हैं
हाँ, वे साथ काम कर सकते हैं। मान लीजिए आप किसी क्लाउड AI असिस्टेंट से दस्तावेज़ का सारांश बनाने को कहते हैं।
आपका डिवाइस एप्लिकेशन चलाता है। क्लाउड सर्वर अनुरोध प्राप्त करता है, अनुमतियाँ जाँचता है और जानकारी तैयार करता है। कोई संगत एक्सेलेरेटर मॉडल की गणनाएँ करता है। फिर सर्वर परिणाम लौटा देता है।
बड़े डिप्लॉयमेंट में कुछ नेटवर्क या सुरक्षा कार्यों के लिए इन्फ्रास्ट्रक्चर प्रोसेसर भी इस्तेमाल हो सकते हैं। आपके फ़ोन या लैपटॉप के स्थानीय AI फ़ीचर इसके बजाय NPU का उपयोग कर सकते हैं।
इस चित्र का सुलभ टेक्स्ट विकल्प
Figure 2 किसी AI अनुरोध का एक संभव रास्ता सरल रूप में दिखाता है।
चरण 1. उपयोगकर्ता का डिवाइस ऐप को CPU पर चलाता है। स्थानीय GPU या NPU वैकल्पिक है। अनुरोध क्लाउड ऐप सर्वर को जाता है।
चरण 2. क्लाउड ऐप सर्वर में CPU अनुरोध और अनुमतियाँ संभालता है। फिर अनुरोध एक AI एक्सेलेरेटर तक जाता है।
AI एक्सेलेरेटर GPU, TPU या LPU में से चुना गया एक संगत विकल्प है। ये विकल्प हैं, तीन अनिवार्य चरण नहीं।
चरण 3. बनाया गया उत्तर उपयोगकर्ता को लौट आता है।
वैकल्पिक इन्फ्रास्ट्रक्चर सहायता: सर्वरों के आसपास चुने हुए नेटवर्क, स्टोरेज और सुरक्षा कार्य DPU संभाल सकता है।
याद रखने की अहम बात यह है कि हर AI एप्लिकेशन को छहों तरह के प्रोसेसर की ज़रूरत नहीं होती। छोटे मॉडल के लिए सामान्य CPU काफ़ी हो सकता है। शक्तिशाली AI सेवा कई तरह के हार्डवेयर को मिला सकती है।
सबसे पहले किस प्रोसेसर के बारे में सीखें
अगर आप कंप्यूटिंग में नए हैं, तो CPU और GPU से शुरू करें। सामान्य-उद्देश्य कंप्यूटिंग और समानांतर कंप्यूटिंग को समझना सबसे अच्छी बुनियाद देता है।
अगर आप मोबाइल या एम्बेडेड एप्लिकेशन बनाते हैं, तो जानें कि सॉफ़्टवेयर NPU का उपयोग कब कर सकता है और उसकी सीमाएँ क्या हैं। अगर आप AI मॉडल, क्लाउड डिप्लॉयमेंट या मशीन लर्निंग पर काम करते हैं, तो GPU और TPU जैसे विशेष एक्सेलेरेटर समझें। अगर आप डेटा-सेंटर नेटवर्किंग या इन्फ्रास्ट्रक्चर में काम करते हैं, तो DPU अधिक प्रासंगिक हो जाते हैं। और अगर आप कम-विलंब मॉडल सेवा का मूल्यांकन करते हैं, तो Groq का LPU समझने लायक एक आर्किटेक्चर है।
सिर्फ़ इसलिए कि AI चर्चाओं में छहों नाम आते हैं, आपको सबमें महारत हासिल करने की ज़रूरत नहीं है। इतना सीखें कि पहचान सकें कि हर एक क्या करता है, फिर जहाँ आपके काम को ज़रूरत हो वहाँ गहराई में जाएँ।
याद रखने लायक मुख्य अंतर
CPU लचीले सामान्य-उद्देश्य प्रोसेसर हैं। GPU उपयुक्त समानांतर काम में बेहतरीन हैं। Google के TPU मशीन-लर्निंग गणना को तेज़ करते हैं। NPU डिवाइस पर कुशल AI प्रोसेसिंग संभव बनाते हैं। Groq के LPU मॉडल इन्फ़रेंस के लिए विशेष तरीका अपनाते हैं। DPU चुने हुए इन्फ्रास्ट्रक्चर कार्य ऑफ़लोड करते हैं।
ये तकनीकें एक-दूसरे की पूरक हो सकती हैं, और कोई भी हर एप्लिकेशन के लिए सार्वभौमिक विकल्प नहीं है।
सबसे अच्छा प्रोसेसर केवल सबसे शक्तिशाली नहीं होता। वह वही है जो किए जाने वाले काम के अनुकूल हो।
स्रोत और आगे पढ़ने के लिए
संपादकीय स्रोत कटऑफ़: 17 October 2026। हर स्रोत 17 October 2026 को खोलकर जाँचा गया। कई स्रोत कंपनियों के अपने दस्तावेज़ हैं, इसलिए वे उन्हीं कंपनियों के उत्पाद बताते हैं और स्वतंत्र तुलना नहीं हैं।
- Intel: CPU vs GPU. सामान्य-उद्देश्य और समानांतर प्रोसेसिंग का परिचय।
- NVIDIA: CUDA Programming Guide. GPU का निष्पादन मॉडल और समानांतर प्रोग्रामिंग।
- Google Cloud: Introduction to Cloud TPU. TPU का उद्देश्य, उपयुक्त वर्कलोड और सीमाएँ।
- Apple: Core ML. Apple डिवाइस हार्डवेयर पर मशीन-लर्निंग मॉडल का उपयोग।
- Groq: What is a Language Processing Unit?. Groq द्वारा अपने आर्किटेक्चर की अपनी व्याख्या। प्रचार वाले प्रदर्शन दावों को स्वतंत्र बेंचमार्क परिणाम नहीं मानना चाहिए।
- NVIDIA: BlueField Networking Platform. DPU के नेटवर्किंग, सुरक्षा और स्टोरेज उपयोग।
- AWS: Trainium. इन छह परिचयात्मक नामों से बाहर के एक AI एक्सेलेरेटर का उदाहरण।
तकनीकी स्रोतों की समीक्षा 17 October 2026 को की गई। उत्पादों की क्षमताएँ बदलती रहती हैं, इसलिए ताज़ा जानकारी के लिए जुड़े हुए दस्तावेज़ देखें।