

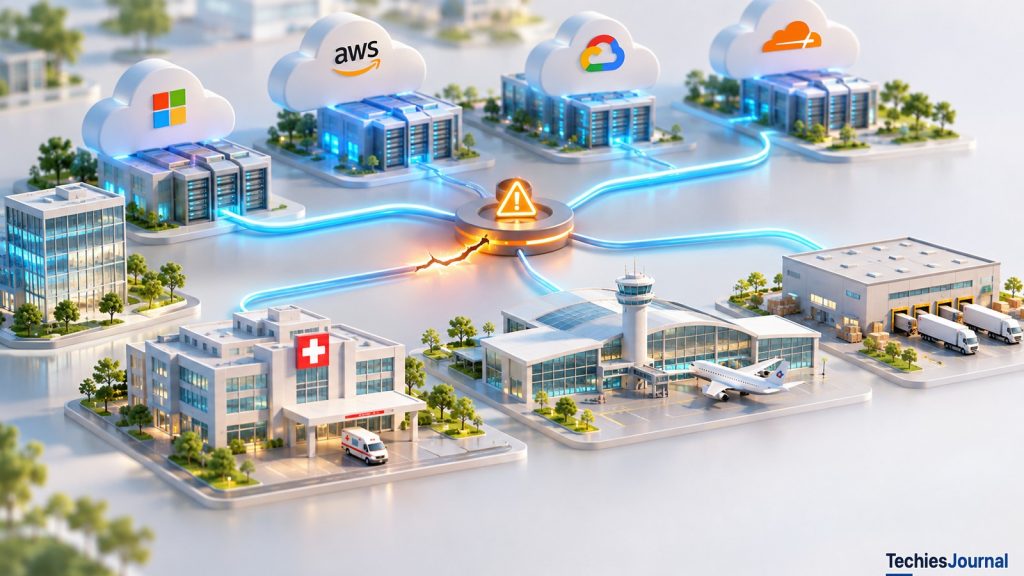
Ce que cinq ans de grandes perturbations technologiques révèlent des dépendances partagées, de l’impact sur l’activité et des décisions de résilience.
Une entreprise peut être perturbée alors que ses propres systèmes sont sains
Une organisation dispose de deux connexions réseau, de serveurs en cluster, de bases de données répliquées, de sauvegardes et d’un site de reprise après sinistre. Ses ingénieurs ont passé des années à supprimer les points de défaillance internes connus. Puis les employés perdent l’accès à un service externe essentiel. Les équipements de l’organisation fonctionnent, et pourtant un processus métier important ne peut plus se poursuivre normalement.
Cela ne prouve pas que le cloud a affaibli la fiabilité. Dans de nombreux cas, les plateformes cloud offrent une disponibilité, une sécurité et une capacité opérationnelle supérieures à ce qu’une organisation pourrait construire elle-même à un coût raisonnable. Mais confier ses systèmes à un fournisseur externe change ce qu’une entreprise peut prévenir, ce dont elle peut se remettre directement, et ce qu’elle doit subir pendant que quelqu’un d’autre rétablit le service.
La distinction compte parce qu’un processus métier dépend rarement d’une seule application. La commande d’un client peut nécessiter un service d’identité, un intermédiaire de paiement, une plateforme de sécurité réseau et un système de données. N’importe lequel peut devenir une contrainte, même si les autres fonctionnent.
La question n’est pas de savoir si les entreprises doivent éviter les fournisseurs de cloud et de logiciels en tant que service (SaaS). Il s’agit de savoir si leurs plans de continuité tiennent compte de toute la chaîne de technologies et d’organisations nécessaire pour fournir les services essentiels.
Cinq ans de perturbations importantes
Les incidents ci-dessous ont été retenus pour leurs conséquences documentées et leurs mécanismes de défaillance différents. Il s’agit d’un registre illustratif, pas d’un recensement des pannes dans le monde. Les durées et les impacts renvoient à des mesures différentes et ne doivent pas être comparés comme s’il s’agissait de la même statistique.
| Date | Incident | Impact opérationnel ou financier documenté | Ce que le cas illustre |
|---|---|---|---|
| Avril 2022 | Atlassian Cloud | 883 sites représentant 775 clients supprimés, certaines restaurations s’étendant jusqu’à 14 jours | La reprise à grande échelle peut différer d’un basculement ordinaire Revue Atlassian |
| Février 2024 | Change Healthcare | UnitedHealth a déclaré 2,2 milliards de dollars de coûts directs de réponse en 2024 et 867 millions de dollars d’impacts de perturbation de l’activité chez Optum Insight | Des intermédiaires de transactions critiques relient de nombreuses organisations par ailleurs indépendantes Formulaire 10-K 2024 d’UnitedHealth |
| Juillet 2024 | Mise à jour logicielle de CrowdStrike | Delta a déclaré environ 7000 vols annulés, un impact de 380 millions de dollars sur les revenus et 170 millions de dollars de dépenses supplémentaires | Des composants logiciels communs peuvent prolonger la reprise opérationnelle Formulaire 10-K 2024 de Delta |
| Juin 2025 | Google Cloud | Perturbation étendue de services, issue d’une infrastructure partagée de gestion d’API | Les dépendances globales de politiques et de contrôle peuvent affecter de nombreux services Rapport d’incident Google Cloud |
| Juin 2025 | Cloudflare | Cloudflare indique 2 heures et 28 minutes de perturbation touchant plusieurs produits | Une plateforme peut dépendre du service de stockage d’un autre fournisseur Rapport d’analyse Cloudflare de juin 2025 |
| Octobre 2025 | AWS us-east-1 | Des problèmes DNS liés à DynamoDB ont été suivis de difficultés de rétablissement d’EC2 et des répartiteurs de charge | Corriger la défaillance initiale ne rétablit pas immédiatement tous les services dépendants Rapport d’incident AWS |
| Novembre 2025 | Cloudflare | Perturbation étendue causée par la propagation de données de configuration | Des chemins de configuration communs peuvent créer une exposition partagée Rapport d’analyse Cloudflare de novembre 2025 |
| Février 2026 | Google Vertex AI Gemini API | Hausse des erreurs d’API pendant environ 1 heure et 58 minutes | Des applications reposant sur l’IA peuvent partager les dépendances classiques des plateformes Rapport d’état Google Cloud |
| Novembre 2026 | Microsoft Exchange Online | La connectivité aux boîtes aux lettres et certaines fonctions dépendantes de Microsoft 365 ont été touchées les 12 et 13 novembre. La cause racine préliminaire de Microsoft était une mise à niveau antérieure de la capacité réseau. Les pertes financières consolidées n’ont pas été vérifiées | Des fonctions SaaS peuvent partager des services sous-jacents même lorsque les noms de produits diffèrent Extrait PennO365 des rapports d’incidents de Microsoft |
Le tableau seul ne peut pas établir que les pannes deviennent plus fréquentes. La recherche 2025 d’Uptime Institute a même fait état d’une quatrième année consécutive de baisse de la fréquence globale des pannes et de leur gravité générale déclarée. Elle a aussi averti que les données sur les pannes doivent être traitées avec scepticisme, en raison d’une transparence limitée et d’un signalement peu fiable. Analyse d’Uptime Institute
Une comparaison plus utile consiste à se demander comment une perturbation est passée d’un composant technique à un processus métier, et quelle reprise restait possible pour les personnes qui en dépendaient.
La différence entre avoir des sauvegardes et reprendre le travail : Atlassian
En avril 2022, un script de maintenance d’Atlassian a supprimé des sites cloud entiers au lieu des seules informations d’application visées. La revue post-incident d’Atlassian indique 883 sites et 775 clients touchés, les dernières restaurations ayant été achevées le 18 avril. Certains clients ont connu une perturbation pouvant aller jusqu’à 14 jours. Revue Atlassian
Atlassian disposait de mécanismes de reprise, mais son processus de restauration établi était adapté à des sites individuels ou à de petits groupes. Reconstruire des centaines de sites répartis sur des produits connectés a exigé des procédures et une automatisation supplémentaires. La revue de l’entreprise décrit aussi comment la suppression des enregistrements de sites a perturbé les flux de contact et de support utilisés pour communiquer avec les clients.
La distinction essentielle porte sur trois questions : l’infrastructure peut-elle survivre à la défaillance d’un composant ? Les données sont-elles protégées ? Un service métier complet peut-il être restauré à l’échelle et à la vitesse requises ? Une réponse positive à l’une ne garantit pas les autres.
Pour un client, cela suggère un test de continuité proportionné. Identifier quel travail s’arrêterait si le produit SaaS était indisponible pendant un jour ou une semaine. Déterminer si les documents essentiels, les coordonnées, les validations ou les instructions de travail sont accessibles par une méthode indépendante approuvée. Une plateforme SaaS entièrement dupliquée n’est peut-être pas nécessaire. Un moyen testé de poursuivre le travail le plus important peut être plus utile.
Le service de transactions partagé : Change Healthcare
La cyberattaque de février 2024 contre Change Healthcare a perturbé les services de transactions de santé. UnitedHealth a isolé les systèmes touchés pour contenir la menace, ce qui a contribué à interrompre les demandes de remboursement et les flux liés aux paiements pour les organisations qui s’appuyaient sur la plateforme. Il s’agissait d’un incident de cybersécurité, pas d’une panne ordinaire d’infrastructure cloud. Formulaire 10-K 2024 d’UnitedHealth
Dans son rapport annuel 2024, UnitedHealth a déclaré 2,2 milliards de dollars de coûts directs de réponse et un montant estimé de 867 millions de dollars d’impacts de perturbation de l’activité chez Optum Insight. Elle a aussi déclaré avoir accordé plus de 9 milliards de dollars de prêts sans intérêt à des prestataires de soins jusqu’à la fin de 2024. Le document indique que les 2,2 milliards de dollars de coûts directs de réponse comprennent les coûts liés à l’octroi de ces prêts. Les prêts eux-mêmes représentent un soutien financier et ne doivent pas être ajoutés aux pertes de l’incident. Les catégories financières du document ne doivent pas non plus être transformées en estimation unique de la perte pour l’ensemble du secteur. Formulaire 10-K 2024 d’UnitedHealth
L’incident montre comment un seul intermédiaire peut être essentiel aux transactions entre de nombreuses organisations par ailleurs indépendantes. Leurs propres serveurs et réseaux peuvent rester disponibles, et pourtant les demandes de remboursement et les paiements peuvent être interrompus parce qu’une étape externe nécessaire ne peut pas être menée à bien.
Le problème pratique n’est pas de savoir si chaque prestataire de santé doit gérer son propre réseau de transactions. Il s’agit de savoir si les processus métier critiques ont été cartographiés à travers l’intermédiaire externe, si des dispositions alternatives sont réalisables sur les plans contractuel et technique, et si les mesures de contingence en matière de trésorerie ou de processus manuels sont adaptées à une interruption prolongée.
Quand les ordinateurs reviennent mais pas les opérations : CrowdStrike et Delta
Le 19 juillet 2024, une mise à jour défectueuse du contenu de sécurité de CrowdStrike a provoqué des défaillances généralisées sur les systèmes Windows. Le problème sous-jacent était un composant logiciel commun, et non une panne universelle d’une région cloud. Formulaire 10-K 2024 de Delta
Delta Air Lines a divulgué environ 7000 annulations de vols en cinq jours, un impact direct estimé de 380 millions de dollars sur les revenus et environ 170 millions de dollars de dépenses d’exploitation supplémentaires. Elle a aussi indiqué environ 50 millions de dollars de dépenses de carburant évitées en raison des vols annulés. Ce sont des effets financiers distincts déclarés par l’entreprise, et non un calcul confirmé de perte nette pour l’ensemble de l’incident. Formulaire 10-K 2024 de Delta
Une compagnie aérienne doit coordonner avions, équipages, passagers, aéroports et horaires. Remettre un ordinateur en service ne ramène pas instantanément tous ces éléments à leur état opérationnel normal. Les retards créent des arriérés, et les arriérés créent du travail de reprise supplémentaire.
Cette différence vaut au-delà des compagnies aériennes. Un système de commandes rétabli peut encore contenir des transactions à rapprocher. Une plateforme de service client restaurée peut devoir absorber une file d’attente accumulée. Un système hospitalier peut devoir reprogrammer des soins. Une entreprise devrait donc mesurer non seulement le temps nécessaire au retour de sa technologie, mais aussi le temps nécessaire pour que l’activité puisse de nouveau fournir un service acceptable.
Une dépendance derrière le fournisseur : Google Cloud et Cloudflare
Le 12 juin 2025, une modification d’informations de politique distribuées à l’échelle mondiale a interagi avec un défaut logiciel dans l’infrastructure de gestion d’API de Google Cloud. Plusieurs services Google ont été perturbés. Le rapport d’incident de Google indique que le nouveau chemin de code ne comportait ni gestion des erreurs ni protection par indicateur de fonctionnalité, de sorte que des champs de politique vides, répliqués à l’échelle mondiale en quelques secondes, ont fait planter à répétition le service de contrôle des politiques dans chaque région. Un kill switch a mis fin à l’essentiel de l’impact en environ 40 minutes, tandis que le rétablissement dans us-central1 a pris jusqu’à environ 2 heures et 40 minutes. Rapport d’incident Google Cloud
Le même jour, Cloudflare a indiqué deux heures et 28 minutes d’impact sur des services dont Workers KV, Access, Gateway, WARP et Turnstile. Sa propre chronologie s’étend un peu plus longtemps, sur environ deux heures et 36 minutes. Cloudflare a identifié la défaillance d’une dépendance de stockage externe utilisée par Workers KV comme déclencheur immédiat. Plusieurs produits Cloudflare s’appuyaient sur ce service pour la configuration, l’authentification ou la diffusion de contenu. L’entreprise a indiqué que des services importants non touchés étaient restés opérationnels, notamment le DNS principal et une grande partie des fonctions de son CDN. Rapport d’analyse Cloudflare de juin 2025
Ici, une entreprise pouvait dépendre de Cloudflare alors que Cloudflare dépendait lui-même d’un autre service d’infrastructure. L’entreprise peut n’avoir aucune relation directe avec ce fournisseur sous-jacent. Compter les fournisseurs directs, ou exploiter des applications sur différentes plateformes, n’établit pas nécessairement des chemins de défaillance indépendants.
La leçon est de retracer les dépendances au niveau qui compte pour une fonction métier critique. Il est aussi important de ne pas supposer que chaque fonctionnalité d’un fournisseur est tombée en panne. Identifier précisément les services touchés fait partie d’une évaluation honnête de la résilience.
Pourquoi le rétablissement d’un composant n’a pas suffi à terminer la reprise d’AWS
En octobre 2025, un problème de gestion DNS impliquant Amazon DynamoDB dans la région us-east-1 a affecté les connexions à un point de terminaison régional. Le rapport post-événement d’AWS décrit ensuite des problèmes de lancement d’instances EC2, de gestion des hôtes et de contrôles de santé de Network Load Balancer. Rapport d’incident AWS
Le problème initial de DynamoDB a été résolu avant que toutes les opérations dépendantes se soient rétablies. Certaines instances EC2 existantes sont restées saines alors que le lancement de nouvelles instances était altéré. Cette distinction change ce que les clients vivent réellement. Une charge de travail qui s’exécute sur une capacité existante suffisante peut continuer à fonctionner, tandis que celle qui a besoin de nouvelles instances, d’une capacité de remplacement ou de certaines opérations de gestion peine à fonctionner.
La préoccupation d’ingénierie pertinente n’est pas simplement de savoir s’il existe plusieurs zones de disponibilité. Il s’agit de savoir si une action de reprise envisagée dépend d’un service partagé qui pourrait lui aussi être altéré. Par exemple, un plan de basculement qui nécessite de nouvelles capacités doit être testé face aux contraintes de capacité et de services de contrôle, plutôt que de supposer que le provisionnement réussit toujours.
Pannes du plan de contrôle cloud : pourquoi des serveurs qui tournent ne garantissent pas un service qui fonctionne, publié par TechiesJournal, explique comment ces services de contrôle tombent en panne. Ils importent ici seulement parce qu’ils aident à expliquer l’écart entre un fournisseur qui rétablit son infrastructure et un client qui rétablit sa fonction métier.
Ce que l’incident récent de Microsoft 365 apporte
Le 12 novembre 2026, Microsoft a signalé des problèmes de connectivité aux boîtes aux lettres Exchange Online, pouvant affecter Outlook on the web et plusieurs protocoles de connexion. Les mises à jour pendant l’incident décrivaient un grand nombre de serveurs devenus indisponibles de façon inattendue, ce qui a reporté la charge sur le reste de l’infrastructure, et un processus central des serveurs touchés devenu saturé. Des mises à jour ultérieures ont décrit une amélioration de la stabilité après que Microsoft a appliqué un correctif à un composant amont de configuration d’authentification et de routage. Extrait PennO365 des rapports d’incidents de Microsoft
Au 14 novembre, les enregistrements que Microsoft avait envoyés au service PennO365 de l’University of Pennsylvania montraient les deux incidents comme service rétabli. Microsoft a donné une cause racine préliminaire : un problème introduit lors d’une mise à niveau antérieure de la capacité réseau, apparu après une récente modification du réseau. Elle a indiqué qu’il s’agissait d’un problème technique sans lien avec une cyberattaque ou l’IA, et qu’un rapport post-incident complet suivrait.
Microsoft a aussi signalé des effets sur certaines fonctionnalités d’autres produits Microsoft 365 qui s’appuyaient sur Exchange Online. Cela ne signifie pas que chaque produit connecté ou chaque fonctionnalité était indisponible.
Limite des preuves, examen du 14 novembre 2026 : le champ officiel de cause racine de Microsoft était encore vide et son rapport post-incident complet n’avait pas été publié dans les enregistrements examinés, de sorte que la cause préliminaire peut changer. Les deux enregistrements d’incident donnent aussi des heures de fin différentes. Les pertes financières consolidées de l’activité n’ont pas été vérifiées. En conséquence, cet incident est une illustration récente des dépendances fonctionnelles du SaaS, et non une base pour affirmer une perte financière ou pour établir une attribution définitive de la cause.
Le risque se situe dans le processus métier, pas seulement dans l’application
Pris ensemble, ces cas montrent quatre façons différentes dont le travail essentiel peut s’arrêter. Des données peuvent être difficiles à restaurer à grande échelle. Un intermédiaire de transactions peut être indisponible. Un logiciel partagé peut interrompre de nombreuses organisations à la fois. Un service qui semble indépendant peut reposer sur un autre fournisseur ou sur un composant de contrôle commun.
L’unité d’analyse utile est un service métier important. Imaginez une entreprise qui accepte un paiement en ligne. Sa boutique peut rester en bon état alors que l’intermédiaire de paiement est indisponible. À l’inverse, sa boutique peut être hors ligne alors qu’un processus téléphonique ou manuel approuvé préserve une partie limitée de l’activité essentielle. Dans les deux situations, un pourcentage de disponibilité de l’application ne suffit pas, à lui seul, à mesurer l’expérience du client.
Alternative textuelle accessible de cette figure
Le service est une chaîne de cinq maillons : boutique, service d’identité, intermédiaire de paiement, plateforme de sécurité et système de données.
Quatre maillons fonctionnent. L’intermédiaire de paiement est en panne.
Sans plan, le client ne peut pas payer et le service métier s’arrête.
Avec un repli testé, un processus téléphonique ou manuel approuvé contourne le maillon rompu, et les paiements essentiels continuent de façon limitée.
Ce n’est pas une découverte nouvelle. Les pratiques établies de continuité et de résilience opérationnelle distinguent déjà la reprise technique de la poursuite des fonctions métier critiques. Les recommandations du NIST en matière de planification de la continuité et les cadres de résilience opérationnelle du secteur financier mettent l’accent sur l’impact sur l’activité, les dépendances, les priorités de reprise et les tests. Recommandations du NIST sur la planification de la continuité Recommandations de la Bank of England sur la résilience
Le changement pour une entreprise moderne est d’appliquer ces questions aux services externes et en aval qu’elle n’exploite pas directement.
Que nous disent réellement les pertes ?
Delta et UnitedHealth divulguent des impacts importants, mais ils décrivent des catégories de coûts différentes et des environnements d’activité très différents. Additionner ces chiffres produirait un nombre impressionnant sans interprétation utile.
Uptime Institute offre un contexte plus large. Dans son analyse annuelle des pannes 2025, 54 % des répondants à son enquête 2024 ont déclaré que leur panne significative à grave la plus récente avait coûté plus de 100 000 dollars, et un sur cinq (20 %) plus de 1 million de dollars. Ce sont des réponses d’enquête portant sur des pannes à fort impact choisies, et non la part de toutes les pannes cloud dépassant ces montants. Le rapport avertit aussi que la mesure des pannes est incomplète. Analyse d’Uptime Institute
La décision propre à une entreprise devrait plutôt partir de la conséquence probable de la perte d’un service métier pendant une heure, un jour ou plusieurs jours. Elle devrait prendre en compte les transactions interrompues, la productivité du personnel, le préjudice aux clients, les obligations réglementaires, la trésorerie, les frais de reprise et l’arriéré après le rétablissement du service. Lorsque l’entreprise n’a pas d’estimations défendables, elle devrait les présenter comme des scénarios plutôt que comme des statistiques de pertes publiées.
Que devrait faire différemment une entreprise ?
Une réponse solide n’exige pas de dupliquer chaque plateforme technologique. Elle exige d’adapter la protection à l’interruption que l’activité ne peut pas tolérer.
D’abord, nommer le service métier essentiel, et pas seulement l’application. Puis, retracer les systèmes, les fournisseurs externes, les services d’identité, les sources de données et les intermédiaires de transactions nécessaires pour le fournir. Noter lesquelles de ces dépendances sont partagées entre des opérations apparemment indépendantes.
Ensuite, définir une interruption acceptable et un niveau de service minimal. Un site de connaissances internes peut tolérer une journée de perturbation, alors qu’une fonction de paiement ou de communication d’urgence ne le peut pas. La réponse devrait refléter la conséquence pour l’activité, et non le prestige de la technologie.
Enfin, répéter une défaillance précise. Le personnel peut-il accéder à une liste de contacts d’urgence indépendante si la plateforme habituelle d’identité ou de collaboration est indisponible ? Les transactions entrantes peuvent-elles être mises en file d’attente et rapprochées en toute sécurité ? Peut-on récupérer les informations critiques sans l’interface SaaS habituelle ? Le basculement nécessite-t-il un service de contrôle qui pourrait lui aussi être en panne ? L’exercice devrait mesurer le véritable rétablissement de la fonction métier, y compris les arriérés et le travail manuel.
Il y a des compromis. Des plateformes indépendantes, plusieurs régions et des architectures multicloud peuvent réduire certaines défaillances corrélées, mais elles ajoutent aussi des coûts d’exploitation, de la complexité de réplication et des responsabilités de sécurité. Parfois, un processus métier alternatif testé est un contrôle plus proportionné. Parfois, le coût et les conséquences justifient une redondance technique substantielle. Le choix devrait suivre l’exigence métier et un test réaliste.
Un rôle limité pour l’IA
Les outils opérationnels fondés sur l’IA peuvent aider à analyser les journaux, à regrouper les alertes et à suggérer des pistes d’investigation. Leurs capacités annoncées ne prouvent pas, à elles seules, qu’ils raccourcissent la reprise lors d’incidents majeurs. Toute action modifiant la production nécessite toujours une vérification et une autorisation appropriées.
Les services d’IA peuvent aussi devenir des dépendances. Cloudflare a indiqué que les requêtes d’inférence de Workers AI avaient échoué pendant son incident Workers KV de juin 2025. C’est un exemple concret d’une fonctionnalité d’IA moderne qui dépend d’une infrastructure classique de configuration et de plateforme. Rapport d’analyse Cloudflare de juin 2025
L’IA relève donc de la même évaluation des dépendances et de la continuité que les autres services critiques. Elle peut améliorer la capacité de l’équipe à enquêter sur un incident, mais elle ne supprime pas le besoin de communications indépendantes, de tests de reprise et de bons contrôles d’exploitation.
La fiabilité et la résilience devraient être mesurées ensemble
Les services cloud ont mis à la disposition d’un plus grand nombre d’organisations des capacités substantielles de fiabilité et de reprise. Les incidents de cette revue ne prouvent pas qu’externaliser l’infrastructure rend une entreprise moins fiable, et ils n’établissent pas qu’exploiter plusieurs fournisseurs est toujours préférable.
Ils montrent en revanche pourquoi la disponibilité d’une plateforme et la continuité d’activité sont des résultats différents. Un service peut être conçu avec de la redondance et subir tout de même une défaillance de configuration partagée. Un fournisseur peut rétablir ses systèmes techniques alors que ses clients sont encore en train de reprendre leurs processus métier. Une organisation peut éviter la défaillance d’origine et pourtant en subir les conséquences parce qu’un intermédiaire essentiel est indisponible.
Un plan de résilience utile commence donc par le service métier qui doit continuer, suit ses dépendances au-delà du réseau de l’organisation, et teste ce qui peut réellement fonctionner pendant une interruption. Il investit dans l’indépendance là où l’impact sur l’activité justifie le coût, plutôt que d’essayer d’éliminer chaque dépendance.
Une technologie fiable aide une entreprise à continuer de fonctionner. La résilience de l’entreprise exige aussi un plan pour le cas où cette technologie est indisponible.
Références et lectures complémentaires
- Atlassian: Post-Incident Review on the April 2022 Outage. Nombre de clients, mécanisme de suppression, impact sur le support et chronologie de la reprise.
- UnitedHealth Group: 2024 Form 10-K. Présentation des coûts de l’incident Change Healthcare et de la perturbation de l’activité.
- Delta Air Lines: 2024 Form 10-K. Présentation des impacts opérationnels et financiers de juillet 2024.
- Google Cloud: June 12, 2025 Service Disruption Incident Report. Mécanisme et reprise.
- Cloudflare: Cloudflare Service Outage June 12, 2025. Dépendance de stockage partagée, produits touchés et non touchés.
- AWS: Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia Region, October 2025. Enchaînement des problèmes DynamoDB, EC2 et des répartiteurs de charge.
- Cloudflare: November 18, 2025 Outage. Propagation de la configuration et effets sur les services.
- Google Cloud: Vertex AI Gemini API Incident, February 27, 2026. Enregistrement officiel de l’incident par Google Cloud.
- Microsoft: Exchange Online incident EX1550543 and Microsoft 365 incident MO1550821, November 12 to 14, 2026. Rapports d’incidents de Microsoft tels que copiés dans l’extrait d’incidents PennO365 de l’University of Pennsylvania, qui s’actualise toutes les 15 minutes, de sorte que la page change à mesure que Microsoft met à jour ses rapports.
- Uptime Institute: Annual Outage Analysis 2025. Synthèse : tendances des pannes, coûts déclarés et limites de la mesure.
- TechiesJournal : Pannes du plan de contrôle cloud : pourquoi des serveurs qui tournent ne garantissent pas un service qui fonctionne. Comment les services de contrôle cloud tombent en panne et que vérifier.
- NIST: SP 800-34 Rev. 1, Contingency Planning Guide for Federal Information Systems. Analyse d’impact sur l’activité, interdépendances, priorités de reprise et tests.
- Bank of England and PRA: SS1/21, Operational resilience: Impact tolerances for important business services. Services métier importants, tolérances d’impact, cartographie et tests de scénarios.
Les sources ont été lues le 14 novembre 2026. L’incident Microsoft était encore en cours d’examen, et les détails d’un incident peuvent changer.