

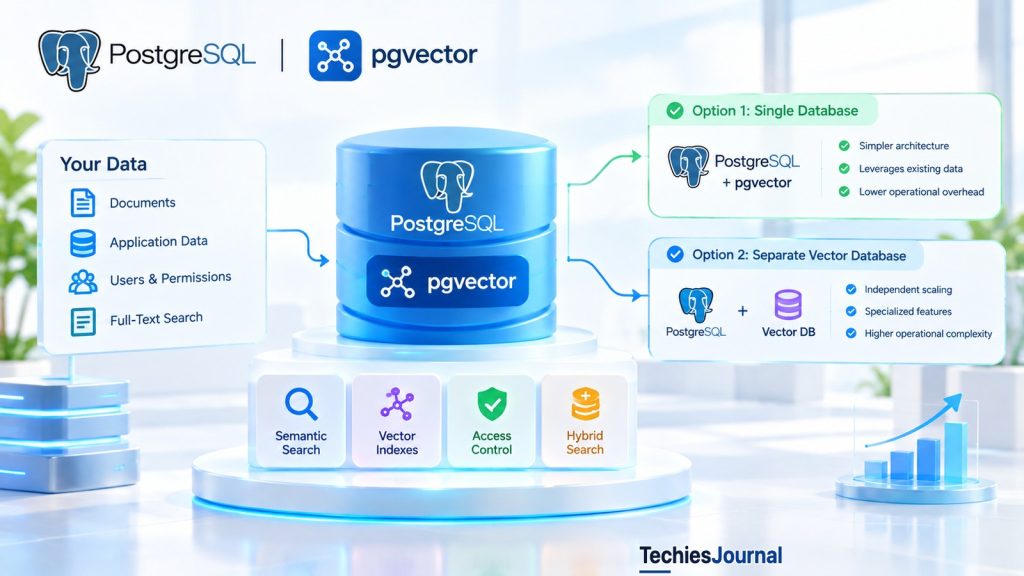
Una aplicación de IA puede guardar los registros de negocio, los embeddings y los documentos consultables en PostgreSQL, o incorporar un sistema vectorial dedicado. La decisión adecuada depende de la calidad de la recuperación, los controles de acceso, los requisitos de escalado y el costo de mantener sincronizados varios almacenes de datos.
Una organización que crea un asistente de conocimiento con IA quizá ya guarde sus documentos, usuarios y permisos en PostgreSQL. Para que esos documentos se puedan buscar por su significado, la aplicación necesita embeddings. Son representaciones numéricas del contenido que permiten al software encontrar pasajes relacionados semánticamente.
Una opción es guardar los embeddings junto a los datos de la aplicación con la extensión pgvector. Otra es mantener un sistema de búsqueda vectorial separado. Ambas arquitecturas pueden dar soporte a la generación aumentada por recuperación (retrieval-augmented generation, RAG).
La pregunta es si una base de datos separada resuelve un problema medible o introduce una complejidad que la aplicación todavía no necesita.
Qué añade pgvector a PostgreSQL
PostgreSQL ya ofrece almacenamiento relacional, transacciones, uniones (joins), indexación y búsqueda de texto completo (full-text search). pgvector añade tipos de datos vectoriales, operadores de similitud e índices aproximados de vecinos más cercanos, que encuentran coincidencias cercanas con rapidez sin comprobar cada vector.
Una aplicación puede guardar en PostgreSQL fragmentos de documentos, sus embeddings y los metadatos asociados. Cuando un usuario hace una pregunta, la aplicación crea un embedding de esa pregunta y busca embeddings de documentos similares. Los pasajes recuperados pueden aportar después contexto a un modelo de lenguaje que genera una respuesta.
pgvector no genera embeddings, no garantiza que las respuestas generadas por el modelo sean correctas ni determina automáticamente si un documento es seguro para que lo lea un usuario concreto. Esas siguen siendo responsabilidades de la aplicación y de su arquitectura de seguridad.
Es importante tener presente que pgvector es una extensión, no una funcionalidad de PostgreSQL 19. Sus capacidades actuales funcionan en las versiones de PostgreSQL con soporte, y el README de pgvector indica compatibilidad con PostgreSQL 13 y posteriores, así que comprueba qué versiones admite tu versión de pgvector. Para saber qué cambia en el propio PostgreSQL, consulta nuestro artículo sobre PostgreSQL 19 y su versión candidata.
Fuente: pgvector official documentation.
Cómo recupera documentos una aplicación RAG empresarial
Piensa en un asistente de conocimiento interno hipotético que usan empleados de Finanzas y de Recursos Humanos. La organización guarda los documentos y los metadatos de acceso en PostgreSQL. Cada documento se divide en pasajes consultables, y cada pasaje tiene asociado un embedding.
Una operación de recuperación típica tiene varias etapas.
1. Autenticar al usuario. La aplicación establece la identidad del usuario y su contexto organizativo autorizado.
2. Determinar el ámbito de documentos permitido. El servidor identifica a qué documentos tiene derecho a acceder el usuario, con datos de autorización de confianza y no con instrucciones aportadas por el usuario.
3. Generar el embedding de la pregunta. Un modelo de embeddings convierte la pregunta del usuario en la misma representación vectorial compatible que se usa para los pasajes almacenados.
4. Recuperar los pasajes coincidentes. PostgreSQL busca contenido semánticamente similar mientras aplica las condiciones de acceso a documentos que correspondan.
5. Aplicar el límite de acceso. La aplicación verifica que solo el contenido permitido pueda pasar al modelo. La seguridad a nivel de fila en la base de datos puede aportar otra capa de control donde esté configurada correctamente.
6. Generar la respuesta. El modelo de lenguaje usa pasajes autorizados como contexto de apoyo. La aplicación puede conservar las referencias a las fuentes para la trazabilidad.
Autenticar
La aplicación establece la identidad del usuario y su contexto organizativo autorizado.
Ámbito válido
El servidor identifica a qué documentos tiene derecho a acceder el usuario, con datos de autorización de confianza y no con instrucciones aportadas por el usuario.
Generar embedding
Un modelo de embeddings convierte la pregunta del usuario en la misma representación vectorial compatible que se usa para los pasajes almacenados.
Buscar
PostgreSQL busca contenido semánticamente similar mientras aplica las condiciones de acceso a documentos que correspondan.
Un documento de Recursos Humanos podría ser semánticamente similar, pero la similitud no convierte ese documento en autorizado.
Aplicar el límite
La aplicación verifica que solo el contenido permitido pueda pasar al modelo.
La seguridad a nivel de fila en la base de datos puede aportar otra capa de control donde esté configurada correctamente.
Generar
El modelo de lenguaje usa pasajes autorizados como contexto de apoyo.
La aplicación puede conservar las referencias a las fuentes para la trazabilidad.
Supón que un empleado de Finanzas pregunta por una política de aprobación de gastos. Un documento de Recursos Humanos podría ser semánticamente similar, pero la similitud no convierte ese documento en autorizado. La consulta a la base de datos y los controles de la aplicación que la rodean deben impedir que material restringido entre en el contexto del modelo.
Seguridad a nivel de fila en PostgreSQL
La seguridad a nivel de fila (row-level security, RLS) de PostgreSQL puede restringir qué registros puede leer o modificar un rol de base de datos. Puede ayudar a aplicar los límites entre tenants o entre documentos con independencia del filtrado habitual de la aplicación.
Sin embargo, activar RLS no hace que cada conexión sea segura de forma automática. Los superusuarios y los roles con BYPASSRLS eluden las políticas. Los propietarios de las tablas normalmente eluden RLS salvo que se configure FORCE ROW LEVEL SECURITY. Las aplicaciones también deben establecer el contexto de autorización de forma segura, sobre todo cuando las conexiones se agrupan en un pool o se reutilizan.
RLS debería probarse con roles de usuario realistas, incluidas pruebas negativas que demuestren que no se pueden recuperar documentos no autorizados. Una cláusula WHERE tenant_id = ... habitual es útil para filtrar consultas, pero no debería tratarse como un límite de seguridad completo cuando la aplicación que hace la llamada puede modificarla u omitirla.
Fuente: PostgreSQL, Row Security Policies.
La búsqueda exacta y los índices aproximados resuelven problemas distintos
De forma predeterminada, pgvector realiza una búsqueda exacta de vecinos más cercanos. Esta encuentra los vectores más cercanos según la medida de distancia elegida y ofrece una referencia útil con la que evaluar los resultados aproximados. A medida que crecen las colecciones de vectores y el volumen de solicitudes, la búsqueda exacta puede volverse más costosa.
pgvector admite dos métodos principales de indexación aproximada.
| Índice | Cómo funciona | Compromiso importante |
|---|---|---|
| HNSW | Organiza los vectores en un grafo navegable | Buenas características de velocidad y exhaustividad para muchas cargas de trabajo, con más tiempo de creación y más necesidades de memoria |
| IVFFlat | Agrupa los vectores en listas y busca en las listas seleccionadas | Requiere datos de entrenamiento adecuados y ajustar la amplitud de la búsqueda |
Los índices aproximados pueden devolver resultados distintos de los de la búsqueda exacta. Por eso la latencia por sí sola es una medida de rendimiento insuficiente. Los equipos también deberían medir la exhaustividad (recall), que indica cuántos de los vecinos más cercanos esperados se recuperaron en comparación con una referencia de búsqueda exacta.
Para un asistente de IA, un resultado más rápido puede ser menos útil si omite de forma sistemática un documento importante.
El filtrado puede afectar a la calidad de la recuperación
Las búsquedas empresariales rara vez dependen solo de la similitud vectorial. Los resultados también pueden filtrarse por organización, tipo de documento, proyecto o ámbito de acceso. Con índices aproximados, PostgreSQL puede aplicar el filtrado después de que el recorrido del índice haya seleccionado los candidatos, y esto puede devolver menos resultados de los solicitados.
Por ejemplo, si una búsqueda examina 40 candidatos y solo el 10 % cumple un filtro de categoría, podrían quedar de media unos cuatro. Es una ilustración de la selectividad, no un resultado garantizado para cada búsqueda.
pgvector incorporó los recorridos iterativos del índice (iterative index scans) en la versión 0.8.0, del 30 de octubre de 2024. Los recorridos iterativos pueden seguir examinando más candidatos del índice cuando el filtrado elimina demasiados resultados, dentro de los límites de recursos y de recorrido configurados. Otros enfoques incluyen los índices habituales de PostgreSQL, los índices vectoriales parciales y el particionado de tablas, según los patrones de consulta. Estos mecanismos deberían elegirse a partir de mediciones.
Los tenants que comparten un mismo índice aproximado también pueden afectarse entre sí. La documentación de pgvector indica que los vectores de un tenant pueden cambiar la exhaustividad y la velocidad para otros tenants, y recomienda el particionado por lista o tablas separadas para aislar a los tenants.
Un filtro de autorización aplicado correctamente nunca debe debilitarse solo para aumentar el número de resultados de búsqueda. Un sistema de recuperación que devuelve menos pasajes autorizados puede producir una respuesta menos completa. Devolver pasajes no autorizados es un fallo distinto y más grave.
Fuentes: pgvector changelog, pgvector filtering guidance y pgvector multitenancy.
La búsqueda híbrida combina distintas formas de relevancia
La similitud semántica es útil cuando los usuarios describen un concepto sin usar las palabras exactas que aparecen en un documento. La búsqueda por palabras clave sigue siendo importante para identificadores, nombres de productos, números de políticas y términos técnicos.
PostgreSQL admite la búsqueda de texto completo mediante herramientas como tsvector y tsquery. Las aplicaciones pueden combinar esos resultados con la búsqueda por similitud de pgvector. Por ejemplo, un asistente de conocimiento que busca un número de incidente concreto puede beneficiarse de la coincidencia exacta de texto, mientras que una pregunta de diagnóstico más amplia puede beneficiarse de la recuperación semántica.
Los resultados clasificados pueden combinarse con técnicas como la fusión de rangos recíprocos (reciprocal rank fusion), que une dos listas clasificadas según la posición, y después, de forma opcional, reordenarse con otro modelo de relevancia. Sin embargo, la búsqueda híbrida no garantiza una mejor recuperación en todas las aplicaciones. Los equipos deberían evaluar preguntas representativas, los documentos esperados y la calidad de la clasificación final.
Fuentes: PostgreSQL full-text search y pgvector hybrid search.
¿Cuándo resulta útil una base de datos vectorial separada?
Un sistema vectorial dedicado puede llegar a compensar cuando los requisitos de recuperación de una aplicación superan lo que su entorno de PostgreSQL actual puede soportar de forma eficaz. Algunos ejemplos son el tráfico de búsqueda vectorial que escala de forma independiente, la indexación distribuida especializada, las colecciones de búsqueda muy grandes o las funciones de recuperación que no están disponibles en el despliegue de PostgreSQL elegido.
Pero trasladar los embeddings a otro sistema crea responsabilidades adicionales.
Piensa en la actualización de un documento. La aplicación cambia el documento de origen en PostgreSQL. También debe volver a generar los embeddings afectados y actualizar el índice vectorial. Hasta que termine la sincronización, las búsquedas pueden recuperar contenido desactualizado.
La eliminación crea un problema relacionado. Quitar un documento de la base de datos transaccional también debe quitar o invalidar sus representaciones vectoriales.
Los cambios de permisos son especialmente importantes. Si se revoca el acceso de un usuario, los metadatos de acceso obsoletos de otro sistema de búsqueda no deben permitir que el contenido restringido llegue al modelo.
Por lo tanto, una arquitectura con dos almacenes de datos necesita una forma fiable de propagar los cambios, gestionar los fallos, reintentar de forma segura y determinar cuándo están al día los datos de búsqueda. La captura de datos de cambios (change-data capture), que transmite los cambios fuera de la base de datos, los patrones de bandeja de salida transaccional (transactional outbox), que registran el evento de cambio en la misma transacción que los datos, y el procesamiento de eventos pueden ayudar, pero cada uno requiere implementación y responsables de su operación. La comprobación de permisos de referencia debería seguir pudiendo aplicarse aunque el índice de búsqueda vaya con retraso.
Documento editado
La aplicación cambia el documento de origen en PostgreSQL.
También debe volver a generar los embeddings afectados y actualizar el índice vectorial.
Hasta que termine la sincronización, las búsquedas pueden recuperar contenido desactualizado.
Documento eliminado
Quitar un documento de la base de datos transaccional también debe quitar o invalidar sus representaciones vectoriales.
Se revoca un permiso
Si se revoca el acceso de un usuario, los metadatos de acceso obsoletos de otro sistema de búsqueda no deben permitir que el contenido restringido llegue al modelo.
El índice se retrasa
Por lo tanto, una arquitectura con dos almacenes de datos necesita una forma fiable de propagar los cambios, gestionar los fallos, reintentar de forma segura y determinar cuándo están al día los datos de búsqueda.
La comprobación de permisos de referencia debería seguir pudiendo aplicarse aunque el índice de búsqueda vaya con retraso.
Estos límites de sincronización forman parte del costo de adoptar un sistema vectorial separado.
Los modelos de embeddings introducen otro límite de migración
Un embedding se genera con un modelo y una representación concretos. Cambiar el modelo de embeddings puede cambiar las dimensiones de los vectores, sus distribuciones y el comportamiento de la similitud. Los embeddings producidos por modelos incompatibles no deberían combinarse como si sus distancias fueran directamente comparables.
Las organizaciones deberían registrar los identificadores de los modelos de embeddings, sus versiones y los parámetros de generación pertinentes. Una migración de modelo puede exigir generar embeddings nuevos, reconstruir los índices y evaluar la calidad de la recuperación antes de cambiar las consultas de producción. Durante una transición, puede que las representaciones antiguas y las nuevas tengan que coexistir.
pgvector también tiene límites de indexación que dependen de la representación. Su soporte documentado de HNSW incluye valores vector de hasta 2000 dimensiones y valores halfvec de hasta 4000 dimensiones. Estos límites se refieren a la representación del índice correspondiente, no a una restricción universal sobre cualquier estrategia posible de almacenamiento o de búsqueda. Por lo tanto, el modelo de embeddings que elige la aplicación influye en el diseño del índice.
Fuente: pgvector, Vector Types and Indexing Limits.
¿Cómo debería elegir un equipo?
Una evaluación útil compara el enfoque actual basado en PostgreSQL con un sistema vectorial separado usando la misma carga de trabajo representativa.
| Área de evaluación | Pregunta que hay que responder |
|---|---|
| Calidad de la recuperación | ¿Se encuentran de forma sistemática los pasajes relevantes esperados? |
| Autorización | ¿Pueden llegar alguna vez documentos no autorizados al contexto del modelo? |
| Rendimiento | ¿Cumple la latencia de búsqueda el objetivo con una concurrencia realista? |
| Filtrado | ¿Mantienen una exhaustividad aceptable las condiciones selectivas de tenant y de metadatos? |
| Actualizaciones y eliminaciones | ¿Con qué rapidez refleja el índice de búsqueda los cambios en el origen? |
| Operaciones | ¿Cuáles son los requisitos de indexación, copia de seguridad, monitoreo y recuperación? |
| Escalado | ¿Puede crecer la demanda de recuperación sin perjudicar las cargas de trabajo transaccionales? |
| Costo | ¿Cuál es el gasto combinado de infraestructura y mantenimiento? |
La comparación no debería dar por hecho que la tecnología más especializada es automáticamente la más adecuada. Una aplicación pequeña o mediana puede comprobar que PostgreSQL con pgvector cubre sus necesidades con menos sistemas que gestionar. Una aplicación más grande puede justificar una capa de búsqueda independiente cuando el aislamiento de cargas de trabajo, las funciones especializadas o el escalado independiente aportan beneficios medibles. Esos resultados dependen de la carga de trabajo y deberían establecerse mediante pruebas, no con umbrales genéricos de tamaño de la base de datos.
Las operaciones también incluyen mantener la extensión con los parches al día. El registro de cambios de pgvector recoge correcciones de una posible corrupción de índices durante el vacuum de HNSW en la versión 0.8.3, del 17 de junio de 2026, y de desbordamientos de búfer durante la creación de índices IVFFlat en las versiones 0.8.6, del 29 de julio (en sistemas de 32 bits), y 0.8.7, del 1 de octubre de 2026. Los equipos deberían usar una versión de parches actual y probar el mantenimiento de los índices, como el vacuum y las reconstrucciones, antes de depender de un índice en producción.
A qué se reduce la decisión de arquitectura
PostgreSQL y pgvector permiten que los registros de la aplicación, los embeddings, los metadatos y la búsqueda de texto permanezcan en un único entorno de base de datos. Esto puede simplificar las aplicaciones de IA que ya dependen mucho de datos relacionales. Un sistema vectorial separado puede aportar capacidades valiosas, pero exige atención a la sincronización, las eliminaciones, la autorización y la responsabilidad operativa.
Ninguna de las dos arquitecturas garantiza automáticamente la relevancia de la búsqueda ni una recuperación segura.
Empieza por requisitos verificados de recuperación y de control de acceso. Usa PostgreSQL con pgvector cuando los cumpla de forma eficaz, e incorpora un sistema vectorial separado cuando las mediciones justifiquen la complejidad adicional.
Referencias y lecturas adicionales
- pgvector, Official Repository. Tipos de vectores admitidos, búsqueda por similitud, indexación, filtrado y multitenencia.
- pgvector, Changelog. Historial de versiones, recorridos iterativos del índice y versiones de parches.
- PostgreSQL, Row Security Policies. Comportamiento de la autorización en la base de datos y condiciones para eludirla.
- PostgreSQL, Full Text Search. Recuperación por palabras clave y clasificación.
- PostgreSQL, Full Text Search Introduction. Los tipos
tsvectorytsquery. - PostgreSQL, EXPLAIN. Inspección de planes de ejecución y evaluación del rendimiento.
- pgvector, Release and Security History. Versiones de la extensión y actualizaciones de mantenimiento.
Fuentes verificadas el 6 de noviembre de 2026. pgvector publica versiones con frecuencia, y la versión 0.8.7, del 1 de octubre de 2026, corrigió un error en la creación de índices IVFFlat y no se presenta como la que introduce las capacidades de arquitectura que se tratan aquí, así que consulta las fuentes anteriores antes de actuar. Las indicaciones sobre rendimiento y arquitectura son recomendaciones analíticas, no resultados de pruebas comparativas (benchmarks) independientes de TechiesJournal.