

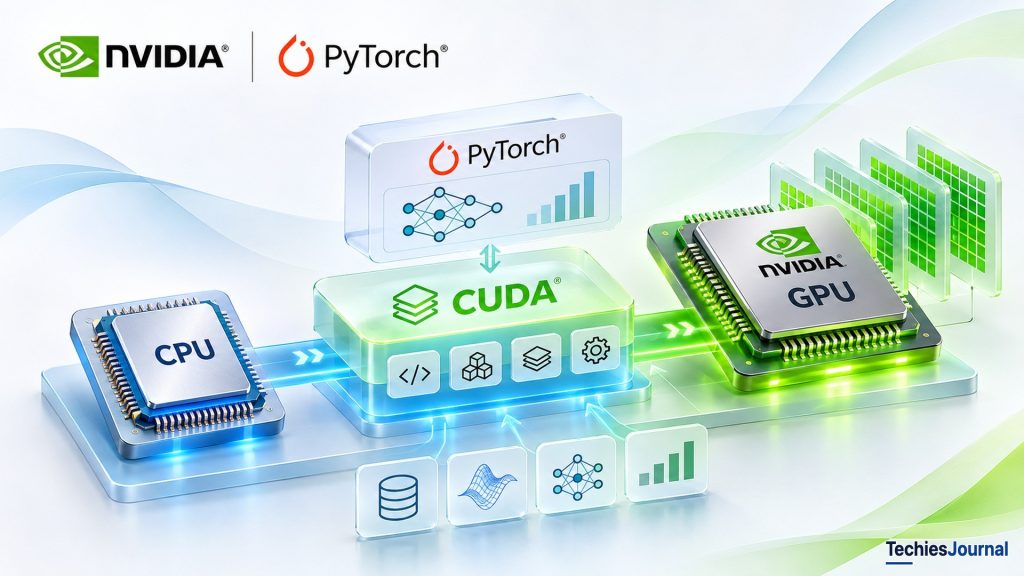
Cómo cooperan las CPU y las GPU, qué añade CUDA, cómo lo usan los frameworks de IA y con qué profundidad necesitan aprenderlo los distintos perfiles profesionales.
Una computadora puede ser extremadamente potente y aun así tener dificultades con ciertos tipos de cálculos.
Pensemos en un equipo de ingeniería que desarrolla un software para simular cómo se desplaza el calor por un componente de una aeronave. La simulación divide el componente en millones de regiones pequeñas y calcula de forma repetida cómo cambia la temperatura en cada una de ellas.
Cada cálculo puede ser relativamente sencillo. La dificultad está en la cantidad de cálculos que hay que realizar. El equipo podría ejecutar la simulación en una computadora convencional. Pero a medida que la simulación se vuelve más detallada, la demanda de cómputo crece. Una tarea que antes terminaba en minutos puede acabar necesitando horas, según el modelo, los algoritmos y el hardware disponible.
Un procesador más rápido puede ayudar. Pero cada vez cobra más importancia otra pregunta: ¿y si el problema pudiera dividirse en muchos cálculos más pequeños y procesarse en paralelo?
Aquí es donde cobra importancia la diferencia entre una CPU y una GPU.
Por qué las computadoras tienen CPU
Toda computadora de uso general depende de una unidad central de procesamiento (CPU) para ejecutar instrucciones y coordinar una gran variedad de operaciones. Cuando abre un navegador, guarda un documento, ejecuta una aplicación empresarial o lanza un programa, la CPU desempeña un papel importante para que esas operaciones se lleven a cabo.
Una CPU moderna contiene varios núcleos de procesamiento. Cada núcleo está diseñado para ejecutar instrucciones con eficiencia, y las CPU resultan especialmente eficaces con cargas de trabajo que implican operaciones variadas, toma de decisiones, rutas de ejecución cambiantes y tareas que dependen de los resultados de instrucciones anteriores.
Las CPU también pueden realizar procesamiento en paralelo. Un procesador con varios núcleos puede ejecutar varias tareas, o partes de una carga de trabajo, al mismo tiempo, y los núcleos modernos pueden efectuar varias operaciones matemáticas simultáneamente. Pero las CPU están diseñadas para equilibrar requisitos de cómputo muy diversos. No están optimizadas exclusivamente para ejecutar cantidades enormes de cálculos similares.
Volvamos a la simulación de calor. Algunas partes exigen coordinar datos, tomar decisiones y gestionar el programa en su conjunto. Una CPU se encarga bien de esas responsabilidades. Otras partes consisten en aplicar de forma repetida operaciones matemáticas a millones de regiones. Eso abre la oportunidad de usar otro tipo de procesador.
Por qué las GPU son diferentes
Una unidad de procesamiento gráfico (GPU) es un procesador desarrollado en origen para acelerar los cálculos relacionados con los gráficos. Representar una escena tridimensional implica calcular el aspecto de grandes cantidades de píxeles, superficies, texturas y elementos geométricos. Muchos de esos cálculos pueden realizarse en paralelo.
Las arquitecturas de GPU evolucionaron para ofrecer un alto rendimiento de cómputo en cargas de trabajo con esta característica. A diferencia de una CPU, que dedica una parte considerable de sus recursos de hardware a ejecutar con eficiencia una amplia gama de tareas, una GPU dedica gran parte de su arquitectura a procesar en paralelo grandes cantidades de trabajo adecuado.
Esta diferencia hace que las GPU sean valiosas para algo más que mostrar gráficos. Nuestra simulación de ingeniería también contiene gran cantidad de operaciones matemáticas relacionadas entre sí. Con un algoritmo adecuado, muchas de esas operaciones pueden ejecutarse potencialmente en una GPU.
La simulación sigue necesitando una CPU. La GPU no sustituye al procesador responsable de ejecutar la aplicación en su conjunto. En cambio, la CPU y la GPU pueden trabajar juntas, y cada una se ocupa de las partes de la carga de trabajo que se ajustan a su arquitectura.
Alternativa de texto accesible para esta figura
El diagrama compara cuatro núcleos de CPU ilustrativos con numerosas unidades de ejecución de GPU abstractas. No está a escala.
Texto que aparece en la figura: 1. Por qué difieren los diseños de CPU y GPU | Ambas ejecutan cálculos. Sus puntos fuertes son distintos, no una clasificación universal de velocidad. | CPU · Procesamiento general | GPU · Rendimiento paralelo | Núcleo 1 | Núcleo 2 | Núcleo 3 | Núcleo 4 | Tareas variadas · control complejo | Muchos cálculos similares en paralelo | Solo ilustración: los recuadros no comparan el número físico de núcleos.
Resulta tentador concluir que las GPU son simplemente CPU más rápidas. No lo son. Una GPU puede superar con creces a una CPU en una carga de trabajo paralela adecuada. Pero las aplicaciones con dependencias secuenciales complejas, operaciones irregulares o cantidades muy pequeñas de trabajo pueden obtener poco beneficio.
Mover datos entre la memoria de la CPU y la de la GPU, coordinar la ejecución y asignar recursos de la GPU también tienen un costo. El rendimiento depende de la naturaleza del problema, de la implementación y del hardware, y no solo de que haya una GPU disponible.
Si las GPU son potentes, ¿para qué hace falta CUDA?
Ya entendemos por qué un ingeniero querría usar una GPU. Pero identificar el hardware capaz de ejecutar un cálculo es solo una parte del desafío. El equipo de ingeniería tiene una aplicación que describe la simulación mediante operaciones matemáticas, estructuras de datos e instrucciones de programa. La GPU tiene una arquitectura de ejecución y un sistema de memoria diferentes.
La aplicación no puede dar por supuesto que una función ordinaria de CPU se ejecutará con eficiencia en miles de hilos de GPU. Necesita una forma de describir qué cálculos deben ejecutarse en la GPU, cómo debe organizarse ese trabajo, cómo pasan a estar disponibles los datos y cómo se coordina la ejecución.
Sin interfaces de programación, compiladores, bibliotecas y software de apoyo adecuados, gran parte de la capacidad de cómputo de la GPU seguiría siendo difícil de aprovechar para las aplicaciones de uso general. Este es el problema que hace importante a CUDA.
Cuando NVIDIA anunció CUDA en noviembre de 2006, contribuyó a que las GPU de NVIDIA compatibles pudieran programarse para computación de uso general y no solo para el procesamiento gráfico tradicional. CUDA significaba originalmente Compute Unified Device Architecture.
Su importancia no radica en que haga potentes a las GPU. La capacidad de cómputo la aporta la arquitectura de hardware. CUDA ayuda a los desarrolladores de software a expresar y ejecutar trabajo aprovechando esa capacidad.
Con el tiempo, el ecosistema que lo rodea se amplió hasta incluir bibliotecas matemáticas, compiladores, herramientas de depuración, herramientas de análisis del rendimiento e integraciones con software de nivel superior. Esa base acabó siendo especialmente importante para la inteligencia artificial.
Hoy, un desarrollador puede entrenar una red neuronal con Python y PyTorch sin necesidad de escribir código CUDA directamente. Sin embargo, por debajo de la aplicación Python, el software compatible con CUDA puede encargarse de ejecutar partes sustanciales del cómputo en hardware de GPU de NVIDIA.
Para entender esa relación, tenemos que examinar cómo una aplicación pasa de las instrucciones ordinarias de un programa a la ejecución paralela en la GPU.
De una aplicación a una GPU: la arquitectura de CUDA
Volvamos a la simulación de ingeniería. La aplicación necesita preparar la simulación, cargar los valores iniciales, gestionar los cálculos y, por último, mostrar o almacenar los resultados. No todo ese trabajo corresponde a la GPU.
La CPU sigue siendo responsable de ejecutar la aplicación principal, coordinar las operaciones e iniciar los cálculos adecuados en la GPU. En la terminología de CUDA, la parte de la aplicación que corre en la CPU se llama host, mientras que la GPU se llama device. Esa distinción es importante porque el host y el device pueden tener recursos de ejecución y espacios de memoria diferentes.
El código de la simulación que se ejecuta en la CPU podría preparar millones de valores de temperatura. Después necesita hacer que esos valores sean accesibles para el código de la GPU. Una aplicación CUDA típica puede usar el runtime para reservar memoria accesible desde la GPU, transferir datos, lanzar cálculos en la GPU, sincronizar la ejecución y recuperar los resultados. Por debajo de esas interfaces que ve la aplicación, el software y la infraestructura de controladores de NVIDIA gestionan las interacciones con el hardware de la GPU.
Alternativa de texto accesible para esta figura
La aplicación se conecta con el host de CPU y las interfaces de CUDA, que acceden a la GPU de NVIDIA mediante la infraestructura de controladores. Arquitectura conceptual simplificada.
Texto que aparece en la figura: 2. CUDA en la arquitectura de la aplicación | CUDA es una plataforma y un ecosistema. No es una GPU ni una única capa de software obligatoria. | Aplicación de simulación de ingeniería | CPU / Host | Control y orquestación del programa | Interfaces y bibliotecas de CUDA | Lanzamiento de kernels, datos y API de cómputo | Controlador de NVIDIA + GPU compatible | Ejecución en el device | El host y el device cooperan. Las API, las bibliotecas y el controlador tienen funciones distintas.
Hay aquí una distinción arquitectónica. CUDA no es un único componente de software situado entre cada aplicación y la GPU. Es una plataforma de programación y un ecosistema más amplios, que contienen interfaces, herramientas y bibliotecas con responsabilidades distintas. Algunas aplicaciones llaman directamente a las API de CUDA. Otras se apoyan en bibliotecas o frameworks que usan CUDA internamente.
La relación se vuelve más clara si seguimos un cálculo concreto.
¿Qué ocurre cuando CUDA ejecuta un cálculo?
Imaginemos que nuestro equipo de ingeniería quiere calcular los cambios de temperatura en un gran conjunto de regiones. A modo de ilustración, supongamos que un paso adecuado puede realizarse de forma independiente para muchas regiones usando valores del paso anterior de la simulación.
Primero, la aplicación prepara los datos de entrada. Después se asegura de que la GPU pueda acceder a ellos. En un flujo de trabajo convencional con memoria explícita, la aplicación reserva memoria del device y copia los datos de la memoria de la CPU a la de la GPU. Existen otros enfoques, como la memoria gestionada, pero el requisito esencial es el mismo: los datos deben ser accesibles allí donde se realiza el cómputo.
Una vez que los datos están listos, la aplicación lanza una función diseñada para ejecutarse en la GPU. CUDA llama kernel a esta función. Un kernel no es una aplicación completa. Describe un cálculo concreto que ejecutarán los hilos de la GPU.
En nuestra simulación, un kernel podría calcular un valor de temperatura actualizado para cada región a partir de los valores cercanos. En lugar de ejecutar un cálculo tras otro por una única ruta de ejecución de la CPU, la aplicación lanza una gran colección de hilos de GPU que realizan en paralelo el trabajo adecuado.
Cuando el kernel termina, los resultados pueden permanecer en la memoria de la GPU para otro paso de la simulación. Solo cuando la CPU necesita los valores (por ejemplo, para escribir un informe o mostrar un resultado) la aplicación podría transferirlos de vuelta a la memoria del host.
Alternativa de texto accesible para esta figura
Cinco pasos: preparar los datos, hacerlos accesibles a la GPU, lanzar el kernel, calcular en el device y consumir los resultados. Se incluye una nota de sincronización.
Texto que aparece en la figura: 3. Un cálculo de CUDA, paso a paso | Ejemplo de simulación térmica de ingeniería. Los resultados de la GPU pueden permanecer en el device para pasos posteriores. | 1 · Preparar | La CPU crea los datos | 2 · Hacer accesibles los datos | Reservar/copiar o memoria gestionada | 3 · Lanzar el kernel | El host envía trabajo a la GPU | 4 · Calcular | Los hilos del device calculan | 5 · Usar el resultado | Siguiente paso en GPU o lectura en CPU | El trabajo de la GPU puede ser asíncrono. Sincronice cuando sea necesario. | La transferencia de datos es condicional: la memoria unificada o gestionada y la reutilización en la GPU cambian la ruta.
Fíjese en la importancia de mantener los resultados intermedios en la GPU. Si una simulación requiere miles de pasos de procesamiento, transferir el conjunto de datos completo a la CPU después de cada paso podría suponer una sobrecarga considerable. Un diseño mejor puede realizar muchas operaciones en la GPU y transferir solo lo que la CPU necesita realmente.
Esto ilustra un principio más amplio: la aceleración con GPU no consiste solo en hacer más rápidas las operaciones matemáticas individuales. También exige diseñar cómo se desplazan el cómputo y los datos por el sistema.
¿Espera la CPU mientras trabaja la GPU?
No necesariamente. Muchas operaciones de CUDA pueden lanzarse de forma asíncrona, lo que permite que la CPU siga con otro trabajo mientras la GPU procesa las operaciones enviadas antes. CUDA usa streams para organizar las operaciones de GPU en cola.
Las operaciones enviadas al mismo stream tienen reglas de orden, mientras que las operaciones independientes en streams distintos pueden solaparse, según las dependencias y las capacidades del hardware. La aplicación debe sincronizarse cuando necesita saber que un trabajo concreto ha terminado o cuando otra operación depende de sus resultados.
Nuestra simulación podría preparar el siguiente lote de datos de entrada mientras la GPU procesa el lote actual. Pero si el siguiente cálculo depende de resultados anteriores, el programa debe respetar esa dependencia. La ejecución asíncrona puede mejorar la utilización. No elimina la necesidad de una coordinación correcta.
¿Cómo reparte CUDA el trabajo entre miles de hilos de GPU?
Hemos descrito un kernel como una función que se ejecuta en la GPU. Pero ¿cómo sabe la GPU qué hilo debe calcular qué región? CUDA ofrece una jerarquía lógica de ejecución: hilos, bloques de hilos y mallas (grids).
Un hilo representa una instancia lógica de ejecución de un kernel. Cada hilo tiene acceso a identificadores que ayudan a determinar qué parte de la carga de trabajo debe procesar. Los hilos se organizan en grupos llamados bloques de hilos. Un conjunto de bloques de hilos forma una malla (grid).
Consideremos una simulación simplificada con 1024 regiones, procesadas de forma independiente en un paso de cálculo. Un desarrollador podría lanzar cuatro bloques de hilos de 256 hilos cada uno. Eso crea 1024 hilos lógicos, cada uno potencialmente responsable de una región. Cada hilo ejecuta el código del kernel, pero usa su propio índice para identificar qué región debe actualizar.
Alternativa de texto accesible para esta figura
La malla tiene cuatro bloques de 256 hilos cada uno. Un panel de hardware de GPU aparte explica la planificación en los multiprocesadores de streaming.
Texto que aparece en la figura: 4. Jerarquía lógica de ejecución de CUDA | Ejemplo: 1024 hilos lógicos = 4 bloques × 256 hilos. No son 1024 núcleos físicos dedicados. | Un lanzamiento de kernel · Malla | Bloque de hilos 1 · 256 hilos | Bloque de hilos 2 · 256 hilos | Bloque de hilos 3 · 256 hilos | Bloque de hilos 4 · 256 hilos | Hardware de GPU | Multiprocesadores de streaming | planifican los bloques disponibles | Los warps ejecutan hilos | Los bloques y los hilos son organización de software. Los SM y los warps son conceptos de ejecución del hardware. | Dibujado: 16 de los 256 hilos de cada bloque
El propósito es describir una carga de trabajo paralela de gran tamaño sin asignar manualmente cada cálculo a una unidad de procesamiento física concreta. Los hilos de un mismo bloque pueden usar mecanismos de sincronización compatibles y memoria compartida para intercambiar datos intermedios.
Eso puede ser valioso en nuestra simulación. La nueva temperatura de una región puede depender de las regiones vecinas. Un kernel diseñado con cuidado puede permitir que los hilos que cooperan reutilicen valores cercanos en lugar de recuperar una y otra vez la misma información de una memoria más lenta.
Pero la programación ordinaria con bloques de hilos no permite a los desarrolladores dar por supuesto que todos los bloques se ejecutan simultáneamente ni que un bloque pueda sincronizarse libremente con todos los demás. Un algoritmo que requiere coordinación global debe tener en cuenta esas restricciones o usar mecanismos apropiados.
¿Son los hilos de CUDA lo mismo que los núcleos físicos de la GPU?
No. Los hilos y los bloques describen cómo organiza el software el trabajo. La GPU contiene los recursos de cómputo físicos que ejecutan ese trabajo. Las GPU de NVIDIA contienen unidades de hardware llamadas multiprocesadores de streaming (SM), que planifican y ejecutan bloques sujetos a límites de recursos.
Dentro de un bloque, los hilos se agrupan en unidades de ejecución llamadas warps. Un warp convencional de CUDA contiene 32 hilos, mientras que el comportamiento preciso de planificación y ejecución depende de la arquitectura. Que una malla contenga miles de hilos no significa que cada hilo reciba un procesador físico dedicado, ni que todos los hilos se ejecuten simultáneamente.
El desarrollador describe el trabajo paralelo. El hardware de la GPU y su maquinaria de ejecución determinan cómo ese trabajo usa los recursos disponibles. Esta distinción es una de las ideas arquitectónicas más importantes de CUDA.
La memoria importa tanto como la potencia de procesamiento
Un procesador rápido puede pasar mucho tiempo esperando datos si una aplicación accede a la memoria de forma ineficiente. Por eso las GPU ofrecen varias estructuras de memoria diseñadas para sostener el rendimiento.
Un conjunto de datos de simulación grande puede residir en la memoria global de la GPU. Los hilos pueden acceder a la memoria global, pero los accesos repetidos o mal organizados pueden resultar costosos. Los hilos de un bloque pueden usar la memoria compartida para cooperar y reutilizar datos. Cada hilo puede usar registros para sus valores de trabajo, sujetos a los límites del hardware.
El objetivo no es memorizar cada tipo de memoria. Es entender que el rendimiento depende del cómputo y del acceso a los datos.
Si las regiones vecinas necesitan repetidamente las mismas temperaturas, una implementación ineficiente puede cargar los mismos valores innecesariamente muchas veces. Una implementación mejor puede organizar los accesos o reutilizar datos compartidos. Una GPU puede tener una capacidad aritmética enorme y aun así ofrecer un rendimiento decepcionante si el software no consigue suministrarle los datos con eficiencia.
Cómo CUDA se convirtió en un ecosistema de software
La mayoría de los ingenieros no quieren implementar desde cero cada operación matemática. La simulación puede usar operaciones con matrices y transformaciones numéricas comunes a muchas aplicaciones. Desarrollar y ajustar cada una por separado sería caro.
El ecosistema de CUDA ofrece bibliotecas y herramientas reutilizables. cuBLAS implementa operaciones de álgebra lineal, y cuFFT admite transformadas rápidas de Fourier. El CUDA Toolkit incluye interfaces de programación, compiladores y herramientas para desarrolladores, entre ellos el compilador nvcc para CUDA C++.
La API de runtime ofrece a las aplicaciones un acceso cómodo a los mecanismos de ejecución comunes. La API de controlador ofrece un control de recursos y de ejecución de más bajo nivel. Los perfiladores y depuradores ayudan a los ingenieros a inspeccionar problemas y rendimiento. El controlador de NVIDIA permite la interacción con el hardware compatible.
Alternativa de texto accesible para esta figura
Cuatro componentes paralelos del ecosistema CUDA se conectan conceptualmente con el controlador de NVIDIA y el hardware de la GPU, con las herramientas a su lado.
Texto que aparece en la figura: 5. CUDA es un ecosistema de software | Los componentes son capacidades y rutas, no una cadena lineal obligatoria. | Aplicaciones · Programas CUDA C++ · Bibliotecas aceleradas por GPU | Compilador / nvcc | Compila kernels de CUDA | API de runtime | Interfaz de ejecución común | API de controlador | Control de recursos de más bajo nivel | Bibliotecas de CUDA | cuBLAS · cuFFT · otras bibliotecas | Controlador de NVIDIA y hardware de GPU compatible | Los perfiladores y depuradores observan la ejecución en todos estos componentes.
Una aplicación puede invocar una biblioteca de GPU ya compilada sin compilar un kernel propio. Un framework de alto nivel puede ocultar gran parte de la gestión subyacente de memoria y ejecución. Estas diferencias importan al configurar computadoras de desarrollo y entornos de GPU en la nube: tener un controlador y una compilación del framework compatibles no equivale a exigir que cada desarrollador de aplicaciones instale y use el toolkit completo.
El valor de un acelerador depende no solo del rendimiento del hardware, sino del software disponible para usarlo. Unas especificaciones de hardware impresionantes aportan poco valor práctico cuando faltan bibliotecas, frameworks, compiladores, herramientas de diagnóstico o aplicaciones compatibles.
Cómo la IA moderna usa CUDA sin exponerlo a los desarrolladores
Un ingeniero de IA suele empezar con un framework y no con kernels de GPU escritos a mano. En PyTorch, el desarrollador define las capas del modelo, prepara los datos y opera con tensores, estructuras numéricas multidimensionales.
Las redes neuronales aplican repetidamente transformaciones como la multiplicación de matrices a los tensores. Muchas de estas operaciones pueden beneficiarse del paralelismo de la GPU. Cuando PyTorch realiza una operación compatible en una GPU de NVIDIA, su backend compatible con CUDA envía el trabajo mediante kernels y bibliotecas aceleradas adecuados.
Alternativa de texto accesible para esta figura
De la aplicación PyTorch al backend de CUDA, a los kernels y las bibliotecas y a la GPU de NVIDIA. Incluye una salvedad según la operación.
Texto que aparece en la figura: 6. CUDA por debajo de un framework de IA | Un desarrollador de PyTorch puede usar el cómputo de la GPU de NVIDIA sin escribir kernels de CUDA propios. | Modelo de Python / PyTorch | Tensores y operaciones | Backend de PyTorch con CUDA | Envía las operaciones compatibles al device | Kernels y bibliotecas optimizadas | La implementación varía según la operación | GPU de NVIDIA + controlador | Ejecutan el trabajo de GPU compatible | No todas las operaciones siguen la misma ruta de kernels y bibliotecas ni tienen soporte de GPU.
No se trata de una única ruta de implementación fija. Distintas operaciones de PyTorch pueden usar diferentes kernels, bibliotecas o implementaciones compiladas. Algunas operaciones pueden ejecutarse en la CPU. Lo que ocurre lo determinan la ubicación del dispositivo, el software compatible y el comportamiento del framework.
Consideremos un ejemplo deliberadamente pequeño en Python:
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"

a = torch.tensor([1.0, 2.0, 3.0], device=device)
b = torch.tensor([4.0, 5.0, 6.0], device=device)

result = a + b
print(result.cpu())
Si PyTorch puede usar CUDA, los tensores y la suma se ejecutan en el dispositivo CUDA seleccionado. En caso contrario, el ejemplo usa la CPU. Esto demuestra la selección de dispositivo, no una ventaja de velocidad. El desarrollador no ha escrito ningún kernel de CUDA personalizado. La implementación pertinente la proporciona el framework.
¿Por qué entender CUDA si PyTorch ya se encarga de él?
La abstracción hace más accesible la computación con GPU, pero no elimina las dependencias arquitectónicas.
Imaginemos que un modelo de IA funciona en una estación de trabajo, pero falla en un servidor de GPU en la nube. El modelo de Python puede ser válido, mientras que al entorno desplegado le falta un controlador compatible, una compilación del framework compatible o una arquitectura de GPU admitida. O bien el modelo puede ejecutarse correctamente pero rendir mal por exceso de transferencias de CPU a GPU, operaciones pequeñas o sincronización innecesaria.
Estos problemas no siempre exigen escribir CUDA C++. Sí exigen entender lo suficiente para identificar si el fallo está en el código del modelo, en el comportamiento de dispositivos del framework, en el software instalado o en el movimiento de datos.
Para los ingenieros de nube, los equipos de plataformas de IA y los desarrolladores de aplicaciones de producción, esta comprensión arquitectónica puede ser más útil que la programación inmediata de kernels de bajo nivel.
Por qué CUDA no hace automáticamente más rápido el software
Consideremos dos versiones de la simulación. La primera procesa millones de regiones de forma repetida y dedica un tiempo sustancial a operaciones numéricas paralelas. Con un algoritmo adecuado, puede beneficiarse considerablemente de la aceleración con GPU.
La segunda realiza solo unos cientos de cálculos y necesita los resultados de inmediato en la CPU. Las transferencias de datos, el envío de trabajo y la sincronización pueden costar más que el propio cómputo. Incluso una carga de trabajo grande puede rendir mal por dependencias secuenciales, trabajo desequilibrado o acceso ineficiente a la memoria.
Una comparación rigurosa mide la carga de trabajo de extremo a extremo: preparación de los datos de entrada, ubicación de los datos, cómputo, sincronización, salida y costo operativo. También compara con una implementación de CPU sólida y práctica, no con una referencia débil elegida a propósito.
El objetivo no es maximizar la utilización de la GPU. Es mejorar un resultado computacional real.
¿Depende toda la computación de IA de NVIDIA CUDA?
No. CUDA es central para muchas cargas de trabajo en GPU de NVIDIA, pero la computación acelerada es más amplia que CUDA. AMD desarrolla el ecosistema de software ROCm, mientras que SYCL y otros enfoques admiten modelos adicionales de programación heterogénea y de aceleradores. Las aplicaciones de IA también pueden ejecutarse en CPU y en otros aceleradores.
Estas alternativas plantean una pregunta práctica de arquitectura. Un framework de alto nivel puede ofrecer API similares en distintos dispositivos, y aun así las bibliotecas, la compatibilidad, las operaciones admitidas, el rendimiento y el comportamiento en el despliegue pueden diferir. La portabilidad del código fuente de la aplicación no garantiza un rendimiento equivalente ni una operación igual de sencilla.
Al elegir hardware para un sistema de IA en producción, un equipo debería evaluar la carga de trabajo real, el framework y las bibliotecas admitidos, la disponibilidad, el precio, las competencias del equipo y el mantenimiento a largo plazo. La madurez del software de CUDA es una prueba relevante, no un mandato universal para elegir hardware de NVIDIA.
¿Quién necesita aprender CUDA?
Un estudiante de IA debería empezar por la programación, Python, el manejo de datos, las matemáticas y un framework de aprendizaje automático pertinente. Entender qué hacen una GPU y CUDA es útil, pero la optimización en CUDA C++ no suele ser la primera prioridad.
Un desarrollador de aplicaciones debería entender la selección de dispositivo y las dependencias de despliegue. Un ingeniero de nube debería saber cómo encajan los controladores compatibles, los frameworks y los recursos de GPU. Un ingeniero de rendimiento de aprendizaje automático puede necesitar investigar kernels, memoria, sincronización y perfilado. Los especialistas en computación científica y en GPU pueden necesitar diseñar y ajustar kernels de CUDA directamente.
La distinción Conocer → Usar → Dominar de TechiesJournal ayuda a definir la profundidad adecuada:
- Conocer: explicar CPU frente a GPU, host frente a device, los kernels y el lugar de CUDA por debajo de los frameworks de IA.
- Usar: configurar y diagnosticar entornos con CUDA y examinar problemas básicos de memoria o de ejecución.
- Dominar: desarrollar y optimizar kernels de GPU, razonar sobre los recursos de hardware y tomar decisiones detalladas sobre los equilibrios de rendimiento.
No todo el mundo necesita la etapa final. Muchos profesionales sacan más provecho inmediato de una comprensión arquitectónica precisa que de memorizar la sintaxis de bajo nivel de CUDA.
CUDA revela algo más grande sobre la computación moderna
Volvamos a la simulación de ingeniería. El problema original parecía una falta de potencia de cómputo. Pero la GPU por sí sola no lo resolvió. La aplicación necesitaba una forma de describir el trabajo paralelo, gestionar la memoria, coordinar la ejecución, usar operaciones matemáticas optimizadas y verificar los resultados.
La misma relación aparece en la IA. Un desarrollador puede entrenar un modelo con interfaces de Python conocidas porque varias capas de software y hardware trabajan juntas por debajo.
Esa sencillez no hace irrelevantes las capas inferiores. Demuestra el valor de las abstracciones construidas sobre hardware capaz.
CUDA importa porque el hardware acelerado se vuelve realmente útil gracias a los modelos de programación, las interfaces, las bibliotecas y las herramientas que permiten al software aprovecharlo con eficacia.
Para la mayoría de los lectores, entender esas relaciones es el mejor punto de partida. Los detalles más profundos de programación deberían venir después, cuando su trabajo realmente los requiera.
Referencias y lecturas adicionales
- NVIDIA CUDA Programming Guide: modelo de host y device, kernels, mallas, memoria y ejecución.
- NVIDIA CUDA Toolkit Documentation: API, componentes del toolkit, herramientas y bibliotecas admitidas.
- NVIDIA CUDA C++ Best Practices Guide: movimiento de memoria, medición del rendimiento y optimización.
- PyTorch CUDA Semantics: dispositivos, tensores, operaciones y sincronización.
- AMD ROCm Documentation: ecosistema alternativo de computación con GPU, para comparar.
- Khronos SYCL: estándar multiplataforma de programación heterogénea.
Fecha de la revisión técnica: 17 de noviembre de 2026. Vuelva a verificar las URL de las fuentes, las capacidades del software y las afirmaciones específicas de cada versión en el momento de la publicación.