

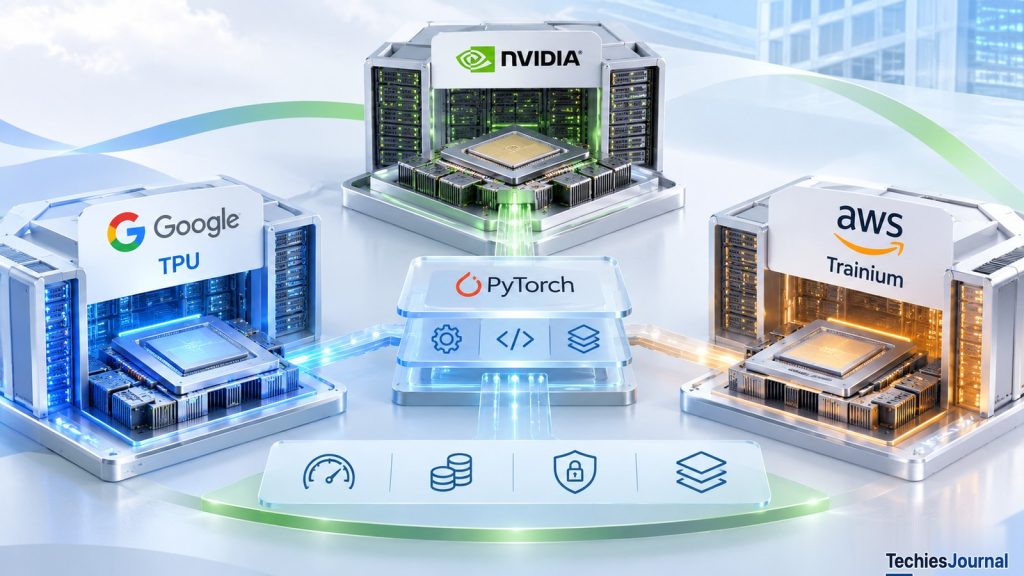
Google के नए TPU सिस्टम और PyTorch सपोर्ट में हुए सुधार AI कंप्यूटिंग के लिए ज़्यादा विकल्प बना रहे हैं। लेकिन NVIDIA पर निर्भरता घटाने के लिए सिर्फ़ दूसरा प्रोसेसर चुन लेना काफ़ी नहीं है।
संगठन NVIDIA से आगे क्यों देख रहे हैं
कल्पना कीजिए कि कोई कंपनी एक AI असिस्टेंट चलाती है, जो कर्मचारियों को आंतरिक दस्तावेज़ खोजने, सवालों के जवाब पाने और रोज़मर्रा के काम पूरे करने में मदद करता है। यह असिस्टेंट NVIDIA GPU पर चलता है। उसके डेवलपर PyTorch और NVIDIA के कंप्यूटिंग प्लेटफ़ॉर्म के लिए ऑप्टिमाइज़ की गई लाइब्रेरी इस्तेमाल करते हैं।
सेवा बढ़ने पर कंपनी को ज़्यादा प्रोसेसिंग क्षमता चाहिए। उसके आर्किटेक्ट जानना चाहते हैं कि क्या विश्वसनीयता और पहले के इंजीनियरिंग निवेश से समझौता किए बिना, वैकल्पिक हार्डवेयर कम कुल लागत पर ज़रूरी सेवा दे सकता है।
Google Tensor Processing Unit (TPU) देता है, जो मशीन-लर्निंग वर्कलोड के लिए बने विशेष प्रोसेसर हैं। AWS Trainium देता है, जो AI एक्सेलरेटर का एक और परिवार है। दोनों प्रदाता जाने-पहचाने डेवलपमेंट फ़्रेमवर्क के लिए सपोर्ट बेहतर कर रहे हैं। Google की 9 नवंबर 2026 को TPU 8tx और TPU 8i Max की घोषणा इस सवाल को सामयिक बनाती है, लेकिन गहरा बदलाव यह है कि क्या संगठन उपयुक्त AI वर्कलोड को सिर्फ़ NVIDIA पर निर्भर हुए बिना चला सकते हैं।
NVIDIA को बदलना मुश्किल क्यों है
ग्राफ़िक्स प्रोसेसिंग यूनिट (GPU) AI के लिए इसलिए अहम बने क्योंकि वे बहुत-सी गणनाएँ एक साथ कर सकते हैं। इस वजह से वे न्यूरल नेटवर्क की ट्रेनिंग और इन्फ़रेंस, यानी प्रशिक्षित मॉडल से परिणाम निकालने, दोनों के लिए उपयोगी हैं।
NVIDIA का लाभ उसके प्रोसेसर से आगे जाता है। उसका पैरेलल कंप्यूटिंग प्लेटफ़ॉर्म CUDA प्रोग्रामिंग टूल और ऑप्टिमाइज़ की गई लाइब्रेरी देता है। AI फ़्रेमवर्क, कस्टम ऑपरेशन, इन्फ़रेंस इंजन और डिप्लॉयमेंट टूल उस इकोसिस्टम से गहराई से जुड़ गए हैं। इसलिए PyTorch एप्लिकेशन NVIDIA-विशिष्ट घटकों पर निर्भर हो सकता है, भले ही उसके डेवलपर सीधे CUDA कोड कम ही लिखते हों।
एप्लिकेशन को किसी दूसरे एक्सेलरेटर पर ले जाने के लिए सिर्फ़ GPU की कंप्यूट क्षमता के बराबर होना काफ़ी नहीं है। मॉडल, उस पर निर्भर लाइब्रेरी, मेमोरी की ज़रूरतें और संचालन के टूल वैकल्पिक हार्डवेयर पर सही और कुशलता से काम करने चाहिए। इसीलिए NVIDIA को आसानी से नहीं बदला जा सकता।
प्रोसेसर की बुनियादी बातों के लिए TechiesJournal का CPU vs GPU vs TPU vs NPU vs LPU vs DPU की व्याख्या देखें।
Google के नए TPU सिस्टम क्या बदलते हैं
9 नवंबर 2026 को Google ने TPU 8tx और TPU 8i Max की घोषणा की, जिससे उसके आठवीं पीढ़ी के TPU पोर्टफ़ोलियो का विस्तार हुआ।
| TPU सिस्टम | इच्छित वर्कलोड |
|---|---|
| TPU 8t | बड़े पैमाने पर मॉडल ट्रेनिंग |
| TPU 8i | रीयल-टाइम इन्फ़रेंस और तर्क |
| TPU 8tx | गोपनीय इन्फ़रेंस और संवेदनशील AI वर्कलोड |
| TPU 8i Max | बड़े संदर्भ वाले वर्कलोड और बढ़ा हुआ कंप्यूट घनत्व |
ये एक ही प्रोसेसर के चार अदल-बदल सकने वाले संस्करण नहीं हैं। Google अलग-अलग AI वर्कलोड के लिए हार्डवेयर सिस्टम को ढाल रहा है, जिसमें पैकेजिंग, मेमोरी, नेटवर्किंग और सुरक्षा शामिल हैं। Google के अनुसार TPU 8tx वही सिलिकॉन इस्तेमाल करता है जो TPU 8t में है, और TPU 8i Max एक पैकेज में दो मौजूदा TPU 8i चिप जोड़ता है, इसलिए ये नई चिप आर्किटेक्चर नहीं, बल्कि नए सिस्टम कॉन्फ़िगरेशन हैं।
TPU 8tx: संवेदनशील वर्कलोड की सुरक्षा
कल्पना कीजिए कि कोई वित्तीय संस्था संवेदनशील ग्राहक रिकॉर्ड प्रोसेस करने के लिए AI मॉडल इस्तेमाल करती है। स्टोरेज और ट्रांज़िट में डेटा की सुरक्षा मायने रखती है, लेकिन संस्था को उस समय भी सुरक्षा चाहिए हो सकती है जब मॉडल उस जानकारी को प्रोसेस कर रहा हो।
कॉन्फ़िडेंशियल कंप्यूटिंग (confidential computing) हार्डवेयर-समर्थित आइसोलेशन और सुरक्षा तंत्रों का उपयोग करती है ताकि निष्पादन के दौरान अनधिकृत पहुँच घटे। Google के अनुसार TPU 8tx समर्थित इन्फ़रेंस वर्कलोड के लिए ऐसी क्षमताएँ देता है, साथ ही निजी मॉडल कस्टमाइज़ेशन और चुने हुए ट्रेनिंग उपयोग के मामलों के लिए भी।
कॉन्फ़िडेंशियल कंप्यूटिंग एप्लिकेशन की एंड-टू-एंड सुरक्षा की गारंटी नहीं देती। पहचान, अनुमतियाँ, मॉडल का व्यवहार और डिप्लॉयमेंट कॉन्फ़िगरेशन अलग ज़िम्मेदारियाँ बनी रहती हैं।
TPU 8i Max: माँग वाले संदर्भ वर्कलोड को सहारा
व्यापक दस्तावेज़ों या सॉफ़्टवेयर रिपॉज़िटरी को प्रोसेस करने वाला AI एजेंट मेमोरी क्षमता और मेमोरी तथा कंप्यूट घटकों के बीच सूचना की गति से सीमित हो सकता है।
Google TPU 8i Max के लिए एक पैकेज में दो TPU 8i चिप जोड़ता है। कंपनी के अनुसार यह एक अकेले TPU 8i की तुलना में दोगुना कंप्यूट, ऑन-चिप SRAM और हाई-बैंडविड्थ मेमोरी बैंडविड्थ देता है। ये तुलनाएँ Google के अपने पोर्टफ़ोलियो के भीतर हैं। वे किसी समतुल्य NVIDIA डिप्लॉयमेंट पर बढ़त साबित नहीं करतीं।
घोषित होने का मतलब हर जगह उपलब्ध होना नहीं है
घोषणा इच्छित क्षमताओं का वर्णन करती है। वह हर कॉन्फ़िगरेशन, स्थान या डिप्लॉयमेंट मॉडल के लिए सामान्य ग्राहक उपलब्धता स्थापित नहीं करती। माइग्रेशन की योजना बनाने से पहले खरीदारों को पात्रता, क्षमता, समर्थित सॉफ़्टवेयर, कीमत और व्यावसायिक पहुँच की पुष्टि करनी चाहिए।
PyTorch सपोर्ट चिप्स से ज़्यादा मायने क्यों रख सकता है
एक एक्सेलरेटर तब डेवलपरों के काम का बनता है जब उनके एप्लिकेशन उस पर चल सकें। 20 अक्टूबर 2026 को PyTorch प्रोजेक्ट ने TorchTPU की घोषणा की, जो Google और Meta का ओपन-सोर्स सहयोग है। TorchTPU Google के TPU के लिए एक नेटिव PyTorch बैकएंड लाता है और इसका लक्ष्य एप्लिकेशन को किसी दूसरे मशीन-लर्निंग फ़्रेमवर्क के आसपास दोबारा बनाने की ज़रूरत घटाना है।
यह प्रोजेक्ट सक्रिय रूप से विकसित हो रहा है। इसके डेवलपर कुछ ट्रेनिंग और इन्फ़रेंस वर्कलोड के लिए प्रोडक्शन उपयोग का वर्णन करते हैं, लेकिन यह हर मॉडल के लिए संगतता या प्रोडक्शन-तैयारी की गारंटी नहीं है।
मॉडल चलाना और उसे ऑप्टिमाइज़ करना एक बात नहीं है
कंपनी के AI असिस्टेंट पर लौटें। मान लीजिए उसका मौजूदा PyTorch मॉडल NVIDIA GPU इस्तेमाल करता है। किसी समर्थित कॉन्फ़िगरेशन के लिए, निष्पादन डिवाइस बदलने से मॉडल TPU पर चल सकता है और सही जवाब दे सकता है। TorchTPU का अपना वर्णन है कि पोर्टिंग उतनी आसान हो सकती है जितना model.to("cuda") को model.to("tpu") में बदलना, इस चेतावनी के साथ कि सर्वोच्च प्रदर्शन के लिए इससे ज़्यादा चाहिए। यह उपयोगी शुरुआती बिंदु है, माइग्रेशन का अंत नहीं।
मूल मॉडल GPU-विशिष्ट कस्टम कर्नेल, खास मेमोरी लेआउट या अपनी परतों को प्रोसेसरों में बाँटने की रणनीति इस्तेमाल कर सकता है। TPU हार्डवेयर पर मेमोरी और एक्सेलरेटर संचार का कुशल उपयोग करने के लिए अलग शार्डिंग (sharding) रणनीति, यानी मॉडल को कई प्रोसेसरों में बाँटने की रणनीति, की ज़रूरत पड़ सकती है। जो ऑपरेशन सही ढंग से चलता है, वह ट्यूनिंग के बिना भी खराब प्रदर्शन कर सकता है।
TorchTPU की तकनीकी चर्चा मॉडल के आकार, शार्डिंग और ऑपरेशनों को व्यावहारिक ऑप्टिमाइज़ेशन विचार बताती है। वह यह भी बताती है कि XLA कंपाइलर अपेक्षा करता है कि टेंसर आकार कंपाइल के समय ज्ञात हों, और कहती है कि बदलते आकारों के लिए सपोर्ट अभी सक्रिय विकास में है। फ़्रेमवर्क संगतता किसी वर्कलोड को चलना संभव बनाती है। प्रदर्शन पोर्टेबिलिटी के लिए पूरे सिस्टम को बिना अनुपातहीन पुनर्विकास के कुशलता से चलना होता है।
स्रोत: PyTorch, 20 अक्टूबर 2026।
इस चित्र का सुलभ टेक्स्ट विकल्प
आपका PyTorch मॉडल model.to("cuda") से NVIDIA GPU पर भेजा जा सकता है, जिसमें CUDA लाइब्रेरी और GPU कर्नेल इस्तेमाल होते हैं।
या उसे model.to("tpu") से Google TPU पर भेजा जा सकता है, जिसमें TorchTPU बैकएंड और XLA कंपाइलर इस्तेमाल होते हैं। मॉडल चलता है।
पूरी गति के लिए ट्यूनिंग अब भी बाकी है: टेंसर आकार, शार्डिंग और GPU-विशिष्ट कर्नेल।
AWS भी ऐसा ही विकल्प विकसित कर रहा है
AWS Trainium के ज़रिए इससे मिलता-जुलता तरीका अपना रहा है। 20 अक्टूबर 2026 को उसने TorchNeuron की घोषणा की, जो समर्थित Trainium इन्फ़्रास्ट्रक्चर के लिए बना नेटिव PyTorch बैकएंड है। यह ईगर निष्पादन और कंपाइलेशन सहित जाने-पहचाने PyTorch डेवलपमेंट पैटर्न को सपोर्ट करता है।
AWS ने TorchNeuron को Trainium2 और Trainium3 के लिए पब्लिक बीटा के रूप में लॉन्च किया। यह स्थिति सपोर्ट की अपेक्षाओं और प्रोडक्शन योजना के लिए मायने रखती है। TorchNeuron और TorchTPU सॉफ़्टवेयर अपनाने की कुछ बाधाएँ घटाते हैं, लेकिन वे Google और AWS के एक्सेलरेटर को अदल-बदल सकने योग्य नहीं बनाते। हार्डवेयर, कंपाइलर, समर्थित ऑपरेशन और डिप्लॉयमेंट परिवेश अलग हैं।
NVIDIA पूरे सिस्टम के ज़रिए मुकाबला कर रहा है
NVIDIA भी माँग वाले AI वर्कलोड के अनुसार खुद को ढाल रहा है। उसका Dynamo 1.0 इन्फ़रेंस फ़्रेमवर्क, जिसे मार्च 2026 में प्रोडक्शन-तैयार बताकर घोषित किया गया, वितरित निष्पादन, रिक्वेस्ट रूटिंग और GPU सिस्टम में मेमोरी के ज़्यादा कुशल उपयोग को संबोधित करता है।
NVIDIA का Rubin आर्किटेक्चर कंप्यूट, मेमोरी और इंटरकनेक्ट में सुधारों के ज़रिए तर्क और लंबे संदर्भ वाले इन्फ़रेंस को लक्ष्य बनाता है। उसके प्रकाशित प्रदर्शन आँकड़े विक्रेता-रिपोर्टेड दावे हैं और उन्हें सार्वभौमिक रूप से हासिल परिणाम नहीं समझना चाहिए।
यह अलग-थलग प्रोसेसरों के बीच नहीं, बल्कि हार्डवेयर, प्रोग्रामिंग इंटरफ़ेस, इन्फ़रेंस सॉफ़्टवेयर और नेटवर्किंग समेत एक्सेलरेटर प्लेटफ़ॉर्म के बीच की प्रतिस्पर्धा है। TechiesJournal का AWS और NVIDIA का दो मिलियन GPU विस्तार: क्लाउड आर्किटेक्ट्स को क्या समझना चाहिए क्लाउड निवेश का अतिरिक्त संदर्भ देता है।
स्रोत: NVIDIA Dynamo, 16 मार्च 2026 और Rubin आर्किटेक्चर, 21 जुलाई 2026।
कैसे तय करें कि कोई विकल्प सार्थक है या नहीं
कंपनी के आर्किटेक्ट अब अपने स्थापित NVIDIA डिप्लॉयमेंट की तुलना किसी उपलब्ध, समर्थित TPU कॉन्फ़िगरेशन से करना चाहते हैं। उन्हें अलग-थलग चिप स्पेसिफ़िकेशन की तुलना करने के बजाय समतुल्य वर्कलोड का परीक्षण करना होगा। दोनों सिस्टम को एक ही मॉडल के साथ, या ऐसे कॉन्फ़िगरेशन के साथ जिनके अंतर पारदर्शी रूप से दर्ज हों, स्वीकार्य मॉडल गुणवत्ता देनी चाहिए।
| मूल्यांकन कारक | क्या मापें |
|---|---|
| शुद्धता | आउटपुट की गुणवत्ता और समर्थित ऑपरेशन |
| लेटेंसी | पहले टोकन तक का समय और पूरे जवाब का समय |
| थ्रूपुट | ज़रूरी कॉन्करेंसी पर उपयोगी काम |
| मेमोरी | क्षमता, बैंडविड्थ और लंबे संदर्भ में व्यवहार |
| लागत | समतुल्य सेवा की कुल लागत |
| माइग्रेशन | कोड बदलाव, ट्यूनिंग और इंजीनियरिंग प्रयास |
| संचालन | मॉनिटरिंग, सपोर्ट, उपलब्धता और समस्या निवारण |
अगर वर्कलोड अकुशलता से चलता है तो कम प्रति घंटा कीमत भी ऊँची सेवा लागत दे सकती है। ज़्यादा महँगा सिस्टम तब किफ़ायती हो सकता है जब वह ज़रूरी सेवा सीमाओं के भीतर ज़्यादा उपयोगी काम दे। प्रकाशित बेंचमार्क उम्मीदवार चुनने में मदद करते हैं, लेकिन मॉडल, प्रिसीज़न, संदर्भ लंबाई और कॉन्करेंसी में अंतर के कारण मुख्य परिणाम तुलनीय नहीं रह सकते।
एक निर्भरता बदलने से दूसरी आ सकती है
TPU पर जाने से CUDA और NVIDIA हार्डवेयर पर निर्भरता घट सकती है, जबकि Google Cloud, TPU-विशिष्ट टूलिंग या समर्थित डिप्लॉयमेंट विकल्पों पर निर्भरता बढ़ सकती है। Trainium AWS के भीतर ऐसी ही निर्भरताएँ बना सकता है।
हार्डवेयर स्वतंत्रता का मतलब है एक एक्सेलरेटर इकोसिस्टम का व्यावहारिक विकल्प होना। क्लाउड पोर्टेबिलिटी का मतलब है किसी एप्लिकेशन को बिना अत्यधिक पुनर्डिज़ाइन और संचालन की बाधा के एक क्लाउड परिवेश से दूसरे में ले जा पाना। एक दूसरे की गारंटी नहीं देता।
एक ही प्रदाता से जुड़ा संगठन मापने योग्य लाभ के लिए विशेष एकीकरण स्वीकार कर सकता है। मल्टी-क्लाउड संगठन पोर्टेबिलिटी को ज़्यादा महत्व दे सकता है। किसी भी लक्ष्य को उसकी लागत पर विचार किए बिना नहीं अपनाना चाहिए।
क्या NVIDIA बाज़ार हिस्सेदारी खोएगा?
विश्वसनीय विकल्पों का दिखना, अपने आप में NVIDIA के वित्तीय नुकसान को स्थापित नहीं करता। तीन परिणाम अलग-अलग हैं।
चयन का मतलब है कि कोई ग्राहक दूसरे एक्सेलरेटर पर विचार कर सकता है। प्रतिस्थापन का मतलब है कि वह ग्राहक सचमुच किसी समर्थित वर्कलोड को ले जाता है। वित्तीय विस्थापन का मतलब है कि यह कदम NVIDIA की खरीद को उससे कम कर देता है जो अन्यथा होती।
AI कंप्यूटिंग बाज़ार इतना बढ़ सकता है कि NVIDIA GPU और कस्टम एक्सेलरेटर एक साथ बढ़ें। NVIDIA का सॉफ़्टवेयर इकोसिस्टम और इंस्टॉल्ड बेस उसके लाभ बने हुए हैं। मौजूदा प्रमाण TPU 8tx या TPU 8i Max के कारण किसी विशिष्ट बाज़ार हिस्सेदारी पूर्वानुमान का समर्थन नहीं कर सकते।
डेवलपरों और क्लाउड आर्किटेक्टों को अभी क्या करना चाहिए
मौजूदा टीमों को पहले CUDA-विशिष्ट कर्नेल, इन्फ़रेंस लाइब्रेरी, मॉडल-सर्विंग निर्भरताएँ और GPU-केंद्रित संचालन टूल पहचानने चाहिए। नए सिस्टम को मॉडल की ज़रूरतों, उपलब्ध क्षमता, लेटेंसी, सुरक्षा और कुल लागत के अनुसार एक्सेलरेटर विकल्पों की शॉर्टलिस्ट बनानी चाहिए।
जहाँ संभावित लाभ प्रयास को उचित ठहराएँ, वहाँ किसी भरोसेमंद बेसलाइन के मुकाबले सीमित बेंचमार्क करें। दर्ज करें कि मॉडल चलता है या नहीं, कितना अच्छा प्रदर्शन करता है, उसके लिए कौन-सा इंजीनियरिंग काम चाहिए और संचालन मॉडल सपोर्ट करने योग्य है या नहीं।
Google का TPU विस्तार और बेहतर होता फ़्रेमवर्क सपोर्ट चुने हुए वर्कलोड के लिए एक्सेलरेटर विकल्पों को ज़्यादा व्यावहारिक बनाते हैं। बदलना सार्थक है या नहीं, यह संगतता, मापे गए प्रदर्शन, कुल लागत और उससे आने वाली नई निर्भरताओं के आधार पर तय होना चाहिए।
और गहराई से जानें
- Google: Our newest TPUs, 8tx and 8i Max (9 नवंबर 2026)।
- PyTorch: Introducing TorchTPU (20 अक्टूबर 2026)।
- AWS: Native PyTorch Support for AWS Trainium (20 अक्टूबर 2026)।
- NVIDIA: Dynamo 1.0 Production-Scale Inference (16 मार्च 2026)।
- NVIDIA: Inside Rubin GPU Architecture (21 जुलाई 2026)।
स्रोत 13 नवंबर 2026 को पढ़े गए थे। उत्पाद की उपलब्धता, परिपक्वता और विक्रेताओं के दावे बदल सकते हैं।