

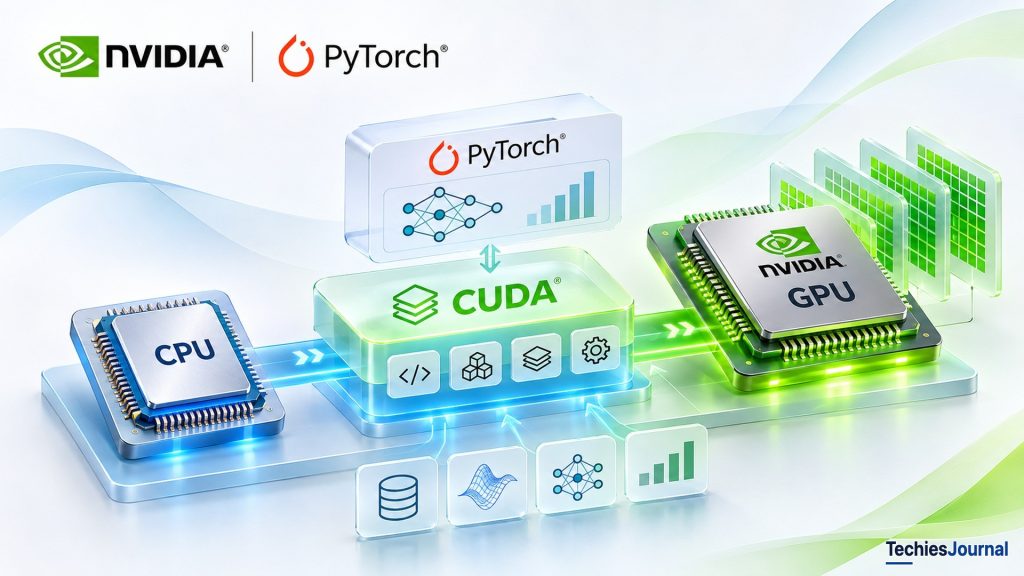
CPUలు, GPUలు కలిసి ఎలా పనిచేస్తాయి, CUDA ఏమి జోడిస్తుంది, AI ఫ్రేమ్వర్క్లు దీన్ని ఎలా ఉపయోగిస్తాయి, వేర్వేరు పాత్రల వారు దీన్ని ఎంత లోతుగా నేర్చుకోవాలి అనే విషయాలు.
ఒక కంప్యూటర్ అత్యంత శక్తివంతమైనదైనా, కొన్ని రకాల లెక్కల విషయంలో ఇబ్బంది పడవచ్చు.
ఒక విమాన భాగంలో వేడి ఎలా ప్రసరిస్తుందో అనుకరించే సాఫ్ట్వేర్ను అభివృద్ధి చేస్తున్న ఇంజనీరింగ్ బృందాన్ని ఊహించండి. ఆ సిమ్యులేషన్ భాగాన్ని మిలియన్ల కొద్దీ చిన్న ప్రాంతాలుగా విభజించి, వాటి అంతటా ఉష్ణోగ్రత ఎలా మారుతుందో మళ్లీ మళ్లీ లెక్కిస్తుంది.
ప్రతి లెక్క చాలా సరళంగానే ఉండవచ్చు. సవాలు ఏమిటంటే చేయాల్సిన లెక్కల సంఖ్య. బృందం ఆ సిమ్యులేషన్ను సాధారణ కంప్యూటర్ ప్రాసెసర్పై నడపవచ్చు. కానీ సిమ్యులేషన్ మరింత వివరంగా మారేకొద్దీ గణన అవసరం పెరుగుతుంది. మోడల్, అల్గారిథమ్లు, అందుబాటులో ఉన్న హార్డ్వేర్ను బట్టి, ఒకప్పుడు నిమిషాల్లో పూర్తయిన పని చివరకు గంటలు పట్టవచ్చు.
వేగవంతమైన ప్రాసెసర్ను వాడితే సహాయం కావచ్చు. కానీ మరో ప్రశ్న క్రమంగా ముఖ్యమవుతుంది: సమస్యను అనేక చిన్న లెక్కలుగా విభజించి, వాటిని సమాంతరంగా ప్రాసెస్ చేయగలిగితే ఎలా ఉంటుంది?
ఇక్కడే CPUకి, GPUకి మధ్య ఉన్న తేడా ముఖ్యమవుతుంది.
కంప్యూటర్లకు CPUలు ఎందుకు ఉంటాయి
ప్రతి సాధారణ ప్రయోజన కంప్యూటర్ ఇన్స్ట్రక్షన్లను అమలు చేయడానికి, అనేక రకాల ఆపరేషన్లను సమన్వయం చేయడానికి Central Processing Unit (CPU) మీద ఆధారపడుతుంది. మీరు బ్రౌజర్ తెరిచినప్పుడు, డాక్యుమెంట్ సేవ్ చేసినప్పుడు, వ్యాపార అప్లికేషన్ నడిపినప్పుడు లేదా ఒక ప్రోగ్రామ్ను అమలు చేసినప్పుడు, ఆ ఆపరేషన్లు జరగడంలో CPU ముఖ్యమైన పాత్ర పోషిస్తుంది.
ఆధునిక CPUలో అనేక ప్రాసెసింగ్ కోర్లు ఉంటాయి. ప్రతి కోర్ ఇన్స్ట్రక్షన్లను సమర్థవంతంగా అమలు చేయడానికి రూపొందించబడింది. వైవిధ్యమైన ఆపరేషన్లు, నిర్ణయాలు తీసుకోవడం, మారే అమలు మార్గాలు, ముందటి ఇన్స్ట్రక్షన్ల ఫలితాలపై ఆధారపడే పనులు ఉండే వర్క్లోడ్లలో CPUలు ప్రత్యేకంగా సమర్థంగా ఉంటాయి.
CPUలు కూడా సమాంతర ప్రాసెసింగ్ చేయగలవు. బహుళ కోర్లు ఉన్న ప్రాసెసర్ అనేక పనులను లేదా వర్క్లోడ్లోని భాగాలను ఒకే సమయంలో అమలు చేయగలదు, ఆధునిక CPU కోర్లు అనేక గణిత ఆపరేషన్లను ఏకకాలంలో చేయగలవు. కానీ CPUలు అనేక రకాల కంప్యూటింగ్ అవసరాలను సమతుల్యం చేసేలా రూపొందించబడ్డాయి. భారీ సంఖ్యలో ఒకేరకమైన లెక్కలను అమలు చేయడానికి మాత్రమే అవి ఆప్టిమైజ్ చేయబడలేదు.
మన హీట్ సిమ్యులేషన్కు తిరిగి వద్దాం. కొన్ని భాగాలకు డేటాను సమన్వయం చేయడం, నిర్ణయాలు తీసుకోవడం, మొత్తం ప్రోగ్రామ్ను నిర్వహించడం అవసరం. CPU ఈ బాధ్యతలను బాగా నిర్వర్తిస్తుంది. ఇతర భాగాల్లో మిలియన్ల కొద్దీ ప్రాంతాలపై గణిత ఆపరేషన్లను మళ్లీ మళ్లీ వర్తింపజేయడం ఉంటుంది. అది వేరే రకం ప్రాసెసర్కు అవకాశం కల్పిస్తుంది.
GPUలు ఎందుకు భిన్నమైనవి
Graphics Processing Unit (GPU) అనేది మొదట గ్రాఫిక్స్ సంబంధిత గణనను వేగవంతం చేయడానికి అభివృద్ధి చేసిన ప్రాసెసర్. త్రీ-డైమెన్షనల్ దృశ్యాన్ని రెండర్ చేయడంలో పెద్ద సంఖ్యలో పిక్సెల్లు, ఉపరితలాలు, టెక్స్చర్లు, జ్యామితీయ అంశాల రూపాన్ని లెక్కించడం ఉంటుంది. ఈ లెక్కల్లో చాలా వాటిని సమాంతరంగా చేయవచ్చు.
ఈ లక్షణం ఉన్న వర్క్లోడ్లకు అధిక గణన త్రూపుట్ను అందించేలా GPU ఆర్కిటెక్చర్లు పరిణామం చెందాయి. విస్తృత శ్రేణి పనులను సమర్థంగా అమలు చేయడానికి గణనీయమైన హార్డ్వేర్ వనరులను కేటాయించే CPUకి భిన్నంగా, GPU తన ఆర్కిటెక్చర్లో ఎక్కువ భాగాన్ని తగిన పనిని పెద్ద మొత్తంలో సమాంతరంగా ప్రాసెస్ చేయడానికి కేటాయిస్తుంది.
ఈ తేడా వల్ల GPUలు గ్రాఫిక్స్ చూపించడానికి మించి విలువైనవి అవుతాయి. మన ఇంజనీరింగ్ సిమ్యులేషన్లో కూడా పరస్పర సంబంధం ఉన్న గణిత ఆపరేషన్లు పెద్ద సంఖ్యలో ఉన్నాయి. తగిన అల్గారిథమ్తో, వాటిలో చాలా ఆపరేషన్లు GPU అంతటా అమలు కావచ్చు.
సిమ్యులేషన్కు ఇంకా CPU అవసరమే. మొత్తం అప్లికేషన్ను నడిపే ప్రాసెసర్ స్థానంలో GPU రాదు. బదులుగా CPU, GPU కలిసి పనిచేయగలవు, ప్రతిదీ తన ఆర్కిటెక్చర్కు తగిన వర్క్లోడ్ భాగాలను నిర్వహిస్తుంది.
ఈ చిత్రానికి అందుబాటు టెక్స్ట్ ప్రత్యామ్నాయం
నాలుగు ఉదాహరణ CPU కోర్లను, అనేక నైరూప్య GPU అమలు యూనిట్లతో పోలుస్తున్న రేఖాచిత్రం. ఇది స్కేల్ ప్రకారం కాదు.
చిత్రంలో చూపిన టెక్స్ట్: 1. CPU, GPU డిజైన్లు ఎందుకు భిన్నం | రెండూ లెక్కలు చేస్తాయి. బలాలు భిన్నం, సార్వత్రిక వేగ ర్యాంకింగ్ కాదు. | CPU · సాధారణ ప్రాసెసింగ్ | GPU · సమాంతర త్రూపుట్ | కోర్ 1 | కోర్ 2 | కోర్ 3 | కోర్ 4 | వైవిధ్యమైన పనులు · సంక్లిష్ట ఫ్లో | అనేక సమాన లెక్కలు సమాంతరంగా | ఉదాహరణ మాత్రమే: బాక్స్లు కోర్ సంఖ్యల పోలిక కాదు.
GPUలు కేవలం వేగవంతమైన CPUలు అని నిర్ధారణకు రావాలని అనిపించవచ్చు. కానీ అవి అలా కావు. తగిన సమాంతర వర్క్లోడ్పై GPU, CPU కంటే గణనీయంగా మెరుగ్గా పనిచేయవచ్చు. కానీ సంక్లిష్టమైన వరుస ఆధారపడటాలు, క్రమరహిత ఆపరేషన్లు లేదా చాలా తక్కువ పని ఉన్న అప్లికేషన్లకు పెద్దగా ప్రయోజనం కలగకపోవచ్చు.
CPU, GPU మెమరీల మధ్య డేటాను తరలించడం, అమలును సమన్వయం చేయడం, GPU వనరులను కేటాయించడం కూడా ఖర్చులను కలిగిస్తాయి. పనితీరు సమస్య స్వభావం, అమలు విధానం, హార్డ్వేర్పై ఆధారపడి ఉంటుంది, GPU అందుబాటులో ఉందా లేదా అనే దానిపై మాత్రమే కాదు.
GPUలు శక్తివంతమైనవైతే CUDA ఎందుకు అవసరం?
ఒక ఇంజనీర్ GPUను ఎందుకు వాడాలనుకుంటారో ఇప్పుడు అర్థమైంది. కానీ ఒక గణనను అమలు చేయగల హార్డ్వేర్ను గుర్తించడం సవాలులో ఒక భాగం మాత్రమే. ఇంజనీరింగ్ బృందం దగ్గర గణిత ఆపరేషన్లు, డేటా స్ట్రక్చర్లు, ప్రోగ్రామ్ ఇన్స్ట్రక్షన్ల ద్వారా సిమ్యులేషన్ను వివరించే అప్లికేషన్ ఉంది. GPUకి భిన్నమైన అమలు ఆర్కిటెక్చర్, మెమరీ వ్యవస్థ ఉంటాయి.
సాధారణ CPU ఫంక్షన్ వేలాది GPU threadల అంతటా సమర్థంగా నడుస్తుందని అప్లికేషన్ ఊహించడం సాధ్యం కాదు. ఏ లెక్కలు GPUపై నడవాలో, ఆ పనిని ఎలా వ్యవస్థీకరించాలో, డేటా ఎలా అందుబాటులోకి వస్తుందో, అమలును ఎలా సమన్వయం చేయాలో వివరించడానికి దానికి ఒక మార్గం కావాలి.
తగిన ప్రోగ్రామింగ్ ఇంటర్ఫేస్లు, కంపైలర్లు, లైబ్రరీలు, సహాయక సాఫ్ట్వేర్ లేకపోతే, GPU గణన సామర్థ్యంలో చాలా భాగాన్ని సాధారణ ప్రయోజన అప్లికేషన్లు వినియోగించుకోవడం కష్టంగానే ఉండిపోతుంది. CUDAను ముఖ్యమైనదిగా చేసే సమస్య ఇదే.
NVIDIA నవంబర్ 2006లో CUDAను ప్రకటించినప్పుడు, అనుకూలమైన NVIDIA GPUలను కేవలం సంప్రదాయ గ్రాఫిక్స్ ప్రాసెసింగ్కే కాకుండా సాధారణ ప్రయోజన కంప్యూటింగ్ కోసం ప్రోగ్రామ్ చేయగలిగేలా చేయడానికి అది సహాయపడింది. CUDA అసలు పూర్తి రూపం Compute Unified Device Architecture.
దీని ప్రాముఖ్యత GPUలను శక్తివంతంగా చేయడంలో లేదు. గణన సామర్థ్యాన్ని హార్డ్వేర్ ఆర్కిటెక్చర్ అందిస్తుంది. ఆ సామర్థ్యాన్ని ఉపయోగించి పనిని వ్యక్తీకరించి, అమలు చేయడంలో సాఫ్ట్వేర్ డెవలపర్లకు CUDA సహాయపడుతుంది.
కాలక్రమేణా, చుట్టూ ఉన్న ఎకోసిస్టమ్ గణిత లైబ్రరీలు, కంపైలర్లు, డీబగ్గింగ్ టూల్స్, పనితీరు విశ్లేషణ టూల్స్, ఉన్నత స్థాయి సాఫ్ట్వేర్తో ఇంటిగ్రేషన్లు కూడా చేరేలా విస్తరించింది. ఆ పునాది చివరకు ఆర్టిఫిషియల్ ఇంటెలిజెన్స్కు ప్రత్యేకంగా ముఖ్యమైనదిగా మారింది.
ఈ రోజు ఒక డెవలపర్ CUDA కోడ్ను నేరుగా రాయకుండానే Python, PyTorch ఉపయోగించి న్యూరల్ నెట్వర్క్ను ట్రైన్ చేయవచ్చు. అయినా Python అప్లికేషన్ కింద, NVIDIA GPU హార్డ్వేర్పై గణనలో గణనీయమైన భాగాన్ని అమలు చేసే బాధ్యత CUDA-ఎనేబుల్డ్ సాఫ్ట్వేర్దే కావచ్చు.
ఆ సంబంధాన్ని అర్థం చేసుకోవడానికి, ఒక అప్లికేషన్ సాధారణ ప్రోగ్రామ్ ఇన్స్ట్రక్షన్ల నుంచి సమాంతర GPU అమలుకు ఎలా వెళ్తుందో పరిశీలించాలి.
అప్లికేషన్ నుంచి GPU వరకు: CUDA ఆర్కిటెక్చర్ను అర్థం చేసుకోవడం
ఇంజనీరింగ్ సిమ్యులేషన్కు తిరిగి వద్దాం. అప్లికేషన్ సిమ్యులేషన్ను సిద్ధం చేయాలి, ప్రారంభ విలువలను లోడ్ చేయాలి, లెక్కలను నిర్వహించాలి, చివరకు ఫలితాలను చూపించాలి లేదా నిల్వ చేయాలి. ఆ పని అంతా GPUకి చెందదు.
ప్రధాన అప్లికేషన్ను నడపడం, ఆపరేషన్లను సమన్వయం చేయడం, తగిన GPU లెక్కలను ప్రారంభించడం CPU బాధ్యతగానే ఉంటుంది. CUDA పరిభాషలో అప్లికేషన్లోని CPU వైపును host అంటారు, GPUను device అంటారు. ఈ తేడా ముఖ్యం, ఎందుకంటే host, device రెండింటికీ భిన్నమైన అమలు వనరులు, మెమరీ స్పేస్లు ఉండవచ్చు.
సిమ్యులేషన్ CPU వైపు కోడ్ మిలియన్ల కొద్దీ ఉష్ణోగ్రత విలువలను సిద్ధం చేయవచ్చు. తర్వాత ఆ విలువలను GPU కోడ్కు అందుబాటులోకి తేవాలి. ఒక సాధారణ CUDA అప్లికేషన్ రన్టైమ్ను ఉపయోగించి GPU అందుకోగల మెమరీని కేటాయించవచ్చు, డేటాను బదిలీ చేయవచ్చు, GPUపై లెక్కలను ప్రారంభించవచ్చు, అమలును సింక్రనైజ్ చేయవచ్చు, ఫలితాలను తిరిగి తీసుకోవచ్చు. అప్లికేషన్కు కనిపించే ఆ ఇంటర్ఫేస్ల కింద, NVIDIA సాఫ్ట్వేర్, డ్రైవర్ ఇన్ఫ్రాస్ట్రక్చర్ GPU హార్డ్వేర్తో పరస్పర చర్యలను నిర్వహిస్తాయి.
ఈ చిత్రానికి అందుబాటు టెక్స్ట్ ప్రత్యామ్నాయం
అప్లికేషన్ CPU host, CUDA ఇంటర్ఫేస్లతో అనుసంధానమై, డ్రైవర్ ఇన్ఫ్రాస్ట్రక్చర్ ద్వారా NVIDIA GPUను చేరుకుంటుంది. సరళీకృత సంభావిత ఆర్కిటెక్చర్.
చిత్రంలో చూపిన టెక్స్ట్: 2. అప్లికేషన్ ఆర్కిటెక్చర్లో CUDA | CUDA ప్లాట్ఫామ్, ఎకోసిస్టమ్. అది GPU కాదు, తప్పనిసరి ఒకే పొర కాదు. | ఇంజనీరింగ్ సిమ్యులేషన్ అప్లికేషన్ | CPU / Host | ప్రోగ్రామ్ నియంత్రణ, ఆర్కెస్ట్రేషన్ | CUDA ఇంటర్ఫేస్లు / లైబ్రరీలు | Kernel లాంచ్లు, డేటా, కంప్యూట్ APIలు | NVIDIA డ్రైవర్ + అనుకూల GPU | Device అమలు | Host, device సహకరిస్తాయి. APIలు, లైబ్రరీలు, డ్రైవర్ పాత్రలు వేరు.
ఇక్కడ ఒక ఆర్కిటెక్చర్ సంబంధిత తేడా ఉంది. CUDA అనేది ప్రతి అప్లికేషన్కు, GPUకి మధ్య ఉండే ఒకే సాఫ్ట్వేర్ భాగం కాదు. ఇది వేర్వేరు బాధ్యతలు ఉన్న ఇంటర్ఫేస్లు, టూల్స్, లైబ్రరీలు కలిగిన విస్తృత ప్రోగ్రామింగ్ ప్లాట్ఫామ్, ఎకోసిస్టమ్. కొన్ని అప్లికేషన్లు CUDA APIలను నేరుగా పిలుస్తాయి. మరికొన్ని అంతర్గతంగా CUDA వాడే లైబ్రరీలు లేదా ఫ్రేమ్వర్క్లపై ఆధారపడతాయి.
ఒక నిజమైన లెక్కను అనుసరిస్తే ఈ సంబంధం మరింత స్పష్టమవుతుంది.
CUDA ఒక లెక్కను అమలు చేసినప్పుడు ఏమి జరుగుతుంది?
మన ఇంజనీరింగ్ బృందం పెద్ద సంఖ్యలో ప్రాంతాల అంతటా ఉష్ణోగ్రత మార్పులను లెక్కించాలనుకుంటోందని ఊహించండి. ఉదాహరణ కోసం, మునుపటి సిమ్యులేషన్ దశ విలువలను ఉపయోగించి, తగిన ఒక దశను అనేక ప్రాంతాలకు స్వతంత్రంగా చేయవచ్చని అనుకుందాం.
అప్లికేషన్ మొదట ఇన్పుట్ డేటాను సిద్ధం చేస్తుంది. తర్వాత ఆ ఇన్పుట్లను GPU అందుకోగలదని నిర్ధారిస్తుంది. సంప్రదాయ స్పష్టమైన మెమరీ వర్క్ఫ్లోలో, అప్లికేషన్ device మెమరీని కేటాయించి, డేటాను CPU మెమరీ నుంచి GPU మెమరీకి కాపీ చేస్తుంది. managed memory సహా ఇతర విధానాలు ఉన్నాయి, కానీ ప్రాథమిక అవసరం అదే: గణన జరిగే చోట డేటా అందుబాటులో ఉండాలి.
డేటా సిద్ధమైన తర్వాత, అప్లికేషన్ GPUపై అమలు కావడానికి రూపొందించిన ఒక ఫంక్షన్ను ప్రారంభిస్తుంది. CUDA ఈ ఫంక్షన్ను kernel అంటుంది. kernel పూర్తి అప్లికేషన్ కాదు. GPU threadలు అమలు చేసే ఒక నిర్దిష్ట గణనను అది వివరిస్తుంది.
మన సిమ్యులేషన్కు, kernel ప్రతి ప్రాంతానికి చుట్టుపక్కల విలువలను ఉపయోగించి నవీకరించిన ఉష్ణోగ్రత విలువను లెక్కించవచ్చు. ఒకే CPU అమలు మార్గం ద్వారా ఒక లెక్క తర్వాత మరో లెక్కను అమలు చేయడానికి బదులుగా, తగిన పనిని సమాంతరంగా చేయడానికి అప్లికేషన్ GPU threadల పెద్ద సమూహాన్ని ప్రారంభిస్తుంది.
kernel పూర్తయినప్పుడు, ఫలితాలు మరో సిమ్యులేషన్ దశ కోసం GPU మెమరీలోనే ఉండవచ్చు. CPUకి విలువలు అవసరమైనప్పుడు మాత్రమే (ఉదాహరణకు, నివేదిక రాయడానికి లేదా ఫలితం చూపించడానికి) అప్లికేషన్ వాటిని host మెమరీకి తిరిగి బదిలీ చేయవచ్చు.
ఈ చిత్రానికి అందుబాటు టెక్స్ట్ ప్రత్యామ్నాయం
ఐదు దశలు: డేటా సిద్ధం చేయడం, GPUకి అందుబాటులోకి తేవడం, kernel ప్రారంభించడం, deviceపై గణన, ఫలితాలు వాడటం. సింక్రనైజేషన్ గమనిక కూడా ఉంది.
చిత్రంలో చూపిన టెక్స్ట్: 3. ఒక CUDA గణన, దశలవారీగా | ఇంజనీరింగ్ హీట్ సిమ్యులేషన్ ఉదాహరణ. GPU ఫలితాలు deviceలోనే ఉండవచ్చు. | 1 · సిద్ధం | CPU ఇన్పుట్ల సృష్టి | 2 · డేటా అందుబాటు | కేటాయింపు/కాపీ లేదా managed memory | 3 · Kernel లాంచ్ | Host GPU పనిని పంపుతుంది | 4 · గణన | Device threadలు లెక్కిస్తాయి | 5 · ఫలితం వాడటం | GPU తదుపరి దశ లేదా CPU చదవడం | GPU పని అసింక్రనస్ కావచ్చు. అవసరమైతే సింక్రనైజ్ చేయండి. | డేటా బదిలీ షరతుతో: unified/managed memory, GPUలో పునర్వినియోగం మార్గం మారుస్తాయి.
మధ్యంతర ఫలితాలను GPUలోనే ఉంచడం ఎంత ముఖ్యమో గమనించండి. సిమ్యులేషన్కు వేలాది ప్రాసెసింగ్ దశలు అవసరమైతే, ప్రతి దశ తర్వాత మొత్తం డేటాసెట్ను CPUకి తిరిగి బదిలీ చేయడం గణనీయమైన ఓవర్హెడ్ను కలిగించవచ్చు. మెరుగైన డిజైన్ GPUపై అనేక ఆపరేషన్లు చేసి, CPUకి నిజంగా అవసరమైనది మాత్రమే బదిలీ చేయవచ్చు.
ఇది ఒక పెద్ద సూత్రాన్ని చూపిస్తుంది: GPU యాక్సిలరేషన్ అంటే కేవలం వ్యక్తిగత గణిత ఆపరేషన్లను వేగవంతం చేయడం కాదు. గణన, డేటా వ్యవస్థ గుండా ఎలా కదలాలో రూపొందించడం కూడా అవసరం.
GPU పనిచేస్తున్నప్పుడు CPU వేచి ఉంటుందా?
తప్పనిసరిగా కాదు. అనేక CUDA ఆపరేషన్లను అసింక్రనస్గా ప్రారంభించవచ్చు, దీనివల్ల ముందే సమర్పించిన ఆపరేషన్లను GPU ప్రాసెస్ చేస్తుండగా CPU ఇతర పని కొనసాగించగలదు. క్యూలో ఉన్న GPU ఆపరేషన్లను వ్యవస్థీకరించడానికి CUDA streamsను ఉపయోగిస్తుంది.
ఒకే streamకు సమర్పించిన ఆపరేషన్లకు క్రమ నియమాలు ఉంటాయి, వేర్వేరు streamsలోని స్వతంత్ర ఆపరేషన్లు ఆధారపడటాలు, హార్డ్వేర్ సామర్థ్యాలను బట్టి ఒకదానితో ఒకటి అతివ్యాప్తి చెందవచ్చు. నిర్దిష్ట పని పూర్తయిందని తెలుసుకోవాల్సినప్పుడు లేదా మరో ఆపరేషన్ దాని ఫలితాలపై ఆధారపడినప్పుడు అప్లికేషన్ సింక్రనైజ్ చేయాలి.
మన సిమ్యులేషన్ GPU ప్రస్తుత బ్యాచ్ను ప్రాసెస్ చేస్తుండగా తదుపరి ఇన్పుట్ బ్యాచ్ను సిద్ధం చేయవచ్చు. కానీ తదుపరి లెక్క మునుపటి ఫలితాలపై ఆధారపడితే, ప్రోగ్రామ్ ఆ ఆధారపడటాన్ని కాపాడాలి. అసింక్రనస్ అమలు వినియోగాన్ని మెరుగుపరచగలదు. కానీ సరైన సమన్వయం అవసరాన్ని అది తొలగించదు.
వేలాది GPU threadల మధ్య CUDA పనిని ఎలా విభజిస్తుంది?
kernelను GPUపై అమలయ్యే ఫంక్షన్గా వర్ణించాం. కానీ ఏ ప్రాంతాన్ని ఏ thread లెక్కించాలో GPUకి ఎలా తెలుస్తుంది? CUDA ఒక తార్కిక అమలు శ్రేణిని అందిస్తుంది: threads, thread blocks, grids.
thread అంటే kernel యొక్క ఒక తార్కిక అమలు ఉదాహరణ. ప్రతి thread ఏ వర్క్లోడ్ భాగాన్ని ప్రాసెస్ చేయాలో నిర్ణయించడంలో సహాయపడే ఐడెంటిఫయర్లను అందుకోగలదు. threadలను thread blocks అనే సమూహాలుగా వ్యవస్థీకరిస్తారు. thread blocksల సమూహం ఒక grid అవుతుంది.
ఒక లెక్కింపు దశ కోసం స్వతంత్రంగా ప్రాసెస్ చేసే 1,024 ప్రాంతాలు ఉన్న సరళీకృత సిమ్యులేషన్ను పరిగణించండి. డెవలపర్ ఒక్కొక్కటి 256 threadలు ఉన్న నాలుగు thread blocksను ప్రారంభించవచ్చు. అది 1,024 తార్కిక threadలను సృష్టిస్తుంది, ప్రతిదీ ఒక ప్రాంతానికి బాధ్యత వహించే అవకాశం ఉంటుంది. ప్రతి thread kernel కోడ్ను నడుపుతుంది కానీ ఏ ప్రాంతాన్ని నవీకరించాలో గుర్తించడానికి తన సొంత index ఉపయోగిస్తుంది.
ఈ చిత్రానికి అందుబాటు టెక్స్ట్ ప్రత్యామ్నాయం
Gridలో ఒక్కొక్కటి 256 threadలు ఉన్న నాలుగు blocks ఉన్నాయి. ప్రత్యేక GPU హార్డ్వేర్ ప్యానెల్ streaming multiprocessorsపై షెడ్యూలింగ్ను వివరిస్తుంది.
చిత్రంలో చూపిన టెక్స్ట్: 4. CUDA తార్కిక అమలు శ్రేణి | ఉదాహరణ: 1,024 తార్కిక threadలు = 4 blocks × 256 threadలు. 1,024 భౌతిక కోర్లు కాదు. | ఒక kernel లాంచ్ · Grid | Thread block 1 · 256 threadలు | Thread block 2 · 256 threadలు | Thread block 3 · 256 threadలు | Thread block 4 · 256 threadలు | GPU హార్డ్వేర్ | Streaming multiprocessors | blocksను షెడ్యూల్ చేస్తాయి | Warps threadలను నడుపుతాయి | Blocks, threadలు సాఫ్ట్వేర్ వ్యవస్థీకరణ. SMలు, warps హార్డ్వేర్ అమలు భావనలు. | చూపినవి: ప్రతి blockలోని 256 threadలలో 16
ప్రతి లెక్కను ఒక్కో భౌతిక ప్రాసెసింగ్ యూనిట్కు చేతితో కేటాయించకుండా, పెద్ద సమాంతర వర్క్లోడ్ను వివరించడమే దీని ఉద్దేశం. ఒకే blockలోని threadలు మధ్యంతర డేటాను పంచుకోవడానికి మద్దతు ఉన్న సింక్రనైజేషన్ యంత్రాంగాలను, shared memoryని ఉపయోగించవచ్చు.
మన సిమ్యులేషన్లో అది విలువైనది కావచ్చు. ఒక ప్రాంతం కొత్త ఉష్ణోగ్రత చుట్టుపక్కల ప్రాంతాలపై ఆధారపడవచ్చు. జాగ్రత్తగా రూపొందించిన kernel, నెమ్మదైన మెమరీ నుంచి అదే సమాచారాన్ని మళ్లీ మళ్లీ తీసుకోకుండా, సహకరించే threadలు చుట్టుపక్కల విలువలను తిరిగి వాడుకునేలా చేయగలదు.
కానీ సాధారణ thread-block ప్రోగ్రామింగ్లో, అన్ని blocks ఒకేసారి అమలవుతాయని లేదా ఒక block మిగతా అన్ని blocksతో స్వేచ్ఛగా సింక్రనైజ్ కాగలదని డెవలపర్లు ఊహించకూడదు. గ్లోబల్ సమన్వయం అవసరమైన అల్గారిథమ్ ఆ పరిమితులను పరిగణనలోకి తీసుకోవాలి లేదా తగిన యంత్రాంగాలను ఉపయోగించాలి.
CUDA threadలు భౌతిక GPU కోర్లతో సమానమేనా?
కాదు. threads, blocks అనేవి సాఫ్ట్వేర్ పనిని ఎలా వ్యవస్థీకరిస్తుందో వివరిస్తాయి. ఆ పనిని అమలు చేసేవి GPUలోని భౌతిక గణన వనరులు. NVIDIA GPUలలో Streaming Multiprocessors (SMs) అనే హార్డ్వేర్ యూనిట్లు ఉంటాయి, అవి వనరుల పరిమితులకు లోబడి blocksను షెడ్యూల్ చేసి అమలు చేస్తాయి.
ఒక block లోపల, threadలను warps అనే అమలు యూనిట్లుగా సమూహపరుస్తారు. సంప్రదాయ CUDA warpలో 32 threadలు ఉంటాయి, అయితే ఖచ్చితమైన షెడ్యూలింగ్, అమలు ప్రవర్తన ఆర్కిటెక్చర్పై ఆధారపడి ఉంటుంది. వేలాది threadలు ఉన్న grid అంటే ప్రతి threadకు ప్రత్యేక భౌతిక ప్రాసెసర్ వస్తుందని కాదు, అన్ని threadలు ఒకేసారి అమలవుతాయని కూడా కాదు.
డెవలపర్ సమాంతర పనిని వివరిస్తాడు. ఆ పని అందుబాటులో ఉన్న వనరులను ఎలా వాడుకోవాలో GPU హార్డ్వేర్, అమలు యంత్రాంగం నిర్ణయిస్తాయి. CUDA యొక్క అతి ముఖ్యమైన ఆర్కిటెక్చర్ ఆలోచనల్లో ఈ తేడా ఒకటి.
ప్రాసెసింగ్ శక్తి అంతే మెమరీ కూడా ముఖ్యం
అప్లికేషన్ మెమరీని అసమర్థంగా వాడితే, వేగవంతమైన ప్రాసెసర్ కూడా డేటా కోసం చాలా సమయం వేచి ఉండవచ్చు. అందువల్ల GPUలు త్రూపుట్కు మద్దతిచ్చేలా రూపొందించిన అనేక మెమరీ నిర్మాణాలను అందిస్తాయి.
పెద్ద సిమ్యులేషన్ డేటాసెట్ GPU global memoryలో ఉండవచ్చు. threadలు global memoryని యాక్సెస్ చేయగలవు, కానీ పునరావృతమయ్యే లేదా సరిగా వ్యవస్థీకరించని యాక్సెస్లు ఖరీదైనవి కావచ్చు. ఒక blockలోని threadలు సహకరించడానికి, డేటాను తిరిగి వాడుకోవడానికి shared memoryని ఉపయోగించవచ్చు. ప్రతి thread హార్డ్వేర్ పరిమితులకు లోబడి పని విలువల కోసం registersను ఉపయోగించవచ్చు.
ప్రతి మెమరీ రకాన్ని గుర్తుపెట్టుకోవడం ముఖ్యం కాదు. పనితీరు గణనపై మరియు డేటా యాక్సెస్పై ఆధారపడి ఉంటుందన్నదే ముఖ్యం.
పక్కపక్క ప్రాంతాలకు అవే ఉష్ణోగ్రతలు మళ్లీ మళ్లీ అవసరమైతే, అసమర్థ అమలు అదే విలువలను అనవసరంగా చాలాసార్లు లోడ్ చేయవచ్చు. మెరుగైన అమలు యాక్సెస్లను వ్యవస్థీకరించవచ్చు లేదా shared డేటాను తిరిగి వాడవచ్చు. GPUకి అపారమైన అంకగణిత సామర్థ్యం ఉన్నా, సాఫ్ట్వేర్ డేటాను సమర్థంగా అందించలేకపోతే నిరాశాజనక పనితీరే రావచ్చు.
CUDA సాఫ్ట్వేర్ ఎకోసిస్టమ్గా ఎలా మారింది
చాలా మంది ఇంజనీర్లు ప్రతి గణిత ఆపరేషన్ను మొదటి నుంచి అమలు చేయాలనుకోరు. సిమ్యులేషన్ అనేక అప్లికేషన్లకు సాధారణమైన మ్యాట్రిక్స్ ఆపరేషన్లను, సంఖ్యాత్మక పరివర్తనలను ఉపయోగించవచ్చు. ప్రతిదాన్ని స్వతంత్రంగా అభివృద్ధి చేయడం, ట్యూన్ చేయడం ఖరీదైనది.
CUDA ఎకోసిస్టమ్ మళ్లీ వాడగల లైబ్రరీలను, టూల్స్ను అందిస్తుంది. cuBLAS లీనియర్-ఆల్జీబ్రా ఆపరేషన్లను అమలు చేస్తుంది, cuFFT ఫాస్ట్ ఫోరియర్ ట్రాన్స్ఫామ్లకు మద్దతిస్తుంది. CUDA Toolkitలో ప్రోగ్రామింగ్ ఇంటర్ఫేస్లు, కంపైలర్లు, డెవలపర్ టూల్స్ ఉంటాయి, వాటిలో CUDA C++ కోసం nvcc కంపైలర్ కూడా ఉంది.
runtime API సాధారణ అమలు యంత్రాంగాలను అప్లికేషన్లకు సౌకర్యవంతంగా అందిస్తుంది. driver API వనరులు, అమలుపై మరింత తక్కువ స్థాయి నియంత్రణను ఇస్తుంది. ప్రొఫైలర్లు, డీబగ్గర్లు ఇంజనీర్లకు సమస్యలను, పనితీరును పరిశీలించడంలో సహాయపడతాయి. NVIDIA డ్రైవర్ అనుకూలమైన హార్డ్వేర్తో పరస్పర చర్యకు మద్దతిస్తుంది.
ఈ చిత్రానికి అందుబాటు టెక్స్ట్ ప్రత్యామ్నాయం
నాలుగు సమాంతర CUDA ఎకోసిస్టమ్ భాగాలు NVIDIA డ్రైవర్, GPU హార్డ్వేర్తో సంభావితంగా అనుసంధానమవుతాయి, టూల్స్ పక్కన ఉంటాయి.
చిత్రంలో చూపిన టెక్స్ట్: 5. CUDA ఒక సాఫ్ట్వేర్ ఎకోసిస్టమ్ | భాగాలు సామర్థ్యాలు, మార్గాలు. ఒకే తప్పనిసరి వరుస కాదు. | అప్లికేషన్లు · CUDA C++ ప్రోగ్రామ్లు · GPU-వేగవంత లైబ్రరీలు | కంపైలర్ / nvcc | CUDA kernelలను నిర్మించు | Runtime API | సాధారణ అమలు ఇంటర్ఫేస్ | Driver API | తక్కువ స్థాయి వనరుల నియంత్రణ | CUDA లైబ్రరీలు | cuBLAS · cuFFT · ఇతర లైబ్రరీలు | NVIDIA డ్రైవర్, మద్దతు ఉన్న GPU హార్డ్వేర్ | ప్రొఫైలర్లు, డీబగ్గర్లు ఈ భాగాల అమలును గమనిస్తాయి.
అప్లికేషన్ ప్రత్యేక kernelను కంపైల్ చేయకుండానే ముందే నిర్మించిన GPU లైబ్రరీని పిలవవచ్చు. ఉన్నత స్థాయి ఫ్రేమ్వర్క్ అంతర్లీన మెమరీ, అమలు నిర్వహణలో చాలా భాగాన్ని దాచవచ్చు. డెవలపర్ కంప్యూటర్లను, క్లౌడ్ GPU వాతావరణాలను కాన్ఫిగర్ చేసేటప్పుడు ఈ తేడాలు ముఖ్యం: అనుకూలమైన డ్రైవర్, ఫ్రేమ్వర్క్ బిల్డ్ ఉండటం అంటే ప్రతి అప్లికేషన్ డెవలపర్ పూర్తి toolkitను ఇన్స్టాల్ చేసి వాడాల్సిన అవసరం ఉందని కాదు.
ఒక యాక్సిలరేటర్ విలువ హార్డ్వేర్ పనితీరుపైనే కాక, దాన్ని ఉపయోగించడానికి అందుబాటులో ఉన్న సాఫ్ట్వేర్పై కూడా ఆధారపడి ఉంటుంది. లైబ్రరీలు, ఫ్రేమ్వర్క్లు, కంపైలర్లు, ట్రబుల్షూటింగ్ టూల్స్ లేదా అనుకూలమైన అప్లికేషన్లు లేనప్పుడు, ఆకట్టుకునే హార్డ్వేర్ స్పెసిఫికేషన్లు ఆచరణలో తక్కువ విలువనే ఇస్తాయి.
ఆధునిక AI డెవలపర్లకు కనిపించకుండానే CUDAను ఎలా ఉపయోగిస్తుంది
ఒక AI ఇంజనీర్ సాధారణంగా చేతితో రాసిన GPU kernelలతో కాకుండా ఫ్రేమ్వర్క్తో మొదలుపెడతారు. PyTorchలో డెవలపర్ మోడల్ లేయర్లను నిర్వచిస్తారు, డేటాను సిద్ధం చేస్తారు, బహుమితీయ సంఖ్యాత్మక నిర్మాణాలైన tensors మీద ఆపరేట్ చేస్తారు.
న్యూరల్ నెట్వర్క్లు tensorsకు మ్యాట్రిక్స్ గుణకారం వంటి పరివర్తనలను మళ్లీ మళ్లీ వర్తింపజేస్తాయి. ఈ ఆపరేషన్లలో చాలా వాటికి GPU సమాంతరత వల్ల ప్రయోజనం కలగవచ్చు. NVIDIA GPUపై PyTorch మద్దతు ఉన్న ఆపరేషన్ను చేసినప్పుడు, దాని CUDA-ఎనేబుల్డ్ బ్యాకెండ్ తగిన kernelల ద్వారా, వేగవంతం చేసిన లైబ్రరీల ద్వారా పనిని పంపిస్తుంది.
ఈ చిత్రానికి అందుబాటు టెక్స్ట్ ప్రత్యామ్నాయం
PyTorch అప్లికేషన్ నుంచి CUDA బ్యాకెండ్, kernelలు, లైబ్రరీలు, NVIDIA GPU వరకు. ఆపరేషన్-నిర్దిష్ట హెచ్చరిక కూడా ఉంది.
చిత్రంలో చూపిన టెక్స్ట్: 6. AI ఫ్రేమ్వర్క్ కింద CUDA | PyTorch డెవలపర్ సొంత CUDA kernelలు రాయకుండానే NVIDIA GPU గణనను వాడవచ్చు. | Python మోడల్ / PyTorch | Tensors, ఆపరేషన్లు | CUDA-ఎనేబుల్డ్ PyTorch బ్యాకెండ్ | మద్దతు ఉన్న device ఆపరేషన్లను పంపుతుంది | Kernelలు, ఆప్టిమైజ్ చేసిన లైబ్రరీలు | అమలు ఆపరేషన్ను బట్టి మారుతుంది | NVIDIA GPU + డ్రైవర్ | మద్దతు ఉన్న GPU పనిని అమలు చేయి | ప్రతి ఆపరేషన్ ఒకే kernel/లైబ్రరీ మార్గం లేదా GPU మద్దతు కలిగి ఉండదు.
ఇది ఒకే స్థిరమైన అమలు మార్గం కాదు. వేర్వేరు PyTorch ఆపరేషన్లు వేర్వేరు kernelలను, లైబ్రరీలను లేదా కంపైల్ చేసిన అమలులను ఉపయోగించవచ్చు. కొన్ని ఆపరేషన్లు CPUపై నడవవచ్చు. device ఎంపిక, మద్దతు ఉన్న సాఫ్ట్వేర్, ఫ్రేమ్వర్క్ ప్రవర్తన ఏమి జరుగుతుందో నిర్ణయిస్తాయి.
ఉద్దేశపూర్వకంగా చిన్నదైన ఒక Python ఉదాహరణను పరిగణించండి:
import torch

device = "cuda" if torch.cuda.is_available() else "cpu"

a = torch.tensor([1.0, 2.0, 3.0], device=device)
b = torch.tensor([4.0, 5.0, 6.0], device=device)

result = a + b
print(result.cpu())
PyTorch CUDAను ఉపయోగించగలిగితే, tensors, కూడిక ఎంచుకున్న CUDA device మీద నడుస్తాయి. లేకపోతే ఉదాహరణ CPUను ఉపయోగిస్తుంది. ఇది device ఎంపికను చూపిస్తుంది, వేగ ప్రయోజనాన్ని కాదు. డెవలపర్ ప్రత్యేక CUDA kernelను రాయలేదు. సంబంధిత అమలును ఫ్రేమ్వర్క్ అందిస్తుంది.
PyTorch ఇప్పటికే చూసుకుంటుంటే CUDAను ఎందుకు అర్థం చేసుకోవాలి?
అబ్స్ట్రాక్షన్ GPU కంప్యూటింగ్ను మరింత అందుబాటులోకి తెస్తుంది, కానీ ఆర్కిటెక్చర్ ఆధారపడటాలను తొలగించదు.
ఒక AI మోడల్ వర్క్స్టేషన్లో నడుస్తూ, క్లౌడ్ GPU సర్వర్లో విఫలమవుతుందని ఊహించండి. Python మోడల్ సరైనదే కావచ్చు, కానీ డిప్లాయ్ చేసిన వాతావరణంలో అనుకూలమైన డ్రైవర్, ఫ్రేమ్వర్క్ బిల్డ్ లేదా మద్దతు ఉన్న GPU ఆర్కిటెక్చర్ లేకపోవచ్చు. లేదా మోడల్ సరిగా నడిచినా, అధిక CPU నుంచి GPU బదిలీలు, చిన్న ఆపరేషన్లు లేదా అనవసరమైన సింక్రనైజేషన్ వల్ల పనితీరు తక్కువగా ఉండవచ్చు.
ఈ సమస్యలన్నింటికీ CUDA C++ రాయాల్సి వస్తుందని తప్పనిసరిగా చెప్పలేం. కానీ తప్పు మోడల్ కోడ్లో ఉందా, ఫ్రేమ్వర్క్ device ప్రవర్తనలో ఉందా, ఇన్స్టాల్ చేసిన సాఫ్ట్వేర్లో ఉందా, డేటా కదలికలో ఉందా అని గుర్తించడానికి తగినంత అవగాహన అవసరం.
క్లౌడ్ ఇంజనీర్లకు, AI ప్లాట్ఫామ్ బృందాలకు, ప్రొడక్షన్ అప్లికేషన్ డెవలపర్లకు, వెంటనే తక్కువ స్థాయి kernel ప్రోగ్రామింగ్ చేయడం కంటే ఈ ఆర్కిటెక్చర్ అవగాహన ఎక్కువ ఉపయోగకరం కావచ్చు.
CUDA సాఫ్ట్వేర్ను ఆటోమేటిక్గా ఎందుకు వేగవంతం చేయదు
సిమ్యులేషన్ యొక్క రెండు వెర్షన్లను పరిగణించండి. మొదటిది మిలియన్ల కొద్దీ ప్రాంతాలను మళ్లీ మళ్లీ ప్రాసెస్ చేస్తుంది, సమాంతర సంఖ్యాత్మక ఆపరేషన్లపై గణనీయమైన సమయం గడుపుతుంది. తగిన అల్గారిథమ్తో, GPU యాక్సిలరేషన్ వల్ల అది చాలా ప్రయోజనం పొందవచ్చు.
రెండవది కేవలం కొన్ని వందల లెక్కలు చేసి, వెంటనే CPUపై ఫలితాలు కోరుతుంది. డేటా బదిలీలు, పని సమర్పణ, సింక్రనైజేషన్ గణన కంటే ఎక్కువ ఖర్చు కావచ్చు. పెద్ద వర్క్లోడ్ కూడా వరుస ఆధారపడటాలు, అసమతుల్య పని లేదా అసమర్థ మెమరీ యాక్సెస్ వల్ల తక్కువ పనితీరు చూపవచ్చు.
సరైన పోలిక ఎండ్-టు-ఎండ్ వర్క్లోడ్ను కొలుస్తుంది: ఇన్పుట్ సిద్ధం చేయడం, డేటా ఉంచడం, గణన, సింక్రనైజేషన్, అవుట్పుట్, నిర్వహణ ఖర్చు. ఇది ఉద్దేశపూర్వకంగా బలహీనపరిచిన బేస్లైన్తో కాకుండా, బలమైన, ఆచరణాత్మక CPU అమలుతో పోలుస్తుంది.
ఉద్దేశం GPU వినియోగాన్ని గరిష్ఠం చేయడం కాదు. నిజమైన గణన ఫలితాన్ని మెరుగుపరచడమే.
AI కంప్యూటింగ్ పూర్తిగా NVIDIA CUDAపైనే ఆధారపడి ఉందా?
కాదు. అనేక NVIDIA GPU వర్క్లోడ్లకు CUDA కేంద్రమైనది, కానీ యాక్సిలరేటెడ్ కంప్యూటింగ్ CUDA కంటే విస్తృతమైనది. AMD ROCm సాఫ్ట్వేర్ ఎకోసిస్టమ్ను అభివృద్ధి చేస్తుంది, SYCL, ఇతర విధానాలు హెటెరోజీనియస్, యాక్సిలరేటర్ ప్రోగ్రామింగ్ యొక్క అదనపు నమూనాలకు మద్దతిస్తాయి. AI అప్లికేషన్లు CPUలపై, ఇతర యాక్సిలరేటర్లపై కూడా నడవగలవు.
ఈ ప్రత్యామ్నాయాలు ఒక ఆచరణాత్మక ఆర్కిటెక్చర్ ప్రశ్నను తెస్తాయి. ఉన్నత స్థాయి ఫ్రేమ్వర్క్ వివిధ deviceలలో ఒకేలాంటి APIలను అందించవచ్చు, అయినా లైబ్రరీలు, అనుకూలత, మద్దతు ఉన్న ఆపరేషన్లు, పనితీరు, డిప్లాయ్మెంట్ ప్రవర్తన భిన్నంగా ఉండవచ్చు. అప్లికేషన్ సోర్స్ పోర్టబిలిటీ అంటే సమానమైన పనితీరు లేదా కార్యాచరణ సరళత హామీ అని కాదు.
ప్రొడక్షన్ AI వ్యవస్థకు హార్డ్వేర్ను ఎంచుకునేటప్పుడు, బృందం అసలు వర్క్లోడ్ను, మద్దతు ఉన్న ఫ్రేమ్వర్క్, లైబ్రరీలను, లభ్యతను, ధరను, నైపుణ్యాలను, దీర్ఘకాల నిర్వహణను మూల్యాంకనం చేయాలి. CUDA సాఫ్ట్వేర్ పరిపక్వత సంబంధిత సాక్ష్యం, NVIDIA హార్డ్వేర్నే ఎంచుకోవాలనే సార్వత్రిక ఆదేశం కాదు.
CUDAను ఎవరు నేర్చుకోవాలి?
AI నేర్చుకుంటున్న విద్యార్థి ప్రోగ్రామింగ్, Python, డేటా నిర్వహణ, గణితం, సంబంధిత మెషిన్-లెర్నింగ్ ఫ్రేమ్వర్క్తో మొదలుపెట్టాలి. GPU, CUDA ఏమి చేస్తాయో అర్థం చేసుకోవడం ఉపయోగకరం, కానీ CUDA C++ ఆప్టిమైజేషన్ సాధారణంగా మొదటి ప్రాధాన్యం కాదు.
అప్లికేషన్ డెవలపర్ device ఎంపికను, డిప్లాయ్మెంట్ ఆధారపడటాలను అర్థం చేసుకోవాలి. క్లౌడ్ ఇంజనీర్ అనుకూలమైన డ్రైవర్లు, ఫ్రేమ్వర్క్లు, GPU వనరులు ఎలా కలిసి సరిపోతాయో తెలుసుకోవాలి. ML పనితీరు ఇంజనీర్ kernelలు, మెమరీ, సింక్రనైజేషన్, ప్రొఫైలింగ్ను పరిశోధించాల్సి రావచ్చు. సైంటిఫిక్-కంప్యూటింగ్, GPU నిపుణులు CUDA kernelలను నేరుగా రూపొందించి, ట్యూన్ చేయాల్సి రావచ్చు.
TechiesJournal యొక్క Know → Use → Master భేదం తగిన లోతును నిర్వచించడంలో సహాయపడుతుంది:
- Know: CPU vs GPU, host vs device, kernelలు, AI ఫ్రేమ్వర్క్ల కింద CUDA స్థానాన్ని వివరించగలగడం.
- Use: CUDA-ఎనేబుల్డ్ వాతావరణాలను కాన్ఫిగర్ చేసి, ట్రబుల్షూట్ చేయడం, ప్రాథమిక మెమరీ లేదా అమలు సమస్యలను పరిశోధించడం.
- Master: GPU kernelలను అభివృద్ధి చేసి, ఆప్టిమైజ్ చేయడం, హార్డ్వేర్ వనరుల గురించి తర్కించడం, వివరణాత్మక పనితీరు ట్రేడ్-ఆఫ్లను నిర్ణయించడం.
ప్రతి ఒక్కరికీ చివరి దశ అవసరం లేదు. చాలా మంది నిపుణులు తక్కువ స్థాయి CUDA సింటాక్స్ గుర్తుపెట్టుకోవడం కంటే ఖచ్చితమైన ఆర్కిటెక్చర్ అవగాహన వల్లే వెంటనే ఎక్కువ లాభం పొందుతారు.
CUDA ఆధునిక కంప్యూటింగ్ గురించి ఇంకేదో పెద్ద విషయాన్ని వెల్లడిస్తుంది
ఇంజనీరింగ్ సిమ్యులేషన్కు తిరిగి వద్దాం. అసలు సమస్య గణన శక్తి కొరతలా కనిపించింది. కానీ GPU ఒక్కటే దాన్ని పరిష్కరించలేదు. సమాంతర పనిని వివరించడానికి, మెమరీని నిర్వహించడానికి, అమలును సమన్వయం చేయడానికి, ఆప్టిమైజ్ చేసిన గణిత ఆపరేషన్లను వాడటానికి, ఫలితాలను ధ్రువీకరించడానికి అప్లికేషన్కు ఒక మార్గం కావాలి.
AIలో కూడా ఇదే సంబంధం కనిపిస్తుంది. తెలిసిన Python ఇంటర్ఫేస్ల కింద అనేక సాఫ్ట్వేర్, హార్డ్వేర్ పొరలు కలిసి పనిచేయడం వల్లే డెవలపర్ వాటితో మోడల్ను ట్రైన్ చేయగలుగుతాడు.
ఆ సరళత వల్ల దిగువ పొరలు అప్రస్తుతం కావు. సమర్థమైన హార్డ్వేర్ మీద నిర్మించిన అబ్స్ట్రాక్షన్ల విలువను అది చూపిస్తుంది.
CUDA ముఖ్యం ఎందుకంటే, యాక్సిలరేటెడ్ హార్డ్వేర్ను సాఫ్ట్వేర్ సమర్థంగా ఉపయోగించుకునేలా చేసే ప్రోగ్రామింగ్ మోడల్లు, ఇంటర్ఫేస్లు, లైబ్రరీలు, టూల్స్ ద్వారానే ఆ హార్డ్వేర్ నిజంగా ఉపయోగకరమవుతుంది.
చాలా మంది పాఠకులకు ఆ సంబంధాలను అర్థం చేసుకోవడమే సరైన ఆరంభం. లోతైన ప్రోగ్రామింగ్ వివరాలు వారి పనికి నిజంగా అవసరమైనప్పుడు అనుసరించాలి.
సూచనలు, మరింత చదవడానికి
- NVIDIA CUDA Programming Guide: host/device మోడల్, kernelలు, grids, మెమరీ, అమలు.
- NVIDIA CUDA Toolkit Documentation: APIలు, toolkit భాగాలు, మద్దతు ఉన్న టూల్స్, లైబ్రరీలు.
- NVIDIA CUDA C++ Best Practices Guide: మెమరీ కదలిక, పనితీరు కొలత, ఆప్టిమైజేషన్.
- PyTorch CUDA Semantics: devices, tensors, ఆపరేషన్లు, సింక్రనైజేషన్.
- AMD ROCm Documentation: పోలిక కోసం ప్రత్యామ్నాయ GPU కంప్యూటింగ్ ఎకోసిస్టమ్.
- Khronos SYCL: క్రాస్-ప్లాట్ఫామ్ హెటెరోజీనియస్ ప్రోగ్రామింగ్ ప్రమాణం.
సాంకేతిక సమీక్ష తేదీ: నవంబర్ 17, 2026. ప్రచురణ సమయంలో సోర్స్ URLలను, సాఫ్ట్వేర్ సామర్థ్యాలను, విడుదల-నిర్దిష్ట ప్రకటనలను మళ్లీ ధృవీకరించండి.