

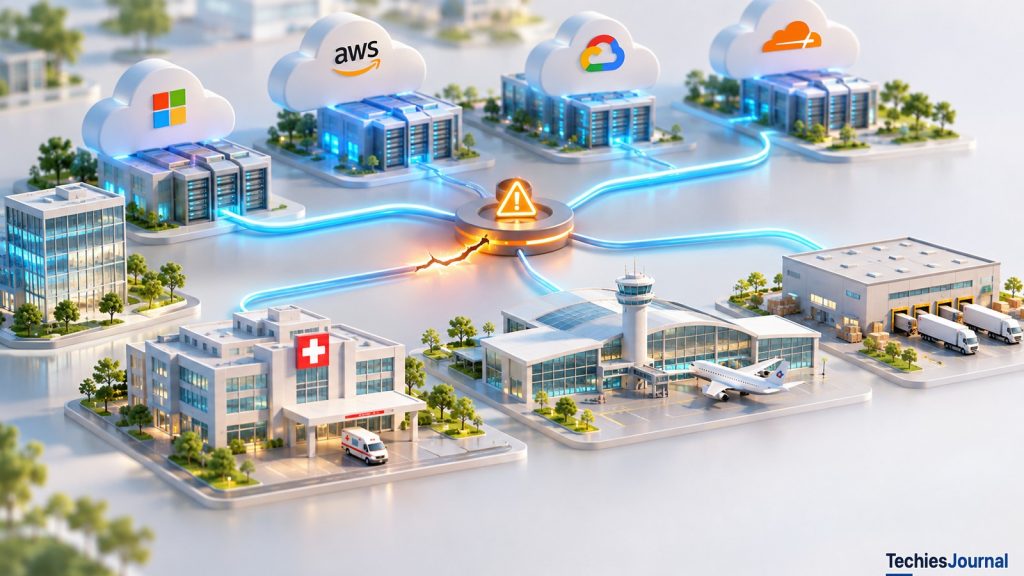
Lo que cinco años de grandes interrupciones tecnológicas revelan sobre las dependencias compartidas, el impacto en el negocio y las decisiones de resiliencia.
Un negocio puede sufrir una interrupción aunque sus propios sistemas estén sanos
Una organización tiene dos conexiones de red, servidores en clúster, bases de datos replicadas, copias de seguridad y un sitio de recuperación ante desastres. Sus ingenieros han dedicado años a eliminar los puntos de falla internos conocidos. Entonces los empleados pierden el acceso a un servicio externo esencial. El equipo de la organización funciona, pero un proceso de negocio importante no puede continuar con normalidad.
Esto no demuestra que la computación en la nube haya debilitado la fiabilidad. En muchos casos, las plataformas en la nube ofrecen más disponibilidad, seguridad y capacidad operativa de las que una organización podría construir por sí misma de forma económica. Pero trasladar los sistemas a un proveedor externo cambia qué fallas puede evitar una empresa, de cuáles puede recuperarse directamente y cuáles debe soportar mientras otra parte restablece el servicio.
La distinción importa porque un proceso de negocio rara vez depende de una sola aplicación. Un pedido de un cliente puede necesitar un servicio de identidad, un intermediario de pagos, una plataforma de seguridad de red y un sistema de datos. Cualquiera de ellos puede convertirse en una restricción aunque el resto esté operativo.
La pregunta no es si las empresas deben evitar a los proveedores de nube y de software como servicio. Es si sus planes de continuidad tienen en cuenta toda la cadena de tecnología y de organizaciones necesaria para prestar los servicios esenciales.
Cinco años de interrupciones significativas
Los incidentes siguientes se seleccionaron por sus consecuencias documentadas y sus distintos mecanismos de falla. Es un registro ilustrativo, no un censo de las interrupciones en todo el mundo. Las duraciones y los impactos se refieren a medidas diferentes y no deben compararse como si fueran la misma estadística.
| Fecha | Incidente | Impacto operativo o financiero documentado | Lo que ilustra el caso |
|---|---|---|---|
| abril de 2022 | Atlassian Cloud | 883 sitios de 775 clientes eliminados, con restauraciones que se prolongaron hasta 14 días en algunos casos | La recuperación a escala puede diferir de la conmutación por error (failover) habitual Revisión de Atlassian |
| febrero de 2024 | Change Healthcare | UnitedHealth informó de 2.2 mil millones de dólares en costos directos de respuesta de 2024 y de 867 millones de dólares en impactos de interrupción del negocio en Optum Insight | Los intermediarios críticos de transacciones conectan muchas organizaciones que de otro modo serían independientes UnitedHealth 2024 Form 10-K |
| julio de 2024 | Actualización de software de CrowdStrike | Delta informó de unos 7000 vuelos cancelados, un impacto de 380 millones de dólares en ingresos y 170 millones de dólares en gastos adicionales | Los componentes de software comunes pueden provocar una recuperación operativa prolongada Delta 2024 Form 10-K |
| junio de 2025 | Google Cloud | Interrupción amplia del servicio originada en una infraestructura compartida de administración de API | Las dependencias globales de políticas y de control pueden afectar a muchos servicios Informe de incidente de Google Cloud |
| junio de 2025 | Cloudflare | Cloudflare informa de 2 horas y 28 minutos de interrupción que afectó a varios productos | Una plataforma puede depender del servicio de almacenamiento de otro proveedor Análisis posterior de Cloudflare de junio de 2025 |
| octubre de 2025 | AWS us-east-1 | Los problemas de DNS relacionados con DynamoDB fueron seguidos por dificultades de recuperación de EC2 y de los balanceadores de carga | Resolver la falla inicial no restablece de inmediato todos los servicios dependientes Informe de incidente de AWS |
| noviembre de 2025 | Cloudflare | Interrupción generalizada causada por datos de configuración propagados | Las rutas de configuración comunes pueden crear una exposición compartida Análisis posterior de Cloudflare de noviembre de 2025 |
| febrero de 2026 | Google Vertex AI Gemini API | Aumento de errores de la API durante aproximadamente 1 hora y 58 minutos | Las aplicaciones basadas en IA pueden compartir dependencias convencionales de la plataforma Informe de estado de Google Cloud |
| noviembre de 2026 | Microsoft Exchange Online | La conectividad de los buzones y algunas funciones dependientes de Microsoft 365 se vieron afectadas del 12 al 13 de noviembre. La causa raíz preliminar que dio Microsoft fue una ampliación anterior de la capacidad de red. No se verificaron las pérdidas financieras consolidadas | Las funciones de SaaS pueden compartir servicios subyacentes aunque los nombres de los productos sean distintos Extracto de PennO365 de los informes de incidentes de Microsoft |
La tabla por sí sola no permite afirmar que las interrupciones sean cada vez más frecuentes. De hecho, la investigación de 2025 de Uptime Institute informó de un cuarto año consecutivo de descenso de la frecuencia general de las interrupciones y de su gravedad general informada. También advirtió de que los datos sobre interrupciones deben tratarse con escepticismo por la transparencia limitada y la escasa fiabilidad de los informes. Análisis de Uptime Institute
Una comparación más productiva pregunta cómo pasó una interrupción de un componente técnico a un proceso de negocio y qué recuperación seguía siendo posible para las personas que dependían de él.
La diferencia entre tener copias de seguridad y recuperar el trabajo: Atlassian
En abril de 2022, un script de mantenimiento de Atlassian eliminó sitios completos en la nube en lugar de solo la información de aplicación prevista. La revisión posterior al incidente de Atlassian registra 883 sitios y 775 clientes afectados, con las últimas restauraciones completadas el 18 de abril. Algunos clientes sufrieron una interrupción de hasta 14 días. Revisión de Atlassian
Atlassian contaba con mecanismos de recuperación, pero su proceso de restauración establecido estaba pensado para sitios individuales o grupos pequeños. Reconstruir cientos de sitios en productos conectados exigió procedimientos y automatización adicionales. La revisión de la empresa también describe cómo la eliminación de los registros de los sitios alteró los flujos de contacto y de soporte que se usaban para comunicarse con los clientes.
La distinción importante está entre tres preguntas: ¿puede la infraestructura sobrevivir a la falla de un componente? ¿Están protegidos los datos? ¿Se puede restaurar un servicio de negocio completo a la escala y con la rapidez necesarias? Una respuesta afirmativa a una no garantiza las demás.
Para un cliente, esto sugiere una prueba de continuidad proporcionada. Identifica qué trabajo se detendría si el producto SaaS no estuviera disponible durante un día o una semana. Determina si los documentos esenciales, los datos de contacto, las aprobaciones o las instrucciones de trabajo son accesibles por un método independiente aprobado. Puede que no sea necesaria una plataforma SaaS duplicada completa. Una forma probada de continuar el trabajo más importante puede ser más útil.
El servicio de transacciones compartido: Change Healthcare
El ciberataque de febrero de 2024 contra Change Healthcare interrumpió los servicios de transacciones sanitarias. UnitedHealth aisló los sistemas afectados para contener la amenaza, lo que contribuyó a que se interrumpieran las reclamaciones y los flujos relacionados con pagos de las organizaciones que dependían de la plataforma. Fue un incidente de ciberseguridad, no una interrupción habitual de la infraestructura en la nube. UnitedHealth 2024 Form 10-K
En su informe anual de 2024, UnitedHealth informó de 2.2 mil millones de dólares en costos directos de respuesta y de 867 millones de dólares estimados en impactos de interrupción del negocio en Optum Insight. También informó de que concedió más de 9 mil millones de dólares en préstamos sin intereses a proveedores de atención médica hasta finales de 2024. El informe indica que los 2.2 mil millones de dólares de costos directos de respuesta incluyen los costos asociados con la concesión de esos préstamos. Los préstamos en sí representan apoyo financiero y no deben sumarse a las pérdidas del incidente. Tampoco deben convertirse las categorías financieras del informe en una única estimación de pérdidas para todo el sector. UnitedHealth 2024 Form 10-K
El incidente demuestra cómo un solo intermediario puede ser esencial para las transacciones entre muchas organizaciones por lo demás independientes. Sus propios servidores y redes pueden seguir disponibles y, aun así, las reclamaciones y los pagos pueden interrumpirse porque no se puede completar un paso externo necesario.
La cuestión práctica no es si cada proveedor de atención médica debe mantener su propia red de transacciones. Es si los procesos de negocio críticos se han mapeado a través del intermediario externo, si las soluciones alternativas son viables desde el punto de vista contractual y técnico, y si las medidas de contingencia de flujo de caja o de procesos manuales son adecuadas para una interrupción prolongada.
Cuando los equipos vuelven pero las operaciones no: CrowdStrike y Delta
El 19 de julio de 2024, una actualización defectuosa del contenido de seguridad de CrowdStrike provocó fallas generalizadas en sistemas Windows. El problema de fondo era un componente de software común, no una interrupción universal de una región de la nube. Delta 2024 Form 10-K
Delta Air Lines comunicó aproximadamente 7000 cancelaciones de vuelos en cinco días, un impacto directo estimado de 380 millones de dólares en ingresos y aproximadamente 170 millones de dólares en gastos operativos adicionales. También identificó aproximadamente 50 millones de dólares en gastos de combustible evitados debido a los vuelos cancelados. Son efectos financieros distintos, informados por la empresa, y no un cálculo confirmado de pérdida neta para todo el incidente. Delta 2024 Form 10-K
Una aerolínea debe coordinar aeronaves, tripulaciones, pasajeros, aeropuertos y horarios. Restaurar una computadora no devuelve al instante todos esos elementos a su estado operativo correcto. Los retrasos generan trabajo acumulado (backlog), y el trabajo acumulado genera más trabajo de recuperación.
Esa diferencia se aplica más allá de las aerolíneas. Un sistema de pedidos recuperado puede seguir conteniendo transacciones que necesitan conciliación. Una plataforma de atención al cliente restaurada puede enfrentarse a una cola acumulada. Un sistema hospitalario puede tener que reprogramar la atención. Por eso una empresa debería medir no solo el tiempo hasta que su tecnología vuelve, sino también el tiempo hasta que el negocio puede volver a prestar un servicio aceptable.
Una dependencia detrás del proveedor: Google Cloud y Cloudflare
El 12 de junio de 2025, un cambio en la información de políticas distribuida globalmente interactuó con un defecto de software en la infraestructura de administración de API de Google Cloud. Varios servicios de Google sufrieron interrupciones. El informe de incidente de Google indica que la nueva ruta de código carecía de manejo de errores y de protección mediante feature flags, de modo que unos campos de políticas en blanco que se replicaron globalmente en cuestión de segundos hicieron que el servicio de comprobación de políticas fallara repetidamente en todas las regiones. Un kill switch puso fin al impacto principal en unos 40 minutos, mientras que la recuperación en us-central1 tardó hasta unas 2 horas y 40 minutos. Informe de incidente de Google Cloud
Ese mismo día, Cloudflare informó de dos horas y 28 minutos de impacto en servicios como Workers KV, Access, Gateway, WARP y Turnstile. Su propia cronología se extiende un poco más, unas dos horas y 36 minutos. Cloudflare identificó como desencadenante inmediato la falla de una dependencia externa de almacenamiento que usa Workers KV. Una serie de productos de Cloudflare dependían de ese servicio para la configuración, la autenticación o la entrega de contenido. La empresa informó de que servicios importantes no afectados siguieron operativos, entre ellos el DNS principal y gran parte de la funcionalidad de su CDN. Análisis posterior de Cloudflare de junio de 2025
Aquí un negocio podía depender de Cloudflare mientras que la propia Cloudflare dependía de otro servicio de infraestructura. Puede que el negocio no tenga ninguna relación directa con ese proveedor subyacente. Contar los proveedores directos, o ejecutar aplicaciones en plataformas distintas, no establece necesariamente que las vías de falla sean independientes.
La lección es rastrear las dependencias al nivel que importa para una función de negocio crítica. También es importante no suponer que todas las funciones de un proveedor fallaron. Identificar con precisión qué servicios se vieron afectados forma parte de una evaluación de resiliencia honesta.
Por qué restablecer un componente no completó la recuperación de AWS
En octubre de 2025, un problema de administración de DNS relacionado con Amazon DynamoDB en la región us-east-1 afectó a las conexiones con un endpoint regional. El informe posterior al evento de AWS describe problemas posteriores con el lanzamiento de instancias de EC2, la administración de hosts y las comprobaciones de estado de Network Load Balancer. Informe de incidente de AWS
El problema inicial de DynamoDB se resolvió antes de que se hubieran recuperado todas las operaciones dependientes. Algunas instancias de EC2 existentes siguieron en buen estado, mientras que el lanzamiento de instancias nuevas estaba afectado. Esta distinción cambia lo que los clientes experimentan realmente. Una carga de trabajo que se ejecuta con suficiente capacidad existente puede seguir funcionando, mientras que otra que necesita instancias nuevas, capacidad de reemplazo u operaciones de administración concretas tiene dificultades.
La preocupación de ingeniería pertinente no es simplemente si existen varias zonas de disponibilidad. Es si una acción de recuperación propuesta depende de un servicio compartido que también podría estar afectado. Por ejemplo, un plan de conmutación por error que requiere nueva capacidad debe probarse frente a las restricciones de capacidad y de servicios de control, en lugar de suponer que el aprovisionamiento siempre tiene éxito.
El artículo de TechiesJournal Caídas del plano de control en la nube: por qué tener los servidores en marcha no significa tener un servicio que funcione explica cómo fallan esos servicios de control. Aquí importan solo porque ayudan a explicar la brecha entre que un proveedor recupere su infraestructura y que un cliente restablezca su función de negocio.
Lo que aporta el reciente incidente de Microsoft 365
El 12 de noviembre de 2026, Microsoft informó de problemas de conectividad de los buzones de Exchange Online que podían afectar a Outlook on the web y a varios protocolos de conexión. Las actualizaciones durante el incidente describieron que un gran número de servidores dejó de estar disponible de forma inesperada, lo que trasladó la carga a la infraestructura restante, y que un proceso central de los servidores afectados quedó saturado. Las actualizaciones posteriores describieron una mejora de la estabilidad después de que Microsoft aplicara un parche a un componente de configuración de autenticación y enrutamiento ascendente. Extracto de PennO365 de los informes de incidentes de Microsoft
Para el 14 de noviembre, los registros que Microsoft había enviado al servicio PennO365 de la University of Pennsylvania mostraban ambos incidentes como servicio restablecido. Microsoft dio una causa raíz preliminar: un problema introducido durante una ampliación anterior de la capacidad de red que salió a la luz después de un cambio reciente en la red. Indicó que se trataba de un problema técnico no relacionado con ciberataques ni con IA, y que se publicaría un informe posterior al incidente completo.
Microsoft también informó de efectos en funciones concretas de otros productos de Microsoft 365 que dependían de Exchange Online. Esto no significa que todos los productos conectados o todas las funciones dejaran de estar disponibles.
Límite de la evidencia, revisada el 14 de noviembre de 2026: el campo formal de causa raíz de Microsoft seguía vacío y su informe posterior al incidente completo no se había publicado en los registros revisados, por lo que la causa preliminar puede cambiar. Los dos registros de incidentes también indican horas de finalización distintas. No se verificaron las pérdidas financieras consolidadas del negocio. En consecuencia, este incidente es una ilustración reciente de las dependencias funcionales de SaaS, no una base para afirmar una pérdida financiera ni para atribuir una causa de forma definitiva.
El riesgo está en el proceso de negocio, no solo en la aplicación
En conjunto, estos casos muestran cuatro maneras distintas en que el trabajo esencial puede detenerse. Puede ser difícil restaurar los datos a escala. Un intermediario de transacciones puede dejar de estar disponible. El software compartido puede interrumpir a muchas organizaciones a la vez. Un servicio que parece independiente puede depender de otro proveedor o de un componente de control común.
La unidad de análisis útil es un servicio de negocio importante. Imagina una empresa que acepta un pago en línea. Su tienda puede seguir sana mientras el intermediario de pagos no está disponible. O bien su tienda puede estar fuera de línea mientras un proceso telefónico o manual aprobado conserva una cantidad limitada de negocio esencial. En ambas situaciones, el porcentaje de disponibilidad de una aplicación es, por sí solo, una medida incompleta de la experiencia del cliente.
Alternativa de texto accesible para esta figura
El servicio es una cadena de cinco eslabones: tienda web, servicio de identidad, intermediario de pagos, servicio de seguridad y sistema de datos.
Cuatro eslabones funcionan. El intermediario de pagos está caído.
Sin un plan, el cliente no puede pagar y el servicio se detiene.
Con una alternativa probada, un proceso telefónico o manual aprobado evita el eslabón roto y los pagos esenciales continúan de forma limitada.
Esto no es un descubrimiento nuevo. Las prácticas establecidas de contingencia y de resiliencia operativa ya distinguen la recuperación técnica de la continuación de las funciones de negocio críticas. La guía de planificación de contingencias del NIST y los marcos de resiliencia operativa del sector financiero hacen hincapié en el impacto en el negocio, las dependencias, las prioridades de recuperación y las pruebas. Guía de planificación de contingencias del NIST Guía de resiliencia del Bank of England
El cambio para una empresa moderna consiste en aplicar esas preguntas a los servicios externos y posteriores que no opera directamente.
¿Qué nos dicen realmente las pérdidas?
Delta y UnitedHealth divulgan impactos importantes, pero describen categorías de costos diferentes y entornos de negocio muy distintos. Sumar esas cifras crearía un número impresionante sin una interpretación útil.
Uptime Institute ofrece un contexto más amplio. En su análisis anual de interrupciones de 2025, el 54 % de los encuestados en su encuesta de 2024 afirmó que su interrupción significativa o grave más reciente costó más de 100 000 dólares, y uno de cada cinco (20 %) informó de más de 1 millón de dólares. Son respuestas de una encuesta sobre interrupciones seleccionadas de gran impacto, no la proporción de todas las interrupciones en la nube que superan esos importes. El informe también advierte de que la medición de las interrupciones es incompleta. Análisis de Uptime Institute
La decisión de una empresa debería partir, en cambio, de la consecuencia probable de perder un servicio de negocio durante una hora, un día o varios días. Debería considerar las transacciones interrumpidas, la productividad del personal, el perjuicio a los clientes, las obligaciones regulatorias, el flujo de caja, los gastos de recuperación y el trabajo acumulado tras restablecer el servicio. Cuando la empresa no disponga de estimaciones defendibles, debería presentarlas como escenarios y no como estadísticas de pérdidas publicadas.
¿Qué debería hacer de otra manera una empresa?
Una respuesta sólida no exige duplicar todas las plataformas tecnológicas. Exige ajustar la protección a la interrupción que el negocio no puede tolerar.
Primero, nombra el servicio de negocio esencial, no solo la aplicación. Luego rastrea los sistemas, los proveedores externos, los servicios de identidad, las fuentes de datos y los intermediarios de transacciones necesarios para prestarlo. Registra cuáles de esas dependencias se comparten entre operaciones aparentemente independientes.
Después, define una interrupción aceptable y un nivel mínimo de servicio. Un sitio interno de conocimiento puede tolerar un día de interrupción, mientras que una función de pagos o de comunicación de emergencia no. La respuesta debería reflejar la consecuencia para el negocio, no el prestigio de la tecnología.
Por último, ensaya una falla concreta. ¿Puede el personal acceder a una lista independiente de contactos de emergencia si la plataforma habitual de identidad o de colaboración no está disponible? ¿Se pueden poner en cola y conciliar con seguridad las transacciones entrantes? ¿Se puede recuperar la información crítica sin la interfaz habitual del SaaS? ¿La conmutación por error requiere un servicio de control que también podría estar caído? El ejercicio debería medir la restauración real de la función de negocio, incluidos el trabajo acumulado y el trabajo manual.
Hay contrapartidas. Las plataformas independientes, las múltiples regiones y las arquitecturas multinube pueden reducir ciertas fallas correlacionadas, pero también añaden costo operativo, complejidad de replicación y responsabilidades de seguridad. A veces un proceso de negocio alternativo probado es un control más proporcionado. A veces el costo y las consecuencias justifican una redundancia técnica considerable. La decisión debería seguir el requisito del negocio y una prueba realista.
Un papel limitado para la IA
Las herramientas operativas basadas en IA pueden ayudar con el análisis de logs, la agrupación de alertas y las sugerencias de investigación. Sus capacidades anunciadas no son, por sí mismas, evidencia de que acorten la recuperación durante incidentes graves. Cualquier acción que cambie producción sigue necesitando verificación y autoridad adecuadas.
Los servicios de IA también pueden convertirse en dependencias. Cloudflare informó de que las solicitudes de inferencia de Workers AI fallaron durante su incidente de Workers KV de junio de 2025. Es un ejemplo concreto de una función moderna de IA que depende de la configuración convencional y de la infraestructura de la plataforma. Análisis posterior de Cloudflare de junio de 2025
Por tanto, la IA pertenece a la misma evaluación de dependencias y de continuidad que otros servicios críticos. Puede mejorar la capacidad del equipo para investigar un incidente, pero no elimina la necesidad de comunicaciones independientes, pruebas de recuperación y controles operativos sólidos.
La fiabilidad y la resiliencia deben medirse juntas
Los servicios en la nube han puesto a disposición de más organizaciones capacidades sustanciales de fiabilidad y de recuperación. Los incidentes de esta revisión no demuestran que externalizar la infraestructura haga a un negocio menos fiable, ni establecen que operar con varios proveedores sea siempre mejor.
Sí muestran por qué la disponibilidad de la plataforma y la continuidad del negocio son resultados distintos. Un servicio puede diseñarse con redundancia y aun así sufrir una falla de configuración compartida. Un proveedor puede restablecer sus sistemas técnicos mientras sus clientes siguen recuperando procesos de negocio. Una organización puede evitar la falla original y, aun así, sufrir consecuencias porque un intermediario esencial no está disponible.
Por tanto, un plan de resiliencia útil parte del servicio de negocio que debe continuar, sigue sus dependencias más allá de la propia red de la organización y prueba qué puede funcionar realmente durante una interrupción. Invierte en independencia donde el impacto en el negocio justifica el costo, en lugar de intentar eliminar todas las dependencias.
La tecnología fiable ayuda a mantener un negocio en marcha. La resiliencia empresarial también requiere un plan para cuando esa tecnología no está disponible.
Referencias y lecturas adicionales
- Atlassian: Post-Incident Review on the April 2022 Outage. Número de clientes, mecanismo de eliminación, impacto en el soporte y cronología de recuperación.
- UnitedHealth Group: 2024 Form 10-K. Análisis de los costos del incidente de Change Healthcare y de la interrupción del negocio.
- Delta Air Lines: 2024 Form 10-K. Análisis de los impactos operativos y financieros de julio de 2024.
- Google Cloud: June 12, 2025 Service Disruption Incident Report. Mecanismo y recuperación.
- Cloudflare: Cloudflare Service Outage June 12, 2025. Dependencia de almacenamiento compartida, productos afectados y no afectados.
- AWS: Summary of the Amazon DynamoDB Service Disruption in the Northern Virginia Region, October 2025. Secuencia de los problemas de DynamoDB, EC2 y los balanceadores de carga.
- Cloudflare: November 18, 2025 Outage. Propagación de la configuración y efectos en los servicios.
- Google Cloud: Vertex AI Gemini API Incident, February 27, 2026. Registro oficial de incidentes de Google Cloud.
- Microsoft: Exchange Online incident EX1550543 and Microsoft 365 incident MO1550821, November 12 to 14, 2026. Informes de incidentes de Microsoft copiados en el extracto de incidentes PennO365 de la University of Pennsylvania, que se actualiza cada 15 minutos, por lo que la página cambia a medida que Microsoft actualiza sus informes.
- Uptime Institute: Annual Outage Analysis 2025. Resumen ejecutivo: tendencias de las interrupciones, costos informados y limitaciones de la medición.
- TechiesJournal: Caídas del plano de control en la nube: por qué tener los servidores en marcha no significa tener un servicio que funcione. Cómo fallan los servicios de control de la nube y qué comprobar.
- NIST: SP 800-34 Rev. 1, Contingency Planning Guide for Federal Information Systems. Análisis de impacto en el negocio, interdependencias, prioridades de recuperación y pruebas.
- Bank of England and PRA: SS1/21, Operational resilience: Impact tolerances for important business services. Servicios de negocio importantes, tolerancias de impacto, mapeo y pruebas de escenarios.
Las fuentes se leyeron el 14 de noviembre de 2026. El incidente de Microsoft seguía en revisión y los detalles de los incidentes pueden cambiar.