

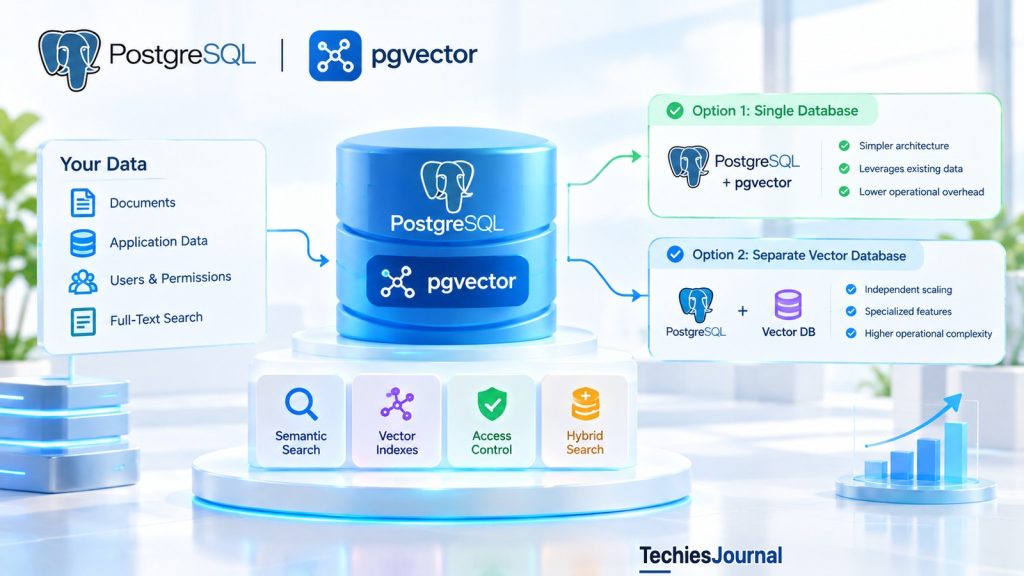
ఒక AI అప్లికేషన్ తన బిజినెస్ రికార్డులు, ఎంబెడ్డింగ్లు (embeddings), సెర్చ్ చేయదగిన డాక్యుమెంట్లను PostgreSQLలోనే ఉంచుకోవచ్చు, లేదా ఒక ప్రత్యేక వెక్టర్ సిస్టమ్ను ప్రవేశపెట్టవచ్చు. సరైన నిర్ణయం రిట్రీవల్ నాణ్యత, యాక్సెస్ నియంత్రణలు, స్కేలింగ్ అవసరాలు, అనేక డేటా స్టోర్లను సింక్రొనైజ్డ్గా ఉంచడానికి అయ్యే ఖర్చుపై ఆధారపడి ఉంటుంది.
AI నాలెడ్జ్ అసిస్టెంట్ను నిర్మిస్తున్న ఒక సంస్థ తన డాక్యుమెంట్లు, యూజర్లు, అనుమతులను ఇప్పటికే PostgreSQLలో నిల్వ చేసి ఉండవచ్చు. ఆ డాక్యుమెంట్లను అర్థం ఆధారంగా సెర్చ్ చేయగలిగేలా చేయడానికి, అప్లికేషన్కు ఎంబెడ్డింగ్లు అవసరం. ఇవి కంటెంట్కు సంఖ్యాత్మక రూపాలు (numerical representations), వీటి ద్వారా సాఫ్ట్వేర్ అర్థపరంగా సంబంధిత భాగాలను (passages) కనుగొనగలుగుతుంది.
ఒక ఎంపిక, pgvector ఎక్స్టెన్షన్ను ఉపయోగించి ఎంబెడ్డింగ్లను అప్లికేషన్ డేటాతో పాటే నిల్వ చేయడం. మరొకటి, ఒక ప్రత్యేక వెక్టర్-సెర్చ్ సిస్టమ్ను నిర్వహించడం. రెండు ఆర్కిటెక్చర్లూ రిట్రీవల్-ఆగ్మెంటెడ్ జనరేషన్కు (retrieval-augmented generation, RAG) సపోర్ట్ ఇవ్వగలవు.
ఒక ప్రత్యేక డేటాబేస్ కొలవగలిగే ఒక సమస్యను పరిష్కరిస్తుందా, లేక అప్లికేషన్కు ఇంకా అవసరం లేని సంక్లిష్టతను తీసుకొస్తుందా అన్నదే ప్రశ్న.
pgvector PostgreSQLకు ఏం జోడిస్తుంది
PostgreSQL ఇప్పటికే రిలేషనల్ స్టోరేజ్, ట్రాన్సాక్షన్లు, జాయిన్లు, ఇండెక్సింగ్, ఫుల్-టెక్స్ట్ సెర్చ్ను (full-text search) అందిస్తుంది. pgvector వెక్టర్ డేటా టైప్లు, సిమిలారిటీ ఆపరేటర్లు, అప్రాక్సిమేట్ నియరెస్ట్-నైబర్ ఇండెక్స్లను (approximate nearest-neighbor indexes) జోడిస్తుంది. ఇవి ప్రతి వెక్టర్ను తనిఖీ చేయకుండానే దగ్గరి సరిపోలికలను వేగంగా కనుగొంటాయి.
ఒక అప్లికేషన్ డాక్యుమెంట్ భాగాలను (chunks), వాటి ఎంబెడ్డింగ్లను, సంబంధిత మెటాడేటాను PostgreSQLలో నిల్వ చేయగలదు. ఒక యూజర్ ప్రశ్న అడిగినప్పుడు, అప్లికేషన్ ఆ ప్రశ్నకు ఒక ఎంబెడ్డింగ్ను సృష్టించి, సారూప్యమైన డాక్యుమెంట్ ఎంబెడ్డింగ్ల కోసం సెర్చ్ చేస్తుంది. తిరిగి పొందిన భాగాలు ఆ తర్వాత సమాధానాన్ని రూపొందిస్తున్న లాంగ్వేజ్ మోడల్కు సందర్భాన్ని (context) అందించగలవు.
pgvector ఎంబెడ్డింగ్లను జనరేట్ చేయదు, మోడల్ రూపొందించిన సమాధానాల సరైనతను అమలు చేయదు, ఒక డాక్యుమెంట్ ఒక నిర్దిష్ట యూజర్ చదవడానికి సురక్షితమా అని తనంతట తానుగా నిర్ణయించదు. అవి అప్లికేషన్, దాని సెక్యూరిటీ ఆర్కిటెక్చర్ బాధ్యతలుగానే ఉంటాయి.
ముఖ్యంగా, pgvector ఒక ఎక్స్టెన్షన్, PostgreSQL 19 ఫీచర్ కాదు. దాని ప్రస్తుత సామర్థ్యాలు సపోర్ట్ ఉన్న PostgreSQL వెర్షన్లన్నింటిలో పనిచేస్తాయి, pgvector README PostgreSQL 13, ఆ తర్వాతి వెర్షన్లకు సపోర్ట్ను పేర్కొంటుంది, కాబట్టి మీ రిలీజ్ ఏ వెర్షన్లకు సపోర్ట్ ఇస్తుందో తనిఖీ చేయండి. PostgreSQLలోనే ఏం మారుతుందో తెలుసుకోవడానికి, PostgreSQL 19, దాని రిలీజ్ క్యాండిడేట్పై మా ఆర్టికల్ చూడండి.
మూలం: pgvector official documentation.
ఒక ఎంటర్ప్రైజ్ RAG అప్లికేషన్ డాక్యుమెంట్లను ఎలా తిరిగి పొందుతుంది
Finance, Human Resources ఉద్యోగులు ఉపయోగించే ఒక ఊహాజనిత అంతర్గత నాలెడ్జ్ అసిస్టెంట్ను పరిగణించండి. సంస్థ డాక్యుమెంట్లను, యాక్సెస్ మెటాడేటాను PostgreSQLలో నిల్వ చేస్తుంది. ప్రతి డాక్యుమెంట్ను సెర్చ్ చేయదగిన భాగాలుగా విభజిస్తారు, ప్రతి భాగానికి ఒక ఎంబెడ్డింగ్ అనుబంధంగా ఉంటుంది.
ఒక సాధారణ రిట్రీవల్ ఆపరేషన్లో అనేక దశలు ఉంటాయి.
1. యూజర్ను ఆథెంటికేట్ చేయడం. అప్లికేషన్ యూజర్ గుర్తింపును, అధీకృత సంస్థాగత సందర్భాన్ని నిర్ధారిస్తుంది.
2. అనుమతించిన డాక్యుమెంట్ పరిధిని నిర్ణయించడం. యూజర్ అందించిన సూచనలపై కాకుండా విశ్వసనీయ ఆథరైజేషన్ డేటాను ఉపయోగించి, యూజర్కు ఏ డాక్యుమెంట్లను యాక్సెస్ చేసే హక్కు ఉందో సర్వర్ గుర్తిస్తుంది.
3. ప్రశ్న ఎంబెడ్డింగ్ను జనరేట్ చేయడం. ఒక ఎంబెడ్డింగ్ మోడల్ యూజర్ ప్రశ్నను, నిల్వ చేసిన భాగాలకు ఉపయోగించిన అదే అనుకూల వెక్టర్ రూపంలోకి మారుస్తుంది.
4. సరిపోలే భాగాలను తిరిగి పొందడం. సరైన డాక్యుమెంట్-యాక్సెస్ షరతులను వర్తింపజేస్తూ PostgreSQL అర్థపరంగా సారూప్యమైన కంటెంట్ కోసం సెర్చ్ చేస్తుంది.
5. యాక్సెస్ సరిహద్దును అమలు చేయడం. అనుమతించిన కంటెంట్ మాత్రమే మోడల్కు చేరగలదని అప్లికేషన్ ధ్రువీకరిస్తుంది. సరిగ్గా కాన్ఫిగర్ చేసిన చోట, డేటాబేస్ వైపు రో-లెవల్ సెక్యూరిటీ మరో అమలు పొరను అందించగలదు.
6. సమాధానాన్ని జనరేట్ చేయడం. లాంగ్వేజ్ మోడల్ అధీకృత భాగాలను సహాయక సందర్భంగా ఉపయోగిస్తుంది. ట్రేసబిలిటీ కోసం అప్లికేషన్ మూల రిఫరెన్స్లను నిలుపుకోగలదు.
ఆథెంటికేషన్
అప్లికేషన్ యూజర్ గుర్తింపును, అధీకృత సంస్థాగత సందర్భాన్ని నిర్ధారిస్తుంది.
అనుమతి పరిధి
యూజర్ అందించిన సూచనలపై కాకుండా విశ్వసనీయ ఆథరైజేషన్ డేటాను ఉపయోగించి, యూజర్కు ఏ డాక్యుమెంట్లను యాక్సెస్ చేసే హక్కు ఉందో సర్వర్ గుర్తిస్తుంది.
ప్రశ్న ఎంబెడ్డింగ్
ఒక ఎంబెడ్డింగ్ మోడల్ యూజర్ ప్రశ్నను, నిల్వ చేసిన భాగాలకు ఉపయోగించిన అదే అనుకూల వెక్టర్ రూపంలోకి మారుస్తుంది.
రిట్రీవ్
సరైన డాక్యుమెంట్-యాక్సెస్ షరతులను వర్తింపజేస్తూ PostgreSQL అర్థపరంగా సారూప్యమైన కంటెంట్ కోసం సెర్చ్ చేస్తుంది.
ఒక Human Resources డాక్యుమెంట్ అర్థపరంగా సారూప్యంగా ఉండవచ్చు, కానీ సారూప్యత ఆ డాక్యుమెంట్ను అధీకృతం చేయదు.
సరిహద్దు అమలు
అనుమతించిన కంటెంట్ మాత్రమే మోడల్కు చేరగలదని అప్లికేషన్ ధ్రువీకరిస్తుంది.
సరిగ్గా కాన్ఫిగర్ చేసిన చోట, డేటాబేస్ వైపు రో-లెవల్ సెక్యూరిటీ మరో అమలు పొరను అందించగలదు.
జనరేట్
లాంగ్వేజ్ మోడల్ అధీకృత భాగాలను సహాయక సందర్భంగా ఉపయోగిస్తుంది.
ట్రేసబిలిటీ కోసం అప్లికేషన్ మూల రిఫరెన్స్లను నిలుపుకోగలదు.
ఒక Finance ఉద్యోగి ఖర్చు-ఆమోద విధానం (expense-approval policy) గురించి అడిగారనుకోండి. ఒక Human Resources డాక్యుమెంట్ అర్థపరంగా సారూప్యంగా ఉండవచ్చు, కానీ సారూప్యత ఆ డాక్యుమెంట్ను అధీకృతం చేయదు. పరిమితం చేసిన సమాచారం మోడల్ సందర్భంలోకి ప్రవేశించకుండా డేటాబేస్ క్వెరీ, దాని చుట్టూ ఉన్న అప్లికేషన్ నియంత్రణలు అడ్డుకోవాలి.
PostgreSQL రో-లెవల్ సెక్యూరిటీ
PostgreSQL రో-లెవల్ సెక్యూరిటీ (row-level security, RLS) ఒక డేటాబేస్ రోల్ ఏ రికార్డులను చదవగలదో లేదా మార్చగలదో పరిమితం చేయగలదు. సాధారణ అప్లికేషన్ ఫిల్టరింగ్తో సంబంధం లేకుండా టెనెంట్ లేదా డాక్యుమెంట్ సరిహద్దులను అమలు చేయడంలో ఇది సహాయపడగలదు.
అయితే, RLSను ఎనేబుల్ చేసినంత మాత్రాన ప్రతి కనెక్షన్ తనంతట తానుగా సురక్షితం కాదు. సూపర్యూజర్లు, BYPASSRLS ఉన్న రోల్స్ పాలసీలను దాటవేస్తాయి. FORCE ROW LEVEL SECURITY కాన్ఫిగర్ చేయకపోతే టేబుల్ ఓనర్లు సాధారణంగా RLSను దాటవేస్తారు. అప్లికేషన్లు ఆథరైజేషన్ సందర్భాన్ని కూడా సురక్షితంగా ఏర్పాటు చేయాలి, ముఖ్యంగా కనెక్షన్లు పూల్ (pool) చేసినప్పుడు లేదా తిరిగి ఉపయోగించినప్పుడు.
అనధికృత డాక్యుమెంట్లను తిరిగి పొందలేమని నిరూపించే నెగటివ్ టెస్ట్లతో సహా, వాస్తవిక యూజర్ రోల్స్తో RLSను పరీక్షించాలి. ఒక సాధారణ WHERE tenant_id = ... క్లాజ్ క్వెరీ ఫిల్టరింగ్కు ఉపయోగపడుతుంది, కానీ పిలిచే అప్లికేషన్ దాన్ని మార్చగలిగినప్పుడు లేదా వదిలేయగలిగినప్పుడు దాన్ని పూర్తి సెక్యూరిటీ సరిహద్దుగా పరిగణించకూడదు.
మూలం: PostgreSQL, Row Security Policies.
ఎగ్జాక్ట్ సెర్చ్, అప్రాక్సిమేట్ ఇండెక్స్లు వేర్వేరు సమస్యలను పరిష్కరిస్తాయి
డిఫాల్ట్గా, pgvector ఎగ్జాక్ట్ నియరెస్ట్-నైబర్ సెర్చ్ (exact nearest-neighbor search) చేస్తుంది. ఇది ఎంచుకున్న దూర కొలమానం (distance measure) ప్రకారం అత్యంత దగ్గరగా సరిపోలే వెక్టర్లను కనుగొంటుంది, అప్రాక్సిమేట్ ఫలితాలను అంచనా వేయడానికి ఉపయోగపడే ఒక బేస్లైన్ను అందిస్తుంది. వెక్టర్ సేకరణలు, అభ్యర్థనల పరిమాణం పెరిగే కొద్దీ, ఎగ్జాక్ట్ సెర్చ్ మరింత ఖరీదైనదిగా మారవచ్చు.
pgvector రెండు ప్రధాన అప్రాక్సిమేట్ ఇండెక్సింగ్ పద్ధతులకు సపోర్ట్ ఇస్తుంది.
| ఇండెక్స్ | ఇది ఎలా పనిచేస్తుంది | ముఖ్యమైన ట్రేడ్-ఆఫ్ |
|---|---|---|
| HNSW | వెక్టర్లను నావిగేట్ చేయదగిన ఒక గ్రాఫ్గా అమరుస్తుంది | అనేక వర్క్లోడ్లకు బలమైన వేగం, రీకాల్ లక్షణాలు, అదనపు బిల్డ్ సమయం, మెమరీ అవసరాలతో |
| IVFFlat | వెక్టర్లను లిస్ట్లుగా సమూహపరిచి, ఎంచుకున్న లిస్ట్లలో సెర్చ్ చేస్తుంది | తగిన ట్రైనింగ్ డేటా, సెర్చ్ విస్తృతిని ట్యూన్ చేయడం అవసరం |
అప్రాక్సిమేట్ ఇండెక్స్లు ఎగ్జాక్ట్ సెర్చ్ కంటే భిన్నమైన ఫలితాలను ఇవ్వవచ్చు. అందుకే లేటెన్సీ ఒక్కటే పనితీరుకు సరిపోని కొలమానం. టీమ్లు రీకాల్ను (recall) కూడా కొలవాలి. ఎగ్జాక్ట్-సెర్చ్ బేస్లైన్తో పోలిస్తే, ఆశించిన నియరెస్ట్-నైబర్ ఫలితాల్లో ఎన్ని తిరిగి వచ్చాయో ఇది సూచిస్తుంది.
ఒక AI అసిస్టెంట్కు, ఒక ముఖ్యమైన డాక్యుమెంట్ నిలకడగా వదిలివేయబడుతుంటే, వేగవంతమైన ఫలితం తక్కువ ఉపయోగకరంగా ఉండవచ్చు.
ఫిల్టరింగ్ రిట్రీవల్ నాణ్యతను ప్రభావితం చేయగలదు
ఎంటర్ప్రైజ్ సెర్చ్లు కేవలం వెక్టర్ సారూప్యతపై ఆధారపడటం అరుదు. ఫలితాలను సంస్థ, డాక్యుమెంట్ రకం, ప్రాజెక్ట్ లేదా యాక్సెస్ పరిధి ఆధారంగా కూడా ఫిల్టర్ చేయవచ్చు. అప్రాక్సిమేట్ ఇండెక్స్లతో, ఇండెక్స్ స్కాన్ అభ్యర్థులను (candidates) ఎంచుకున్న తర్వాత PostgreSQL ఫిల్టరింగ్ను వర్తింపజేయవచ్చు, దీనివల్ల అభ్యర్థించిన దాని కంటే తక్కువ ఫలితాలు రావచ్చు.
ఉదాహరణకు, ఒక సెర్చ్ 40 అభ్యర్థులను పరిశీలించి, వాటిలో 10% మాత్రమే ఒక కేటగిరీ ఫిల్టర్ను సంతృప్తిపరిస్తే, సగటున సుమారు నాలుగు మాత్రమే మిగలవచ్చు. ఇది సెలెక్టివిటీకి (selectivity) ఒక ఉదాహరణ మాత్రమే, ప్రతి సెర్చ్కు హామీ ఇచ్చిన ఫలితం కాదు.
pgvector ఇటరేటివ్ ఇండెక్స్ స్కాన్లను (iterative index scans) వెర్షన్ 0.8.0లో అక్టోబర్ 30, 2024న ప్రవేశపెట్టింది. ఫిల్టరింగ్ చాలా ఎక్కువ ఫలితాలను తొలగించినప్పుడు, కాన్ఫిగర్ చేసిన వనరుల, స్కాన్ పరిమితులకు లోబడి, ఇటరేటివ్ స్కాన్లు మరిన్ని ఇండెక్స్ అభ్యర్థులను పరిశీలించడం కొనసాగించగలవు. క్వెరీ నమూనాలను బట్టి, సాధారణ PostgreSQL ఇండెక్స్లు, పాక్షిక వెక్టర్ ఇండెక్స్లు (partial vector indexes), టేబుల్ పార్టిషనింగ్ ఇతర పద్ధతులు. ఈ విధానాలను కొలతల ద్వారా ఎంచుకోవాలి.
ఒకే అప్రాక్సిమేట్ ఇండెక్స్ను పంచుకునే టెనెంట్లు ఒకరినొకరు ప్రభావితం చేయవచ్చు కూడా. ఒక టెనెంట్ వెక్టర్లు ఇతర టెనెంట్ల రీకాల్ను, వేగాన్ని మార్చగలవని pgvector డాక్యుమెంటేషన్ చెబుతుంది, టెనెంట్ ఐసోలేషన్ కోసం లిస్ట్ పార్టిషనింగ్ లేదా వేర్వేరు టేబుల్లను సిఫార్సు చేస్తుంది.
సరిగ్గా అమలు చేసిన ఆథరైజేషన్ ఫిల్టర్ను, కేవలం సెర్చ్ ఫలితాల సంఖ్యను పెంచడానికి ఎప్పుడూ బలహీనపరచకూడదు. తక్కువ అధీకృత భాగాలను తిరిగి ఇచ్చే రిట్రీవల్ సిస్టమ్ తక్కువ సంపూర్ణమైన సమాధానాన్ని ఇవ్వవచ్చు. అనధికృత భాగాలను తిరిగి ఇవ్వడం వేరే, మరింత తీవ్రమైన వైఫల్యం.
మూలాలు: pgvector changelog, pgvector filtering guidance, pgvector multitenancy.
హైబ్రిడ్ సెర్చ్ వేర్వేరు రకాల ప్రాసంగికతను కలుపుతుంది
ఒక డాక్యుమెంట్లో ఉన్న ఖచ్చితమైన పదాలను ఉపయోగించకుండా యూజర్లు ఒక భావనను వివరించినప్పుడు సెమాంటిక్ సారూప్యత ఉపయోగపడుతుంది. ఐడెంటిఫైయర్లు, ప్రోడక్ట్ పేర్లు, పాలసీ నంబర్లు, సాంకేతిక పదాల కోసం కీవర్డ్ సెర్చ్ ముఖ్యమైనదిగానే ఉంటుంది.
PostgreSQL tsvector, tsquery వంటి సదుపాయాల ద్వారా ఫుల్-టెక్స్ట్ సెర్చ్కు సపోర్ట్ ఇస్తుంది. అప్లికేషన్లు ఆ ఫలితాలను pgvector సిమిలారిటీ సెర్చ్తో కలపగలవు. ఉదాహరణకు, ఒక నిర్దిష్ట ఇన్సిడెంట్ నంబర్ కోసం సెర్చ్ చేస్తున్న నాలెడ్జ్ అసిస్టెంట్కు ఖచ్చితమైన టెక్స్ట్ సరిపోలిక ఉపయోగపడవచ్చు, అయితే విస్తృతమైన ట్రబుల్షూటింగ్ ప్రశ్నకు సెమాంటిక్ రిట్రీవల్ ఉపయోగపడవచ్చు.
ర్యాంక్ చేసిన ఫలితాలను రెసిప్రోకల్ ర్యాంక్ ఫ్యూజన్ (reciprocal rank fusion) వంటి పద్ధతులతో కలపవచ్చు, ఇది రెండు ర్యాంక్ చేసిన లిస్ట్లను స్థానం ఆధారంగా విలీనం చేస్తుంది, ఆ తర్వాత అవసరమైతే మరో ప్రాసంగికత మోడల్తో మళ్లీ ర్యాంక్ (rerank) చేయవచ్చు. అయితే, హైబ్రిడ్ సెర్చ్ ప్రతి అప్లికేషన్లోనూ మెరుగైన రిట్రీవల్కు హామీ ఇవ్వదు. టీమ్లు ప్రాతినిధ్య ప్రశ్నలను, ఆశించిన డాక్యుమెంట్లను, తుది ర్యాంకింగ్ నాణ్యతను అంచనా వేయాలి.
మూలాలు: PostgreSQL full-text search, pgvector hybrid search.
ప్రత్యేక వెక్టర్ డేటాబేస్ ఎప్పుడు ఉపయోగకరంగా మారుతుంది?
ఒక అప్లికేషన్ రిట్రీవల్ అవసరాలు దాని ప్రస్తుత PostgreSQL ఎన్విరాన్మెంట్ సమర్థవంతంగా సపోర్ట్ చేయగల స్థాయిని మించినప్పుడు, ఒక ప్రత్యేక వెక్టర్ సిస్టమ్ విలువైనదిగా మారవచ్చు. వెక్టర్-సెర్చ్ ట్రాఫిక్ను స్వతంత్రంగా స్కేల్ చేయడం, ప్రత్యేకమైన డిస్ట్రిబ్యూటెడ్ ఇండెక్సింగ్, చాలా పెద్ద సెర్చ్ సేకరణలు, లేదా ఎంచుకున్న PostgreSQL డిప్లాయ్మెంట్లో అందుబాటులో లేని రిట్రీవల్ ఫీచర్లు దీనికి ఉదాహరణలు.
కానీ ఎంబెడ్డింగ్లను మరో సిస్టమ్కు తరలించడం అదనపు బాధ్యతలను సృష్టిస్తుంది.
ఒక డాక్యుమెంట్ అప్డేట్ను పరిగణించండి. అప్లికేషన్ PostgreSQLలోని మూల డాక్యుమెంట్ను మారుస్తుంది. ప్రభావితమైన ఎంబెడ్డింగ్లను కూడా అది మళ్లీ జనరేట్ చేసి, వెక్టర్ ఇండెక్స్ను అప్డేట్ చేయాలి. సింక్రొనైజేషన్ పూర్తయ్యే వరకు, సెర్చ్లు పాతబడిన కంటెంట్ను తిరిగి పొందవచ్చు.
డిలీషన్ ఒక సంబంధిత సమస్యను సృష్టిస్తుంది. ట్రాన్సాక్షనల్ డేటాబేస్ నుంచి ఒక డాక్యుమెంట్ను తొలగిస్తే, దాని వెక్టర్ రూపాలను కూడా తొలగించాలి లేదా చెల్లనివిగా చేయాలి.
అనుమతుల మార్పులు ప్రత్యేకంగా ముఖ్యమైనవి. ఒక యూజర్ యాక్సెస్ రద్దు అయితే, మరో సెర్చ్ సిస్టమ్లోని పాతబడిన యాక్సెస్ మెటాడేటా పరిమితం చేసిన కంటెంట్ మోడల్కు చేరడానికి అనుమతించకూడదు.
కాబట్టి రెండు డేటా స్టోర్లు ఉన్న ఆర్కిటెక్చర్కు మార్పులను ప్రచారం చేయడానికి, వైఫల్యాలను నిర్వహించడానికి, సురక్షితంగా మళ్లీ ప్రయత్నించడానికి, సెర్చ్ డేటా ఎప్పుడు తాజాగా ఉందో నిర్ణయించడానికి ఒక విశ్వసనీయ మార్గం అవసరం. డేటాబేస్ నుంచి మార్పులను స్ట్రీమ్ చేసే చేంజ్-డేటా క్యాప్చర్ (change-data capture), మార్పు ఈవెంట్ను డేటా ఉన్న అదే ట్రాన్సాక్షన్లో నమోదు చేసే ట్రాన్సాక్షనల్ అవుట్బాక్స్ (transactional outbox) నమూనాలు, ఈవెంట్ ప్రాసెసింగ్ సహాయపడగలవు, కానీ ప్రతి దానికీ అమలు, ఆపరేషనల్ యాజమాన్యం అవసరం. సెర్చ్ ఇండెక్స్ ఆలస్యమైనప్పుడు కూడా అధికారిక అనుమతి తనిఖీ అమలు చేయదగినదిగానే ఉండాలి.
డాక్యుమెంట్ మారితే
అప్లికేషన్ PostgreSQLలోని మూల డాక్యుమెంట్ను మారుస్తుంది.
ప్రభావితమైన ఎంబెడ్డింగ్లను కూడా అది మళ్లీ జనరేట్ చేసి, వెక్టర్ ఇండెక్స్ను అప్డేట్ చేయాలి.
సింక్రొనైజేషన్ పూర్తయ్యే వరకు, సెర్చ్లు పాతబడిన కంటెంట్ను తిరిగి పొందవచ్చు.
డాక్యుమెంట్ తొలగిస్తే
ట్రాన్సాక్షనల్ డేటాబేస్ నుంచి ఒక డాక్యుమెంట్ను తొలగిస్తే, దాని వెక్టర్ రూపాలను కూడా తొలగించాలి లేదా చెల్లనివిగా చేయాలి.
అనుమతి రద్దయితే
ఒక యూజర్ యాక్సెస్ రద్దు అయితే, మరో సెర్చ్ సిస్టమ్లోని పాతబడిన యాక్సెస్ మెటాడేటా పరిమితం చేసిన కంటెంట్ మోడల్కు చేరడానికి అనుమతించకూడదు.
ఇండెక్స్ ఆలస్యమైతే
కాబట్టి రెండు డేటా స్టోర్లు ఉన్న ఆర్కిటెక్చర్కు మార్పులను ప్రచారం చేయడానికి, వైఫల్యాలను నిర్వహించడానికి, సురక్షితంగా మళ్లీ ప్రయత్నించడానికి, సెర్చ్ డేటా ఎప్పుడు తాజాగా ఉందో నిర్ణయించడానికి ఒక విశ్వసనీయ మార్గం అవసరం.
సెర్చ్ ఇండెక్స్ ఆలస్యమైనప్పుడు కూడా అధికారిక అనుమతి తనిఖీ అమలు చేయదగినదిగానే ఉండాలి.
ఈ సింక్రొనైజేషన్ సరిహద్దులు ఒక ప్రత్యేక వెక్టర్ సిస్టమ్ను స్వీకరించడానికి అయ్యే ఖర్చులో భాగం.
ఎంబెడ్డింగ్ మోడల్లు మరో మైగ్రేషన్ సరిహద్దును తీసుకొస్తాయి
ఒక ఎంబెడ్డింగ్ ఒక నిర్దిష్ట మోడల్, రూపాన్ని ఉపయోగించి జనరేట్ అవుతుంది. ఎంబెడ్డింగ్ మోడల్ను మార్చడం వెక్టర్ డైమెన్షన్లను, పంపిణీలను, సారూప్యత ప్రవర్తనను మార్చవచ్చు. అననుకూల మోడల్లు రూపొందించిన ఎంబెడ్డింగ్లను, వాటి దూరాలు నేరుగా పోల్చదగినవి అన్నట్లుగా కలపకూడదు.
సంస్థలు ఎంబెడ్డింగ్-మోడల్ ఐడెంటిఫైయర్లను, వెర్షన్లను, సంబంధిత జనరేషన్ సెట్టింగ్లను నమోదు చేయాలి. ఒక మోడల్ మైగ్రేషన్కు, ప్రొడక్షన్ క్వెరీలను మార్చడానికి ముందు కొత్త ఎంబెడ్డింగ్లను జనరేట్ చేయడం, ఇండెక్స్లను మళ్లీ నిర్మించడం, రిట్రీవల్ నాణ్యతను అంచనా వేయడం అవసరం కావచ్చు. మార్పు సమయంలో, పాత, కొత్త రూపాలు కలిసి ఉండాల్సి రావచ్చు.
pgvectorకు రూపాన్ని బట్టి మారే ఇండెక్సింగ్ పరిమితులు కూడా ఉన్నాయి. దాని డాక్యుమెంట్ చేసిన HNSW సపోర్ట్లో 2,000 డైమెన్షన్ల వరకు vector విలువలు, 4,000 డైమెన్షన్ల వరకు halfvec విలువలు ఉంటాయి. ఈ పరిమితులు సంబంధిత ఇండెక్స్ రూపానికి సంబంధించినవి, సాధ్యమయ్యే ప్రతి స్టోరేజ్ లేదా సెర్చ్ వ్యూహంపై సార్వత్రిక పరిమితి కాదు. కాబట్టి అప్లికేషన్ ఎంబెడ్డింగ్-మోడల్ ఎంపిక ఇండెక్స్ డిజైన్ను ప్రభావితం చేస్తుంది.
మూలం: pgvector, Vector Types and Indexing Limits.
ఒక టీమ్ ఎలా ఎంచుకోవాలి?
ఉపయోగకరమైన మూల్యాంకనం ప్రస్తుత PostgreSQL విధానాన్ని, అదే ప్రాతినిధ్య వర్క్లోడ్ను ఉపయోగించి ఒక ప్రత్యేక వెక్టర్ సిస్టమ్తో పోలుస్తుంది.
| మూల్యాంకన అంశం | సమాధానం చెప్పాల్సిన ప్రశ్న |
|---|---|
| రిట్రీవల్ నాణ్యత | ఆశించిన సంబంధిత భాగాలు నిలకడగా దొరుకుతున్నాయా? |
| ఆథరైజేషన్ | అనధికృత డాక్యుమెంట్లు ఎప్పుడైనా మోడల్ సందర్భానికి చేరగలవా? |
| పనితీరు | వాస్తవిక కన్కరెన్సీలో సెర్చ్ లేటెన్సీ లక్ష్యాన్ని అందుకుంటుందా? |
| ఫిల్టరింగ్ | సెలెక్టివ్ టెనెంట్, మెటాడేటా షరతులు ఆమోదయోగ్యమైన రీకాల్ను కాపాడతాయా? |
| అప్డేట్లు, డిలీషన్లు | సెర్చ్ ఇండెక్స్ మూల మార్పులను ఎంత త్వరగా ప్రతిబింబిస్తుంది? |
| ఆపరేషన్లు | ఇండెక్సింగ్, బ్యాకప్, మానిటరింగ్, రికవరీ అవసరాలు ఏమిటి? |
| స్కేలింగ్ | ట్రాన్సాక్షనల్ వర్క్లోడ్లకు హాని చేయకుండా రిట్రీవల్ డిమాండ్ పెరగగలదా? |
| ఖర్చు | మొత్తం ఇన్ఫ్రాస్ట్రక్చర్, నిర్వహణ వ్యయం ఎంత? |
అత్యంత ప్రత్యేకమైన టెక్నాలజీ తనంతట తానుగా అత్యంత అనువైనదని ఈ పోలిక భావించకూడదు. ఒక చిన్న లేదా మధ్యస్థ పరిమాణ అప్లికేషన్కు, నిర్వహించాల్సిన సిస్టమ్లు తక్కువగా ఉండేలా pgvectorతో PostgreSQL అవసరాలను తీరుస్తుందని తెలియవచ్చు. వర్క్లోడ్ ఐసోలేషన్, ప్రత్యేక ఫీచర్లు లేదా స్వతంత్ర స్కేలింగ్ కొలవగలిగే ప్రయోజనాలను అందించినప్పుడు, ఒక పెద్ద అప్లికేషన్ స్వతంత్ర సెర్చ్ టియర్ను సమర్థించుకోవచ్చు. ఈ ఫలితాలు వర్క్లోడ్పై ఆధారపడి ఉంటాయి, సాధారణ డేటాబేస్-పరిమాణ పరిమితుల ద్వారా కాకుండా టెస్ట్ల ద్వారా నిర్ధారించాలి.
ఎక్స్టెన్షన్ను ప్యాచ్ చేసి ఉంచడం కూడా ఆపరేషన్లలో భాగమే. pgvector changelog, HNSW వాక్యూమింగ్ సమయంలో సాధ్యమయ్యే ఇండెక్స్ కరప్షన్కు వెర్షన్ 0.8.3లో జూన్ 17, 2026న, IVFFlat ఇండెక్స్ బిల్డ్ల సమయంలో బఫర్ ఓవర్ఫ్లోలకు వెర్షన్లు 0.8.6లో జూలై 29న (32-bit సిస్టమ్లపై), 0.8.7లో అక్టోబర్ 1, 2026న చేసిన సవరణలను నమోదు చేస్తుంది. ఒక ఇండెక్స్పై ప్రొడక్షన్లో ఆధారపడే ముందు, టీమ్లు ప్రస్తుత ప్యాచ్ రిలీజ్ను నడపాలి, వాక్యూమింగ్, రీబిల్డ్ల వంటి ఇండెక్స్ మెయింటెనెన్స్ను పరీక్షించాలి.
ఆర్కిటెక్చర్ నిర్ణయం చివరికి దేనిపై ఆధారపడుతుంది
PostgreSQL, pgvector అప్లికేషన్ రికార్డులు, ఎంబెడ్డింగ్లు, మెటాడేటా, టెక్స్ట్ సెర్చ్ ఒకే డేటాబేస్ ఎన్విరాన్మెంట్లో ఉండేలా అనుమతిస్తాయి. ఇప్పటికే రిలేషనల్ డేటాపై ఎక్కువగా ఆధారపడే AI అప్లికేషన్లను ఇది సరళం చేయగలదు. ఒక ప్రత్యేక వెక్టర్ సిస్టమ్ విలువైన సామర్థ్యాలను అందించవచ్చు, కానీ దానికి సింక్రొనైజేషన్, డిలీషన్లు, ఆథరైజేషన్, ఆపరేషనల్ యాజమాన్యంపై శ్రద్ధ అవసరం.
ఏ ఆర్కిటెక్చర్ కూడా సెర్చ్ ప్రాసంగికతకు లేదా సురక్షిత రిట్రీవల్కు తనంతట తానుగా హామీ ఇవ్వదు.
ధ్రువీకరించిన రిట్రీవల్, యాక్సెస్-నియంత్రణ అవసరాలతో ప్రారంభించండి. pgvectorతో PostgreSQL వాటిని సమర్థవంతంగా తీరిస్తే దాన్ని ఉపయోగించండి, అదనపు సంక్లిష్టతను కొలతలు సమర్థించినప్పుడు ప్రత్యేక వెక్టర్ సిస్టమ్ను ప్రవేశపెట్టండి.
రిఫరెన్స్లు, మరింత చదవడానికి
- pgvector, Official Repository. సపోర్ట్ ఉన్న వెక్టర్ టైప్లు, సిమిలారిటీ సెర్చ్, ఇండెక్సింగ్, ఫిల్టరింగ్, మల్టీటెనెన్సీ.
- pgvector, Changelog. వెర్షన్ చరిత్ర, ఇటరేటివ్ ఇండెక్స్ స్కాన్లు, ప్యాచ్ రిలీజ్లు.
- PostgreSQL, Row Security Policies. డేటాబేస్ ఆథరైజేషన్ ప్రవర్తన, దాటవేత (bypass) షరతులు.
- PostgreSQL, Full Text Search. కీవర్డ్ రిట్రీవల్, ర్యాంకింగ్.
- PostgreSQL, Full Text Search Introduction.
tsvector,tsqueryటైప్లు. - PostgreSQL, EXPLAIN. ఎగ్జిక్యూషన్-ప్లాన్ పరిశీలన, పనితీరు మూల్యాంకనం.
- pgvector, Release and Security History. ఎక్స్టెన్షన్ రిలీజ్లు, మెయింటెనెన్స్ అప్డేట్లు.
మూలాల ధ్రువీకరణ: నవంబర్ 6, 2026. pgvector తరచుగా రిలీజ్ అవుతుంది, అక్టోబర్ 1, 2026 నాటి 0.8.7 రిలీజ్ ఒక IVFFlat ఇండెక్స్ బిల్డ్ బగ్ను సరిచేసింది, ఇక్కడ చర్చించిన ఆర్కిటెక్చరల్ సామర్థ్యాలను ప్రవేశపెట్టినదిగా దాన్ని చూపడం లేదు, కాబట్టి చర్య తీసుకునే ముందు పై మూలాలను తనిఖీ చేయండి. పనితీరు, ఆర్కిటెక్చర్ మార్గదర్శకాలు విశ్లేషణాత్మక సిఫార్సులు, స్వతంత్ర TechiesJournal బెంచ్మార్క్ ఫలితాలు కావు.