

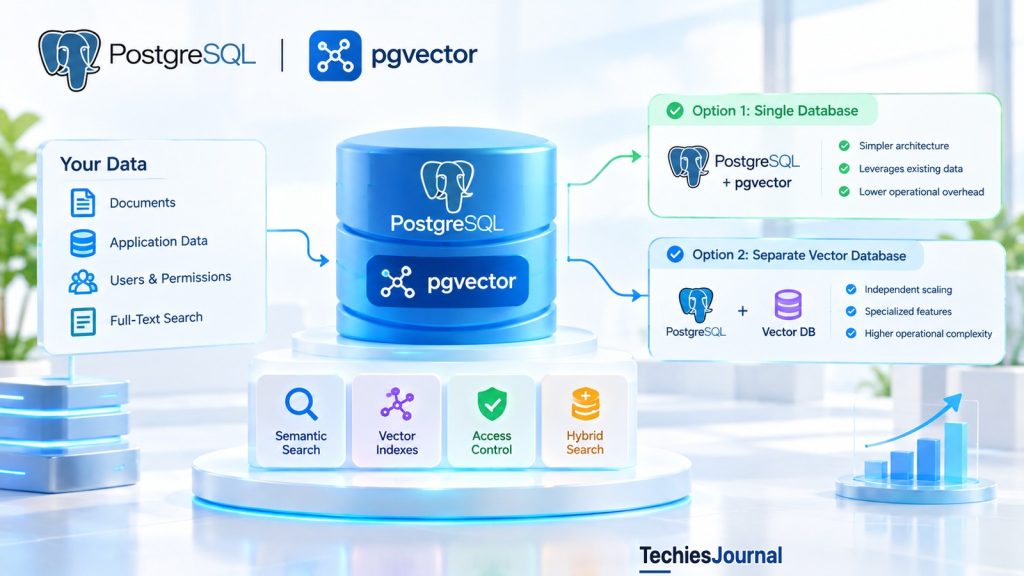
कोई AI एप्लिकेशन बिज़नेस रिकॉर्ड, एम्बेडिंग और खोजे जा सकने वाले दस्तावेज़ PostgreSQL में रख सकता है, या एक समर्पित वेक्टर सिस्टम ला सकता है। सही निर्णय रिट्रीवल की गुणवत्ता, एक्सेस कंट्रोल, स्केलिंग की ज़रूरतों और कई डेटा स्टोर को सिंक्रोनाइज़ रखने की लागत पर निर्भर करता है।
AI नॉलेज असिस्टेंट बनाने वाला कोई संगठन अपने दस्तावेज़, यूज़र और अनुमतियां शायद पहले से ही PostgreSQL में रखता हो। उन दस्तावेज़ों को अर्थ के आधार पर खोजने योग्य बनाने के लिए एप्लिकेशन को एम्बेडिंग (embedding) की ज़रूरत होती है। ये कंटेंट के संख्यात्मक प्रतिनिधित्व हैं, जिनकी मदद से सॉफ़्टवेयर अर्थ की दृष्टि से संबंधित अंश ढूंढ पाता है।
एक विकल्प यह है कि pgvector एक्सटेंशन की मदद से एम्बेडिंग को एप्लिकेशन डेटा के साथ ही स्टोर किया जाए। दूसरा विकल्प एक अलग वेक्टर-सर्च सिस्टम चलाना है। दोनों आर्किटेक्चर रिट्रीवल-ऑगमेंटेड जनरेशन (retrieval-augmented generation, RAG) को सपोर्ट कर सकते हैं।
प्रश्न यह है कि क्या एक अलग डेटाबेस किसी मापने योग्य समस्या को हल करता है, या ऐसी जटिलता लाता है जिसकी एप्लिकेशन को अभी ज़रूरत नहीं है।
pgvector, PostgreSQL में क्या जोड़ता है
PostgreSQL पहले से रिलेशनल स्टोरेज, ट्रांज़ैक्शन, जॉइन, इंडेक्सिंग और फ़ुल-टेक्स्ट सर्च (full-text search) देता है। pgvector वेक्टर डेटा टाइप, सिमिलैरिटी ऑपरेटर और अनुमानित निकटतम-पड़ोसी (approximate nearest-neighbor) इंडेक्स जोड़ता है, जो हर वेक्टर की जांच किए बिना करीबी मिलान जल्दी ढूंढ लेते हैं।
कोई एप्लिकेशन दस्तावेज़ों के हिस्से (चंक), उनकी एम्बेडिंग और उनसे जुड़ा मेटाडेटा PostgreSQL में स्टोर कर सकता है। जब कोई यूज़र प्रश्न पूछता है, तो एप्लिकेशन उस प्रश्न की एम्बेडिंग बनाता है और मिलती-जुलती दस्तावेज़ एम्बेडिंग खोजता है। इसके बाद प्राप्त अंश उत्तर तैयार करने वाले लैंग्वेज मॉडल को संदर्भ दे सकते हैं।
pgvector एम्बेडिंग नहीं बनाता, मॉडल द्वारा तैयार उत्तरों की सटीकता सुनिश्चित नहीं करता, और अपने आप यह तय नहीं करता कि कोई दस्तावेज़ किसी विशेष यूज़र के पढ़ने के लिए सुरक्षित है या नहीं। ये ज़िम्मेदारियां एप्लिकेशन और उसके सिक्योरिटी आर्किटेक्चर की ही रहती हैं।
महत्वपूर्ण बात यह है कि pgvector एक एक्सटेंशन है, PostgreSQL 19 का फ़ीचर नहीं। इसकी मौजूदा क्षमताएं PostgreSQL के समर्थित वर्ज़न में काम करती हैं, और pgvector README में PostgreSQL 13 और उसके बाद के वर्ज़न के लिए सपोर्ट दर्ज है, इसलिए जांच लें कि आपकी रिलीज़ किन वर्ज़न को सपोर्ट करती है। PostgreSQL में खुद क्या बदल रहा है, यह जानने के लिए PostgreSQL 19 और उसके रिलीज़ कैंडिडेट पर हमारा लेख देखें।
स्रोत: pgvector का आधिकारिक डॉक्यूमेंटेशन।
एंटरप्राइज़ RAG एप्लिकेशन दस्तावेज़ कैसे प्राप्त करता है
फ़ाइनेंस और ह्यूमन रिसोर्सेज़ के कर्मचारियों द्वारा इस्तेमाल किए जाने वाले एक काल्पनिक आंतरिक नॉलेज असिस्टेंट पर विचार करें। संगठन दस्तावेज़ और एक्सेस मेटाडेटा PostgreSQL में स्टोर करता है। हर दस्तावेज़ को खोजे जा सकने वाले अंशों में बांटा जाता है, और हर अंश के साथ एक एम्बेडिंग जुड़ी होती है।
एक सामान्य रिट्रीवल ऑपरेशन के कई चरण होते हैं।
1. यूज़र को ऑथेंटिकेट करें। एप्लिकेशन यूज़र की पहचान और उसका अधिकृत संगठनात्मक संदर्भ स्थापित करता है।
2. अनुमत दस्तावेज़ों का दायरा तय करें। सर्वर यह पहचानता है कि यूज़र को किन दस्तावेज़ों तक पहुंच का अधिकार है, और इसके लिए यूज़र द्वारा दिए गए निर्देशों के बजाय भरोसेमंद ऑथराइज़ेशन डेटा का उपयोग करता है।
3. प्रश्न की एम्बेडिंग बनाएं। एक एम्बेडिंग मॉडल यूज़र के प्रश्न को उसी संगत वेक्टर प्रतिनिधित्व में बदलता है जो स्टोर किए गए अंशों के लिए इस्तेमाल हुआ है।
4. मिलते-जुलते अंश प्राप्त करें। PostgreSQL उचित दस्तावेज़-एक्सेस शर्तें लागू करते हुए अर्थ की दृष्टि से मिलते-जुलते कंटेंट को खोजता है।
5. एक्सेस की सीमा लागू करें। एप्लिकेशन यह सत्यापित करता है कि मॉडल तक केवल अनुमत कंटेंट ही भेजा जा सके। सही तरह कॉन्फ़िगर होने पर डेटाबेस की ओर से रो-लेवल सिक्योरिटी (row-level security) प्रवर्तन की एक और परत दे सकती है।
6. उत्तर तैयार करें। लैंग्वेज मॉडल अधिकृत अंशों को सहायक संदर्भ के रूप में उपयोग करता है। ट्रेसबिलिटी के लिए एप्लिकेशन स्रोत संदर्भ सुरक्षित रख सकता है।
ऑथेंटिकेशन
एप्लिकेशन यूज़र की पहचान और उसका अधिकृत संगठनात्मक संदर्भ स्थापित करता है।
अनुमत दायरा
सर्वर यह पहचानता है कि यूज़र को किन दस्तावेज़ों तक पहुंच का अधिकार है, और इसके लिए यूज़र द्वारा दिए गए निर्देशों के बजाय भरोसेमंद ऑथराइज़ेशन डेटा का उपयोग करता है।
प्रश्न की एम्बेडिंग
एक एम्बेडिंग मॉडल यूज़र के प्रश्न को उसी संगत वेक्टर प्रतिनिधित्व में बदलता है जो स्टोर किए गए अंशों के लिए इस्तेमाल हुआ है।
रिट्रीवल
PostgreSQL उचित दस्तावेज़-एक्सेस शर्तें लागू करते हुए अर्थ की दृष्टि से मिलते-जुलते कंटेंट को खोजता है।
ह्यूमन रिसोर्सेज़ का कोई दस्तावेज़ अर्थ की दृष्टि से मिलता-जुलता हो सकता है, लेकिन मिलता-जुलता होने से वह दस्तावेज़ अधिकृत नहीं हो जाता।
सीमा लागू करें
एप्लिकेशन यह सत्यापित करता है कि मॉडल तक केवल अनुमत कंटेंट ही भेजा जा सके।
सही तरह कॉन्फ़िगर होने पर डेटाबेस की ओर से रो-लेवल सिक्योरिटी (row-level security) प्रवर्तन की एक और परत दे सकती है।
जनरेशन
लैंग्वेज मॉडल अधिकृत अंशों को सहायक संदर्भ के रूप में उपयोग करता है।
ट्रेसबिलिटी के लिए एप्लिकेशन स्रोत संदर्भ सुरक्षित रख सकता है।
मान लीजिए फ़ाइनेंस का कोई कर्मचारी खर्च-स्वीकृति नीति के बारे में पूछता है। ह्यूमन रिसोर्सेज़ का कोई दस्तावेज़ अर्थ की दृष्टि से मिलता-जुलता हो सकता है, लेकिन मिलता-जुलता होने से वह दस्तावेज़ अधिकृत नहीं हो जाता। डेटाबेस क्वेरी और उसके आसपास के एप्लिकेशन कंट्रोल को प्रतिबंधित सामग्री को मॉडल के संदर्भ में पहुंचने से रोकना होगा।
PostgreSQL रो-लेवल सिक्योरिटी
PostgreSQL रो-लेवल सिक्योरिटी (RLS) यह सीमित कर सकती है कि कोई डेटाबेस रोल किन रिकॉर्ड को पढ़ या बदल सकता है। यह सामान्य एप्लिकेशन फ़िल्टरिंग से स्वतंत्र रूप से टेनेंट या दस्तावेज़ की सीमाएं लागू करने में मदद कर सकती है।
हालांकि, RLS चालू करने से हर कनेक्शन अपने आप सुरक्षित नहीं हो जाता। सुपरयूज़र और BYPASSRLS वाले रोल पॉलिसी को बायपास कर देते हैं। टेबल के ओनर सामान्यतः RLS को बायपास करते हैं, जब तक FORCE ROW LEVEL SECURITY कॉन्फ़िगर न किया गया हो। एप्लिकेशन को ऑथराइज़ेशन संदर्भ भी सुरक्षित तरीके से स्थापित करना होता है, खासकर जब कनेक्शन पूल किए जाते हैं या दोबारा उपयोग होते हैं।
RLS को वास्तविक यूज़र रोल के साथ टेस्ट किया जाना चाहिए, जिसमें ऐसे नेगेटिव टेस्ट भी शामिल हों जो साबित करें कि अनधिकृत दस्तावेज़ प्राप्त नहीं किए जा सकते। एक सामान्य WHERE tenant_id = ... क्लॉज़ क्वेरी फ़िल्टरिंग के लिए उपयोगी है, लेकिन जब कॉल करने वाला एप्लिकेशन उसे बदल सकता है या हटा सकता है, तब उसे पूरी सुरक्षा सीमा नहीं माना जाना चाहिए।
स्रोत: PostgreSQL, Row Security Policies।
एग्ज़ैक्ट सर्च और अनुमानित इंडेक्स अलग-अलग समस्याएं हल करते हैं
डिफ़ॉल्ट रूप से pgvector एग्ज़ैक्ट निकटतम-पड़ोसी सर्च (exact nearest-neighbor search) करता है। यह चुने गए दूरी माप के अनुसार सबसे निकट मिलने वाले वेक्टर ढूंढता है, और एक उपयोगी आधार-रेखा (baseline) देता है जिसके सापेक्ष अनुमानित परिणामों का मूल्यांकन किया जा सकता है। जैसे-जैसे वेक्टर संग्रह और अनुरोधों की मात्रा बढ़ती है, एग्ज़ैक्ट सर्च महंगी हो सकती है।
pgvector दो प्रमुख अनुमानित इंडेक्सिंग तरीकों को सपोर्ट करता है।
| इंडेक्स | यह कैसे काम करता है | महत्वपूर्ण ट्रेड-ऑफ़ |
|---|---|---|
| HNSW | वेक्टर को एक नेविगेबल ग्राफ़ में व्यवस्थित करता है | कई वर्कलोड के लिए गति और रिकॉल की मज़बूत विशेषताएं, साथ में अतिरिक्त बिल्ड समय और मेमोरी की ज़रूरत |
| IVFFlat | वेक्टर को लिस्ट में समूहित करता है और चुनी गई लिस्ट में खोज करता है | उपयुक्त ट्रेनिंग डेटा और सर्च के दायरे की ट्यूनिंग ज़रूरी |
अनुमानित इंडेक्स एग्ज़ैक्ट सर्च से अलग परिणाम लौटा सकते हैं। इसीलिए केवल लेटेंसी प्रदर्शन का अपर्याप्त माप है। टीमों को रिकॉल (recall) भी मापना चाहिए, जो बताता है कि एग्ज़ैक्ट-सर्च आधार-रेखा की तुलना में अपेक्षित निकटतम-पड़ोसी परिणामों में से कितने प्राप्त हुए।
किसी AI असिस्टेंट के लिए तेज़ परिणाम कम उपयोगी हो सकता है, अगर कोई महत्वपूर्ण दस्तावेज़ लगातार छूट जाता है।
फ़िल्टरिंग रिट्रीवल की गुणवत्ता को प्रभावित कर सकती है
एंटरप्राइज़ सर्च शायद ही कभी केवल वेक्टर सिमिलैरिटी पर निर्भर होती है। परिणामों को संगठन, दस्तावेज़ के प्रकार, प्रोजेक्ट या एक्सेस के दायरे के आधार पर भी फ़िल्टर किया जा सकता है। अनुमानित इंडेक्स के साथ PostgreSQL फ़िल्टरिंग को तब लागू कर सकता है जब इंडेक्स स्कैन कैंडिडेट चुन चुका हो, और इससे अनुरोध से कम परिणाम लौट सकते हैं।
उदाहरण के लिए, अगर कोई सर्च 40 कैंडिडेट की जांच करती है और उनमें से केवल 10% किसी कैटेगरी फ़िल्टर को पूरा करते हैं, तो औसतन लगभग चार ही बच सकते हैं। यह सेलेक्टिविटी का एक उदाहरण है, हर सर्च के लिए निश्चित परिणाम नहीं।
pgvector ने 30 अक्टूबर 2024 को वर्ज़न 0.8.0 में इटरेटिव इंडेक्स स्कैन (iterative index scans) शुरू किए। जब फ़िल्टरिंग बहुत ज़्यादा परिणाम हटा देती है, तब इटरेटिव स्कैन कॉन्फ़िगर की गई संसाधन और स्कैन सीमाओं के भीतर और अधिक इंडेक्स कैंडिडेट की जांच जारी रख सकते हैं। क्वेरी पैटर्न के आधार पर अन्य तरीकों में सामान्य PostgreSQL इंडेक्स, आंशिक वेक्टर इंडेक्स (partial vector indexes) और टेबल पार्टिशनिंग शामिल हैं। इन तंत्रों का चयन माप के आधार पर किया जाना चाहिए।
एक ही अनुमानित इंडेक्स साझा करने वाले टेनेंट एक-दूसरे को भी प्रभावित कर सकते हैं। pgvector डॉक्यूमेंटेशन के अनुसार एक टेनेंट के वेक्टर दूसरे टेनेंट के लिए रिकॉल और गति बदल सकते हैं, और यह टेनेंट आइसोलेशन के लिए लिस्ट पार्टिशनिंग या अलग टेबल की सिफ़ारिश करता है।
सही तरह लागू किए गए ऑथराइज़ेशन फ़िल्टर को केवल सर्च परिणामों की संख्या बढ़ाने के लिए कभी कमज़ोर नहीं किया जाना चाहिए। कम संख्या में अधिकृत अंश लौटाने वाला रिट्रीवल सिस्टम कम पूर्ण उत्तर दे सकता है। अनधिकृत अंश लौटाना एक अलग और अधिक गंभीर विफलता है।
स्रोत: pgvector changelog, pgvector filtering guidance और pgvector multitenancy।
हाइब्रिड सर्च प्रासंगिकता के अलग-अलग रूपों को जोड़ती है
अर्थ पर आधारित सिमिलैरिटी तब उपयोगी होती है जब यूज़र किसी अवधारणा का वर्णन उन सटीक शब्दों के बिना करते हैं जो किसी दस्तावेज़ में मौजूद हैं। आइडेंटिफ़ायर, प्रोडक्ट के नाम, पॉलिसी नंबर और तकनीकी शब्दों के लिए कीवर्ड सर्च अब भी महत्वपूर्ण है।
PostgreSQL tsvector और tsquery जैसी सुविधाओं के ज़रिए फ़ुल-टेक्स्ट सर्च को सपोर्ट करता है। एप्लिकेशन इन परिणामों को pgvector सिमिलैरिटी सर्च के साथ जोड़ सकते हैं। उदाहरण के लिए, किसी विशेष इंसिडेंट नंबर को खोजने वाले नॉलेज असिस्टेंट को एग्ज़ैक्ट टेक्स्ट मैचिंग से लाभ हो सकता है, जबकि किसी व्यापक ट्रबलशूटिंग प्रश्न को सिमैंटिक रिट्रीवल से लाभ हो सकता है।
रैंक किए गए परिणामों को रेसिप्रोकल रैंक फ़्यूज़न (reciprocal rank fusion) जैसी तकनीकों से जोड़ा जा सकता है, जो दो रैंक की गई सूचियों को उनकी स्थिति के आधार पर मिलाती है, और फिर चाहें तो किसी दूसरे रिलेवेंस मॉडल से दोबारा रैंक किया जा सकता है। हालांकि, हाइब्रिड सर्च हर एप्लिकेशन में बेहतर रिट्रीवल की गारंटी नहीं देती। टीमों को प्रतिनिधि प्रश्नों, अपेक्षित दस्तावेज़ों और अंतिम रैंकिंग की गुणवत्ता का मूल्यांकन करना चाहिए।
स्रोत: PostgreSQL full-text search और pgvector hybrid search।
अलग वेक्टर डेटाबेस कब उपयोगी होता है?
एक समर्पित वेक्टर सिस्टम तब सार्थक हो सकता है जब किसी एप्लिकेशन की रिट्रीवल ज़रूरतें उस सीमा से आगे निकल जाएं जिसे उसका मौजूदा PostgreSQL एनवायरनमेंट प्रभावी ढंग से सपोर्ट कर सकता है। उदाहरणों में वेक्टर-सर्च ट्रैफ़िक को स्वतंत्र रूप से स्केल करना, विशेष डिस्ट्रिब्यूटेड इंडेक्सिंग, बहुत बड़े सर्च संग्रह, या ऐसी रिट्रीवल सुविधाएं शामिल हैं जो चुने गए PostgreSQL डिप्लॉयमेंट में उपलब्ध नहीं हैं।
लेकिन एम्बेडिंग को दूसरे सिस्टम में ले जाने से अतिरिक्त ज़िम्मेदारियां पैदा होती हैं।
किसी दस्तावेज़ के अपडेट पर विचार करें। एप्लिकेशन PostgreSQL में स्रोत दस्तावेज़ को बदलता है। उसे प्रभावित एम्बेडिंग को दोबारा बनाना और वेक्टर इंडेक्स को अपडेट भी करना होगा। जब तक सिंक्रोनाइज़ेशन पूरा नहीं होता, सर्च पुराना कंटेंट प्राप्त कर सकती है।
डिलीशन से एक संबंधित समस्या पैदा होती है। ट्रांज़ैक्शनल डेटाबेस से किसी दस्तावेज़ को हटाने पर उसके वेक्टर प्रतिनिधित्व को भी हटाना या अमान्य करना होगा।
अनुमतियों में बदलाव विशेष रूप से महत्वपूर्ण हैं। अगर किसी यूज़र का एक्सेस वापस ले लिया जाता है, तो किसी दूसरे सर्च सिस्टम में मौजूद पुराने एक्सेस मेटाडेटा को प्रतिबंधित कंटेंट मॉडल तक पहुंचने नहीं देना चाहिए।
इसलिए दो डेटा स्टोर वाले आर्किटेक्चर को बदलावों को आगे पहुंचाने, विफलताओं को संभालने, सुरक्षित रूप से दोबारा प्रयास करने और यह तय करने का भरोसेमंद तरीका चाहिए कि सर्च डेटा कब अद्यतन है। चेंज-डेटा कैप्चर (change-data capture), जो डेटाबेस से बदलावों को स्ट्रीम करता है, ट्रांज़ैक्शनल आउटबॉक्स (transactional outbox) पैटर्न, जो बदलाव की घटना को डेटा वाले उसी ट्रांज़ैक्शन में दर्ज करते हैं, और इवेंट प्रोसेसिंग मदद कर सकते हैं, लेकिन इनमें से हर एक के लिए इम्प्लीमेंटेशन और ऑपरेशनल ओनरशिप ज़रूरी है। सर्च इंडेक्स में देरी होने पर भी आधिकारिक अनुमति जांच लागू करने योग्य बनी रहनी चाहिए।
दस्तावेज़ बदला
एप्लिकेशन PostgreSQL में स्रोत दस्तावेज़ को बदलता है।
उसे प्रभावित एम्बेडिंग को दोबारा बनाना और वेक्टर इंडेक्स को अपडेट भी करना होगा।
जब तक सिंक्रोनाइज़ेशन पूरा नहीं होता, सर्च पुराना कंटेंट प्राप्त कर सकती है।
दस्तावेज़ डिलीट हुआ
ट्रांज़ैक्शनल डेटाबेस से किसी दस्तावेज़ को हटाने पर उसके वेक्टर प्रतिनिधित्व को भी हटाना या अमान्य करना होगा।
अनुमति वापस ली गई
अगर किसी यूज़र का एक्सेस वापस ले लिया जाता है, तो किसी दूसरे सर्च सिस्टम में मौजूद पुराने एक्सेस मेटाडेटा को प्रतिबंधित कंटेंट मॉडल तक पहुंचने नहीं देना चाहिए।
सर्च इंडेक्स पीछे है
इसलिए दो डेटा स्टोर वाले आर्किटेक्चर को बदलावों को आगे पहुंचाने, विफलताओं को संभालने, सुरक्षित रूप से दोबारा प्रयास करने और यह तय करने का भरोसेमंद तरीका चाहिए कि सर्च डेटा कब अद्यतन है।
सर्च इंडेक्स में देरी होने पर भी आधिकारिक अनुमति जांच लागू करने योग्य बनी रहनी चाहिए।
ये सिंक्रोनाइज़ेशन सीमाएं अलग वेक्टर सिस्टम अपनाने की लागत का हिस्सा हैं।
एम्बेडिंग मॉडल माइग्रेशन की एक और सीमा लाते हैं
एम्बेडिंग किसी विशेष मॉडल और प्रतिनिधित्व से बनाई जाती है। एम्बेडिंग मॉडल बदलने से वेक्टर के डाइमेंशन, डिस्ट्रिब्यूशन और सिमिलैरिटी का व्यवहार बदल सकता है। असंगत मॉडल से बनी एम्बेडिंग को इस तरह नहीं मिलाना चाहिए मानो उनकी दूरियां सीधे तुलना योग्य हों।
संगठनों को एम्बेडिंग मॉडल के आइडेंटिफ़ायर, वर्ज़न और जनरेशन की प्रासंगिक सेटिंग दर्ज करनी चाहिए। मॉडल माइग्रेशन में प्रोडक्शन क्वेरी को स्विच करने से पहले नई एम्बेडिंग बनाने, इंडेक्स दोबारा बनाने और रिट्रीवल की गुणवत्ता का मूल्यांकन करने की ज़रूरत पड़ सकती है। बदलाव के दौरान पुराने और नए प्रतिनिधित्व को साथ-साथ मौजूद रहना पड़ सकता है।
pgvector की इंडेक्सिंग सीमाएं भी हैं, जो प्रतिनिधित्व पर निर्भर करती हैं। इसके डॉक्यूमेंटेड HNSW सपोर्ट में 2,000 डाइमेंशन तक की vector वैल्यू और 4,000 डाइमेंशन तक की halfvec वैल्यू शामिल हैं। ये सीमाएं संबंधित इंडेक्स प्रतिनिधित्व से जुड़ी हैं, हर संभव स्टोरेज या सर्च रणनीति पर लागू होने वाली सार्वभौमिक पाबंदी नहीं। इसलिए एप्लिकेशन का एम्बेडिंग मॉडल का चुनाव इंडेक्स डिज़ाइन को प्रभावित करता है।
स्रोत: pgvector, Vector Types and Indexing Limits।
टीम को कैसे चुनना चाहिए?
एक उपयोगी मूल्यांकन एक ही प्रतिनिधि वर्कलोड पर मौजूदा PostgreSQL तरीके की तुलना अलग वेक्टर सिस्टम से करता है।
| मूल्यांकन का क्षेत्र | जिस प्रश्न का उत्तर चाहिए |
|---|---|
| रिट्रीवल की गुणवत्ता | क्या अपेक्षित प्रासंगिक अंश लगातार मिलते हैं? |
| ऑथराइज़ेशन | क्या अनधिकृत दस्तावेज़ कभी मॉडल के संदर्भ तक पहुंच सकते हैं? |
| प्रदर्शन | क्या वास्तविक कॉन्करेंसी में सर्च लेटेंसी लक्ष्य को पूरा करती है? |
| फ़िल्टरिंग | क्या सेलेक्टिव टेनेंट और मेटाडेटा शर्तों के साथ रिकॉल स्वीकार्य बना रहता है? |
| अपडेट और डिलीशन | सर्च इंडेक्स स्रोत में हुए बदलावों को कितनी जल्दी दर्शाता है? |
| ऑपरेशन | इंडेक्सिंग, बैकअप, मॉनिटरिंग और रिकवरी की क्या ज़रूरतें हैं? |
| स्केलिंग | क्या ट्रांज़ैक्शनल वर्कलोड को नुकसान पहुंचाए बिना रिट्रीवल की मांग बढ़ सकती है? |
| लागत | इन्फ़्रास्ट्रक्चर और मेंटेनेंस का कुल खर्च कितना है? |
तुलना में यह नहीं मान लेना चाहिए कि सबसे विशेषीकृत तकनीक अपने आप सबसे उपयुक्त है। किसी छोटे या मध्यम आकार के एप्लिकेशन को लग सकता है कि pgvector के साथ PostgreSQL कम सिस्टम संभालते हुए उसकी ज़रूरतें पूरी करता है। कोई बड़ा एप्लिकेशन एक स्वतंत्र सर्च टियर को तब उचित ठहरा सकता है जब वर्कलोड आइसोलेशन, विशेष सुविधाएं या स्वतंत्र स्केलिंग मापने योग्य लाभ देती हों। ये परिणाम वर्कलोड पर निर्भर हैं और इन्हें टेस्ट के ज़रिए स्थापित किया जाना चाहिए, डेटाबेस के आकार की सामान्य सीमाओं के आधार पर नहीं।
ऑपरेशन में एक्सटेंशन को पैच करके रखना भी शामिल है। pgvector changelog में 17 जून 2026 के वर्ज़न 0.8.3 में HNSW वैक्यूमिंग के दौरान संभावित इंडेक्स करप्शन के सुधार दर्ज हैं, और IVFFlat इंडेक्स बिल्ड के दौरान बफ़र ओवरफ़्लो के सुधार 29 जुलाई के वर्ज़न 0.8.6 (32-बिट सिस्टम पर) और 1 अक्टूबर 2026 के वर्ज़न 0.8.7 में दर्ज हैं। टीमों को प्रोडक्शन में किसी इंडेक्स पर निर्भर होने से पहले मौजूदा पैच रिलीज़ चलानी चाहिए और वैक्यूमिंग और रीबिल्ड जैसे इंडेक्स मेंटेनेंस का टेस्ट करना चाहिए।
आर्किटेक्चर का निर्णय आखिरकार किस बात पर टिका है
PostgreSQL और pgvector एप्लिकेशन रिकॉर्ड, एम्बेडिंग, मेटाडेटा और टेक्स्ट सर्च को एक ही डेटाबेस एनवायरनमेंट में रहने देते हैं। इससे उन AI एप्लिकेशन को सरल बनाया जा सकता है जो पहले से रिलेशनल डेटा पर बहुत ज़्यादा निर्भर हैं। एक अलग वेक्टर सिस्टम मूल्यवान क्षमताएं दे सकता है, लेकिन उसमें सिंक्रोनाइज़ेशन, डिलीशन, ऑथराइज़ेशन और ऑपरेशनल ओनरशिप पर ध्यान देना ज़रूरी होता है।
कोई भी आर्किटेक्चर अपने आप सर्च की प्रासंगिकता या सुरक्षित रिट्रीवल की गारंटी नहीं देता।
सत्यापित रिट्रीवल और एक्सेस-कंट्रोल ज़रूरतों से शुरुआत करें। जब pgvector के साथ PostgreSQL उन्हें प्रभावी ढंग से पूरा करे, तब उसका उपयोग करें, और जब माप अतिरिक्त जटिलता को उचित ठहराएं, तब एक अलग वेक्टर सिस्टम लाएं।
संदर्भ और आगे पढ़ने के लिए
- pgvector, Official Repository। समर्थित वेक्टर टाइप, सिमिलैरिटी सर्च, इंडेक्सिंग, फ़िल्टरिंग और मल्टीटेनेंसी।
- pgvector, Changelog। वर्ज़न इतिहास, इटरेटिव इंडेक्स स्कैन और पैच रिलीज़।
- PostgreSQL, Row Security Policies। डेटाबेस ऑथराइज़ेशन का व्यवहार और बायपास की शर्तें।
- PostgreSQL, Full Text Search। कीवर्ड रिट्रीवल और रैंकिंग।
- PostgreSQL, Full Text Search Introduction।
tsvectorऔरtsqueryटाइप। - PostgreSQL, EXPLAIN। एक्ज़िक्यूशन प्लान की जांच और प्रदर्शन का मूल्यांकन।
- pgvector, Release and Security History। एक्सटेंशन की रिलीज़ और मेंटेनेंस अपडेट।
स्रोत 6 नवंबर 2026 को सत्यापित किए गए। pgvector अक्सर नई रिलीज़ जारी करता है, और 1 अक्टूबर 2026 की 0.8.7 रिलीज़ ने IVFFlat इंडेक्स बिल्ड का एक बग ठीक किया और इसे यहां चर्चा की गई आर्किटेक्चरल क्षमताएं लाने वाली रिलीज़ के रूप में प्रस्तुत नहीं किया गया है, इसलिए कोई कदम उठाने से पहले ऊपर दिए गए स्रोत जांच लें। प्रदर्शन और आर्किटेक्चर से जुड़ा मार्गदर्शन विश्लेषणात्मक सिफ़ारिशें हैं, TechiesJournal के स्वतंत्र बेंचमार्क परिणाम नहीं।