

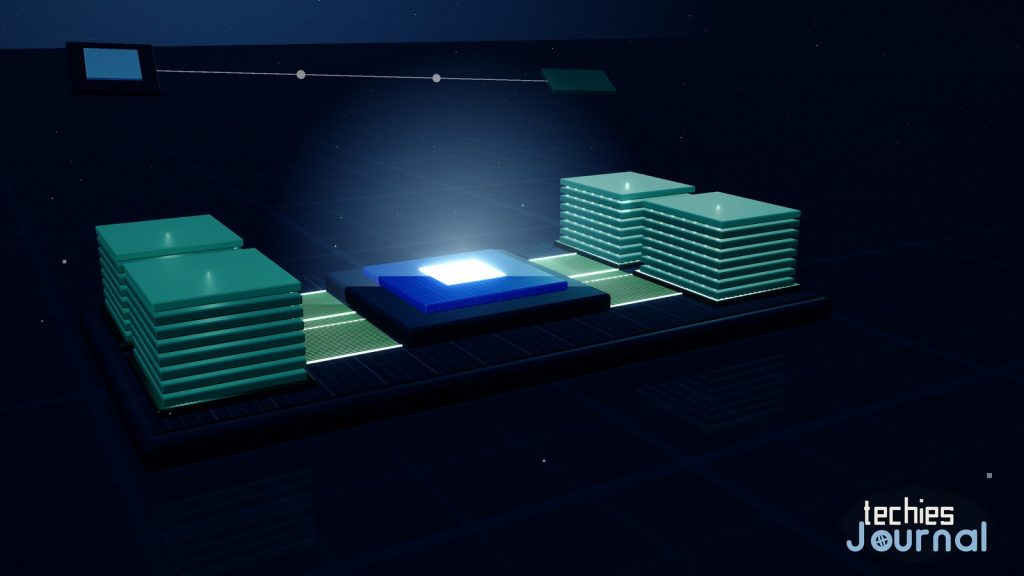
Illustration conceptuelle : une liaison courte et large vers une mémoire empilée, à côté d’une liaison longue et fine vers une mémoire éloignée. Une puce plus rapide attend lorsque ses données arrivent lentement.
Une puce plus rapide ne rend pas, à elle seule, l’IA plus rapide
Une puce d’IA plus rapide ne rend pas l’IA plus rapide si les données ne peuvent pas l’atteindre assez vite.
Une puce ne peut travailler que sur les données dont elle dispose déjà. Si les données arrivent lentement, la puce attend. Pendant une grande partie du temps qu’un modèle passe à rédiger une réponse, c’est cette attente qui fixe la limite, et non le calcul.
Cet article présente la mémoire conçue pour raccourcir cette attente. On l’appelle HBM, pour high bandwidth memory, c’est-à-dire mémoire à haute bande passante. À la fin de votre lecture, vous saurez ce qu’elle est, pourquoi l’IA en consomme autant, pourquoi il n’y en a pas assez et ce que cela implique pour le coût de l’IA comme pour celui des appareils courants.
Ce que la mémoire apporte au processeur
Le processeur effectue les calculs. La mémoire contient les données sur lesquelles il travaille.
Deux grandeurs caractérisent la mémoire. La capacité correspond à la quantité de données qu’elle peut contenir. La bande passante correspond à la vitesse à laquelle les données peuvent circuler entre la mémoire et le processeur.
Pensez à un cuisinier et à son garde-manger. La capacité, c’est la taille du garde-manger. La bande passante, c’est le nombre d’ingrédients que le cuisinier peut apporter jusqu’au plan de travail chaque seconde. Un cuisinier très rapide, mais dont le chemin vers le garde-manger est lent, passe l’essentiel de sa journée à attendre.
Ce qu’est la HBM
La HBM repose sur la même technologie de base que la mémoire ordinaire des ordinateurs, appelée DRAM. Ce qui change, c’est la façon dont elle est assemblée. Plusieurs puces mémoire sont empilées les unes sur les autres, comme les étages d’un immeuble, et reliées par de minuscules connexions verticales appelées vias traversants (through-silicon vias). Cette pile est ensuite placée juste à côté du processeur, sur un support commun, à l’intérieur du même boîtier.
Cette disposition présente deux avantages. La distance entre la mémoire et le processeur est très courte. Et la liaison entre les deux est très large, ce qui permet à de nombreux bits de circuler en même temps.
La norme de la dernière génération, la HBM4, décrit une interface de 2048 bits et jusqu’à 2 téraoctets par seconde pour chaque pile, selon l’annonce de la norme publiée par le JEDEC en avril 2025. À titre de comparaison, une carte graphique haut de gamme peut utiliser une interface de 512 bits vers sa mémoire.
Alternative textuelle accessible pour cette figure
Comparaison de deux dispositions. Dans la première, un processeur est placé au milieu d’un support commun, avec de chaque côté une pile HBM de quatre couches de mémoire, reliée par des liaisons courtes et très larges. La HBM4 utilise 2048 bits par pile.
Dans la seconde, le processeur se trouve à une extrémité d’un circuit imprimé et les puces mémoire à l’autre extrémité, reliés par une liaison plus longue et plus étroite. Une carte graphique haut de gamme peut utiliser 512 bits.
Le prix de cette conception, c’est la complexité. L’empilement est difficile à bien réaliser, et le support commun, appelé interposeur, rend l’ensemble plus coûteux qu’une mémoire ordinaire montée sur un circuit imprimé.
Une puce d’IA moderne embarque plusieurs piles. NVIDIA annonce pour sa puce H100, destinée aux centres de données, 80 Go de mémoire et 3,35 téraoctets par seconde de bande passante. AMD annonce pour sa MI455X 432 Go de HBM4 répartis sur 12 piles, et pour un rack de 72 de ces puces, 31 téraoctets de HBM4 au total. Ce sont des chiffres de fabricants : lisez-les comme ce que chaque entreprise affirme pour son propre produit.
Pourquoi l’IA en a tant besoin
Lorsqu’un modèle d’IA rédige une réponse, il produit un fragment de texte à la fois, appelé jeton (token). Pour chaque jeton, la puce doit lire en mémoire les valeurs stockées du modèle, appelées poids. Elle lit aussi un enregistrement continu de la conversation jusque-là, appelé cache KV. Nous avons expliqué le cache KV dans Exécuter soi-même des modèles d’IA ouverts (en anglais).
Une prépublication de recherche consacrée à l’inférence qualifie cette étape de « strictement limitée par la bande passante », ce qui signifie que la vitesse de la mémoire impose le rythme. Le même article constate que la capacité de HBM limite le nombre d’utilisateurs qu’une puce peut servir simultanément, et que la bande passante limite la vitesse à laquelle chaque réponse apparaît.
Il donne un exemple : servir 128 requêtes de 10 000 jetons de raisonnement chacune nécessite plus de 1,3 téraoctet de mémoire pour le seul cache. Il s’agit d’une prépublication, et deux de ses quatre auteurs travaillent chez Micron, un fabricant de mémoire : lisez-la donc comme un travail informé, mais pas entièrement indépendant. Les auteurs notent que les très grands modèles constitués de nombreuses parties spécialisées peuvent être limités par le routage plutôt que par la vitesse de la mémoire. La mémoire est donc une limite majeure, mais pas la seule.
Voici un calcul simple pour donner un ordre de grandeur. Un modèle de 70 milliards de poids stockés sur deux octets chacun a besoin d’environ 140 Go rien que pour les poids. C’est notre propre calcul, et ce volume ne tient déjà pas dans les 80 Go d’une H100, avant même de compter le moindre cache KV. Des modèles plus grands et des conversations plus longues font encore grimper ce besoin.
Nous avons examiné cette même pression sous l’angle des coûts dans pourquoi l’inférence d’IA change notre façon de penser l’équilibrage de charge (en anglais), et sous l’angle de l’efficacité dans Microsoft Maia 300 (en anglais).
Pourquoi il n’y en a pas assez
Quatre facteurs se combinent et se renforcent mutuellement.
- Peu de fabricants. L’offre de HBM est concentrée entre trois entreprises : SK hynix, Micron et Samsung. À notre avis, un nouvel entrant aurait besoin de plusieurs années pour rattraper son retard.
- Difficile à fabriquer. Empiler et relier les puces, puis les mettre en boîtier à côté d’un processeur, exige des étapes spécialisées. Le directeur des opérations de Micron a déclaré que la future HBM, plus complexe, présente des « trade ratios » plus élevés, c’est-à-dire qu’elle consomme davantage de capacité d’usine pour chaque bit, et que cela limitera l’offre. Le PDG de TSMC a déclaré lors de la conférence sur les résultats de l’entreprise que celle-ci connaît « une forte pénurie sur le back-end », c’est-à-dire l’étape de mise en boîtier.
- Une demande en forte hausse. Chaque rack d’IA nécessite beaucoup de HBM, et le nombre de racks en construction augmente.
- Les nouvelles capacités arrivent lentement. Les plans de Micron, tels que résumés à partir de sa conférence sur les résultats, situent la production de sa première nouvelle usine de l’Idaho à la mi-2027, et celle des usines suivantes en 2028 et 2030. Nous n’avons pas lu ces dates dans la conférence elle-même.
Ce que montrent les résultats de ce mois-ci
Deux entreprises ont publié des résultats qui éclairent les deux extrémités de la chaîne. Sauf mention contraire, les chiffres ci-dessous proviennent de leurs propres documents réglementaires.
| Entreprise | Ce qu’elle a publié | Ce que cela apporte |
|---|---|---|
| TSMC (fabricant de puces, 15 octobre) | Chiffre d’affaires de 1 494,24 milliards de NT$, en hausse de 50,9 % sur un an. Bénéfice net de 763,06 milliards de NT$, en hausse de 68,7 %. Son procédé le plus récent, le 2 nm, a représenté 8 % du chiffre d’affaires des plaquettes (wafers). | Le PDG, C.C. Wei, a déclaré que la demande dépasse l’offre et que l’écart reste « encore assez important ». Cette citation provient d’une transcription tierce dont certains passages sont confus. |
| Micron (fabricant de mémoire, 30 septembre) | Chiffre d’affaires de 54,23 milliards de dollars au quatrième trimestre et de 133,19 milliards de dollars sur l’exercice. L’entreprise prévoit 61,5 milliards de dollars pour le trimestre suivant. | Son directeur des opérations a déclaré : « nous n’avons vraiment aucune visibilité sur le moment où l’offre et la demande s’équilibreront ». |
| AMD (concepteur de puces) | Annonce 432 Go de HBM4 sur chaque MI455X et 31 To dans un rack de 72 puces. AMD prévoit des déploiements en volume de son rack Helios au second semestre 2026. | Samsung a déclaré en mars 2026 être le fournisseur privilégié de HBM4 pour la MI455X. Il s’agit d’une déclaration de Samsung elle-même. |
Une mise en garde s’impose ici. Les entreprises qui affirment que l’offre est tendue sont celles qui la vendent, et une offre tendue soutient leurs prix.
Micron prévoit une marge brute d’environ 86 % pour son prochain trimestre, ce qui montre la solidité de sa position. Considérez ces prévisions comme informées, mais intéressées.
Deux autres points de vue méritent d’être mis en regard. TrendForce, un cabinet d’études indépendant, indique dans un bulletin du 16 octobre que l’offre de HBM restera insuffisante jusqu’en 2028. Ce bulletin résume un rapport payant : nous n’avons donc pas pu en lire les chiffres.
Les perspectives publiées par SK hynix elle-même notent que certains chercheurs s’attendent à une correction des prix de la HBM après 2026, à mesure que la capacité augmente. Une offre insuffisante et des prix qui restent élevés ne sont pas la même affirmation.
Pourquoi cela touche les appareils courants
La HBM et la mémoire ordinaire puisent dans la même capacité limitée de fabrication de puces, selon TrendForce. Quand les fabricants en consacrent davantage à la HBM, il en reste moins pour la mémoire des ordinateurs portables et des téléphones. TrendForce, un cabinet d’études indépendant, prévoyait le 30 septembre que les prix contractuels de la DRAM conventionnelle augmenteraient de 10 à 15 % d’un trimestre à l’autre au dernier trimestre 2026.
Le cabinet a aussi indiqué que la hausse des coûts de la mémoire pèse sur les ventes d’ordinateurs portables, que certaines marques de PC réduisent la capacité des SSD de leurs modèles grand public et que la production de smartphones est freinée. Le directeur des opérations de Micron a déclaré que l’entreprise avait constaté une baisse séquentielle des bits de mémoire livrés à ses clients des segments mobile et PC.
TrendForce ne chiffre pas la part de ces effets imputable à la HBM. Le lien est donc réel, mais son ampleur reste inconnue.
Nous n’avons pas trouvé de hausse de prix confirmée des services d’IA dans le cloud qui découle de la HBM. Si vous achetez de l’IA à l’heure ou au jeton, considérez le coût de la mémoire comme un risque à anticiper, et non comme un fait avéré aujourd’hui. Pour le volet énergétique de cette même histoire, consultez pourquoi l’électricité devient la vraie contrainte (en anglais).
Jusqu’où approfondir le sujet
Connaître : Presque toute personne qui travaille à proximité de l’IA devrait en savoir au moins ceci. La HBM est une mémoire empilée à côté du processeur, l’IA la lit en permanence et l’offre est limitée. Cela explique pourquoi le matériel d’IA coûte cher et pourquoi le choix d’un GPU dépend autant de la mémoire que de la vitesse.
Appliquer : Les ingénieurs qui dimensionnent des charges de travail d’IA doivent savoir estimer la quantité de mémoire dont un modèle et ses conversations auront besoin, puis la comparer à la mémoire et à la bande passante des puces proposées. Pour une vue d’ensemble des types de puces, consultez CPU vs GPU vs TPU vs NPU vs LPU vs DPU.
Maîtriser : Les architectes matériel et infrastructure ont besoin du détail. Cela comprend la façon dont les piles sont construites et mises en boîtier, la manière dont les différentes charges de travail utilisent la mémoire, et la façon de planifier le risque d’approvisionnement sur un achat pluriannuel.
Ce que vous pouvez ignorer pour l’instant
Inutile de mémoriser les noms des générations de HBM, les classes de vitesse ou les tableaux de parts de marché. Ils changent chaque année, et les chiffres de parts de marché que nous avons trouvés dataient de plus d’un an.
Ignorez les flambées de prix issues d’une source unique qui circulent sur les réseaux sociaux : nous n’avons pas pu les confirmer. Vous n’avez pas non plus besoin de suivre chaque chiffre de résultats. L’idée à retenir durablement, c’est que déplacer les données peut limiter l’IA autant que les calculs.
Une prochaine étape concrète
Choisissez un modèle d’IA que vous utilisez ou comptez utiliser, et notez trois chiffres : la taille de ses poids, la quantité de mémoire qu’ajoute une longue conversation, ainsi que la capacité mémoire et la bande passante de la puce qui l’exécute. Si les deux premiers ne tiennent pas confortablement dans le troisième, c’est la mémoire qui vous limite, et une puce plus rapide n’y changera rien.
Pour aller plus loin
- Micron fiscal fourth quarter 2026 press release, pour le chiffre d’affaires, les prévisions et la marge.
- TSMC third quarter 2026 Form 6-K, pour le chiffre d’affaires, le bénéfice et la répartition par procédé.
- AMD Instinct MI400 series, pour les chiffres de mémoire de la MI455X.
- NVIDIA H100, pour sa capacité mémoire et sa bande passante.
- Understanding Inference Scaling for LLMs, pour comprendre pourquoi l’inférence est limitée par la mémoire.
- SK hynix 2026 market outlook, pour le point de vue d’un fabricant de mémoire, y compris les risques qu’il cite.
- TrendForce 4Q26 memory price forecast, via I-Connect007, pour l’effet sur les appareils courants.
- JEDEC HBM4 announcement, as republished by Storage Newsletter, pour la largeur d’interface, la vitesse et les tailles de pile prévues par la norme.
- TrendForce HBM market bulletin, 16 October 2026, pour des perspectives d’approvisionnement indépendantes jusqu’en 2028.
- High Bandwidth Memory on Wikipedia, pour une référence générale sur la construction de la HBM.
Les chiffres de cet article ont été vérifiés les 18 et 19 octobre 2026. Les résultats financiers et les prévisions de prix évoluent : vérifiez les sources ci-dessus avant de vous y fier.