

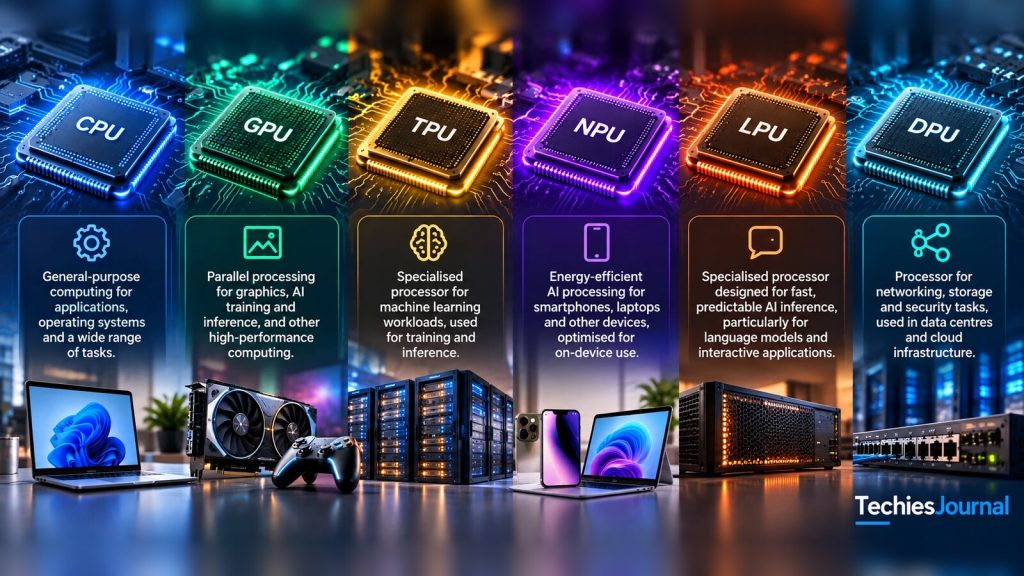
Six types de processeurs expliqués avec des mots simples, à partir d’exemples tirés des téléphones, des ordinateurs et des systèmes d’IA.
Illustration conceptuelle des six types de processeurs, générée par IA. Les puces, les appareils et les libellés de l’image sont des représentations artistiques, et non des photographies de produits réels.
Quand vous ouvrez un navigateur, lancez un jeu, retouchez une photo sur votre téléphone ou posez une question à un assistant d’IA, votre appareil ou un service en ligne doit accomplir des tâches de natures différentes. Certaines exigent de la souplesse. D’autres consistent à répéter des milliers de fois des calculs similaires. D’autres encore doivent consommer très peu d’énergie ou faire circuler efficacement l’information entre des serveurs.
C’est pourquoi les ordinateurs et les services d’IA font appel à différents processeurs. Vous avez sans doute déjà entendu parler des CPU et des GPU. Les TPU, NPU, LPU et DPU sont moins connus, et leurs noms peuvent laisser croire qu’il s’agit de versions concurrentes d’un même produit. Ce n’est pas le cas.
Certains exécutent des modèles d’IA, d’autres prennent en charge le travail applicatif courant, d’autres encore s’occupent de l’infrastructure sur laquelle reposent ces modèles. Voyons comment chacun fonctionne et où vous pouvez le rencontrer.
CPU : le processeur généraliste
CPU signifie Central Processing Unit (unité centrale de traitement). C’est le processeur polyvalent qui exécute une grande variété d’instructions informatiques. Votre système d’exploitation, votre navigateur, vos applications professionnelles et de nombreux processus serveur reposent sur des CPU.
Un CPU possède plusieurs cœurs. Chacun peut exécuter des instructions différentes, réagir aux décisions prises dans un programme et coordonner le travail avec la mémoire et les autres composants. Imaginez un chef cuisinier expérimenté, capable de lire les commandes, de passer d’un plat à l’autre et de gérer les demandes imprévues. Ce n’est qu’une analogie, mais elle montre bien pourquoi la souplesse compte.
Usages courants : faire tourner un système d’exploitation comme Windows, macOS ou Linux, exécuter la logique des applications et des bases de données, traiter les requêtes web et coordonner les applications d’IA. Les CPU peuvent aussi exécuter de petits modèles d’IA lorsque leurs performances suffisent.
Point fort : gère bien des tâches variées. Limite : généralement moins efficace que des accélérateurs dédiés face à d’énormes volumes de calculs d’IA parallélisables.
GPU : le spécialiste du traitement parallèle
GPU signifie Graphics Processing Unit (processeur graphique). Il a d’abord été conçu pour le graphisme, où de nombreux calculs similaires doivent être effectués sur des pixels et des objets 3D. Cette même capacité le rend utile pour l’IA.
Imaginez une brigade de cuisine qui prépare des centaines de plats similaires en même temps, plutôt qu’un seul chef qui passe d’une tâche sans rapport à une autre. Les GPU découpent le travail qui s’y prête en de nombreuses opérations parallèles. Les GPU modernes intègrent aussi du matériel dédié aux calculs matriciels, ces opérations numériques très utilisées dans les réseaux de neurones.
Usages courants : jeux et graphismes 3D, simulations scientifiques, entraînement de modèles d’IA et exécution de modèles entraînés pour générer du texte, des images et d’autres résultats.
Dans un service d’IA cloud, un CPU peut traiter la requête de l’utilisateur pendant qu’un GPU exécute le modèle. Les GPU occupent une place importante parce qu’ils associent une puissance de calcul parallèle considérable à un vaste écosystème logiciel.
Point fort : effectue en parallèle de nombreux calculs qui s’y prêtent. Limite : un matériel de forte puissance peut être un gaspillage lorsque la charge de travail est petite ou ne peut pas exploiter le parallélisme disponible. Le guide de programmation CUDA de NVIDIA détaille le modèle d’exécution parallèle.
TPU : l’accélérateur d’IA spécialisé de Google
TPU signifie Tensor Processing Unit (processeur tensoriel). C’est la famille de processeurs de Google conçue pour les calculs d’apprentissage automatique. Un tenseur est un ensemble de nombres, dont une matrice ordinaire est un exemple familier.
Les réseaux de neurones effectuent des calculs répétés sur ces ensembles de nombres. Les TPU utilisent du matériel spécialisé dans le traitement matriciel pour accélérer ce travail. Une architecture importante repose sur une grille d’unités de calcul qui se transmettent des valeurs de l’une à l’autre, un peu comme sur une chaîne de montage. Le terme technique est celui de réseau systolique. Les TPU modernes comportent aussi d’autres composants de traitement, de mémoire et de communication.
Usages courants : entraînement de modèles d’apprentissage automatique, inférence d’IA et déploiement de charges de travail prises en charge via Google Cloud.
Point fort : exécution efficace des opérations d’apprentissage automatique prises en charge. Limite : il faut tenir compte des logiciels pris en charge et de la charge de travail, car un TPU n’est pas automatiquement un meilleur choix qu’un GPU. L’introduction à Cloud TPU de Google évoque explicitement des situations où des CPU ou des GPU peuvent être préférables.
NPU : un traitement de l’IA efficace sur les appareils
NPU signifie Neural Processing Unit (processeur neuronal). Le terme désigne du matériel dédié à l’accélération des réseaux de neurones, souvent intégré aux téléphones, aux ordinateurs portables et aux systèmes embarqués. De nombreux NPU sont conçus pour effectuer les opérations d’IA prises en charge en consommant moins d’énergie qu’un processeur plus grand et plus généraliste.
Un téléphone peut utiliser du matériel d’IA dédié pour améliorer les photos ou traiter la parole. Un ordinateur portable peut utiliser un NPU pour des fonctions compatibles d’appel vidéo ou d’accessibilité. Les tâches réellement exécutées sur le NPU dépendent de l’appareil, du modèle et du logiciel. Le CPU ou le GPU peuvent prendre en charge d’autres parties.
Usages courants : appareils photo des téléphones, fonctions vocales et linguistiques prises en charge, effets d’appel vidéo, IA embarquée et en périphérie (edge).
Point fort : accélération de l’IA économe en énergie pour les charges de travail compatibles sur l’appareil. Limite : la taille des modèles, la mémoire et les opérations prises en charge varient d’un appareil à l’autre.
Exécuter l’IA en local peut réduire le besoin d’envoyer des données à un service distant, mais un NPU ne rend pas automatiquement une application respectueuse de la vie privée. L’application peut toujours transmettre des informations ailleurs. La documentation Core ML d’Apple décrit comment les modèles pris en charge peuvent utiliser les différents processeurs de l’appareil.
LPU : l’architecture d’inférence de Groq pour les modèles de langage
LPU signifie Language Processing Unit (processeur de langage) dans la terminologie de Groq. Contrairement à CPU ou GPU, ce nom est associé à l’architecture d’inférence d’un fournisseur précis, et non à une famille de processeurs commune à tout le secteur.
L’inférence consiste à utiliser un modèle déjà entraîné pour produire un résultat. Groq conçoit sa technologie LPU pour une exécution rapide et prévisible des modèles pris en charge. Son compilateur planifie le moment où les calculs ont lieu et les déplacements de l’information. L’architecture s’appuie aussi fortement sur une mémoire rapide intégrée à la puce.
Imaginez une chaîne de montage soigneusement planifiée, où chaque poste sait quand l’information arrivera et ce qu’il doit faire ensuite. C’est une première façon d’aborder l’architecture, pas une description littérale de chaque opération.
Usages courants : service de modèles de langage pris en charge, applications d’IA interactives et systèmes où une faible latence de réponse compte.
Point fort : exécution prévisible et inférence potentiellement très rapide sur les charges de travail adaptées. Limite : la compatibilité des modèles, la capacité mémoire et la nécessité de relier plusieurs puces influent sur les performances réelles. Une génération de jetons plus rapide ne signifie pas forcément une application complète moins chère ou plus rapide. Consultez l’explication du LPU par Groq pour la description de l’architecture par le fournisseur.
DPU : le processeur de déchargement de l’infrastructure
DPU signifie Data Processing Unit (processeur de données). Il joue un rôle différent de celui des processeurs précédents. Les grands serveurs et les centres de données doivent acheminer le trafic réseau, gérer les opérations de stockage et appliquer des contrôles de sécurité pendant que les applications tournent.
Un DPU peut décharger le CPU hôte de certaines tâches d’infrastructure. Pensez à une équipe logistique qui s’occupe des livraisons, des contrôles d’accès et des mouvements de stock pour que les personnes qui préparent les commandes puissent se concentrer sur leur travail.
Usages courants : réseau des centres de données, certaines tâches de chiffrement et de sécurité, E/S de stockage, isolation de l’infrastructure et soutien aux grands clusters d’IA.
Point fort : décharge les opérations d’infrastructure de soutien. Limite : ce n’est normalement pas le processeur qui effectue les calculs principaux du modèle d’IA. La documentation de la plateforme BlueField de NVIDIA en fournit un exemple de mise en œuvre.
Les six en un coup d’œil
| Processeur | Rôle principal | Où le rencontrer | Rôle dans l’IA |
|---|---|---|---|
| CPU | Calcul généraliste | Téléphones, ordinateurs portables, serveurs | Exécute les applications, coordonne les traitements et peut exécuter des modèles |
| GPU | Calcul parallèle | PC, stations de travail, serveurs d’IA | Entraînement et inférence |
| TPU | Calcul spécialisé pour l’apprentissage automatique | Infrastructure de Google et Google Cloud | Entraînement et inférence |
| NPU | Accélération efficace des réseaux de neurones | Téléphones, ordinateurs portables, appareils connectés | IA sur l’appareil prise en charge |
| LPU | Exécution d’inférence spécialisée de Groq | Infrastructure d’inférence d’IA | Service de modèles à faible latence pris en charge |
| DPU | Déchargement du réseau, du stockage et de la sécurité | Centres de données et grands serveurs | Soutient l’infrastructure autour des charges de travail d’IA |
Ces appellations ne sont pas toutes du même ordre. CPU, GPU, NPU et DPU désignent de grandes catégories. TPU est la famille de processeurs de Google, et LPU relève de la terminologie de Groq. D’autres accélérateurs d’IA existent aussi, dont AWS Trainium. Ce tableau est une introduction, pas un catalogue exhaustif.
Leur place dans la technologie du quotidien
Sur un smartphone : un CPU gère le travail applicatif courant, un GPU s’occupe du graphisme et des calculs compatibles, et un NPU ou un accélérateur neuronal similaire peut exécuter les fonctions d’IA prises en charge. Tous les téléphones n’ont pas les mêmes composants ni les mêmes capacités.
Sur un ordinateur portable ou de bureau : le CPU fait tourner le système d’exploitation et les applications. Un GPU accélère le graphisme et, quand cela s’y prête, les modèles d’IA. Certains ordinateurs portables récents intègrent des NPU pour des fonctions d’IA en local.
Dans un service d’IA cloud : les CPU gèrent les applications et les requêtes des utilisateurs. Des GPU, des TPU, des LPU ou d’autres accélérateurs pris en charge peuvent exécuter le modèle. À grande échelle, des DPU peuvent prendre en charge une partie du travail réseau, de sécurité ou de stockage autour des serveurs.
Texte alternatif accessible pour cette figure
La figure 1 présente trois groupes de rôles de processeurs. Les groupes se recoupent : il ne s’agit donc pas du schéma d’un système unique qui contiendrait tous les processeurs.
Appareils et applications, usage quotidien : CPU, GPU et NPU. Applications, graphisme et IA locale prise en charge.
Exécution des modèles d’IA, entraînement et/ou inférence : GPU, TPU et LPU. Choisir un matériel compatible avec le modèle et la charge de travail.
Infrastructure, soutien aux grands systèmes : CPU et DPU. Gestion des serveurs, réseau, sécurité et stockage.
Le CPU figure dans le groupe des appareils et dans celui de l’infrastructure. Le GPU figure dans le groupe des appareils et dans celui de l’exécution des modèles d’IA.
Chaque processeur est accompagné d’un court libellé de rôle : CPU, travail général ; GPU, calcul parallèle ; TPU, calcul tensoriel ; NPU, IA en local ; LPU, inférence planifiée ; DPU, déchargement réseau et stockage.
Les catégories sont indicatives. Le choix exact des processeurs dépend de l’appareil et du déploiement.
Comment les différents processeurs travaillent ensemble
Oui. Imaginez que vous demandiez à un assistant d’IA dans le cloud de résumer un document.
Votre appareil exécute l’application. Un serveur dans le cloud reçoit la requête, vérifie les permissions et prépare les informations. Un accélérateur compatible effectue les calculs du modèle. Le serveur renvoie ensuite le résultat.
Un déploiement de grande taille peut aussi utiliser des processeurs d’infrastructure pour certaines tâches réseau ou de sécurité. Les fonctions d’IA locales de votre téléphone ou de votre ordinateur portable peuvent, elles, utiliser un NPU.
Texte alternatif accessible pour cette figure
La figure 2 présente, de façon simplifiée, un exemple possible de requête d’IA.
Étape 1. L’appareil de l’utilisateur exécute l’application sur un CPU. Un GPU ou un NPU local est facultatif. La requête part vers un serveur d’application dans le cloud.
Étape 2. Dans ce serveur d’application, un CPU gère la requête et les permissions. La requête est ensuite transmise à un accélérateur d’IA.
L’accélérateur d’IA est une option compatible choisie parmi GPU, TPU ou LPU. Ce sont des alternatives, et non trois étapes obligatoires.
Étape 3. La réponse générée revient à l’utilisateur.
Soutien facultatif de l’infrastructure : un DPU peut prendre en charge certaines tâches réseau, de stockage et de sécurité autour des serveurs.
L’essentiel à retenir : toutes les applications d’IA n’ont pas besoin des six types de processeurs. Un CPU ordinaire peut suffire pour un petit modèle. Un service d’IA puissant peut combiner de nombreux types de matériel différents.
Quel processeur découvrir en premier
Si vous débutez en informatique, commencez par le CPU et le GPU. Comprendre le calcul généraliste et le calcul parallèle constitue la meilleure base.
Si vous développez des applications mobiles ou embarquées, apprenez quand un logiciel peut utiliser un NPU et quelles sont ses limites. Si vous travaillez sur des modèles d’IA, du déploiement dans le cloud ou de l’apprentissage automatique, familiarisez-vous avec les GPU et les accélérateurs spécialisés comme les TPU. Si vous travaillez dans le réseau ou l’infrastructure des centres de données, les DPU deviennent plus pertinents. Et si vous évaluez des solutions de service de modèles à faible latence, le LPU de Groq est une architecture qui mérite d’être comprise.
Inutile de maîtriser les six noms simplement parce qu’ils reviennent dans les discussions sur l’IA. Apprenez-en assez pour reconnaître ce que fait chacun, puis approfondissez là où votre travail l’exige.
La différence essentielle à retenir
Les CPU sont des processeurs généralistes et polyvalents. Les GPU excellent dans le travail parallèle qui s’y prête. Les TPU de Google accélèrent les calculs d’apprentissage automatique. Les NPU permettent un traitement efficace de l’IA sur les appareils. Les LPU de Groq adoptent une approche spécialisée de l’inférence des modèles. Les DPU déchargent certaines tâches d’infrastructure.
Ces technologies peuvent se compléter, et aucune n’est le choix universel pour toutes les applications.
Le meilleur processeur n’est pas simplement le plus puissant. C’est celui qui convient au travail à accomplir.
Sources et lectures complémentaires
Sources arrêtées au 17 octobre 2026. Chaque source a été ouverte et vérifiée le 17 octobre 2026. Plusieurs sont des documents de fournisseurs : ils décrivent les produits de chacun d’eux et ne constituent pas des comparaisons indépendantes.
- Intel : CPU vs GPU. Introduction au traitement généraliste et au traitement parallèle.
- NVIDIA : CUDA Programming Guide. Le modèle d’exécution des GPU et la programmation parallèle.
- Google Cloud : Introduction to Cloud TPU. Finalité des TPU, charges de travail adaptées et limites.
- Apple : Core ML. Utiliser des modèles d’apprentissage automatique sur le matériel des appareils Apple.
- Groq : What is a Language Processing Unit?. L’explication de son architecture par Groq lui-même. Les affirmations promotionnelles sur les performances ne doivent pas être considérées comme des résultats de tests indépendants.
- NVIDIA : BlueField Networking Platform. Usages des DPU pour le réseau, la sécurité et le stockage.
- AWS : Trainium. Un exemple d’accélérateur d’IA en dehors des six appellations présentées ici.
Sources techniques examinées le 17 octobre 2026. Les capacités des produits évoluent : consultez la documentation en lien pour obtenir les informations à jour.