

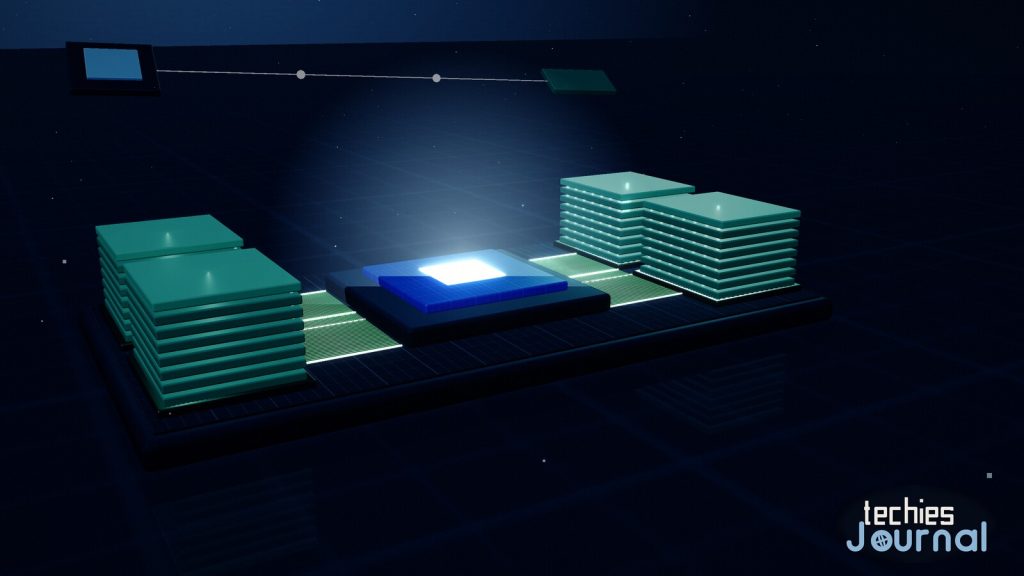
वैचारिक चित्रण: स्टैक की गई मेमोरी तक छोटा, चौड़ा लिंक और दूर रखी मेमोरी तक लंबा, पतला लिंक। डेटा धीरे आए तो तेज़ चिप भी इंतज़ार करती है।
सिर्फ़ तेज़ चिप AI को तेज़ नहीं बनाती
अगर डेटा चिप तक काफ़ी तेज़ी से नहीं पहुँचता, तो तेज़ AI चिप भी AI को तेज़ नहीं बनाती।
चिप सिर्फ़ उसी डेटा पर काम कर सकती है जो उसके पास पहले से है। डेटा धीरे आए तो चिप इंतज़ार करती है। मॉडल जवाब लिखने में जितना समय लगाता है, उसके बड़े हिस्से में सीमा गणना नहीं, यही इंतज़ार होता है।
यह लेख उस मेमोरी के बारे में है जो इस इंतज़ार को कम करने के लिए बनी है। उसे HBM कहते हैं, यानी high bandwidth memory। आप जानेंगे कि वह क्या है, AI उसे इतना क्यों इस्तेमाल करता है, वह कम क्यों पड़ रही है, और AI व आम उपकरणों की लागत पर इसका क्या असर है।
प्रोसेसर के लिए मेमोरी क्या करती है
प्रोसेसर गणनाएँ करता है। मेमोरी वह डेटा रखती है जिस पर वह काम कर रहा है।
मेमोरी को दो संख्याएँ बताती हैं। कैपेसिटी यानी वह कितना रख सकती है। बैंडविड्थ यानी मेमोरी और प्रोसेसर के बीच डेटा कितनी तेज़ी से जा सकता है।
एक रसोइये और एक पैंट्री की कल्पना कीजिए। कैपेसिटी पैंट्री का आकार है। बैंडविड्थ यह है कि रसोइया हर सेकंड काउंटर तक कितनी सामग्री ला सकता है। पैंट्री तक का रास्ता धीमा हो तो बहुत तेज़ रसोइया भी दिन का ज़्यादातर समय इंतज़ार में बिताता है।
HBM क्या है
HBM उसी बुनियादी तकनीक से बनती है जिससे आम कंप्यूटर मेमोरी बनती है, जिसे DRAM कहते हैं। फ़र्क़ इसमें है कि उसे कैसे जोड़ा गया है। कई मेमोरी चिप इमारत की मंज़िलों की तरह एक के ऊपर एक रखी जाती हैं और through-silicon vias नाम के छोटे खड़े कनेक्शनों से जोड़ी जाती हैं। इस स्टैक को उसी पैकेज के अंदर, साझा आधार पर, प्रोसेसर के ठीक बगल में रखा जाता है।
इस बनावट के दो फ़ायदे हैं। मेमोरी और प्रोसेसर के बीच की दूरी बहुत कम होती है। और उनके बीच का लिंक बहुत चौड़ा होता है, यानी कई बिट एक साथ चल सकते हैं।
नवीनतम पीढ़ी का मानक HBM4, JEDEC की April 2025 की घोषणा के अनुसार, हर स्टैक के लिए 2,048-bit इंटरफ़ेस और 2 terabytes प्रति सेकंड तक की गति बताता है। तुलना के लिए, हाई-एंड ग्राफ़िक्स कार्ड अपनी मेमोरी के लिए 512-bit इंटरफ़ेस इस्तेमाल कर सकता है।
इस चित्र का सुलभ टेक्स्ट विकल्प
दो बनावटों की तुलना। पहली में, साझा आधार के बीच में प्रोसेसर है और दोनों तरफ़ चार मेमोरी परतों वाला HBM स्टैक है, जो छोटे, बहुत चौड़े लिंक से जुड़े हैं। HBM4 हर स्टैक पर 2,048 bits इस्तेमाल करता है।
दूसरी में, प्रोसेसर सर्किट बोर्ड के एक सिरे पर और मेमोरी चिप दूसरे सिरे पर हैं, जो लंबे, संकरे लिंक से जुड़ी हैं। हाई-एंड ग्राफ़िक्स कार्ड 512 bits इस्तेमाल कर सकता है।
इस डिज़ाइन की कीमत जटिलता है। स्टैकिंग को अच्छी तरह करना कठिन है, और interposer नाम का साझा आधार नतीजे को सर्किट बोर्ड पर लगी आम मेमोरी से महँगा बना देता है।
आधुनिक AI चिप कई स्टैक रखती है। NVIDIA अपनी H100 data-center चिप को 80 GB मेमोरी और 3.35 terabytes प्रति सेकंड बैंडविड्थ के साथ सूचीबद्ध करती है। AMD अपनी MI455X को 12 स्टैक में 432 GB HBM4 के साथ, और उनमें से 72 वाले एक rack को कुल 31 terabytes HBM4 के साथ सूचीबद्ध करती है। ये विक्रेताओं के आँकड़े हैं, इसलिए इन्हें हर कंपनी के अपने उत्पाद के बारे में दावे की तरह पढ़ें।
AI को इतनी मेमोरी क्यों चाहिए
जब AI मॉडल जवाब लिखता है, तो वह एक बार में टेक्स्ट का एक टुकड़ा बनाता है, जिसे token कहते हैं। हर token के लिए चिप को मेमोरी से मॉडल की संग्रहीत संख्याएँ पढ़नी पड़ती हैं, जिन्हें weights कहते हैं। वह अब तक की बातचीत का चलता हुआ रिकॉर्ड भी पढ़ती है, जिसे KV cache कहते हैं। हमने KV cache को खुद ओपन AI मॉडल चलाना: इसके लिए असल में क्या चाहिए में समझाया था।
inference पर एक शोध preprint इस चरण को “strictly bandwidth-bound” बताता है, यानी रफ़्तार मेमोरी की गति तय करती है। वही पेपर पाता है कि HBM कैपेसिटी तय करती है कि एक चिप एक साथ कितने उपयोगकर्ताओं को सेवा दे सकती है, और बैंडविड्थ तय करती है कि हर जवाब कितनी जल्दी आता है।
वह एक उदाहरण देता है: हर एक में 10,000 reasoning tokens वाले 128 requests को सेवा देने के लिए सिर्फ़ cache के लिए 1.3 terabytes से ज़्यादा मेमोरी चाहिए। यह एक preprint है, और इसके चार लेखकों में से दो मेमोरी निर्माता Micron में काम करते हैं, इसलिए इसे जानकारीपूर्ण पर पूरी तरह स्वतंत्र नहीं मानकर पढ़ें। लेखक ध्यान दिलाते हैं कि कई विशेषज्ञ हिस्सों से बने बहुत बड़े मॉडल मेमोरी की गति के बजाय routing से सीमित हो सकते हैं। इसलिए मेमोरी एक बड़ी सीमा है, लेकिन अकेली नहीं।
पैमाना दिखाने के लिए एक सीधा हिसाब। 70 billion weights वाला मॉडल, जिसमें हर weight दो bytes में रखा गया हो, सिर्फ़ weights के लिए लगभग 140 GB माँगता है। यह हमारा अपना गणित है, और KV cache गिनने से पहले ही यह H100 के 80 GB में नहीं समाता। बड़े मॉडल और लंबी बातचीत ज़रूरत को और बढ़ाते हैं।
इसी दबाव को हमने लागत की तरफ़ से AI Inference हमारे load balancing सोचने के तरीके को क्यों बदल रहा है में, और दक्षता की तरफ़ से Microsoft Maia 300: AI को कुशलता से चलाना अब बेहतर मॉडल बनाने जितना ही अहम क्यों होता जा रहा है में देखा था।
यह पर्याप्त क्यों नहीं है
चार बातें मिलकर काम करती हैं, और वे एक-दूसरे को मज़बूत करती हैं।
- गिने-चुने निर्माता। HBM की आपूर्ति तीन कंपनियों में केंद्रित है: SK hynix, Micron और Samsung। हमारी राय में, किसी नए खिलाड़ी को पकड़ बनाने में सालों लगेंगे।
- बनाना कठिन। चिप को स्टैक करना, जोड़ना और फिर प्रोसेसर के बगल में पैकेज करना विशेष चरण माँगता है। Micron के मुख्य परिचालन अधिकारी ने कहा कि भविष्य की अधिक जटिल HBM में “trade ratios” ज़्यादा हैं, यानी हर बिट के लिए ज़्यादा फ़ैक्टरी क्षमता लगती है, और यह आपूर्ति को सीमित करेगा। TSMC के CEO ने अपनी earnings call में कहा कि कंपनी के पास “a big shortage on the back end” है, यानी पैकेजिंग चरण में।
- माँग तेज़ी से बढ़ रही है। हर AI rack को बहुत HBM चाहिए, और बन रहे racks की संख्या बढ़ रही है।
- नई क्षमता धीमी है। Micron की योजनाएँ, उसकी earnings call के सार के अनुसार, अपनी पहली नई Idaho fab से उत्पादन mid-2027 में, और आगे की fabs से 2028 और 2030 में रखती हैं। ये तारीख़ें हमने call में स्वयं नहीं पढ़ीं।
इस महीने के नतीजे क्या दिखाते हैं
दो कंपनियों ने नतीजे बताए, जो श्रृंखला के दोनों सिरों की झलक देते हैं। नीचे के आँकड़े, जहाँ चिह्नित नहीं हैं, उनकी अपनी filings से हैं।
| कंपनी | क्या बताया | यह क्या जोड़ता है |
|---|---|---|
| TSMC (चिप निर्माता, 15 October) | राजस्व NT$1,494.24 billion, साल भर पहले से 50.9 percent ज़्यादा। शुद्ध आय NT$763.06 billion, 68.7 percent ज़्यादा। इसकी नवीनतम 2nm प्रक्रिया wafer राजस्व का 8 percent थी। | CEO C.C. Wei ने कहा कि माँग आपूर्ति से ज़्यादा है और यह अंतर “still quite big” है। यह उद्धरण तीसरे पक्ष के transcript से है जिसमें कुछ अंश अस्पष्ट हैं। |
| Micron (मेमोरी निर्माता, 30 September) | चौथी तिमाही का राजस्व $54.23 billion और पूरे साल का राजस्व $133.19 billion। अगली तिमाही के लिए $61.5 billion का अनुमान दिया। | इसके मुख्य परिचालन अधिकारी ने कहा “we really don’t have line of sight to when supply and demand balances.” |
| AMD (चिप डिज़ाइनर) | हर MI455X पर 432 GB HBM4 और 72 चिप वाले rack में 31 TB सूचीबद्ध करती है। AMD को अपने Helios rack की volume deployments 2026 की दूसरी छमाही में होने की उम्मीद है। | Samsung ने March 2026 में कहा कि वह MI455X के लिए पसंदीदा HBM4 आपूर्तिकर्ता है। यह Samsung का अपना बयान है। |
यहाँ एक सावधानी मायने रखती है। आपूर्ति तंग होने की बात वही कंपनियाँ कह रही हैं जो उसे बेचती हैं, और तंग आपूर्ति उनके दामों को फ़ायदा देती है।
Micron ने अपनी अगली तिमाही के लिए लगभग 86 percent gross margin का अनुमान दिया, जो दिखाता है कि उसकी स्थिति कितनी मज़बूत है। अनुमानों को जानकारीपूर्ण पर स्वार्थ वाले मानकर चलें।
इनके साथ दो और नज़रिए रखने लायक हैं। स्वतंत्र शोध फ़र्म TrendForce 16 October के bulletin में कहती है कि HBM 2028 तक कम आपूर्ति में रहेगी। वह bulletin एक पेड रिपोर्ट का सार है, इसलिए हम उसके आँकड़े नहीं पढ़ सके।
SK hynix का अपना outlook बताता है कि कुछ शोधकर्ताओं को उम्मीद है कि क्षमता बढ़ने पर 2026 के बाद HBM के दाम सुधरेंगे। आपूर्ति का कम होना और दामों का ऊँचा बने रहना एक ही दावा नहीं हैं।
यह आम उपकरणों तक क्यों पहुँचता है
TrendForce के अनुसार, HBM और आम मेमोरी एक ही सीमित चिप-निर्माण क्षमता पर निर्भर हैं। जब निर्माता उसका ज़्यादा हिस्सा HBM को देते हैं, तो laptops और फ़ोन की मेमोरी के लिए कम बचता है। स्वतंत्र शोध फ़र्म TrendForce ने 30 September को अनुमान लगाया कि 2026 की आख़िरी तिमाही में conventional DRAM contract दाम एक तिमाही से अगली तिमाही में 10 से 15 percent बढ़ेंगे।
उसने यह भी बताया कि ऊँची मेमोरी लागत notebook बिक्री पर दबाव डाल रही है, कुछ PC ब्रांड mainstream मॉडलों में SSD का आकार घटा रहे हैं, और स्मार्टफ़ोन उत्पादन रुका हुआ है। Micron के COO ने कहा कि कंपनी ने mobile और client ग्राहकों को भेजे गए memory bits में क्रमिक गिरावट देखी।
इसमें से कितना HBM की वजह से है, TrendForce उसकी कोई संख्या नहीं देती। इसलिए संबंध वास्तविक है, लेकिन उसका आकार ज्ञात नहीं।
हमें cloud AI सेवाओं में HBM से आई कोई पुष्ट दाम बढ़ोतरी नहीं मिली। अगर आप AI घंटे के हिसाब से या token के हिसाब से ख़रीदते हैं, तो मेमोरी की लागत को आज के तथ्य की तरह नहीं, बल्कि योजना बनाने लायक जोखिम की तरह लें। इसी कहानी के बिजली वाले पक्ष के लिए AI के पास पैसा और चिप्स हैं। बिजली असली बाधा क्यों बनती जा रही है देखें।
इसे कितनी गहराई तक सीखें
जानें: AI के आसपास काम करने वाले लगभग सभी को इतना जानना चाहिए। HBM प्रोसेसर के बगल में स्टैक की गई मेमोरी है, AI उसे लगातार पढ़ता है, और आपूर्ति सीमित है। यह समझाता है कि AI हार्डवेयर महँगा क्यों है और GPU का चुनाव जितना गति का है उतना ही मेमोरी का भी।
इस्तेमाल करें: AI workloads का आकार तय करने वाले इंजीनियरों को अंदाज़ा लगाना आना चाहिए कि एक मॉडल और उसकी बातचीतों को कितनी मेमोरी चाहिए, और उसकी तुलना उपलब्ध चिपों की मेमोरी और बैंडविड्थ से करनी आनी चाहिए। चिप के प्रकारों की व्यापक तस्वीर के लिए CPU vs GPU vs TPU vs NPU vs LPU vs DPU: अंतर क्या है और इनका उपयोग कब होता है? देखें।
महारत हासिल करें: हार्डवेयर और इन्फ्रास्ट्रक्चर आर्किटेक्ट्स को ब्योरा चाहिए। इसमें शामिल है कि स्टैक कैसे बनते और पैकेज होते हैं, अलग-अलग workloads मेमोरी का इस्तेमाल कैसे करते हैं, और कई सालों की ख़रीद में आपूर्ति के जोखिम की योजना कैसे बनाएँ।
अभी जो छोड़ सकते हैं
HBM की पीढ़ियों के नाम, गति ग्रेड या बाज़ार हिस्सेदारी की तालिकाएँ याद करने की ज़रूरत नहीं। वे हर साल बदलती हैं, और हमें मिले हिस्सेदारी के आँकड़े एक साल से ज़्यादा पुराने थे।
सोशल मीडिया पर घूमते एक-स्रोत वाले दामों के उछाल को नज़रअंदाज़ करें, क्योंकि हम उन्हें पुष्ट नहीं कर सके। हर earnings आँकड़े का पीछा करने की भी ज़रूरत नहीं। टिकने वाला विचार यह है कि डेटा को ले जाना भी AI को उतना ही सीमित कर सकता है जितना गणना करना।
एक व्यावहारिक अगला क़दम
कोई एक AI मॉडल चुनें जिसे आप इस्तेमाल करते हैं या करने की योजना रखते हैं, और तीन संख्याएँ लिखें: उसके weights का आकार, लंबी बातचीत कितनी मेमोरी जोड़ती है, और उसे चलाने वाली चिप की मेमोरी कैपेसिटी व बैंडविड्थ। अगर पहली दो तीसरी के अंदर आराम से नहीं समातीं, तो आपकी सीमा मेमोरी है, और तेज़ चिप उसे ठीक नहीं करेगी।
और गहराई में
- Micron fiscal fourth quarter 2026 press release राजस्व, अनुमान और margin के लिए।
- TSMC third quarter 2026 Form 6-K राजस्व, आय और प्रक्रिया मिश्रण के लिए।
- AMD Instinct MI400 series MI455X के मेमोरी आँकड़ों के लिए।
- NVIDIA H100 उसकी मेमोरी कैपेसिटी और बैंडविड्थ के लिए।
- Understanding Inference Scaling for LLMs यह समझने के लिए कि inference मेमोरी से क्यों सीमित है।
- SK hynix 2026 market outlook एक मेमोरी निर्माता का अपना नज़रिया, उसके बताए जोखिमों समेत।
- TrendForce 4Q26 memory price forecast, via I-Connect007 आम उपकरणों पर असर के लिए।
- JEDEC HBM4 announcement, as republished by Storage Newsletter मानक की इंटरफ़ेस चौड़ाई, गति और स्टैक आकार के लिए।
- TrendForce HBM market bulletin, 16 October 2026 2028 तक स्वतंत्र आपूर्ति अनुमान के लिए।
- High Bandwidth Memory on Wikipedia HBM कैसे बनती है, इसके सामान्य संदर्भ के लिए।
इस लेख के आँकड़े 18 और 19 October 2026 को जाँचे गए थे। earnings आँकड़े और दामों के अनुमान बदलते हैं, इसलिए भरोसा करने से पहले ऊपर के स्रोत देख लें।