

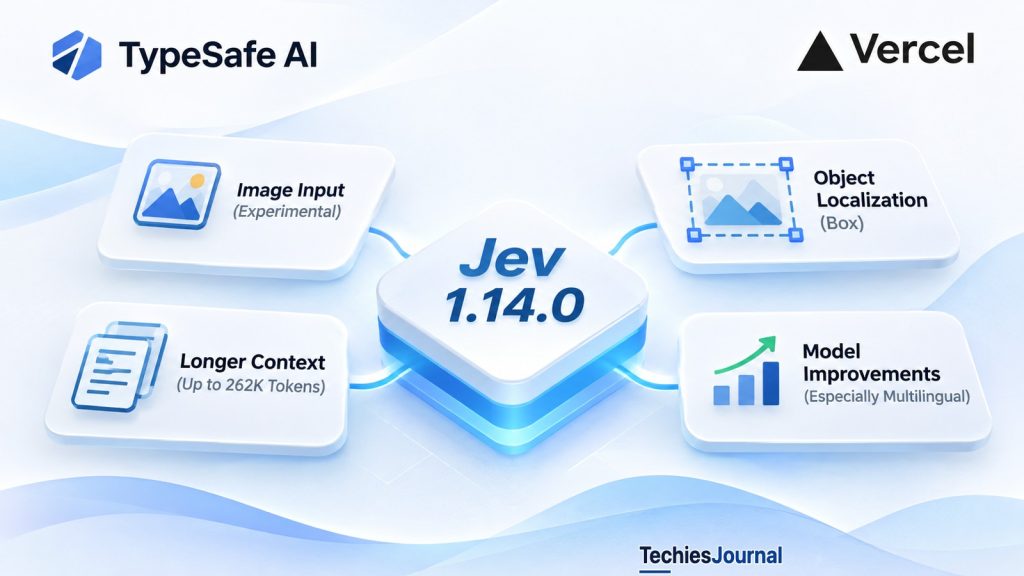
La dernière version de TypeSafe AI améliore son modèle orienté décision et introduit, à titre expérimental, le traitement d’images, la localisation d’objets et un contexte plus long. Voici ce que les développeurs doivent comprendre avant d’adopter cette mise à jour.
Un client envoie à un commerçant en ligne la photo d’un ordinateur portable endommagé. Le système de support doit déterminer si un dommage est visible, identifier la zone touchée et transmettre la demande à l’équipe compétente.
Un modèle orienté décision offre une façon de traiter ce flux de travail : au lieu de produire une longue description que le code applicatif devra interpréter, il répond à des questions précises au moyen de sorties structurées.
Le 14 octobre 2026, TypeSafe AI a publié Jev 1.14.0, une mise à jour incrémentale accompagnée de capacités expérimentales de traitement d’images, d’un nouveau type de question pour les cadres de délimitation (bounding boxes) et de limites de contexte plus élevées. L’entreprise annonce aussi des progrès de qualité du modèle, en particulier pour les tâches multilingues.
L’intérêt de cette version ne tient pas à une nouvelle architecture de prise de décision. Il tient à l’élargissement des informations que Jev peut examiner et des types de réponses qu’il peut produire.
Qu’est-ce qui change dans Jev 1.14.0 ?
Jev est un modèle d’IA orienté décision développé par TypeSafe AI. Une application fournit des informations sur une situation et pose des questions prédéfinies. Le modèle renvoie des réponses structurées et des probabilités plutôt que du texte conversationnel.
Notre précédent article de TechiesJournal, Jev expliqué : pourquoi ce modèle d’IA prend des décisions au lieu de rédiger des réponses (en anglais), examine cette architecture et ses applications pratiques.
La version 1.14.0 s’appuie sur ces fondations.
TypeSafe s’attend à ce que la plupart des aspects ne soient que légèrement meilleurs que dans la version 1.13.0, le gain le plus important étant attendu pour la prise en charge multilingue. Dans le même temps, l’entreprise ouvre à l’expérimentation des capacités jusque-là restreintes.
La distinction compte, car certaines fonctionnalités annoncées en même temps que la version 1.14.0 fonctionnent aussi avec le modèle précédent.
| Capacité | Statut dans Jev 1.14.0 |
|---|---|
| Qualité du modèle | Améliorations incrémentales revendiquées par TypeSafe, en particulier pour les tâches multilingues |
| Entrée d’images | Expérimentale. Également disponible avec Jev 1.13.0 |
Type de question box | Nouveau dans Jev 1.14.0. Expérimental |
| Contexte plus long | Limites expérimentales de 262K jetons. Pris en charge par les versions 1.13.0 et 1.14.0 |
| Accès au modèle | Disponible via l’API de TypeSafe et Vercel AI Gateway |
L’interface standard du modèle reste textuelle. L’entrée d’images et le contexte plus long sont des capacités expérimentales activées séparément, et non des fonctionnalités de production par défaut.
TypeSafe appelle ces fonctionnalités expérimentales sa danger zone (« zone de danger »). L’entreprise les a rendues accessibles pour le développement et l’exploration, tout en indiquant qu’elles n’atteignent pas encore le niveau de fiabilité qu’elle attend pour un usage en production.
Il y a donc deux raisons distinctes d’examiner cette version : évaluer si le modèle mis à jour améliore les applications existantes, et expérimenter des capacités qui n’étaient pas disponibles auparavant via l’interface prise en charge.
La prise en charge des images étend les décisions structurées aux applications visuelles
La conception établie de Jev permet aux applications de soumettre des informations sous forme d’état (state) et de poser des questions à leur sujet. La prise en charge expérimentale des images prolonge cette approche en permettant à un contenu visuel de figurer dans la même requête.
TypeSafe utilise un mécanisme assets pour référencer des images dans l’état de l’application, dans les instructions des questions ou dans les critères d’évaluation. Une application peut ainsi combiner du texte, des informations métier structurées et des photos pour formuler une décision.
Reprenons l’exemple de l’ordinateur portable endommagé.
Le système de support reçoit un message du client et une image. Il pourrait demander si la photo montre un écran endommagé et quelle catégorie décrit le mieux le problème.
Au lieu de rédiger un paragraphe sur la photo, Jev peut répondre aux questions prédéfinies sous des formes que l’application de support sait déjà exploiter.
Cela peut être utile pour les flux de retour de produits, l’inspection de documents, les rapports de maintenance et d’autres applications où des éléments visuels contribuent à une décision de classification ou d’acheminement.
Le traitement des images est désactivé par défaut. Avec l’API directe de TypeSafe, les développeurs l’activent en envoyant :
TypeSafe-Danger-Zone-Images: true
Selon la documentation de TypeSafe, les questions box sont elles aussi désactivées par défaut et nécessitent le même en-tête dans toute requête qui en contient une.
La documentation officielle sur les images décrit les structures de requête prises en charge, les références d’images et les limites de la phase expérimentale.
Le nouveau type de question box
L’ajout le plus marquant de Jev 1.14.0 est box, un type de question conçu pour localiser un objet dans une image.
Les types de questions existants de Jev portent pour l’essentiel sur la classification, la notation et l’évaluation de conditions. Une réponse box décrit, elle, une région d’une image.
Sa réponse comprend quatre coordonnées normalisées, top, bottom, left et right, ainsi qu’une valeur confidence comprise entre zéro et un.
Les coordonnées décrivent un rectangle relatif aux dimensions de l’image. Une application peut convertir ces valeurs en positions en pixels pour mettre en évidence ou recadrer la zone identifiée.
Par exemple, une réponse box pourrait avoir la structure suivante :
{
  "type": "box",
  "box": {
    "top": 0.25,
    "bottom": 0.82,
    "left": 0.44,
    "right": 0.84
  },
  "confidence": 0.92
}
Réponse donnée à titre d’illustration, adaptée de l’exemple de réponse complète publié dans la documentation Box de TypeSafe. Dans cette réponse, la réponse se trouve dans la table answers, sous une clé portant le nom de la question, à côté du nom du modèle et des informations d’utilisation. Ces valeurs proviennent de l’exemple de TypeSafe : elles ne correspondent ni à un test indépendant de TechiesJournal ni à un résultat pour le scénario de l’ordinateur portable.
Le champ confidence représente la confiance que le modèle déclare dans sa localisation. Il ne faut pas l’interpréter comme une probabilité de 92 %, vérifiée de façon indépendante, que l’objet ait été correctement localisé. Les développeurs doivent mesurer la précision de la localisation et le comportement de la confiance sur des images représentatives avant de choisir des seuils pour leurs applications.
Il existe aussi une contrainte propre à l’API.
Une question box renvoie toujours un cadre. Elle ne prévoit aucun résultat distinct non trouvé, même lorsque l’objet demandé est absent.
TypeSafe recommande de l’associer à une question Noul qui évalue si l’objet est présent. L’application peut alors ignorer les coordonnées lorsque le résultat de présence ne justifie pas de les utiliser.
Pour l’application de support des ordinateurs portables, cela revient à demander si une fissure est visible avant de se fier aux coordonnées censées la localiser.
Les deux résultats ont des rôles différents : l’un évalue la présence, l’autre identifie un emplacement. Aucun des deux, à lui seul, ne constitue une preuve visuelle vérifiée de façon indépendante.
La documentation de TypeSafe sur box explique le format de réponse, le traitement de la confiance et les modèles de questions recommandés.
Pour les développeurs, ce nouveau type apporte une capacité intéressante qui va au-delà de la classification. Il permet à Jev de fournir des informations spatiales exploitables par les interfaces et les systèmes de traitement en aval, même si son statut expérimental limite pour l’instant son adéquation aux flux de production sans supervision.
Un contexte plus long augmente la capacité d’entrée, avec des compromis mesurables
TypeSafe a également introduit une option expérimentale pour les entrées plus volumineuses.
Avec les paramètres normaux, Jev accepte au maximum 64 000 jetons par requête et 32 000 jetons par question. Lorsque le contexte long est activé, ces deux limites passent à 262 000 jetons.
Cette capacité fonctionne avec Jev 1.13.0 et 1.14.0.
Cette fenêtre plus large pourrait aider les applications à examiner de longs contrats, des journaux (logs) d’exploitation ou des dossiers volumineux dans lesquels les informations pertinentes sont réparties sur plusieurs sections.
Par exemple, une application d’analyse de contrats pourrait demander si un long accord autorise une résiliation anticipée dans des conditions précises.
Pouvoir soumettre le document complet simplifie une partie de ce flux de travail. Cela ne rend pas nécessairement la décision obtenue plus exacte.
TypeSafe indique explicitement que le traitement en contexte long est plus lent et moins précis que le fonctionnement dans les limites par défaut.
Cela impose un choix d’architecture : soumettre l’intégralité des sources, ou commencer par récupérer les sections les plus pertinentes pour la question.
La seconde approche peut être préférable lorsqu’une application sait identifier de façon fiable les éléments nécessaires à sa décision.
Le contexte long s’active avec :
TypeSafe-Danger-Zone-Long-Context: true
TypeSafe applique le même tarif par jeton d’entrée, que l’option de contexte long soit activée ou non. Une requête plus volumineuse peut néanmoins coûter plus cher, puisqu’elle traite davantage de jetons.
La documentation des modèles décrit ces limites et le comportement qui leur est associé.
Ensemble, le traitement des images, les réponses spatiales et le contexte élargi étendent la gamme des entrées et des sorties que Jev peut traiter. Ils rendent aussi l’évaluation plus dépendante de la charge de travail réelle de l’application.
Ce que les applications Jev existantes doivent prendre en compte
Pour les développeurs qui utilisent déjà Jev, les améliorations de qualité du modèle peuvent être plus immédiatement pertinentes que les fonctionnalités expérimentales.
TypeSafe s’attend à ce que Jev 1.14.0 soit un peu plus performant sur l’ensemble des tâches, la plus forte amélioration portant sur la prise en charge multilingue.
Il s’agit d’attentes annoncées par l’éditeur, et non de la preuve que chaque application obtiendra de meilleurs résultats. TypeSafe reconnaît aussi les limites de ses propres évaluations internes et conseille aux développeurs de donner la priorité à leurs propres tests.
Les applications qui gèrent plusieurs langues devraient comparer les deux versions sur des exemples représentatifs, proches de la production, en particulier lorsque des erreurs de classification ont des conséquences opérationnelles.
Un second point mérite attention : la gestion des versions du modèle.
TypeSafe prend en charge des identifiants de modèle fixes en plus d’alias mobiles.
| Intégration | Identifiant du modèle |
|---|---|
| API directe de TypeSafe | jev-1.14.0 |
| Vercel AI Gateway | typesafe-ai/jev-1.14.0 |
Ces identifiants désignent la même version de Jev à travers des interfaces d’intégration différentes. Les développeurs doivent respecter le format de requête et les exigences d’authentification de la plateforme qu’ils utilisent.
Vercel a annoncé son intégration de Jev 1.14.0 le 15 octobre 2026. Son annonce concernant AI Gateway comprend un exemple qui utilise l’interface de décision expérimentale de l’AI SDK.
TypeSafe propose aussi des alias comme jev-latest et jev-preview.
Lors de la revue des sources du 31 octobre, sa documentation indiquait que ces deux alias pointaient vers Jev 1.14.0. Contrairement à un identifiant de version fixe, un alias peut changer de cible lorsqu’une nouvelle version devient disponible.
Cette distinction compte pour les applications dont le comportement dépend des jugements du modèle.
Une application d’acheminement du support pourrait se mettre à classer différemment certains cas limites après le changement d’un alias, même si elle n’a pas été redéployée. Les nouveaux résultats pourraient représenter des améliorations, des régressions ou des différences acceptables.
Utiliser un identifiant de modèle fixe permet d’évaluer plus facilement les changements avant de les promouvoir. TypeSafe renvoie aussi la version du modèle effectivement utilisée dans sa réponse d’API, ce qui permet aux applications d’enregistrer quelle version a produit chaque décision.
L’annonce de version de TypeSafe indique également l’intention de donner un préavis de 60 jours avant la dépréciation officielle de Jev 1.13.0, et de 30 jours pour Jev 1.14.0, et précise qu’une politique de dépréciation sera publiée d’abord. Les équipes qui figent un identifiant fixe devraient surveiller cet avis.
La gestion des versions n’est donc pas un simple détail d’intégration. Elle fait partie du maintien d’un comportement prévisible dans les logiciels qui s’appuient sur des jugements produits par un modèle.
Comment les développeurs devraient évaluer cette version
Le test le plus utile consiste à comparer la version aux exigences établies de l’application.
Pour une intégration textuelle existante, cela signifie exécuter Jev 1.13.0 et 1.14.0 sur les mêmes entrées représentatives, avec des résultats attendus déterminés indépendamment de l’un et l’autre modèle.
Les résultats devraient montrer si les améliorations sont significatives pour les classifications, les langues et les conditions métier que l’application rencontre réellement.
Les flux expérimentaux fondés sur les images exigent des cas supplémentaires.
Dans l’exemple de l’ordinateur portable endommagé, n’évaluer que des photos montrant des fissures évidentes en dirait peu sur la fiabilité. Un jeu de données plus instructif inclurait des dommages subtils, des écrans intacts, des reflets, un mauvais éclairage, des défauts partiellement masqués et des cas où l’objet demandé est absent.
L’évaluation devrait mesurer la précision de la classification, les fausses identifications, les défauts manqués, la qualité de la localisation et la relation entre la confiance et l’exactitude réelle.
Pour le contexte long, une comparaison pertinente examinerait si le traitement d’un document complet donne de meilleurs résultats que la fourniture de sections pertinentes soigneusement sélectionnées.
La latence et le coût devraient être mesurés en même temps que la précision, afin de pouvoir mettre les améliorations en regard de leurs conséquences opérationnelles.
Ces tests servent des objectifs différents selon l’application. Un système de support qui recommande une file de revue peut tolérer des erreurs qui seraient inacceptables dans un flux contrôlant des paiements, des accès ou des équipements physiques.
Dans les systèmes aux conséquences plus lourdes, l’application devrait conserver une mise en application indépendante des politiques et toute revue humaine requise par le niveau de risque.
Ce sont des considérations d’architecture plus générales, et non des propriétés propres à Jev 1.14.0. Notre article précédent, L’IA apprend à décider sans parler (en anglais), examine comment Jev et d’autres mécanismes de décision par IA s’intègrent dans l’architecture applicative.
Pour cette version, la tâche immédiate est plus étroite : déterminer si le nouveau modèle ou la capacité expérimentale donne des résultats suffisants pour un cas d’usage clairement défini.
Ce que Jev 1.14.0 révèle de l’orientation des modèles de décision
Jev 1.14.0 est une version incrémentale plutôt qu’un changement fondamental dans le fonctionnement de l’IA orientée décision.
Les améliorations du modèle donnent aux utilisateurs existants une raison de réévaluer les performances, en particulier pour les charges de travail multilingues. Les fonctionnalités expérimentales laissent entrevoir un éventail plus large d’applications portant sur des informations visuelles et volumineuses.
Le type box est le signe le plus clair de cette orientation. Jev ne se contente plus de sélectionner et de noter des résultats : il produit des informations spatiales structurées que les applications peuvent interpréter directement.
Que ces capacités deviennent utiles en production dépendra des progrès de la précision du modèle, de la constance de son comportement et de la fiabilité des flux de travail qui l’entourent.
TypeSafe a choisi de les exposer avant de les déclarer prêtes pour la production. Cela fait de Jev 1.14.0 une version qui mérite d’être examinée, en particulier par les développeurs qui explorent les systèmes de décision visuelle.
Pour les utilisateurs existants, c’est une mise à jour du modèle à évaluer. Pour les développeurs qui travaillent sur des décisions visuelles, c’est l’occasion de prototyper une nouvelle capacité. Cette distinction est plus utile que de considérer toutes les fonctionnalités de la version comme également matures.
Références et lectures complémentaires
- Jev: For the builders AND dreamers, TypeSafe AI, 14 octobre 2026. Annonce officielle de la version : changements du modèle, fonctionnalités expérimentales et limites déclarées.
- TypeSafe Models, TypeSafe AI. Identifiants de modèle, limites de contexte, alias, entrées prises en charge, considérations linguistiques et tarifs.
- Images, TypeSafe AI. Traitement expérimental des images, références d’assets et configuration des requêtes.
- Box, TypeSafe AI. Localisation d’objets, coordonnées normalisées, valeurs de confiance et limite liée aux objets absents.
- TypeSafe AI’s Jev 1.14 is now available on AI Gateway, Vercel, 15 octobre 2026. Identifiant du modèle sur la passerelle et exemples d’intégration.
- Jev Explained: Why This AI Model Makes Decisions Instead of Writing Answers (en anglais), TechiesJournal, 23 septembre 2026. Explication de fond de l’architecture orientée décision de Jev.
- AI Is Learning to Decide Without Talking (en anglais), TechiesJournal, 4 octobre 2026. Contexte d’architecture plus large pour les systèmes de décision par IA.
Revue des sources : 31 octobre 2026. Les attentes de performances sont attribuées à TypeSafe AI. Aucun banc d’essai indépendant du modèle ni aucun test de fiabilité en production n’a été réalisé pour cet article.