

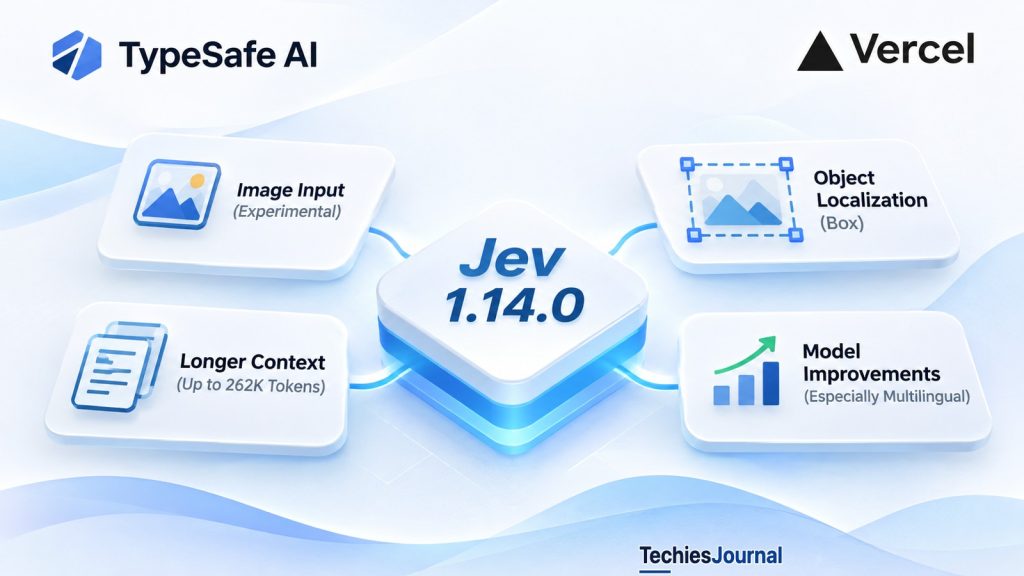
La última versión de TypeSafe AI mejora su modelo orientado a decisiones e introduce, de forma experimental, procesamiento de imágenes, localización de objetos y un contexto más largo. Esto es lo que los desarrolladores necesitan entender antes de adoptar la actualización.
Un cliente envía a una tienda en línea una fotografía de una computadora portátil dañada. El sistema de soporte tiene que determinar si el daño es visible, identificar la zona afectada y dirigir la solicitud al equipo adecuado.
Un modelo orientado a decisiones ofrece una forma de resolver este flujo de trabajo: en lugar de generar una descripción extensa que el código de la aplicación tenga que interpretar, responde a preguntas concretas mediante salidas estructuradas.
El 14 de octubre de 2026, TypeSafe AI publicó Jev 1.14.0, una actualización incremental acompañada de capacidades experimentales de imagen, un nuevo tipo de pregunta de cuadro delimitador (bounding box) y límites de contexto más amplios. La empresa también informa de mejoras en la calidad del modelo, sobre todo en tareas multilingües.
La importancia de esta versión no está en una nueva arquitectura de toma de decisiones, sino en la ampliación de la información que Jev puede examinar y de los tipos de respuesta que puede producir.
¿Qué cambió en Jev 1.14.0?
Jev es un modelo de IA orientado a decisiones desarrollado por TypeSafe AI. Una aplicación aporta información sobre una situación y plantea preguntas predefinidas. El modelo devuelve respuestas estructuradas y probabilidades en lugar de texto conversacional.
Nuestro artículo anterior en TechiesJournal, Jev explicado: por qué este modelo de IA toma decisiones en lugar de redactar respuestas (en inglés), analiza esta arquitectura y sus aplicaciones prácticas.
La versión 1.14.0 se apoya en esa base.
TypeSafe espera que la mayoría de los aspectos sean solo ligeramente mejores que en la 1.13.0, y que la mayor mejora llegue en el soporte multilingüe. Al mismo tiempo, la empresa está abriendo a la experimentación capacidades que antes estaban restringidas.
La distinción importa porque algunas de las funciones anunciadas junto con la 1.14.0 también funcionan con el modelo anterior.
| Capacidad | Estado en Jev 1.14.0 |
|---|---|
| Calidad del modelo | Mejoras incrementales según TypeSafe, sobre todo en tareas multilingües |
| Entrada de imágenes | Experimental. También disponible con Jev 1.13.0 |
Tipo de pregunta box | Nuevo en Jev 1.14.0. Experimental |
| Contexto más largo | Límites experimentales de 262K tokens. Compatible con la 1.13.0 y la 1.14.0 |
| Acceso al modelo | Disponible a través de la API de TypeSafe y de Vercel AI Gateway |
La interfaz estándar del modelo sigue basándose en texto. La entrada de imágenes y el contexto más largo son capacidades experimentales que se activan por separado, no funciones de producción predeterminadas.
TypeSafe llama a estas funciones experimentales su danger zone («zona de peligro»). La empresa las ha puesto a disposición para desarrollo y exploración, aunque afirma que todavía no cumplen sus expectativas de fiabilidad para un uso en producción.
Esto da dos motivos distintos para examinar esta versión: evaluar si el modelo actualizado mejora las aplicaciones existentes y experimentar con capacidades que antes no estaban disponibles a través de la interfaz compatible.
La compatibilidad con imágenes lleva las decisiones estructuradas a las aplicaciones visuales
El diseño establecido de Jev permite que las aplicaciones envíen información como estado y planteen preguntas sobre ella. La compatibilidad experimental con imágenes amplía ese enfoque al permitir que el contenido visual forme parte de la misma solicitud.
TypeSafe usa un mecanismo de assets para hacer referencia a imágenes dentro del estado de la aplicación, de las instrucciones de las preguntas o de los criterios de evaluación. Así, una aplicación puede combinar texto, información de negocio estructurada y fotografías al formular una decisión.
Volvamos al ejemplo de la computadora portátil dañada.
El sistema de soporte recibe un mensaje del cliente y una imagen. Podría preguntar si la fotografía muestra daños en la pantalla y qué categoría describe mejor el problema.
En lugar de generar un párrafo sobre la fotografía, Jev puede responder a las preguntas predefinidas en formatos que la aplicación de soporte ya entiende.
Esto puede resultar útil en flujos de devolución de productos, inspección de documentos, informes de mantenimiento y otras aplicaciones en las que la evidencia visual contribuye a una decisión de clasificación o de enrutamiento.
El procesamiento de imágenes está desactivado de forma predeterminada. Con la API directa de TypeSafe, los desarrolladores lo activan enviando:
TypeSafe-Danger-Zone-Images: true
Según la documentación de TypeSafe, las preguntas box también están desactivadas de forma predeterminada y requieren el mismo encabezado en cualquier solicitud que incluya una.
La documentación oficial sobre imágenes describe las estructuras de solicitud compatibles, las referencias a imágenes y las limitaciones experimentales.
El nuevo tipo de pregunta box
La novedad más característica de Jev 1.14.0 es box, un tipo de pregunta diseñado para localizar un objeto dentro de una imagen.
Los tipos de pregunta existentes de Jev se ocupan sobre todo de clasificar, puntuar y evaluar condiciones. Una respuesta box, en cambio, describe una región de una imagen.
Su respuesta incluye cuatro coordenadas normalizadas, top, bottom, left y right, y un valor de confidence entre cero y uno.
Las coordenadas describen un rectángulo relativo a las dimensiones de la imagen. Una aplicación puede convertir esos valores en posiciones de píxeles para resaltar o recortar la zona identificada.
Por ejemplo, una respuesta box podría tener la siguiente estructura:
{
  "type": "box",
  "box": {
    "top": 0.25,
    "bottom": 0.82,
    "left": 0.44,
    "right": 0.84
  },
  "confidence": 0.92
}
Respuesta ilustrativa adaptada del ejemplo de respuesta completa de la documentación de Box publicada por TypeSafe. En esa respuesta, la contestación se encuentra dentro del mapa answers, bajo una clave con el nombre de la pregunta, junto al nombre del modelo y la información de uso. Estos valores proceden del ejemplo de TypeSafe y no representan una prueba independiente de TechiesJournal ni un resultado para el caso de la computadora portátil.
El campo confidence representa la confianza que el propio modelo declara en su localización. No debe interpretarse como una probabilidad del 92 % verificada de forma independiente de que el objeto se haya localizado correctamente. Los desarrolladores deben medir la precisión de la localización y el comportamiento de la confianza con imágenes representativas antes de elegir los umbrales de sus aplicaciones.
Existe además una restricción concreta de la API.
Una pregunta box siempre devuelve un cuadro. No tiene un resultado aparte de no encontrado, ni siquiera cuando el objeto solicitado no está presente.
TypeSafe recomienda combinarla con una pregunta Noul que evalúe si el objeto está presente. Así, la aplicación puede descartar las coordenadas cuando el resultado de presencia no justifique usarlas.
En la aplicación de soporte para computadoras portátiles, eso significa preguntar si hay una grieta visible antes de confiar en unas coordenadas pensadas para localizarla.
Los dos resultados cumplen funciones distintas: uno evalúa la presencia y el otro identifica una ubicación. Ninguno de ellos constituye por sí solo una evidencia visual verificada de forma independiente.
La documentación de box de TypeSafe explica el formato de respuesta, el tratamiento de la confianza y los patrones de pregunta recomendados.
Para los desarrolladores, el nuevo tipo introduce una capacidad interesante más allá de la clasificación. Permite que Jev aporte información espacial que pueden usar las interfaces y los sistemas de procesamiento posteriores, aunque su carácter experimental limita por ahora su idoneidad para flujos de producción sin supervisión.
Un contexto más largo aumenta la capacidad de entrada, con contrapartidas medibles
TypeSafe también ha introducido una opción experimental para entradas más grandes.
Con la configuración normal, Jev admite un máximo de 64 000 tokens por solicitud y 32 000 tokens por pregunta. Con el contexto largo activado, ambos límites aumentan a 262 000 tokens.
Esta capacidad funciona con Jev 1.13.0 y 1.14.0.
La ventana más amplia podría ayudar a las aplicaciones a examinar contratos extensos, registros (logs) operativos o historiales largos en los que la información relevante está repartida en varias secciones.
Por ejemplo, una aplicación de revisión de contratos podría preguntar si un acuerdo extenso permite la rescisión anticipada en determinadas condiciones.
Poder enviar el documento completo simplifica una parte de ese flujo de trabajo. No hace necesariamente que la decisión resultante sea más precisa.
TypeSafe indica de forma explícita que el procesamiento con contexto largo es más lento y menos preciso que trabajar dentro de los límites predeterminados.
Eso plantea una decisión de arquitectura: enviar el material de origen completo o recuperar primero las secciones más relevantes para la pregunta.
El segundo enfoque puede ser preferible cuando una aplicación es capaz de identificar de forma fiable el material que necesita para su decisión.
El contexto largo se activa mediante:
TypeSafe-Danger-Zone-Long-Context: true
TypeSafe cobra la misma tarifa por token de entrada tanto si la opción de contexto largo está activada como si no. Aun así, una solicitud más grande puede costar más porque procesa más tokens.
La documentación de los modelos describe los límites y el comportamiento asociado a ellos.
En conjunto, el procesamiento de imágenes, las respuestas espaciales y el contexto más amplio extienden la variedad de entradas y salidas que Jev puede manejar. También hacen que la evaluación dependa más de la carga de trabajo real de cada aplicación.
Qué deben tener en cuenta las aplicaciones de Jev existentes
Para los desarrolladores que ya usan Jev, las mejoras en la calidad del modelo pueden ser más relevantes a corto plazo que las funciones experimentales.
TypeSafe espera que Jev 1.14.0 rinda algo mejor en todas las tareas, con la mayor mejora en el soporte multilingüe.
Se trata de expectativas declaradas por el proveedor, no de una prueba de que todas las aplicaciones vayan a obtener mejores resultados. TypeSafe también reconoce limitaciones en sus propias evaluaciones internas y aconseja a los desarrolladores que den prioridad a sus propias pruebas.
Las aplicaciones que manejan varios idiomas deberían comparar las dos versiones con ejemplos representativos y cercanos a producción, sobre todo cuando los errores de clasificación tienen consecuencias operativas.
Hay una segunda consideración: la gestión de versiones del modelo.
TypeSafe admite identificadores de modelo fijos junto con alias móviles.
| Integración | Identificador del modelo |
|---|---|
| API directa de TypeSafe | jev-1.14.0 |
| Vercel AI Gateway | typesafe-ai/jev-1.14.0 |
Los identificadores representan la misma versión de Jev a través de interfaces de integración distintas. Los desarrolladores deben seguir el formato de solicitud y los requisitos de autenticación de la plataforma que usen.
Vercel anunció su integración de Jev 1.14.0 el 15 de octubre de 2026. Su anuncio de AI Gateway incluye un ejemplo que usa la interfaz experimental de decisiones del AI SDK.
TypeSafe también ofrece alias como jev-latest y jev-preview.
En la revisión de fuentes del 31 de octubre, su documentación indicaba que ambos alias apuntaban a Jev 1.14.0. A diferencia de un identificador de versión fijo, un alias puede cambiar cuando se publica una versión posterior.
Esa distinción importa en las aplicaciones cuyo comportamiento depende de los juicios del modelo.
Una aplicación de enrutamiento de soporte podría empezar a clasificar de otra manera algunos casos límite después de que cambie un alias, aunque la aplicación no se haya vuelto a desplegar. Los nuevos resultados podrían ser mejoras, regresiones o diferencias aceptables.
Usar un identificador de modelo fijo facilita evaluar los cambios antes de promoverlos. TypeSafe también devuelve en la respuesta de su API la versión del modelo resuelta, lo que permite a las aplicaciones registrar qué versión produjo cada decisión.
El anuncio de la versión de TypeSafe también expresa la intención de avisar con 60 días de antelación antes de que Jev 1.13.0 quede formalmente obsoleta, y con 30 días en el caso de Jev 1.14.0, y señala que primero publicará una política de obsolescencia. Los equipos que fijen un identificador concreto deberían estar atentos a ese aviso.
Por tanto, la gestión de versiones no es un simple detalle de integración. Forma parte de mantener un comportamiento predecible en un software que depende de juicios generados por un modelo.
Cómo deben evaluar los desarrolladores esta versión
La prueba más útil es una comparación con los requisitos ya establecidos de la aplicación.
En una integración existente basada en texto, eso significa ejecutar Jev 1.13.0 y 1.14.0 con las mismas entradas representativas, con resultados esperados determinados de forma independiente de ambos modelos.
Los resultados deberían mostrar si las mejoras son significativas para las clasificaciones, los idiomas y las condiciones de negocio con los que la aplicación se encuentra realmente.
Los flujos experimentales con imágenes requieren casos adicionales.
En el ejemplo de la computadora portátil dañada, evaluar solo fotografías con grietas evidentes revelaría poco sobre la fiabilidad. Un conjunto de datos más informativo incluiría daños sutiles, pantallas sin daños, reflejos, mala iluminación, defectos parcialmente ocultos y casos en los que falta el objeto solicitado.
La evaluación debería medir la precisión de la clasificación, las identificaciones erróneas, los defectos no detectados, la calidad de la localización y la relación entre la confianza y el acierto real.
En el caso del contexto largo, una comparación significativa examinaría si procesar un documento completo da mejores resultados que aportar secciones relevantes cuidadosamente seleccionadas.
La latencia y el costo deberían medirse junto con la precisión, para poder evaluar las mejoras frente a sus consecuencias operativas.
Estas pruebas cumplen funciones distintas según la aplicación. Un sistema de soporte que recomienda una cola de revisión puede tolerar errores que serían inaceptables en un flujo de trabajo que controla pagos, accesos o equipos físicos.
En los sistemas en los que hay más en juego, la aplicación debería mantener un control independiente del cumplimiento de las políticas y cualquier revisión humana que exija el riesgo.
Se trata de consideraciones de arquitectura más generales, no de propiedades especiales de Jev 1.14.0. Nuestro artículo anterior, La IA está aprendiendo a decidir sin hablar (en inglés), analiza cómo encajan Jev y otros mecanismos de decisión de IA en la arquitectura de las aplicaciones.
Para esta versión, la tarea inmediata es más acotada: determinar si el nuevo modelo o la capacidad experimental funcionan lo bastante bien para un caso de uso claramente definido.
Qué nos dice Jev 1.14.0 sobre la dirección de los modelos de decisión
Jev 1.14.0 es una versión incremental, no un cambio fundamental en el funcionamiento de la IA orientada a decisiones.
Sus mejoras del modelo dan a los usuarios actuales un motivo para volver a evaluar el rendimiento, sobre todo en cargas de trabajo multilingües. Las funciones experimentales apuntan hacia una gama más amplia de aplicaciones con información visual y extensa.
El tipo box es la señal más clara de esa dirección. Jev va más allá de seleccionar y puntuar resultados para producir información espacial estructurada que las aplicaciones pueden interpretar directamente.
Que esas capacidades lleguen a ser útiles en producción dependerá de las mejoras en la precisión del modelo, de un comportamiento coherente y de la fiabilidad de los flujos de trabajo que las rodean.
TypeSafe ha optado por exponerlas antes de declararlas listas para producción. Eso convierte a Jev 1.14.0 en una versión que vale la pena examinar, sobre todo para los desarrolladores que exploran sistemas de decisión visuales.
Para los usuarios actuales, es una actualización del modelo que hay que evaluar. Para los desarrolladores que trabajan con decisiones visuales, es una oportunidad de crear prototipos con una nueva capacidad. Esta distinción es más útil que tratar todas las funciones de la versión como si tuvieran la misma madurez.
Referencias y lecturas adicionales
- Jev: For the builders AND dreamers, TypeSafe AI, 14 de octubre de 2026. Anuncio oficial de la versión: cambios del modelo, funciones experimentales y limitaciones declaradas.
- TypeSafe Models, TypeSafe AI. Identificadores de modelo, límites de contexto, alias, entradas compatibles, consideraciones sobre idiomas y precios.
- Images, TypeSafe AI. Tratamiento experimental de imágenes, referencias a recursos (assets) y configuración de las solicitudes.
- Box, TypeSafe AI. Localización de objetos, coordenadas normalizadas, valores de confianza y la limitación ante objetos ausentes.
- TypeSafe AI’s Jev 1.14 is now available on AI Gateway, Vercel, 15 de octubre de 2026. Identificador del modelo en el gateway y ejemplos de integración.
- Jev Explained: Why This AI Model Makes Decisions Instead of Writing Answers (en inglés), TechiesJournal, 23 de septiembre de 2026. Explicación de base sobre la arquitectura de Jev orientada a decisiones.
- AI Is Learning to Decide Without Talking (en inglés), TechiesJournal, 4 de octubre de 2026. Contexto de arquitectura más amplio sobre los sistemas de decisión de IA.
Revisión de fuentes: 31 de octubre de 2026. Las expectativas de rendimiento se atribuyen a TypeSafe AI. Para este artículo no se realizó ninguna prueba comparativa independiente del modelo ni ninguna prueba de fiabilidad en producción.