

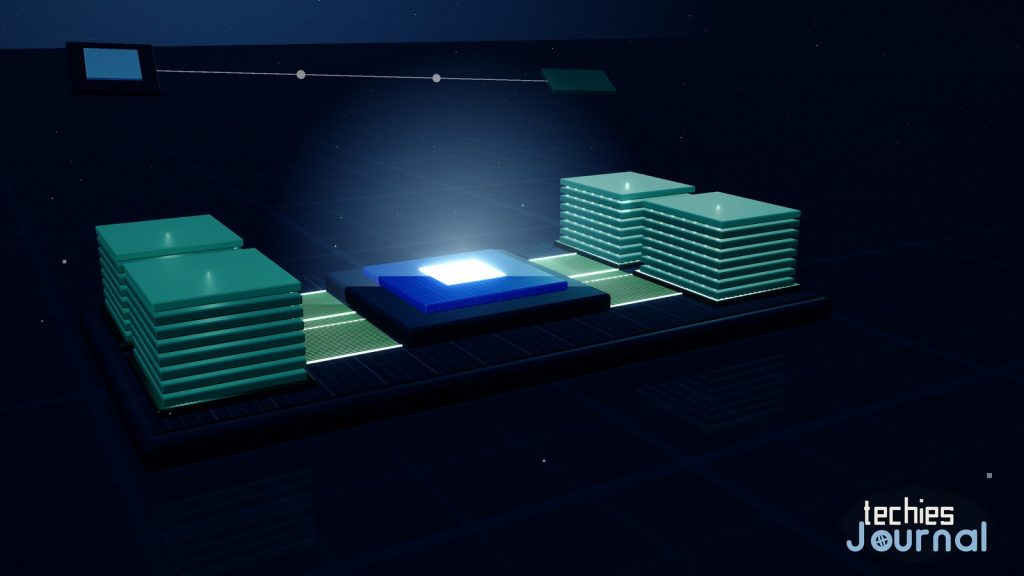
Ilustración conceptual: un enlace corto y ancho hacia una memoria apilada, junto a un enlace largo y estrecho hacia una memoria lejana. Un chip más rápido espera cuando sus datos llegan despacio.
Un chip más rápido no hace más rápida la IA por sí solo
Un chip de IA más rápido no hace más rápida la IA si los datos no llegan al chip con suficiente rapidez.
Un chip solo puede trabajar con los datos que ya tiene. Si los datos llegan despacio, el chip espera. Durante buena parte del tiempo que un modelo dedica a escribir una respuesta, el límite es esa espera, no el cálculo.
Este artículo explica la memoria que se creó para acortar esa espera. Se llama HBM, siglas en inglés de high bandwidth memory (memoria de gran ancho de banda). Al terminar sabrás qué es, por qué la IA usa tanta, por qué no hay suficiente y qué significa eso para el costo de la IA y de los dispositivos de uso cotidiano.
Qué hace la memoria por un procesador
El procesador hace los cálculos. La memoria guarda los datos con los que está trabajando.
Dos cifras describen una memoria. La capacidad es cuánto puede guardar. El ancho de banda es la velocidad a la que los datos pueden moverse entre la memoria y el procesador.
Piensa en un cocinero y una despensa. La capacidad es el tamaño de la despensa. El ancho de banda es cuántos ingredientes puede llevar el cocinero a la mesa de trabajo cada segundo. Un cocinero muy rápido con un camino lento hasta la despensa pasa la mayor parte del día esperando.
Qué es la HBM
La HBM se fabrica con la misma tecnología básica que la memoria habitual de una computadora, llamada DRAM. Lo que cambia es cómo se ensambla. Varios chips de memoria se apilan unos sobre otros, como los pisos de un edificio, y se unen mediante diminutas conexiones verticales llamadas vías a través del silicio (through-silicon vias). Después, esta pila se coloca justo al lado del procesador, sobre una base compartida y dentro del mismo encapsulado.
Esa disposición ofrece dos ventajas. La distancia entre la memoria y el procesador es muy corta. Y el enlace entre ambos es muy ancho, lo que significa que muchos bits pueden moverse al mismo tiempo.
El estándar de la última generación, HBM4, describe una interfaz de 2048 bits y hasta 2 terabytes por segundo por cada pila, según el anuncio del estándar que publicó JEDEC en abril de 2025. Como comparación, una tarjeta gráfica de gama alta puede usar una interfaz de 512 bits con su memoria.
Texto alternativo accesible para esta figura
Comparación de dos disposiciones. En la primera, un procesador ocupa el centro de una base compartida con una pila HBM de cuatro capas de memoria a cada lado, unidas por enlaces cortos y muy anchos. La HBM4 usa 2048 bits por pila.
En la segunda, el procesador está en un extremo de una placa de circuito y los chips de memoria en el otro, unidos por un enlace más largo y más estrecho. Una tarjeta gráfica de gama alta puede usar 512 bits.
El precio de este diseño es la complejidad. El apilamiento es difícil de hacer bien, y la base compartida, llamada interposer, hace que el resultado sea más caro que la memoria convencional montada en una placa de circuito.
Un chip de IA moderno lleva varias pilas. NVIDIA anuncia su chip para centros de datos H100 con 80 GB de memoria y 3.35 terabytes por segundo de ancho de banda. AMD anuncia su MI455X con 432 GB de HBM4 repartidos en 12 pilas, y un rack de 72 de ellos con 31 terabytes de HBM4 en total. Son cifras de los propios fabricantes, así que tómalas como lo que cada empresa afirma de su producto.
Por qué la IA necesita tanta
Cuando un modelo de IA escribe una respuesta, produce un fragmento de texto cada vez, llamado token. Por cada token, el chip tiene que leer de la memoria los números almacenados del modelo, llamados pesos. También lee un registro continuo de la conversación hasta ese momento, llamado caché KV. Explicamos la caché KV en Ejecutar modelos de IA abiertos por tu cuenta (en inglés).
Un preprint de investigación sobre inferencia describe esta etapa como «estrictamente limitada por el ancho de banda», es decir, que la velocidad de la memoria marca el ritmo. El mismo artículo concluye que la capacidad de HBM limita a cuántos usuarios puede atender un chip a la vez, y que el ancho de banda limita la rapidez con la que aparece cada respuesta.
Da un ejemplo: atender 128 solicitudes con 10 000 tokens de razonamiento cada una requiere más de 1.3 terabytes de memoria solo para la caché. Es un preprint, y dos de sus cuatro autores trabajan en Micron, un fabricante de memoria, así que tómalo como un trabajo bien informado pero no del todo independiente. Los autores señalan que los modelos muy grandes formados por muchas partes especializadas pueden estar limitados por el enrutamiento y no por la velocidad de la memoria. Así que la memoria es un límite importante, pero no el único.
Una cuenta sencilla muestra la escala. Un modelo con 70 mil millones de pesos almacenados a dos bytes cada uno necesita unos 140 GB solo para los pesos. Es un cálculo nuestro, y esa cifra ya no cabe en los 80 GB de un H100 antes de contar ninguna caché KV. Los modelos más grandes y las conversaciones más largas elevan todavía más la necesidad.
Analizamos la misma presión desde el lado del costo en por qué la inferencia de IA está cambiando la forma de entender el balanceo de carga (en inglés), y desde el lado de la eficiencia en Microsoft Maia 300 (en inglés).
Por qué no hay suficiente
Se combinan cuatro factores, que se refuerzan entre sí.
- Pocos fabricantes. El suministro de HBM se concentra en tres empresas: SK hynix, Micron y Samsung. En nuestra opinión, un recién llegado necesitaría años para alcanzarlas.
- Difícil de fabricar. Apilar y unir los chips, y luego encapsularlos junto a un procesador, requiere pasos especializados. El director de operaciones de Micron dijo que la HBM futura, más compleja, tiene «trade ratios» más altos, lo que significa que consume más capacidad de fábrica por cada bit, y que esto limitará el suministro. El director ejecutivo de TSMC dijo en su conferencia de resultados que la empresa tiene «una gran escasez en el back end», es decir, en la etapa de encapsulado.
- La demanda crece rápido. Cada rack de IA necesita mucha HBM, y el número de racks que se construyen va en aumento.
- La nueva capacidad llega despacio. Los planes de Micron, según un resumen de su conferencia de resultados, sitúan la producción de su primera fábrica nueva en Idaho a mediados de 2027, con otras fábricas después, en 2028 y 2030. No leímos estas fechas en la propia conferencia.
Qué muestran los resultados de este mes
Dos empresas publicaron resultados que ofrecen una vista de ambos extremos de la cadena. Las cifras siguientes proceden de sus propios informes oficiales, salvo que se indique lo contrario.
| Empresa | Qué informó | Qué aporta |
|---|---|---|
| TSMC (fabricante de chips, 15 de octubre) | Ingresos de 1494.24 mil millones de NT$, un 50.9 % más que un año antes. Beneficio neto de 763.06 mil millones de NT$, un 68.7 % más. Su proceso más reciente, de 2 nm, representó el 8 % de los ingresos por obleas. | Su director ejecutivo, C.C. Wei, dijo que la demanda supera a la oferta y que la brecha es «todavía bastante grande». Esta cita procede de una transcripción de terceros con pasajes confusos. |
| Micron (fabricante de memoria, 30 de septiembre) | Ingresos de 54.23 mil millones de dólares en el cuarto trimestre y de 133.19 mil millones de dólares en el año completo. Su previsión para el siguiente trimestre es de 61.5 mil millones de dólares. | Su director de operaciones dijo: «realmente no tenemos visibilidad sobre cuándo se equilibrarán la oferta y la demanda». |
| AMD (diseñador de chips) | Indica 432 GB de HBM4 en cada MI455X y 31 TB en un rack de 72 chips. AMD prevé despliegues en volumen de su rack Helios en el segundo semestre de 2026. | Samsung dijo en marzo de 2026 que es el proveedor preferente de HBM4 para el MI455X. Es una declaración de la propia Samsung. |
Aquí conviene una advertencia. Las empresas que dicen que el suministro es escaso son las que lo venden, y la escasez favorece sus precios.
Micron prevé un margen bruto de alrededor del 86 % para su próximo trimestre, lo que muestra lo sólida que es su posición. Toma las previsiones como bien informadas, pero interesadas.
Vale la pena tener presentes otras dos visiones junto a ellas. TrendForce, una firma de investigación independiente, afirma en un boletín del 16 de octubre que la oferta de HBM seguirá siendo insuficiente hasta 2028. Ese boletín es un resumen de un informe de pago, así que no pudimos leer sus cifras.
Las propias perspectivas de SK hynix señalan que algunos analistas esperan que los precios de la HBM se corrijan después de 2026, a medida que crezca la capacidad. Que el suministro sea escaso y que los precios sigan altos no son la misma afirmación.
Por qué esto llega a los dispositivos de uso cotidiano
La HBM y la memoria convencional dependen de la misma capacidad limitada de fabricación de chips, según TrendForce. Cuando los fabricantes destinan más de ella a la HBM, queda menos para la memoria de las computadoras portátiles y los teléfonos. TrendForce, una firma de investigación independiente, pronosticó el 30 de septiembre que los precios de contrato de la DRAM convencional subirían entre un 10 y un 15 % de un trimestre al siguiente en el último trimestre de 2026.
También informó que el mayor costo de la memoria está lastrando las ventas de computadoras portátiles, que algunas marcas de PC están reduciendo la capacidad de los SSD en sus modelos de gama general y que la producción de smartphones se está frenando. El director de operaciones de Micron dijo que la empresa registró un descenso secuencial en los bits de memoria que envió a clientes de dispositivos móviles y de PC.
TrendForce no cuantifica qué parte de esto se debe a la HBM. Así que el vínculo es real, pero no se conoce su magnitud.
No encontramos ninguna subida de precios confirmada en los servicios de IA en la nube que se deba a la HBM. Si compras IA por horas o por tokens, trata el costo de la memoria como un riesgo para el que conviene planificar y no como un hecho actual. Para la parte energética de la misma historia, consulta por qué la electricidad se está convirtiendo en la verdadera limitación (en inglés).
Hasta qué punto conviene aprender esto
Conocer: Casi todas las personas que trabajan cerca de la IA deberían saber al menos esto. La HBM es memoria apilada junto al procesador, la IA la lee constantemente y el suministro es limitado. Eso explica por qué el hardware de IA es caro y por qué elegir una GPU depende tanto de la memoria como de la velocidad.
Usar: Los ingenieros que dimensionan cargas de trabajo de IA deberían poder estimar cuánta memoria necesitarán un modelo y sus conversaciones, y compararla con la memoria y el ancho de banda de los chips disponibles. Para una visión más amplia de los tipos de chips, consulta CPU vs GPU vs TPU vs NPU vs LPU vs DPU.
Dominar: Los arquitectos de hardware e infraestructura necesitan el detalle. Eso incluye cómo se construyen y encapsulan las pilas, cómo usan la memoria las distintas cargas de trabajo y cómo planificar el riesgo de suministro en una compra de varios años.
Qué puedes ignorar por ahora
No necesitas memorizar los nombres de las generaciones de HBM, sus grados de velocidad ni las tablas de cuota de mercado. Cambian cada año, y las cifras de cuota que encontramos tenían más de un año de antigüedad.
Ignora los picos de precios de una sola fuente que circulan en las redes sociales, porque no pudimos confirmarlos. Tampoco necesitas seguir cada cifra de resultados. La idea que perdura es que mover datos puede limitar a la IA tanto como calcular.
Un siguiente paso práctico
Elige un modelo de IA que uses o pienses usar y anota tres cifras: el tamaño de sus pesos, cuánta memoria añade una conversación larga, y la capacidad de memoria y el ancho de banda del chip que lo ejecuta. Si las dos primeras no caben con holgura en la tercera, tu límite es la memoria, y un chip más rápido no lo resolverá.
Para profundizar
- Micron fiscal fourth quarter 2026 press release, para los ingresos, la previsión y el margen.
- TSMC third quarter 2026 Form 6-K, para los ingresos, el beneficio y la combinación de procesos.
- AMD Instinct MI400 series, para las cifras de memoria del MI455X.
- NVIDIA H100, para su capacidad de memoria y su ancho de banda.
- Understanding Inference Scaling for LLMs, para entender por qué la inferencia está limitada por la memoria.
- SK hynix 2026 market outlook, para la visión de un fabricante de memoria, incluidos los riesgos que menciona.
- TrendForce 4Q26 memory price forecast, via I-Connect007, para el efecto en los dispositivos de uso cotidiano.
- JEDEC HBM4 announcement, as republished by Storage Newsletter, para el ancho de la interfaz, la velocidad y los tamaños de pila que define el estándar.
- TrendForce HBM market bulletin, 16 October 2026, para una previsión independiente del suministro hasta 2028.
- High Bandwidth Memory en Wikipedia, como referencia general sobre cómo se construye la HBM.
Las cifras de este artículo se comprobaron el 18 y el 19 de octubre de 2026. Los resultados financieros y las previsiones de precios cambian, así que consulta las fuentes anteriores antes de basarte en ellas.