

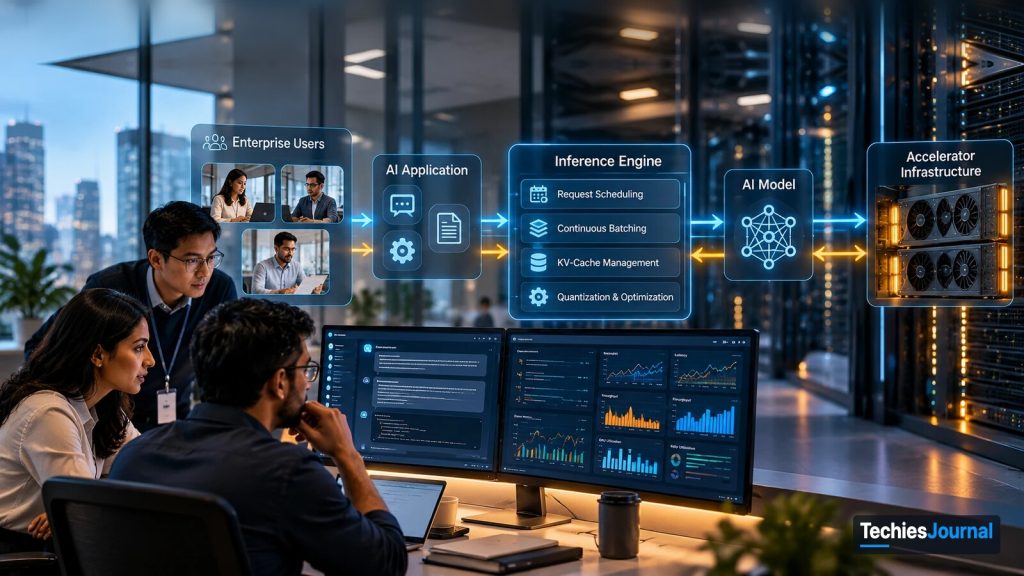
Illustration d’une pile de service d’IA. Les tableaux de bord et graphiques représentés sont décoratifs : ce ne sont pas de vraies mesures.
Faire tourner un modèle d’IA est une chose. Le faire répondre de manière fiable à de nombreux utilisateurs en est une autre. Comprendre les moteurs d’inférence aide les équipes d’ingénierie à prendre de meilleures décisions de service, sans se fier à des comparaisons de performances trompeuses.
Comment un modèle d’IA répond à une question
Imaginez une organisation qui construit un assistant d’IA interne. Les employés peuvent s’en servir pour chercher dans la documentation technique, comprendre les procédures internes et poser des questions sur les applications et l’infrastructure.
L’équipe de développement choisit un modèle de langage à poids ouverts, l’exécute sur une machine équipée d’un GPU et le connecte à une simple interface de chat. Pendant la démonstration, tout fonctionne. Un employé pose une question, le modèle la traite et une réponse s’affiche.
Ce processus s’appelle l’inférence. Un modèle apprend des régularités pendant l’entraînement. Pendant l’inférence, il utilise ses paramètres entraînés pour traiter de nouvelles entrées et produire des sorties. Normalement, il ne se réentraîne pas chaque fois que quelqu’un pose une question.
Les modèles de langage produisent leurs réponses sous forme de suites de jetons (tokens), qui peuvent représenter des mots, des parties de mots ou de la ponctuation. Générer ces jetons demande du calcul et de la mémoire, et les besoins en ressources varient selon le modèle et la charge de travail. Pour une démonstration à un seul utilisateur, gérer ce calcul peut sembler simple. La production pose des défis d’une autre nature.
Ce que fait un moteur d’inférence d’IA
Un modèle d’IA et un moteur d’inférence n’ont pas le même rôle. Le modèle contient les paramètres entraînés et la structure de calcul qui servent à produire les sorties. Le moteur d’inférence est le logiciel chargé d’exécuter ce modèle sur le matériel disponible et de gérer le travail de calcul associé.
Selon sa conception, un moteur d’inférence peut charger des modèles, ordonnancer les requêtes, gérer la mémoire, regrouper les opérations par lots et diffuser en flux les réponses générées.
La relation de base est la suivante :
Utilisateur → Application d’IA → Moteur d’inférence → Exécution du modèle → Réponse
Une application en production peut aussi comprendre la recherche de documents, l’authentification, le routage réseau, la surveillance et d’autres services. Le moteur d’inférence ne remplace pas ces composants.
Des outils comme Ollama, LM Studio et llama.cpp rendent l’exécution locale de modèles accessible, avec des capacités de service plus ou moins étendues. Des systèmes comme vLLM, SGLang et LMDeploy proposent d’autres approches pour gérer les charges de travail d’inférence. La section suivante explique pourquoi une organisation a besoin de ces capacités au lieu de conserver la configuration qui fonctionnait pendant le développement.
Pourquoi la production change le problème
L’organisation ouvre son assistant à plusieurs centaines d’employés. Certains posent des questions courtes. D’autres soumettent de longs documents. Plusieurs requêtes arrivent en même temps, et la longueur des réponses varie considérablement.
Ces requêtes ne consomment pas autant de ressources de calcul les unes que les autres. Traiter un long document demande plus de calcul en entrée que traiter une question courte. Générer une longue réponse demande aussi plus de travail que produire une réponse brève.
À mesure que l’usage simultané augmente, le système de service doit arbitrer entre des requêtes concurrentes et une mémoire GPU limitée. Les employés peuvent constater des temps de réponse irréguliers, même lorsque le matériel disponible semble puissant.
La question n’est plus seulement de savoir si le modèle peut produire une réponse. Elle est de savoir si le système de service peut traiter efficacement des requêtes différentes tout en maintenant des performances acceptables.
Comment les moteurs d’inférence gèrent les requêtes simultanées
Pour de nombreux modèles de langage fondés sur l’architecture transformer, l’inférence comporte deux étapes importantes. Le prefill (préremplissage) est l’étape au cours de laquelle le modèle traite les jetons d’entrée et prépare les informations nécessaires à la génération. Des entrées plus longues créent en général plus de travail à cette étape.
Le décodage (decode) est l’étape au cours de laquelle le modèle génère les jetons de sortie par étapes de calcul successives. Les deux étapes ont des caractéristiques de calcul différentes. Leurs besoins en ressources dépendent du modèle, du matériel, de la longueur des requêtes et de la configuration d’exécution.
Quand plusieurs requêtes arrivent, un ordonnancement efficace devient important. L’une des techniques est le batching continu (continuous batching). Plutôt que de traiter un groupe fixe de requêtes jusqu’à ce qu’elles soient toutes terminées, le moteur peut ajuster le groupe actif à mesure que des requêtes se terminent et que de nouvelles sont prêtes. Cela peut améliorer l’utilisation du matériel et le débit.
La gestion de la mémoire est tout aussi importante. Pendant la génération, les modèles transformer conservent couramment des informations d’attention intermédiaires issues des jetons déjà traités. C’est ce qu’on appelle le cache clé-valeur (key-value cache), ou cache KV. Conserver ces informations évite de refaire certains calculs, mais le cache consomme de la mémoire. Davantage de requêtes simultanées et des séquences plus longues augmentent en général les besoins en mémoire.
Les moteurs d’inférence emploient des stratégies différentes pour gérer cette mémoire. Par exemple, vLLM a introduit PagedAttention, une approche qui organise la mémoire du cache KV en blocs afin de réduire les allocations inefficaces et d’améliorer l’utilisation de la mémoire.
Ces techniques aident à comprendre comment un moteur d’inférence peut améliorer les performances sans changer le modèle sous-jacent. Source : documentation de vLLM
Alternative textuelle accessible pour cette figure
Dans le moteur, des requêtes de longueurs différentes arrivent ensemble. Un ordonnanceur applique le batching continu, l’étape de prefill traite les jetons d’entrée, l’étape de décodage génère les jetons de sortie un par un et la réponse est renvoyée en flux à l’utilisateur. Un cache KV dans la mémoire de l’accélérateur soutient l’ordonnanceur, le prefill et le décodage, et grandit avec le nombre de requêtes simultanées et la longueur des séquences.
Autour du moteur, une passerelle d’API peut gérer l’authentification et les limites de requêtes, l’application peut gérer les sessions, la recherche documentaire, l’autorisation des outils et les délais d’expiration (timeouts), une plateforme d’orchestration peut superviser le processus de service, et la surveillance devrait relier les métriques du moteur au comportement de l’application.
Autres optimisations
À mesure que les charges de travail deviennent plus exigeantes, d’autres techniques peuvent aider.
La quantification utilise une précision numérique réduite pour certaines valeurs ou certains calculs du modèle. Elle peut réduire les besoins en mémoire et potentiellement améliorer les performances, mais la compatibilité et la qualité des sorties doivent être évaluées.
La mise en cache des préfixes (prefix caching) réutilise les calculs appropriés lorsque des requêtes partagent des préfixes de prompt identiques. Cela peut aider les applications qui envoient de manière répétée les mêmes instructions ou le même contexte.
Le décodage spéculatif (speculative decoding) s’appuie sur des jetons proposés et sur un processus de vérification pour accélérer la génération dans des conditions favorables.
Certains déploiements séparent aussi l’exécution du prefill et celle du décodage, ou répartissent le calcul du modèle sur plusieurs accélérateurs. Toutes les applications ne tirent pas le même bénéfice de ces méthodes. La prise en charge des fonctionnalités et leur efficacité dépendent du modèle, de la version du moteur, du matériel et de la charge de travail.
Comprendre ces mécanismes donne aux ingénieurs une base pour évaluer les moteurs qui les mettent en œuvre.
Comprendre les moteurs d’inférence disponibles
Plusieurs projets open source fournissent des capacités d’exécution de l’inférence et de service. Leurs fonctionnalités se recoupent, mais leurs architectures, leur compatibilité et leurs caractéristiques d’exploitation peuvent différer.
vLLM
vLLM est un moteur open source d’inférence et de service, associé à une gestion efficace du cache KV grâce à PagedAttention. Il prend en charge des capacités comme le batching continu, la mise en cache des préfixes, la quantification, le décodage spéculatif, les sorties structurées et l’exécution distribuée.
C’est un candidat pertinent pour les environnements de service de modèles multi-utilisateurs, même si chaque fonctionnalité dépend du modèle, du matériel, du backend et de la version. Source : documentation de vLLM
SGLang
SGLang fournit des capacités d’inférence et de service pour les modèles de langage, notamment l’ordonnancement de l’exécution, des optimisations liées au cache, la génération structurée et la prise en charge des appels d’outils. Il propose aussi des outils de benchmark pour évaluer l’exécution hors ligne et le service en ligne.
Ces capacités le rendent pertinent pour des applications aux exigences de service élevées, mais elles ne démontrent pas qu’il est plus rapide dans tous les cas pour les charges de travail agentiques. Source : documentation de SGLang
LMDeploy
LMDeploy prend en charge le service de modèles au moyen de backends d’exécution, dont TurboMind et PyTorch. Il fournit des options de quantification, des interfaces de service et des outils d’évaluation des performances.
Les modèles pris en charge et les capacités d’optimisation varient selon le backend, ce qui rend les vérifications de compatibilité particulièrement importantes. Source : documentation de LMDeploy
La place de llama.cpp
llama.cpp est un autre environnement d’exécution d’inférence pertinent, en particulier pour l’exécution portable, les modèles quantifiés et le matériel aux ressources limitées. Il fournit aussi des capacités de service et peut convenir à certains environnements de production.
Une application plus modeste au trafic prévisible n’a pas forcément besoin d’une architecture de service plus complexe. Des charges de travail plus exigeantes peuvent justifier l’évaluation d’autres moteurs. La question pratique n’est pas de savoir quel projet est le plus populaire, mais quelle implémentation répond aux besoins réels de l’application.
| Moteur | Ce que met en avant sa documentation | Ce qu’il faut vérifier d’abord |
|---|---|---|
| vLLM | Gestion du cache KV avec PagedAttention, batching continu, mise en cache des préfixes, quantification, décodage spéculatif, sorties structurées, exécution distribuée | Lesquelles de ces fonctionnalités sont prises en charge par votre modèle, votre matériel, votre backend et votre version |
| SGLang | Ordonnancement de l’exécution, optimisations liées au cache, génération structurée, appels d’outils, outils de benchmark pour le service hors ligne et en ligne | Si ses points forts s’appliquent à votre charge de travail, car ils ne le rendent pas plus rapide dans tous les cas pour le travail agentique |
| LMDeploy | Backends TurboMind et PyTorch, options de quantification, interfaces de service, outils d’évaluation des performances | Modèles pris en charge et optimisations, qui varient selon le backend |
| llama.cpp | Exécution portable, modèles quantifiés, matériel aux ressources limitées, capacités de service | Si une application plus modeste au trafic prévisible a besoin d’un moteur plus complexe |
Avant de comparer la vitesse, vérifier la compatibilité
Notre assistant interne doit désormais prendre en charge des conversations ordinaires, des questions portant sur des documents, des réponses structurées et certains flux de travail qui utilisent des outils. L’équipe présélectionne plusieurs moteurs d’inférence.
Avant de les soumettre à des benchmarks, elle doit vérifier que chaque candidat peut faire fonctionner correctement l’application. Les vérifications importantes portent sur la compatibilité du modèle et du tokenizer, la longueur de contexte prise en charge, les exigences matérielles, les modèles de chat (chat templates), le streaming, les sorties structurées et le comportement des appels d’outils.
Deux moteurs peuvent exposer des API compatibles avec OpenAI sans se comporter de façon identique. Ils peuvent différer par les paramètres pris en charge, les templates propres à chaque modèle, le comportement de la génération contrainte et l’analyse des appels d’outils.
Par exemple, un moteur peut générer du texte rapidement mais renvoyer du JSON qui ne respecte pas le schéma exigé par l’application. De même, la sortie d’un appel d’outil peut nécessiter une configuration propre au modèle avant que l’application puisse l’interpréter de manière fiable.
Le moteur d’inférence peut aider à produire une demande d’appel d’outil, mais c’est toujours l’application qui est responsable d’autoriser et d’exécuter l’action demandée. Les comparaisons de performances n’ont de sens qu’une fois que les candidats satisfont aux mêmes exigences fonctionnelles.
Un moteur incapable de produire de manière fiable des sorties valides pour l’application ne devrait pas l’emporter parce qu’il génère plus de jetons par seconde.
Comment mesurer les performances d’inférence
Une fois la compatibilité établie, les tests de performances peuvent commencer. La première question est ce que vivent réellement les utilisateurs.
Quand un employé soumet une requête, il peut y avoir un délai avant que le premier jeton apparaisse. La réponse arrive ensuite progressivement jusqu’à la fin de la génération. Des mesures différentes décrivent des parties différentes de cette expérience.
| Métrique | Signification | Intérêt pratique |
|---|---|---|
| Délai avant le premier jeton (TTFT) | Délai avant l’arrivée du premier jeton généré | Réactivité interactive |
| Latence entre jetons (ITL) | Temps entre deux jetons générés successifs | Fluidité des réponses diffusées en flux |
| Latence de bout en bout | Temps total jusqu’à la fin de la réponse | Temps d’exécution complet de la tâche |
| Débit | Requêtes ou jetons traités par unité de temps | Capacité de service |
| Taux de requêtes réussies | Requêtes traitées conformément aux exigences de l’application | Capacité réellement utilisable |
Un moteur peut atteindre un débit élevé alors que certaines requêtes subissent individuellement des délais plus longs. Le bon équilibre dépend de la charge de travail. Pour un assistant conversationnel, des premières réponses rapides peuvent être importantes. Pour un traitement de documents pendant la nuit, le débit total et le coût d’exploitation peuvent compter davantage.
Pourquoi les moyennes peuvent être trompeuses
La latence moyenne ne révèle pas toute la distribution des temps de réponse. Un système peut servir rapidement la plupart des requêtes alors qu’un plus petit pourcentage d’entre elles subit des délais importants.
Les ingénieurs examinent donc des percentiles comme P95 et P99. Par exemple, la latence P95 désigne la valeur à laquelle ou en dessous de laquelle environ 95 % des requêtes mesurées se sont terminées.
L’évaluation des performances devrait aussi inclure les erreurs, les délais dépassés (timeouts), les annulations et les réponses invalides. Exclure les requêtes en échec peut faire paraître un système plus efficace qu’il ne l’est. Source : référence des métriques NVIDIA AIPerf
Pourquoi les benchmarks de moteurs d’inférence se contredisent
Un benchmark peut indiquer que SGLang surpasse vLLM. Un autre peut indiquer l’inverse. Les résultats ne sont pas forcément contradictoires.
Les performances dépendent de l’architecture du modèle, de sa taille, de la précision, de l’accélérateur, de la concurrence, de la longueur des entrées et des sorties, et de la configuration de service. Un benchmark réalisé avec un petit modèle sur un seul GPU ne désigne pas le meilleur moteur pour un modèle plus grand réparti sur plusieurs accélérateurs. Même un matériel identique ne garantit pas une comparaison équitable si les moteurs utilisent des réglages d’optimisation différents.
Les ingénieurs devraient donc distinguer deux types d’évaluation :
- Comparaison contrôlée : maintenir constantes autant de variables que possible pour comprendre les différences entre les moteurs.
- Meilleure configuration pratique : optimiser chaque candidat de façon appropriée pour déterminer quel déploiement répond le plus efficacement aux exigences de l’application.
Les deux sont utiles, mais elles répondent à des questions différentes.
Benchmarks hors ligne et en ligne
Un benchmark hors ligne peut mesurer l’exécution du modèle sans passer par tout le chemin de service de l’API. Un benchmark en ligne envoie des requêtes à un service en fonctionnement et intègre des effets supplémentaires comme le traitement des requêtes et l’ordonnancement.
Un résultat hors ligne ne devrait pas être comparé directement à un résultat en ligne comme s’ils mesuraient des conditions identiques. Le guide de benchmark de service de SGLang décrit la génération de charges de travail et les tests de performances sur les backends de service pris en charge.
Les benchmarks du secteur continuent eux aussi d’évoluer. MLPerf Inference v6.1, publié en septembre 2026, accorde davantage d’attention à des charges de travail comme la génération augmentée par récupération (RAG) de bout en bout et l’inférence agentique. Ces évolutions améliorent les méthodes disponibles pour évaluer les systèmes d’inférence, mais elles ne désignent pas un moteur comme le meilleur pour toutes les applications. Source : MLCommons, MLPerf Inference
Construire un benchmark autour de l’application
Pour notre assistant d’entreprise, un test utile devrait comprendre trois charges de travail représentatives. Les questions courtes révèlent la réactivité interactive. Les requêtes portant sur de longs documents font apparaître les besoins en traitement des entrées et en mémoire. Les requêtes à sortie structurée et celles qui utilisent des outils testent l’exactitude en même temps que les performances.
L’équipe devrait augmenter progressivement la concurrence et observer le comportement de chaque moteur sous un trafic plus lourd. Pour la reproductibilité, le compte rendu du test devrait indiquer la révision exacte du modèle, la version du moteur, le matériel, la précision numérique, les réglages d’optimisation et la méthode de mesure.
La comparaison finale devrait prendre en compte les percentiles de latence, le débit, les erreurs, la consommation de ressources et les requêtes valides pour l’application menées à bien. L’objectif n’est pas de produire un classement universel. Il est de déterminer quelle configuration répond aux exigences de cette application.
Ce contre quoi un moteur d’inférence ne vous protège pas
Un benchmark mesure généralement un moteur dans des conditions confortables : le test devrait donc aussi trouver le point où les conditions cessent de l’être. Quand le cache KV ne peut pas contenir toutes les requêtes d’un lot, le moteur doit faire quelque chose du travail en trop. vLLM, par exemple, peut préempter une requête et la recalculer plus tard, et sa documentation avertit que cela peut dégrader la latence de bout en bout. Source : guide d’optimisation et de réglage de vLLM
Les autres moteurs gèrent la pression sur la mémoire à leur manière. Pour chaque candidat, demandez-vous ce qu’il advient d’une requête quand la mémoire est épuisée : attend-elle, redémarre-t-elle, ralentit-elle tout le monde ou échoue-t-elle, et l’application peut-elle faire la différence ?
Un moteur d’inférence n’est pas non plus, par défaut, une frontière de sécurité. Le guide de sécurité de vLLM indique que son paramètre de clé d’API ne protège que certains préfixes d’endpoints, énumère d’autres endpoints qui restent accessibles sans clé, et recommande de réduire au minimum les endpoints exposés et de placer le serveur derrière un proxy inverse. Il précise aussi que la communication entre les nœuds d’un déploiement multinœud n’est pas sécurisée par défaut et doit être protégée par un réseau isolé. Source : guide de sécurité de vLLM
La règle pratique est que l’authentification, les limites de requêtes et l’isolement réseau relèvent des couches passerelle et plateforme décrites plus haut, et que le moteur ne devrait pas être exposé directement aux utilisateurs ni à des réseaux non fiables. Pour tout autre moteur, lisez sa documentation de sécurité avant de supposer qu’il se comporte de la même façon.
La reprise se prépare avant le premier incident. Consignez la révision exacte du modèle et la version du moteur en production comme dans les benchmarks, gardez l’image précédente du moteur déployable, et envoyez une nouvelle version sur une petite part du trafic avant d’y basculer tout le monde.
Testez ensuite délibérément les cas désagréables : un redémarrage pendant un trafic intense, un modèle qui ne se charge pas et un retour arrière (rollback), et mesurez pendant combien de temps les utilisateurs sont touchés. Une mise à niveau du moteur peut modifier les paramètres pris en charge, les templates et le comportement des appels d’outils : les vérifications de compatibilité décrites plus haut doivent donc être refaites après chaque mise à niveau.
Ce qui se passe après le déploiement
Un bon résultat de benchmark ne prouve pas la fiabilité en production. Le système de service doit aussi gérer l’annulation des requêtes, l’épuisement des ressources, un trafic inattendu, les échecs de chargement de modèles, les redémarrages et les mises à niveau logicielles.
Ces responsabilités dépassent le moteur d’inférence. Une passerelle d’API peut gérer l’authentification et les limites de requêtes. Une plateforme d’orchestration peut superviser le processus de service. L’application peut contrôler les sessions, la recherche documentaire, l’autorisation des outils et les délais d’expiration. L’équipe doit établir à quel niveau se situe chaque responsabilité.
Surveillance et dépannage
Supposons que des employés signalent des réponses plus lentes. L’équipe devrait pouvoir déterminer si la cause est une hausse du trafic, des prompts plus longs, des files d’attente de requêtes, la pression sur la mémoire, l’exécution du modèle ou une dépendance applicative en aval.
Les moteurs d’inférence exposent couramment des métriques d’exploitation. Par exemple, vLLM fournit des métriques compatibles avec Prometheus pour son environnement de service. Une observabilité utile exige de relier ces métriques du moteur au comportement de l’application.
Si la recherche documentaire consomme l’essentiel du temps de la requête, changer de moteur d’inférence risque d’apporter peu d’amélioration. Surveiller uniquement le GPU ne suffit pas à expliquer l’expérience utilisateur dans son ensemble.
Une inférence plus rapide peut réduire les coûts, mais pas automatiquement
Un débit plus élevé peut permettre à un déploiement fortement sollicité de servir davantage de requêtes avec le même matériel, ou de réduire le nombre d’instances d’accélérateurs nécessaires. En revanche, augmenter le débit d’un GPU peu utilisé mais facturé en continu peut ne pas réduire les dépenses. L’évaluation économique devrait tenir compte des frais d’infrastructure, du taux d’utilisation, des requêtes réussies, de l’effort d’ingénierie, de la maintenance et de la complexité d’exploitation.
Une comparaison utile mesure le coût nécessaire pour satisfaire les exigences de service de l’application, pas simplement le coût par jeton théorique.
Comment une équipe peut choisir un moteur d’inférence
Notre assistant interne a commencé comme une démonstration à un seul utilisateur. Il exige désormais un service fiable pour plusieurs types de requêtes et de nombreux utilisateurs. L’équipe d’ingénierie en sait assez pour aborder la décision de façon méthodique.
D’abord, elle devrait décider si une inférence autogérée est nécessaire. Un service d’inférence managé peut déjà répondre aux exigences de l’application tout en réduisant les responsabilités d’infrastructure. Si un service autogéré se justifie, l’équipe peut évaluer les moteurs compatibles.
| Décision | Ce qu’il faut établir |
|---|---|
| Mode de déploiement | Service managé ou service autogéré |
| Compatibilité | Modèle, matériel, sorties et intégrations requis |
| Performances | Latence, débit et comportement sous un trafic réaliste |
| Fiabilité | Limites de ressources, défaillances, surveillance et reprise |
| Aspects économiques | Coûts d’infrastructure, effort d’exploitation et intérêt d’une migration |
Parfois, le moteur existant restera la meilleure option pratique. Un moteur concurrent peut offrir un débit plus élevé mais entraîner des coûts de compatibilité ou de maintenance supérieurs au gain. Rien n’oblige à migrer parce qu’un autre produit arrive en tête d’un benchmark public.
De même, un environnement d’exécution plus simple peut suffire pour une application dont les exigences de performances et de fiabilité sont déjà satisfaites. La décision devrait découler d’exigences applicatives mesurables, et non de la popularité d’une technologie.
Jusqu’où les professionnels doivent comprendre les moteurs d’inférence
Des rôles différents demandent des niveaux de connaissance différents.
Les développeurs d’applications devraient comprendre la latence des réponses, la compatibilité des API, le streaming, la validation des sorties et les implications de leurs requêtes au modèle.
Les ingénieurs plateforme et les SRE qui exploitent une infrastructure d’inférence ont besoin d’une connaissance plus approfondie de l’utilisation des ressources, de la concurrence, de la surveillance, du déploiement, de la fiabilité et de la planification de capacité.
Les spécialistes de l’infrastructure d’IA qui optimisent l’exécution des modèles peuvent aussi avoir besoin de comprendre les algorithmes d’ordonnancement, la gestion du cache KV, la quantification, le parallélisme et les techniques propres à chaque accélérateur.
Tout le monde n’a pas besoin de maîtriser le fonctionnement interne des moteurs d’inférence. La profondeur appropriée dépend de ce que fait le professionnel : consommer, exploiter ou optimiser l’infrastructure de service.
Prendre la bonne décision d’ingénierie
Les modèles d’IA attirent l’attention parce que leurs sorties sont visibles. Les moteurs d’inférence travaillent derrière ces sorties et gèrent le calcul qui rend possible le service en production. Leur importance apparaît plus clairement quand les applications font face à un trafic simultané, à des longueurs de requêtes variables, à des contraintes de mémoire et à des exigences de niveau de service.
Choisir un moteur d’inférence demande donc plus que de comparer des chiffres de benchmark. Les ingénieurs doivent vérifier la compatibilité avec l’application, tester des charges de travail représentatives, comprendre les responsabilités d’exploitation et évaluer le coût total nécessaire pour satisfaire les exigences de service.
Les produits et les classements de benchmarks continueront de changer. La décision de fond reste la même.
Choisissez le moteur d’inférence qui répond aux exigences de l’application avec des performances, une fiabilité, un coût et une complexité d’exploitation acceptables, et pas simplement celui qui obtient les meilleurs résultats dans le benchmark de quelqu’un d’autre.
Pour aller plus loin
- vLLM, Official Documentation, projet vLLM. Architecture du moteur, PagedAttention, ordonnancement, compatibilité des modèles et fonctionnalités de service.
- SGLang, Official Documentation, projet SGLang. Exécution des modèles, génération structurée, appels d’outils et capacités de déploiement.
- SGLang, Serving Benchmark Guide, projet SGLang. Génération de charges de travail, concurrence et mesures du service en ligne.
- LMDeploy, Official Documentation, projet LMDeploy. Backends d’exécution TurboMind et PyTorch, modèles pris en charge et service.
- llama.cpp, Official Repository, projet llama.cpp. Inférence portable, exécution quantifiée et capacités de serveur.
- NVIDIA, AIPerf Metrics Reference, NVIDIA. Définitions de la latence d’inférence, du débit et des mesures associées.
- MLCommons, MLPerf Inference, MLCommons. Méthodologie du benchmark et résultats publiés des systèmes d’inférence.
- vLLM, Optimization and Tuning, projet vLLM. Préemption et pression sur la mémoire du cache KV.
- vLLM, Security, projet vLLM. Protection des endpoints et communication entre nœuds.
Recherches arrêtées au 20 octobre 2026. La disponibilité exacte des fonctionnalités et la compatibilité doivent être vérifiées pour la version du moteur évaluée.
À lire aussi sur TechiesJournal
- Pourquoi l’inférence d’IA change notre façon de penser l’équilibrage de charge (en anglais), pour comprendre comment les requêtes sont acheminées entre les réplicas d’inférence quand un seul serveur ne suffit plus.
- Faire tourner soi-même des modèles d’IA ouverts : ce que cela demande vraiment (en anglais), pour la décision d’auto-hébergement qui précède le choix d’un moteur.