

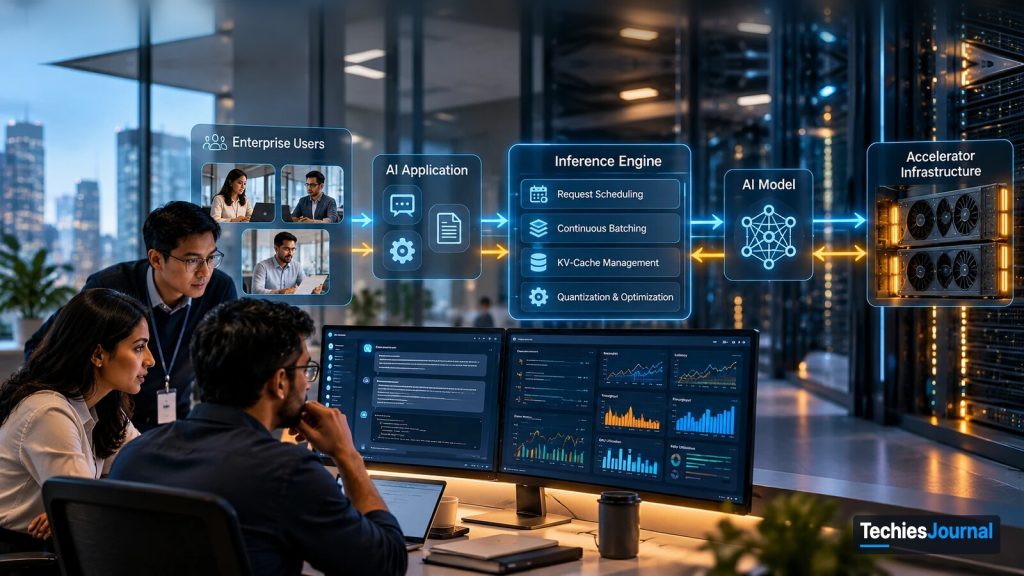
AI సర్వింగ్ స్టాక్ చిత్రణ మాత్రమే. ఇందులో కనిపించే డ్యాష్బోర్డ్లు, చార్ట్లు అలంకారం కోసం మాత్రమే, నిజమైన కొలతలు కావు.
AI మోడల్ను నడపడం ఒక విషయం. చాలా మంది యూజర్లకు అది నమ్మకంగా స్పందించేలా చేయడం మరో విషయం. ఇన్ఫరెన్స్ ఇంజిన్లను అర్థం చేసుకుంటే, తప్పుదోవ పట్టించే పనితీరు పోలికలపై ఆధారపడకుండా ఇంజనీరింగ్ టీమ్లు మెరుగైన సర్వింగ్ నిర్ణయాలు తీసుకోగలవు.
AI మోడల్ ఒక ప్రశ్నకు ఎలా సమాధానం ఇస్తుంది
అంతర్గత AI అసిస్టెంట్ను నిర్మిస్తున్న ఒక సంస్థను ఊహించండి. ఉద్యోగులు దాన్ని సాంకేతిక పత్రాలను వెతకడానికి, అంతర్గత విధానాలను అర్థం చేసుకోవడానికి, అప్లికేషన్లు, మౌలిక సదుపాయాల గురించి ప్రశ్నలు అడగడానికి వాడవచ్చు.
డెవలప్మెంట్ టీమ్ ఒక ఓపెన్-వెయిట్ లాంగ్వేజ్ మోడల్ను ఎంచుకుని, GPU ఉన్న మెషీన్పై నడిపి, ఒక సాధారణ చాట్ ఇంటర్ఫేస్కు కనెక్ట్ చేస్తుంది. ప్రదర్శన సమయంలో అంతా పనిచేస్తుంది. ఒక ఉద్యోగి ప్రశ్న అడుగుతారు, మోడల్ దాన్ని ప్రాసెస్ చేస్తుంది, సమాధానం కనిపిస్తుంది.
ఈ ప్రక్రియను ఇన్ఫరెన్స్ (inference) అంటారు. మోడల్ శిక్షణ సమయంలో నమూనాలను నేర్చుకుంటుంది. ఇన్ఫరెన్స్ సమయంలో, కొత్త ఇన్పుట్లను ప్రాసెస్ చేసి అవుట్పుట్లను ఉత్పత్తి చేయడానికి అది శిక్షణ పొందిన పారామీటర్లను వాడుతుంది. ఎవరైనా ప్రశ్న అడిగిన ప్రతిసారీ అది సాధారణంగా తనను తాను మళ్లీ శిక్షణ చేసుకోదు.
లాంగ్వేజ్ మోడల్లు సమాధానాలను టోకెన్ల క్రమాలుగా ఉత్పత్తి చేస్తాయి, ఇవి పదాలను, పదాల భాగాలను లేదా విరామచిహ్నాలను సూచించవచ్చు. ఆ టోకెన్లను ఉత్పత్తి చేయడానికి గణన, మెమరీ అవసరం, మోడల్ను, వర్క్లోడ్ను బట్టి వనరుల అవసరాలు మారుతాయి. ఒక్క యూజర్ ప్రదర్శనలో ఆ గణనను నిర్వహించడం సులభంగా అనిపించవచ్చు. ప్రొడక్షన్ భిన్నమైన సవాళ్లను తెస్తుంది.
AI ఇన్ఫరెన్స్ ఇంజిన్ ఏమి చేస్తుంది
AI మోడల్కు, ఇన్ఫరెన్స్ ఇంజిన్కు వేర్వేరు ప్రయోజనాలు ఉన్నాయి. మోడల్లో అవుట్పుట్లను ఉత్పత్తి చేయడానికి వాడే శిక్షణ పొందిన పారామీటర్లు, గణన నిర్మాణం ఉంటాయి. ఇన్ఫరెన్స్ ఇంజిన్ అంటే, అందుబాటులో ఉన్న హార్డ్వేర్పై ఆ మోడల్ను అమలు చేసి, దానికి సంబంధించిన గణన పనిని నిర్వహించే సాఫ్ట్వేర్.
దాని రూపకల్పనను బట్టి, ఇన్ఫరెన్స్ ఇంజిన్ మోడల్లను లోడ్ చేయగలదు, అభ్యర్థనలను షెడ్యూల్ చేయగలదు, మెమరీని నిర్వహించగలదు, ఆపరేషన్లను బ్యాచ్ చేయగలదు, ఉత్పత్తి అయిన సమాధానాలను స్ట్రీమ్ చేయగలదు.
ప్రాథమిక సంబంధం ఇది:
యూజర్ → AI అప్లికేషన్ → ఇన్ఫరెన్స్ ఇంజిన్ → మోడల్ అమలు → సమాధానం
ప్రొడక్షన్ అప్లికేషన్లో డాక్యుమెంట్ రిట్రీవల్, ప్రామాణీకరణ, నెట్వర్క్ రూటింగ్, మానిటరింగ్, ఇతర సేవలు కూడా ఉండవచ్చు. ఇన్ఫరెన్స్ ఇంజిన్ ఆ భాగాలకు ప్రత్యామ్నాయం కాదు.
Ollama, LM Studio, llama.cpp వంటి టూల్స్ స్థానికంగా మోడల్లను నడపడాన్ని అందుబాటులోకి తెస్తాయి, సర్వింగ్ సామర్థ్యం స్థాయిలు వేర్వేరుగా ఉంటాయి. vLLM, SGLang, LMDeploy వంటి వ్యవస్థలు ఇన్ఫరెన్స్ వర్క్లోడ్లను నిర్వహించడానికి అదనపు పద్ధతులను అందిస్తాయి. తర్వాతి విభాగం, డెవలప్మెంట్ సమయంలో పనిచేసిన ఏర్పాటునే కొనసాగించకుండా, ఒక సంస్థకు ఈ సామర్థ్యాలు ఎందుకు అవసరమో వివరిస్తుంది.
ప్రొడక్షన్ సమస్యను ఎందుకు మారుస్తుంది
సంస్థ తన అసిస్టెంట్ను అనేక వందల మంది ఉద్యోగులకు అందుబాటులోకి తెస్తుంది. కొందరు చిన్న ప్రశ్నలు అడుగుతారు. మరికొందరు పొడవైన పత్రాలను సమర్పిస్తారు. అనేక అభ్యర్థనలు ఒకేసారి వస్తాయి, సమాధానాల నిడివి చాలా మారుతుంది.
ఈ అభ్యర్థనలు సమాన కంప్యూటింగ్ వనరులను వినియోగించవు. పొడవైన పత్రాన్ని ప్రాసెస్ చేయడానికి, చిన్న ప్రశ్నను ప్రాసెస్ చేయడం కంటే ఎక్కువ ఇన్పుట్ గణన అవసరం. పొడవైన సమాధానాన్ని ఉత్పత్తి చేయడానికి కూడా, క్లుప్త సమాధానం ఇవ్వడం కంటే ఎక్కువ పని అవసరం.
ఏకకాల వినియోగం పెరిగేకొద్దీ, సర్వింగ్ వ్యవస్థ పోటీపడే అభ్యర్థనలను, పరిమితమైన GPU మెమరీని నిర్వహించాలి. అందుబాటులో ఉన్న హార్డ్వేర్ శక్తివంతంగా కనిపించినా, ఉద్యోగులు అస్థిరమైన ప్రతిస్పందన సమయాలను అనుభవించవచ్చు.
ఇప్పుడు సమస్య మోడల్ సమాధానాన్ని ఉత్పత్తి చేయగలదా అన్నది మాత్రమే కాదు. ఆమోదయోగ్యమైన పనితీరును కొనసాగిస్తూ, సర్వింగ్ వ్యవస్థ వేర్వేరు అభ్యర్థనలను సమర్థవంతంగా నిర్వహించగలదా అన్నదే.
ఇన్ఫరెన్స్ ఇంజిన్లు ఏకకాల అభ్యర్థనలను ఎలా నిర్వహిస్తాయి
చాలా ట్రాన్స్ఫార్మర్ ఆధారిత లాంగ్వేజ్ మోడల్లలో, ఇన్ఫరెన్స్లో రెండు ముఖ్యమైన దశలు ఉంటాయి. ప్రిఫిల్ (Prefill) అనేది మోడల్ ఇన్పుట్ టోకెన్లను ప్రాసెస్ చేసి, ఉత్పత్తికి అవసరమైన సమాచారాన్ని సిద్ధం చేసే దశ. పొడవైన ఇన్పుట్లు సాధారణంగా ఈ దశలో ఎక్కువ పనిని సృష్టిస్తాయి.
డీకోడ్ (Decode) అనేది మోడల్ వరుస గణన అడుగుల ద్వారా అవుట్పుట్ టోకెన్లను ఉత్పత్తి చేసే దశ. ఈ రెండు దశల గణన లక్షణాలు వేర్వేరు. వాటి వనరుల డిమాండ్ మోడల్, హార్డ్వేర్, అభ్యర్థన నిడివి, అమలు కాన్ఫిగరేషన్పై ఆధారపడి ఉంటుంది.
అనేక అభ్యర్థనలు వచ్చినప్పుడు, సమర్థవంతమైన షెడ్యూలింగ్ ముఖ్యమవుతుంది. ఒక పద్ధతి నిరంతర బ్యాచింగ్ (continuous batching). స్థిరమైన అభ్యర్థనల సమూహం అన్నీ పూర్తయ్యే వరకు ప్రాసెస్ చేయడానికి బదులు, అభ్యర్థనలు పూర్తవుతున్న కొద్దీ, కొత్త అభ్యర్థనలు సిద్ధమవుతున్న కొద్దీ ఇంజిన్ క్రియాశీల సమూహాన్ని సర్దుబాటు చేయగలదు. ఇది హార్డ్వేర్ వినియోగాన్ని, థ్రూపుట్ను మెరుగుపరచగలదు.
మెమరీ నిర్వహణ కూడా అంతే ముఖ్యం. ఉత్పత్తి సమయంలో, ట్రాన్స్ఫార్మర్ మోడల్లు సాధారణంగా ఇంతకుముందు ప్రాసెస్ చేసిన టోకెన్ల నుంచి మధ్యంతర అటెన్షన్ సమాచారాన్ని నిలుపుకుంటాయి. దీన్ని కీ-వాల్యూ కాష్ (key-value cache) లేదా KV cache అంటారు. ఈ సమాచారాన్ని నిలుపుకోవడం కొన్ని లెక్కలను మళ్లీ చేయకుండా కాపాడుతుంది, కానీ ఆ కాష్ మెమరీని వినియోగిస్తుంది. ఎక్కువ ఏకకాల అభ్యర్థనలు, పొడవైన సీక్వెన్స్లు సాధారణంగా మెమరీ అవసరాలను పెంచుతాయి.
ఆ మెమరీని నిర్వహించడానికి ఇన్ఫరెన్స్ ఇంజిన్లు వేర్వేరు వ్యూహాలను వాడతాయి. ఉదాహరణకు, vLLM PagedAttentionను ప్రవేశపెట్టింది. ఇది అసమర్థ కేటాయింపును తగ్గించి మెమరీ వినియోగాన్ని మెరుగుపరచడానికి KV-cache మెమరీని బ్లాక్లుగా నిర్వహించే పద్ధతి.
అంతర్లీన మోడల్ను మార్చకుండానే ఇన్ఫరెన్స్ ఇంజిన్ పనితీరును ఎలా మెరుగుపరచగలదో ఈ పద్ధతులు వివరించడానికి సహాయపడతాయి. మూలం: vLLM documentation
ఈ చిత్రానికి అందుబాటులో ఉండే టెక్స్ట్ ప్రత్యామ్నాయం
ఇంజిన్ లోపల, వేర్వేరు నిడివుల అభ్యర్థనలు ఒకేసారి వస్తాయి. షెడ్యూలర్ నిరంతర బ్యాచింగ్ వర్తింపజేస్తుంది, ప్రిఫిల్ దశ ఇన్పుట్ టోకెన్లను ప్రాసెస్ చేస్తుంది, డీకోడ్ దశ అవుట్పుట్ టోకెన్లను ఒక్కొక్కటిగా సృష్టిస్తుంది, ప్రతిస్పందన వినియోగదారుకు స్ట్రీమ్ అవుతుంది. యాక్సిలరేటర్ మెమరీలోని KV-cache షెడ్యూలర్, ప్రిఫిల్, డీకోడ్లకు తోడ్పడుతుంది, ఎక్కువ ఏకకాల అభ్యర్థనలు, పొడవైన సీక్వెన్స్లతో పెరుగుతుంది.
ఇంజిన్ చుట్టూ, API గేట్వే ప్రామాణీకరణను, అభ్యర్థన పరిమితులను నిర్వహించవచ్చు, అప్లికేషన్ సెషన్లు, డాక్యుమెంట్ రిట్రీవల్, టూల్ అనుమతి, టైమ్అవుట్లను నిర్వహించవచ్చు, ఆర్కెస్ట్రేషన్ ప్లాట్ఫారమ్ సర్వింగ్ ప్రక్రియను పర్యవేక్షించవచ్చు, మానిటరింగ్ ఇంజిన్ మెట్రిక్లను అప్లికేషన్ స్థాయి ప్రవర్తనతో కలపాలి.
ఇతర ఆప్టిమైజేషన్లు
వర్క్లోడ్లు మరింత డిమాండ్తో కూడినవిగా మారినప్పుడు, అదనపు పద్ధతులు సహాయపడవచ్చు.
క్వాంటైజేషన్ (Quantization) కొన్ని మోడల్ విలువలకు లేదా గణనలకు తగ్గించిన సంఖ్యా కచ్చితత్వాన్ని వాడుతుంది. ఇది మెమరీ అవసరాలను తగ్గించగలదు, పనితీరును మెరుగుపరచే అవకాశం కూడా ఉంది, అయితే అనుకూలతను, అవుట్పుట్ నాణ్యతను అంచనా వేయాలి.
ప్రిఫిక్స్ కాషింగ్ (Prefix caching) అభ్యర్థనలు ఒకే విధమైన ప్రాంప్ట్ ప్రిఫిక్స్లను పంచుకున్నప్పుడు తగిన గణనలను మళ్లీ వాడుతుంది. అవే సూచనలను లేదా సందర్భాన్ని పదేపదే పంపే అప్లికేషన్లకు ఇది సహాయపడవచ్చు.
స్పెక్యులేటివ్ డీకోడింగ్ (Speculative decoding) అనుకూల పరిస్థితుల్లో ఉత్పత్తిని వేగవంతం చేయడానికి ప్రతిపాదిత టోకెన్లను, ధృవీకరణ ప్రక్రియను వాడుతుంది.
కొన్ని డిప్లాయ్మెంట్లు ప్రిఫిల్, డీకోడ్ అమలును వేరు చేస్తాయి లేదా మోడల్ గణనను అనేక యాక్సిలరేటర్లకు పంపిణీ చేస్తాయి. ప్రతి అప్లికేషన్ ఈ పద్ధతుల నుంచి సమానంగా ప్రయోజనం పొందదు. ఫీచర్ మద్దతు, ప్రభావశీలత మోడల్, ఇంజిన్ వెర్షన్, హార్డ్వేర్, వర్క్లోడ్పై ఆధారపడి ఉంటాయి.
ఈ యంత్రాంగాలను అర్థం చేసుకోవడం, వాటిని అమలు చేసే ఇంజిన్లను మూల్యాంకనం చేయడానికి ఇంజనీర్లకు పునాది ఇస్తుంది.
అందుబాటులో ఉన్న ఇన్ఫరెన్స్ ఇంజిన్లను అర్థం చేసుకోవడం
అనేక ఓపెన్-సోర్స్ ప్రాజెక్టులు ఇన్ఫరెన్స్ అమలు, సర్వింగ్ సామర్థ్యాలను అందిస్తాయి. వాటి ఫీచర్లు పరస్పరం కలిసిపోతాయి, కానీ వాటి నిర్మాణాలు, అనుకూలత, ఆపరేషనల్ లక్షణాలు భిన్నంగా ఉండవచ్చు.
vLLM
vLLM అనేది PagedAttention ద్వారా సమర్థవంతమైన KV-cache నిర్వహణతో ముడిపడిన ఓపెన్-సోర్స్ ఇన్ఫరెన్స్, సర్వింగ్ ఇంజిన్. ఇది నిరంతర బ్యాచింగ్, ప్రిఫిక్స్ కాషింగ్, క్వాంటైజేషన్, స్పెక్యులేటివ్ డీకోడింగ్, స్ట్రక్చర్డ్ అవుట్పుట్లు, పంపిణీ అమలు వంటి సామర్థ్యాలకు మద్దతు ఇస్తుంది.
బహుళ-యూజర్ మోడల్-సర్వింగ్ వాతావరణాలకు ఇది సంబంధిత అభ్యర్థి, అయితే వ్యక్తిగత ఫీచర్లు మోడల్, హార్డ్వేర్, బ్యాకెండ్, వెర్షన్పై ఆధారపడి ఉంటాయి. మూలం: vLLM documentation
SGLang
SGLang లాంగ్వేజ్-మోడల్ ఇన్ఫరెన్స్, సర్వింగ్ సామర్థ్యాలను అందిస్తుంది, వీటిలో అమలు షెడ్యూలింగ్, కాష్ సంబంధిత ఆప్టిమైజేషన్లు, స్ట్రక్చర్డ్ జనరేషన్, టూల్-కాలింగ్ మద్దతు ఉన్నాయి. ఆఫ్లైన్ అమలును, ఆన్లైన్ సర్వింగ్ను మూల్యాంకనం చేయడానికి బెంచ్మార్కింగ్ టూల్స్ను కూడా ఇది అందిస్తుంది.
ఈ సామర్థ్యాలు డిమాండ్ ఎక్కువగా ఉన్న సర్వింగ్ అవసరాలున్న అప్లికేషన్లకు దీన్ని సంబంధితంగా చేస్తాయి, కానీ ఏజెంటిక్ వర్క్లోడ్లకు ఇది అన్ని సందర్భాల్లో వేగవంతమైనదని అవి నిరూపించవు. మూలం: SGLang documentation
LMDeploy
LMDeploy, TurboMind, PyTorch వంటి అమలు బ్యాకెండ్ల ద్వారా మోడల్ సర్వింగ్కు మద్దతు ఇస్తుంది. ఇది క్వాంటైజేషన్ ఎంపికలను, సర్వింగ్ ఇంటర్ఫేస్లను, పనితీరు మూల్యాంకన టూల్స్ను అందిస్తుంది.
దాని మోడల్ మద్దతు, ఆప్టిమైజేషన్ సామర్థ్యాలు బ్యాకెండ్ను బట్టి మారుతాయి, కాబట్టి అనుకూలత తనిఖీలు ప్రత్యేకంగా ముఖ్యం. మూలం: LMDeploy documentation
llama.cpp ఎక్కడ సరిపోతుంది
llama.cpp మరో సంబంధిత ఇన్ఫరెన్స్ రన్టైమ్, ముఖ్యంగా పోర్టబుల్ అమలు, క్వాంటైజ్ చేసిన మోడల్లు, వనరులు పరిమితంగా ఉన్న హార్డ్వేర్ కోసం. ఇది సర్వింగ్ సామర్థ్యాలను కూడా అందిస్తుంది, కొన్ని ప్రొడక్షన్ వాతావరణాలకు తగినదిగా ఉండవచ్చు.
ఊహించదగిన ట్రాఫిక్ ఉన్న చిన్న అప్లికేషన్కు మరింత సంక్లిష్టమైన సర్వింగ్ నిర్మాణం అవసరం లేకపోవచ్చు. డిమాండ్ ఎక్కువగా ఉన్న వర్క్లోడ్లకు అదనపు ఇంజిన్లను మూల్యాంకనం చేయడం సమర్థనీయం కావచ్చు. ఆచరణాత్మక ప్రశ్న ఏ ప్రాజెక్ట్ అత్యంత ప్రాచుర్యం పొందిందన్నది కాదు, అప్లికేషన్ నిజమైన అవసరాలకు ఏ అమలు మద్దతిస్తుందన్నదే.
| ఇంజిన్ | దాని డాక్యుమెంటేషన్ హైలైట్ చేసేవి | ముందు తనిఖీ చేయాల్సినవి |
|---|---|---|
| vLLM | PagedAttention ద్వారా KV-cache నిర్వహణ, నిరంతర బ్యాచింగ్, ప్రిఫిక్స్ కాషింగ్, క్వాంటైజేషన్, స్పెక్యులేటివ్ డీకోడింగ్, స్ట్రక్చర్డ్ అవుట్పుట్లు, పంపిణీ అమలు | వీటిలో ఏ ఫీచర్లకు మీ మోడల్, హార్డ్వేర్, బ్యాకెండ్, వెర్షన్ మద్దతు ఇస్తాయి |
| SGLang | అమలు షెడ్యూలింగ్, కాష్ సంబంధిత ఆప్టిమైజేషన్లు, స్ట్రక్చర్డ్ జనరేషన్, టూల్-కాలింగ్ మద్దతు, ఆఫ్లైన్, ఆన్లైన్ సర్వింగ్ కోసం బెంచ్మార్కింగ్ టూల్స్ | దాని బలాలు మీ వర్క్లోడ్కు వర్తిస్తాయా, ఎందుకంటే అవి ఏజెంటిక్ పనులకు అన్ని సందర్భాల్లో వేగవంతమైనదని నిరూపించవు |
| LMDeploy | TurboMind, PyTorch బ్యాకెండ్లు, క్వాంటైజేషన్ ఎంపికలు, సర్వింగ్ ఇంటర్ఫేస్లు, పనితీరు మూల్యాంకన టూల్స్ | బ్యాకెండ్ను బట్టి మారే మోడల్ మద్దతు, ఆప్టిమైజేషన్లు |
| llama.cpp | పోర్టబుల్ అమలు, క్వాంటైజ్ చేసిన మోడల్లు, వనరులు పరిమితంగా ఉన్న హార్డ్వేర్, సర్వింగ్ సామర్థ్యాలు | ఊహించదగిన ట్రాఫిక్ ఉన్న చిన్న అప్లికేషన్కు మరింత సంక్లిష్టమైన ఇంజిన్ అవసరమా |
వేగాన్ని పోల్చే ముందు, అనుకూలతను ధృవీకరించండి
మన అంతర్గత అసిస్టెంట్ ఇప్పుడు సాధారణ సంభాషణలకు, పత్రాల ఆధారిత ప్రశ్నలకు, స్ట్రక్చర్డ్ సమాధానాలకు, కొన్ని టూల్ వాడే వర్క్ఫ్లోలకు మద్దతు ఇవ్వాలి. టీమ్ అనేక ఇన్ఫరెన్స్ ఇంజిన్లను షార్ట్లిస్ట్ చేస్తుంది.
వాటిని బెంచ్మార్క్ చేసే ముందు, ప్రతి అభ్యర్థి అప్లికేషన్ను సరిగా నడపగలదని అది ధృవీకరించాలి. ముఖ్యమైన తనిఖీల్లో మోడల్, టోకెనైజర్ అనుకూలత, మద్దతు ఉన్న కాంటెక్స్ట్ నిడివి, హార్డ్వేర్ అవసరాలు, చాట్ టెంప్లేట్లు, స్ట్రీమింగ్, స్ట్రక్చర్డ్ అవుట్పుట్లు, టూల్-కాల్ ప్రవర్తన ఉన్నాయి.
రెండు ఇంజిన్లు OpenAI-compatible APIలను అందించినా, అవి ఒకేలా ప్రవర్తించవు. మద్దతు ఉన్న పారామీటర్లు, మోడల్-నిర్దిష్ట టెంప్లేట్లు, నియంత్రిత-జనరేషన్ ప్రవర్తన, టూల్-కాల్ పార్సింగ్లో అవి భిన్నంగా ఉండవచ్చు.
ఉదాహరణకు, ఒక ఇంజిన్ టెక్స్ట్ను వేగంగా ఉత్పత్తి చేయవచ్చు, కానీ అప్లికేషన్ కోరే స్కీమాకు సరిపోని JSONను తిరిగి ఇవ్వవచ్చు. అదేవిధంగా, అప్లికేషన్ టూల్-కాల్ అవుట్పుట్ను నమ్మదగినంతగా అర్థం చేసుకునే ముందు దానికి మోడల్-నిర్దిష్ట కాన్ఫిగరేషన్ అవసరం కావచ్చు.
టూల్-కాల్ అభ్యర్థనను రూపొందించడంలో ఇన్ఫరెన్స్ ఇంజిన్ సహాయపడవచ్చు, కానీ కోరిన చర్యను అనుమతించడం, అమలు చేయడం అప్లికేషన్ బాధ్యతగానే ఉంటుంది. అభ్యర్థులు ఒకే క్రియాత్మక అవసరాలను తీర్చిన తర్వాత మాత్రమే పనితీరు పోలికలకు అర్థం ఉంటుంది.
అప్లికేషన్కు చెల్లుబాటయ్యే అవుట్పుట్లను నమ్మదగినంతగా ఇవ్వలేని ఇంజిన్, సెకనుకు ఎక్కువ టోకెన్లను ఉత్పత్తి చేస్తుందన్న కారణంతో గెలవకూడదు.
ఇన్ఫరెన్స్ పనితీరును ఎలా కొలవాలి
అనుకూలత నిర్ధారణ అయిన తర్వాత, పనితీరు పరీక్ష మొదలుపెట్టవచ్చు. మొదటి ప్రశ్న, యూజర్లు నిజంగా ఏమి అనుభవిస్తారన్నది.
ఒక ఉద్యోగి అభ్యర్థనను సమర్పించినప్పుడు, మొదటి టోకెన్ కనిపించే ముందు ఆలస్యం ఉండవచ్చు. తర్వాత ఉత్పత్తి పూర్తయ్యే వరకు సమాధానం క్రమంగా వస్తుంది. వేర్వేరు కొలతలు ఆ అనుభవంలోని వేర్వేరు భాగాలను వివరిస్తాయి.
| కొలత | అర్థం | ఆచరణాత్మక ప్రాముఖ్యత |
|---|---|---|
| మొదటి టోకెన్ వరకు సమయం (TTFT) | మొదటి ఉత్పత్తి అయిన టోకెన్ రావడానికి ముందు ఆలస్యం | ఇంటరాక్టివ్ ప్రతిస్పందన |
| టోకెన్ల మధ్య లేటెన్సీ (ITL) | వరుసగా ఉత్పత్తి అయ్యే టోకెన్ల మధ్య సమయం | స్ట్రీమ్ అయ్యే సమాధానాల సాఫీదనం |
| ఎండ్-టు-ఎండ్ లేటెన్సీ | సమాధానం పూర్తయ్యే వరకు మొత్తం సమయం | పూర్తి పని పూర్తయ్యే సమయం |
| థ్రూపుట్ | ఒక యూనిట్ సమయంలో పూర్తయిన అభ్యర్థనలు లేదా టోకెన్లు | సర్వింగ్ సామర్థ్యం |
| విజయవంతమైన అభ్యర్థనల రేటు | అప్లికేషన్ అవసరాల ప్రకారం పూర్తయిన అభ్యర్థనలు | వాస్తవంగా వాడదగిన సామర్థ్యం |
కొన్ని వ్యక్తిగత అభ్యర్థనలు ఎక్కువ ఆలస్యాన్ని ఎదుర్కొంటున్నా, ఇంజిన్ అధిక థ్రూపుట్ను సాధించగలదు. ఏ సమతుల్యం మేలన్నది వర్క్లోడ్పై ఆధారపడి ఉంటుంది. సంభాషణ అసిస్టెంట్కు, వేగవంతమైన ప్రారంభ ప్రతిస్పందనలు ముఖ్యం కావచ్చు. రాత్రిపూట పత్రాల ప్రాసెసింగ్కు, మొత్తం థ్రూపుట్, నిర్వహణ ఖర్చు ఎక్కువ ముఖ్యం కావచ్చు.
సగటులు ఎందుకు తప్పుదోవ పట్టించగలవు
సగటు లేటెన్సీ ప్రతిస్పందన సమయాల పూర్తి పంపిణీని వెల్లడించదు. ఒక వ్యవస్థ చాలా అభ్యర్థనలను త్వరగా అందించవచ్చు, కానీ చిన్న శాతం అభ్యర్థనలు గణనీయమైన ఆలస్యాన్ని ఎదుర్కొంటాయి.
అందుకే ఇంజనీర్లు P95, P99 వంటి పర్సంటైల్లను పరిశీలిస్తారు. ఉదాహరణకు, P95 లేటెన్సీ అనేది కొలిచిన అభ్యర్థనల్లో సుమారు 95% ఆ విలువలో లేదా అంతకంటే తక్కువలో పూర్తయ్యే విలువను గుర్తిస్తుంది.
పనితీరు మూల్యాంకనంలో ఎర్రర్లు, టైమ్అవుట్లు, రద్దులు, చెల్లని సమాధానాలు కూడా ఉండాలి. విఫలమైన అభ్యర్థనలను మినహాయిస్తే, వ్యవస్థ వాస్తవం కంటే సమర్థవంతంగా కనిపించవచ్చు. మూలం: NVIDIA AIPerf metrics reference
ఇన్ఫరెన్స్-ఇంజిన్ బెంచ్మార్క్లు ఎందుకు పరస్పరం విభేదిస్తాయి
ఒక బెంచ్మార్క్ SGLang, vLLM కంటే మెరుగ్గా పనిచేస్తుందని నివేదించవచ్చు. మరొకటి దానికి వ్యతిరేకంగా నివేదించవచ్చు. ఆ ఫలితాలు తప్పనిసరిగా పరస్పర విరుద్ధం కావు.
పనితీరు మోడల్ ఆర్కిటెక్చర్, మోడల్ పరిమాణం, ప్రెసిషన్, యాక్సిలరేటర్, ఏకకాలత, ఇన్పుట్, అవుట్పుట్ నిడివి, సర్వింగ్ కాన్ఫిగరేషన్పై ఆధారపడి ఉంటుంది. ఒక GPUపై చిన్న మోడల్తో చేసిన బెంచ్మార్క్, అనేక యాక్సిలరేటర్లకు పంపిణీ అయిన పెద్ద మోడల్కు మేలైన ఇంజిన్ ఏదో నిరూపించదు. ఇంజిన్లు వేర్వేరు ఆప్టిమైజేషన్ సెట్టింగ్లను వాడితే, ఒకేలాంటి హార్డ్వేర్ ఉన్నా న్యాయమైన పోలికకు హామీ ఉండదు.
అందువల్ల ఇంజనీర్లు రెండు రకాల మూల్యాంకనాల మధ్య తేడా చూపాలి:
- నియంత్రిత పోలిక (Controlled comparison): ఇంజిన్ల మధ్య తేడాలను అర్థం చేసుకోవడానికి వీలైనన్ని వేరియబుల్స్ను స్థిరంగా ఉంచండి.
- ఉత్తమ ఆచరణాత్మక కాన్ఫిగరేషన్ (Best practical configuration): అప్లికేషన్ అవసరాలను ఏ డిప్లాయ్మెంట్ అత్యంత సమర్థవంతంగా తీరుస్తుందో నిర్ణయించడానికి, ప్రతి అభ్యర్థిని తగిన విధంగా ఆప్టిమైజ్ చేయండి.
రెండూ ఉపయోగకరమే, కానీ అవి వేర్వేరు ప్రశ్నలకు సమాధానం ఇస్తాయి.
ఆఫ్లైన్ vs ఆన్లైన్ బెంచ్మార్క్లు
ఆఫ్లైన్ బెంచ్మార్క్ పూర్తి API-సర్వింగ్ మార్గం లేకుండా మోడల్ అమలును కొలవగలదు. ఆన్లైన్ బెంచ్మార్క్ నడుస్తున్న సేవకు అభ్యర్థనలను పంపుతుంది, అభ్యర్థన నిర్వహణ, షెడ్యూలింగ్ వంటి అదనపు ప్రభావాలను కలుపుకుంటుంది.
ఆఫ్లైన్ ఫలితాన్ని, అవి ఒకే పరిస్థితులను కొలుస్తున్నట్లుగా, ఆన్లైన్ ఫలితంతో నేరుగా పోల్చకూడదు. SGLang’s serving benchmark guide మద్దతు ఉన్న సర్వింగ్ బ్యాకెండ్లలో వర్క్లోడ్ జనరేషన్ను, పనితీరు పరీక్షను వివరిస్తుంది.
పరిశ్రమ బెంచ్మార్క్లు కూడా అభివృద్ధి చెందుతూనే ఉన్నాయి. September 2026లో విడుదలైన MLPerf Inference v6.1, ఎండ్-టు-ఎండ్ రిట్రీవల్-ఆగ్మెంటెడ్ జనరేషన్, ఏజెంటిక్ ఇన్ఫరెన్స్ వంటి వర్క్లోడ్లపై శ్రద్ధను విస్తరించింది. ఈ పరిణామాలు ఇన్ఫరెన్స్ వ్యవస్థలను మూల్యాంకనం చేయడానికి అందుబాటులో ఉన్న పద్ధతులను మెరుగుపరుస్తాయి, కానీ ప్రతి అప్లికేషన్కు ఒక ఇంజిన్ను ఉత్తమమైనదిగా అవి గుర్తించవు. మూలం: MLCommons, MLPerf Inference
అప్లికేషన్ చుట్టూ బెంచ్మార్క్ను నిర్మించండి
మన ఎంటర్ప్రైజ్ అసిస్టెంట్ కోసం, ఉపయోగకరమైన పరీక్షలో మూడు ప్రాతినిధ్య వర్క్లోడ్లు ఉండాలి. చిన్న ప్రశ్నలు ఇంటరాక్టివ్ ప్రతిస్పందనను వెల్లడిస్తాయి. పొడవైన పత్రాల అభ్యర్థనలు ఇన్పుట్ ప్రాసెసింగ్, మెమరీ డిమాండ్లను బయటపెడతాయి. స్ట్రక్చర్డ్-అవుట్పుట్, టూల్ వాడే అభ్యర్థనలు పనితీరుతో పాటు కచ్చితత్వాన్ని పరీక్షిస్తాయి.
టీమ్ ఏకకాలతను క్రమంగా పెంచి, ఎక్కువ ట్రాఫిక్లో ప్రతి ఇంజిన్ ఎలా ప్రవర్తిస్తుందో గమనించాలి. పునరుత్పత్తి కోసం, పరీక్ష రికార్డు కచ్చితమైన మోడల్ రివిజన్, ఇంజిన్ వెర్షన్, హార్డ్వేర్, సంఖ్యా ప్రెసిషన్, ఆప్టిమైజేషన్ సెట్టింగ్లు, కొలత పద్ధతిని గుర్తించాలి.
తుది పోలికలో లేటెన్సీ పర్సంటైల్లు, థ్రూపుట్, ఎర్రర్లు, వనరుల వినియోగం, విజయవంతంగా పూర్తయిన అప్లికేషన్-చెల్లుబాటు అభ్యర్థనలను పరిగణనలోకి తీసుకోవాలి. లక్ష్యం సార్వత్రిక లీడర్బోర్డ్ను తయారు చేయడం కాదు. ఈ అప్లికేషన్ అవసరాలను ఏ కాన్ఫిగరేషన్ తీరుస్తుందో నిర్ణయించడమే.
ఇన్ఫరెన్స్ ఇంజిన్ దేని నుంచి రక్షించదు
బెంచ్మార్క్ సాధారణంగా ఇంజిన్ను సౌకర్యవంతమైన పరిస్థితుల్లో కొలుస్తుంది, కాబట్టి ఆ పరిస్థితులు ఎక్కడ సౌకర్యంగా ఉండటం ఆగిపోతాయో కనుగొనేలా కూడా పరీక్ష ఉండాలి. ఒక బ్యాచ్లోని అన్ని అభ్యర్థనలను KV-cache భరించలేనప్పుడు, ఇంజిన్ అదనపు పనితో ఏదో ఒకటి చేయాల్సి ఉంటుంది. ఉదాహరణకు vLLM ఒక అభ్యర్థనను ప్రీఎంప్ట్ చేసి తర్వాత మళ్లీ గణించగలదు, ఇది ఎండ్-టు-ఎండ్ లేటెన్సీపై ప్రతికూల ప్రభావం చూపవచ్చని దాని డాక్యుమెంటేషన్ హెచ్చరిస్తుంది. మూలం: vLLM optimization and tuning guide
ఇతర ఇంజిన్లు మెమరీ ఒత్తిడిని తమదైన పద్ధతుల్లో నిర్వహిస్తాయి. ప్రతి అభ్యర్థి విషయంలో, మెమరీ అయిపోయినప్పుడు అభ్యర్థనకు ఏమవుతుందో అడగండి: అది వేచి ఉంటుందా, మళ్లీ మొదలవుతుందా, అందరినీ నెమ్మదింపజేస్తుందా లేదా విఫలమవుతుందా, మరియు అప్లికేషన్ ఆ తేడాను గుర్తించగలదా.
ఇన్ఫరెన్స్ ఇంజిన్ డిఫాల్ట్గా భద్రతా సరిహద్దు కూడా కాదు. vLLM భద్రతా గైడ్ ప్రకారం దాని API key సెట్టింగ్ కొన్ని ఎండ్పాయింట్ ప్రిఫిక్స్లను మాత్రమే రక్షిస్తుంది, కీ లేకుండానే అందుబాటులో ఉండే ఇతర ఎండ్పాయింట్లను జాబితా చేస్తుంది, బహిర్గతమయ్యే ఎండ్పాయింట్లను తగ్గించాలని, సర్వర్ను రివర్స్ ప్రాక్సీ వెనుక ఉంచాలని సిఫార్సు చేస్తుంది. బహుళ-నోడ్ డిప్లాయ్మెంట్లో నోడ్ల మధ్య కమ్యూనికేషన్ డిఫాల్ట్గా అసురక్షితమని, దాన్ని ఐసోలేటెడ్ నెట్వర్క్తో రక్షించాలని కూడా అది స్పష్టం చేస్తుంది. మూలం: vLLM security guide
ఆచరణాత్మక నియమం ఏమిటంటే, ప్రామాణీకరణ, అభ్యర్థన పరిమితులు, నెట్వర్క్ ఐసోలేషన్ పైన వివరించిన గేట్వే, ప్లాట్ఫారమ్ పొరలకు చెందుతాయి, మరియు ఇంజిన్ను నేరుగా యూజర్లకు లేదా నమ్మకం లేని నెట్వర్క్లకు బహిర్గతం చేయకూడదు. ఇతర ఇంజిన్ విషయంలో, అదే విధంగా ప్రవర్తిస్తుందని భావించే ముందు దాని భద్రతా డాక్యుమెంటేషన్ చదవండి.
రికవరీకి మొదటి ఇన్సిడెంట్ రాకముందే సిద్ధత అవసరం. బెంచ్మార్క్లలోనే కాక ప్రొడక్షన్లో కూడా కచ్చితమైన మోడల్ రివిజన్ను, ఇంజిన్ వెర్షన్ను నమోదు చేయండి, మునుపటి ఇంజిన్ ఇమేజ్ను డిప్లాయ్ చేయగలిగేలా ఉంచండి, కొత్త వెర్షన్ను అందరికీ మార్చే ముందు ట్రాఫిక్లో చిన్న భాగానికి పంపండి.
తర్వాత అసౌకర్య సందర్భాలను ఉద్దేశపూర్వకంగా పరీక్షించండి: బిజీ ట్రాఫిక్ మధ్యలో రీస్టార్ట్, లోడ్ కాని మోడల్, రోల్బ్యాక్, మరియు యూజర్లు ఎంతసేపు ప్రభావితమవుతారో కొలవండి. ఇంజిన్ అప్గ్రేడ్ మద్దతు ఉన్న పారామీటర్లను, టెంప్లేట్లను, టూల్-కాల్ ప్రవర్తనను మార్చవచ్చు, కాబట్టి ముందు చేసిన అనుకూలత తనిఖీలను ప్రతి అప్గ్రేడ్ తర్వాత మళ్లీ చేయాలి.
డిప్లాయ్మెంట్ తర్వాత ఏమి జరుగుతుంది
బలమైన బెంచ్మార్క్ ఫలితం ప్రొడక్షన్ విశ్వసనీయతను నిరూపించదు. సర్వింగ్ వ్యవస్థ అభ్యర్థన రద్దు, వనరుల అయిపోవడం, ఊహించని ట్రాఫిక్, విఫలమైన మోడల్ లోడ్లు, రీస్టార్ట్లు, సాఫ్ట్వేర్ అప్గ్రేడ్లను కూడా నిర్వహించాలి.
ఈ బాధ్యతలు ఇన్ఫరెన్స్ ఇంజిన్కు మించి విస్తరిస్తాయి. API గేట్వే ప్రామాణీకరణను, అభ్యర్థన పరిమితులను నిర్వహించవచ్చు. ఆర్కెస్ట్రేషన్ ప్లాట్ఫారమ్ సర్వింగ్ ప్రక్రియను పర్యవేక్షించవచ్చు. అప్లికేషన్ సెషన్లను, డాక్యుమెంట్ రిట్రీవల్ను, టూల్ అనుమతిని, టైమ్అవుట్లను నియంత్రించవచ్చు. ప్రతి బాధ్యత ఎక్కడ ఉండాలో టీమ్ నిర్ణయించుకోవాలి.
మానిటరింగ్, ట్రబుల్షూటింగ్
ఉద్యోగులు సమాధానాలు నెమ్మదిగా వస్తున్నాయని నివేదించారనుకోండి. కారణం పెరిగిన ట్రాఫిక్కా, పొడవైన ప్రాంప్ట్లా, అభ్యర్థన క్యూలా, మెమరీ ఒత్తిడా, మోడల్ అమలా లేదా దిగువ అప్లికేషన్ ఆధారపడే అంశమా అని టీమ్ నిర్ధారించగలగాలి.
ఇన్ఫరెన్స్ ఇంజిన్లు సాధారణంగా ఆపరేషనల్ మెట్రిక్లను అందిస్తాయి. ఉదాహరణకు, vLLM తన సర్వింగ్ వాతావరణం కోసం Prometheus-అనుకూల మెట్రిక్లను అందిస్తుంది. ఉపయోగకరమైన అబ్జర్వబిలిటీకి ఆ ఇంజిన్ మెట్రిక్లను అప్లికేషన్-స్థాయి ప్రవర్తనతో అనుసంధానించడం అవసరం.
అభ్యర్థన సమయంలో ఎక్కువ భాగాన్ని డాక్యుమెంట్ రిట్రీవల్ తీసుకుంటే, ఇన్ఫరెన్స్ ఇంజిన్లను మార్చడం వల్ల మెరుగుదల తక్కువగా ఉండవచ్చు. పూర్తి యూజర్ అనుభవాన్ని వివరించడానికి GPUను మాత్రమే మానిటర్ చేయడం సరిపోదు.
వేగవంతమైన ఇన్ఫరెన్స్ ఖర్చులను తగ్గించగలదు, కానీ ఆటోమేటిక్గా కాదు
ఎక్కువ థ్రూపుట్, ఎక్కువగా వినియోగిస్తున్న డిప్లాయ్మెంట్ను అదే హార్డ్వేర్తో ఎక్కువ అభ్యర్థనలను అందించడానికి అనుమతించవచ్చు, లేదా అవసరమైన యాక్సిలరేటర్ ఇన్స్టెన్స్ల సంఖ్యను తగ్గించవచ్చు. అయితే, తక్కువగా వాడే, నిరంతరం బిల్ అయ్యే GPUపై థ్రూపుట్ పెంచడం ఖర్చును తగ్గించకపోవచ్చు. ఆర్థిక అంచనాలో మౌలిక సదుపాయాల ఛార్జీలు, వినియోగం, విజయవంతమైన అభ్యర్థనలు, ఇంజనీరింగ్ శ్రమ, నిర్వహణ, ఆపరేషనల్ సంక్లిష్టత ఉండాలి.
ఉపయోగకరమైన పోలిక, సిద్ధాంతపరమైన టోకెన్కు అయ్యే ఖర్చును కాక, అప్లికేషన్ సర్వీస్ అవసరాలను తీర్చడానికి అయ్యే ఖర్చును కొలుస్తుంది.
టీమ్ ఇన్ఫరెన్స్ ఇంజిన్ను ఎలా ఎంచుకోవచ్చు
మన అంతర్గత అసిస్టెంట్ ఒక్క యూజర్ ప్రదర్శనగా మొదలైంది. ఇప్పుడు అనేక అభ్యర్థన రకాలు, యూజర్లకు నమ్మదగిన సర్వింగ్ అవసరం. నిర్ణయాన్ని క్రమబద్ధంగా సమీపించడానికి ఇంజనీరింగ్ టీమ్కు తగినంత అవగాహన ఉంది.
మొదట, స్వీయ-నిర్వహణ ఇన్ఫరెన్స్ అవసరమా అని అది నిర్ణయించుకోవాలి. మౌలిక సదుపాయాల బాధ్యతలను తగ్గిస్తూనే, మేనేజ్డ్ ఇన్ఫరెన్స్ సేవ ఇప్పటికే అప్లికేషన్ అవసరాలను తీర్చవచ్చు. స్వీయ-నిర్వహణ సర్వింగ్ సమర్థనీయమైతే, టీమ్ అనుకూలమైన ఇంజిన్లను మూల్యాంకనం చేయవచ్చు.
| నిర్ణయం | ఏమి నిర్ధారించుకోవాలి |
|---|---|
| డిప్లాయ్మెంట్ విధానం | మేనేజ్డ్ సేవ లేదా స్వీయ-నిర్వహణ సర్వింగ్ |
| అనుకూలత | అవసరమైన మోడల్, హార్డ్వేర్, అవుట్పుట్లు, అనుసంధానాలు |
| పనితీరు | లేటెన్సీ, థ్రూపుట్, వాస్తవిక ట్రాఫిక్లో ప్రవర్తన |
| విశ్వసనీయత | వనరుల పరిమితులు, వైఫల్యాలు, మానిటరింగ్, పునరుద్ధరణ |
| ఆర్థికాంశాలు | మౌలిక సదుపాయాల ఖర్చులు, ఆపరేషనల్ శ్రమ, మైగ్రేషన్ విలువ |
కొన్నిసార్లు ప్రస్తుత ఇంజిన్ ఉత్తమ ఆచరణాత్మక ఎంపికగా మిగులుతుంది. ఒక పోటీ ఇంజిన్ ఎక్కువ థ్రూపుట్ను అందించవచ్చు, కానీ ఆ మెరుగుదలను మించిపోయే అనుకూలత లేదా నిర్వహణ ఖర్చులను తేవచ్చు. మరో ఉత్పత్తి పబ్లిక్ బెంచ్మార్క్లో ముందున్నందున మైగ్రేట్ కావాలన్న నిబంధన ఏదీ లేదు.
అదేవిధంగా, పనితీరు, విశ్వసనీయత అవసరాలు ఇప్పటికే తీరుతున్న అప్లికేషన్కు సరళమైన రన్టైమ్ సరిపోవచ్చు. నిర్ణయం కొలవదగిన అప్లికేషన్ అవసరాలను అనుసరించాలి, సాంకేతికత ప్రాచుర్యాన్ని కాదు.
ఇన్ఫరెన్స్ ఇంజిన్లను నిపుణులు ఎంత లోతుగా అర్థం చేసుకోవాలి
వేర్వేరు పాత్రలకు వేర్వేరు స్థాయిల జ్ఞానం అవసరం.
అప్లికేషన్ డెవలపర్లు ప్రతిస్పందన లేటెన్సీ, API అనుకూలత, స్ట్రీమింగ్, అవుట్పుట్ ధృవీకరణ, తమ మోడల్ అభ్యర్థనల పర్యవసానాలను అర్థం చేసుకోవాలి.
ఇన్ఫరెన్స్ మౌలిక సదుపాయాలను నిర్వహించే ప్లాట్ఫారమ్ ఇంజనీర్లు, SREలకు వనరుల వినియోగం, ఏకకాలత, మానిటరింగ్, డిప్లాయ్మెంట్, విశ్వసనీయత, సామర్థ్య ప్రణాళికపై లోతైన జ్ఞానం అవసరం.
మోడల్ అమలును ఆప్టిమైజ్ చేసే AI మౌలిక సదుపాయాల నిపుణులు షెడ్యూలింగ్ అల్గారిథమ్లు, KV-cache నిర్వహణ, క్వాంటైజేషన్, పారలెలిజం, యాక్సిలరేటర్-నిర్దిష్ట పద్ధతులను కూడా అర్థం చేసుకోవాల్సి రావచ్చు.
ప్రతి ఒక్కరూ ఇన్ఫరెన్స్-ఇంజిన్ అంతర్గత వివరాలను పూర్తిగా నేర్చుకోవాల్సిన అవసరం లేదు. తగిన లోతు, ఒక నిపుణుడు సర్వింగ్ మౌలిక సదుపాయాలను వినియోగిస్తారా, నిర్వహిస్తారా లేదా ఆప్టిమైజ్ చేస్తారా అన్నదానిపై ఆధారపడి ఉంటుంది.
సరైన ఇంజనీరింగ్ నిర్ణయం తీసుకోవడం
AI మోడల్ల అవుట్పుట్లు కనిపిస్తాయి కాబట్టి అవి దృష్టిని ఆకర్షిస్తాయి. ఇన్ఫరెన్స్ ఇంజిన్లు ఆ అవుట్పుట్ల వెనుక పనిచేస్తూ, ప్రొడక్షన్ సర్వింగ్ను సాధ్యం చేసే గణన పనిని నిర్వహిస్తాయి. అప్లికేషన్లు ఏకకాల ట్రాఫిక్, మారే అభ్యర్థన నిడివి, మెమరీ పరిమితులు, సర్వీస్-స్థాయి అవసరాలను ఎదుర్కొన్నప్పుడు వాటి ప్రాముఖ్యత మరింత స్పష్టమవుతుంది.
కాబట్టి ఇన్ఫరెన్స్ ఇంజిన్ను ఎంచుకోవడానికి బెంచ్మార్క్ సంఖ్యలను పోల్చడం కంటే ఎక్కువ అవసరం. అప్లికేషన్ అనుకూలతను ధృవీకరించడం, ప్రాతినిధ్య వర్క్లోడ్లను పరీక్షించడం, ఆపరేషనల్ బాధ్యతలను అర్థం చేసుకోవడం, సర్వీస్ అవసరాలను తీర్చడానికి అయ్యే మొత్తం ఖర్చును మూల్యాంకనం చేయడం ఇంజనీర్ల బాధ్యత.
ఉత్పత్తులు, బెంచ్మార్క్ ర్యాంకింగ్లు మారుతూనే ఉంటాయి. అంతర్లీన నిర్ణయం మాత్రం అలాగే ఉంటుంది.
వేరొకరి బెంచ్మార్క్లో అత్యుత్తమంగా పనిచేసేదాన్ని కాక, ఆమోదయోగ్యమైన పనితీరు, విశ్వసనీయత, ఖర్చు, ఆపరేషనల్ సంక్లిష్టతతో అప్లికేషన్ అవసరాలను తీర్చే ఇన్ఫరెన్స్ ఇంజిన్ను ఎంచుకోండి.
మరింత లోతుగా
- vLLM, Official Documentation, vLLM project. ఇంజిన్ నిర్మాణం, PagedAttention, షెడ్యూలింగ్, మోడల్ అనుకూలత, సర్వింగ్ ఫీచర్లు.
- SGLang, Official Documentation, SGLang project. మోడల్ అమలు, స్ట్రక్చర్డ్ జనరేషన్, టూల్ కాలింగ్, డిప్లాయ్మెంట్ సామర్థ్యాలు.
- SGLang, Serving Benchmark Guide, SGLang project. వర్క్లోడ్ జనరేషన్, ఏకకాలత, ఆన్లైన్-సర్వింగ్ కొలతలు.
- LMDeploy, Official Documentation, LMDeploy project. TurboMind, PyTorch అమలు బ్యాకెండ్లు, మోడల్ మద్దతు, సర్వింగ్.
- llama.cpp, Official Repository, llama.cpp project. పోర్టబుల్ ఇన్ఫరెన్స్, క్వాంటైజ్ చేసిన అమలు, సర్వర్ సామర్థ్యాలు.
- NVIDIA, AIPerf Metrics Reference, NVIDIA. ఇన్ఫరెన్స్ లేటెన్సీ, థ్రూపుట్, సంబంధిత కొలతల నిర్వచనాలు.
- MLCommons, MLPerf Inference, MLCommons. బెంచ్మార్క్ పద్ధతి, ప్రచురితమైన ఇన్ఫరెన్స్-వ్యవస్థ ఫలితాలు.
- vLLM, Optimization and Tuning, vLLM project. ప్రీఎంప్షన్, KV-cache మెమరీ ఒత్తిడి.
- vLLM, Security, vLLM project. ఎండ్పాయింట్ రక్షణ, నోడ్ల మధ్య కమ్యూనికేషన్.
పరిశోధన ముగింపు తేదీ: October 20, 2026. కచ్చితమైన ఫీచర్ లభ్యతను, అనుకూలతను మూల్యాంకనం చేస్తున్న ఇంజిన్ విడుదలతో ధృవీకరించుకోవాలి.
TechiesJournalలో సంబంధిత రచనలు
- AI inference, load balancing గురించి మన ఆలోచనను ఎందుకు మారుస్తోంది ఒక సర్వర్ సరిపోనప్పుడు ఇన్ఫరెన్స్ రెప్లికాల మధ్య అభ్యర్థనలు ఎలా రూట్ అవుతాయో తెలుసుకోవడానికి.
- ఓపెన్ AI మోడళ్లను మీరే నడపడం: దానికి నిజంగా ఏమి కావాలి ఇంజిన్ను ఎంచుకునే ముందు వచ్చే స్వీయ-హోస్టింగ్ నిర్ణయం కోసం.