

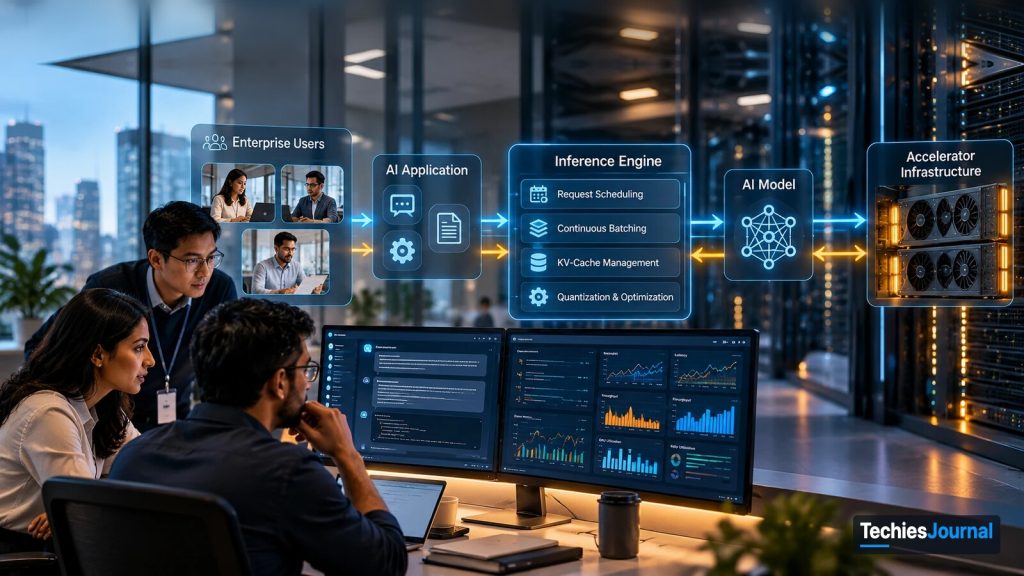
Ilustración de una pila de servicio de IA. Los paneles y gráficos que aparecen son decorativos, no mediciones reales.
Ejecutar un modelo de IA es una cosa. Conseguir que responda de forma fiable a muchos usuarios es otra. Entender los motores de inferencia ayuda a los equipos de ingeniería a tomar mejores decisiones sobre el servicio de modelos sin depender de comparaciones de rendimiento engañosas.
Cómo responde un modelo de IA a una pregunta
Imagina una organización que crea un asistente de IA interno. Los empleados pueden usarlo para buscar documentación técnica, entender procedimientos internos y hacer preguntas sobre aplicaciones e infraestructura.
El equipo de desarrollo elige un modelo de lenguaje de pesos abiertos, lo ejecuta en una máquina con GPU y lo conecta a una interfaz de chat sencilla. Durante la demostración, todo funciona. Un empleado hace una pregunta, el modelo la procesa y aparece una respuesta.
Este proceso se llama inferencia. Un modelo aprende patrones durante el entrenamiento. Durante la inferencia, usa sus parámetros entrenados para procesar nuevas entradas y generar salidas. Normalmente no se vuelve a entrenar cada vez que alguien hace una pregunta.
Los modelos de lenguaje producen las respuestas como secuencias de tokens, que pueden representar palabras, partes de palabras o signos de puntuación. Generar esos tokens requiere cómputo y memoria, y los recursos necesarios varían según el modelo y la carga de trabajo. En una demostración con un solo usuario, gestionar ese cómputo puede parecer sencillo. La producción plantea otro tipo de retos.
Qué hace un motor de inferencia de IA
Un modelo de IA y un motor de inferencia cumplen funciones distintas. El modelo contiene los parámetros entrenados y la estructura computacional que se usan para generar las salidas. El motor de inferencia es el software que se encarga de ejecutar ese modelo en el hardware disponible y de gestionar el trabajo computacional asociado.
Según su diseño, un motor de inferencia puede cargar modelos, planificar solicitudes, gestionar la memoria, agrupar operaciones en lotes y transmitir en streaming las respuestas generadas.
La relación básica es:
Usuario → Aplicación de IA → Motor de inferencia → Ejecución del modelo → Respuesta
Una aplicación en producción también puede incluir recuperación de documentos, autenticación, enrutamiento de red, monitorización y otros servicios. El motor de inferencia no sustituye a esos componentes.
Herramientas como Ollama, LM Studio y llama.cpp hacen accesible la ejecución local de modelos, con distintos niveles de capacidad para servirlos. Sistemas como vLLM, SGLang y LMDeploy ofrecen enfoques adicionales para gestionar cargas de trabajo de inferencia. La siguiente sección explica por qué una organización necesita estas capacidades en lugar de seguir con la configuración que funcionó durante el desarrollo.
Por qué la producción cambia el problema
La organización pone su asistente a disposición de varios cientos de empleados. Algunos hacen preguntas cortas. Otros envían documentos extensos. Llegan varias solicitudes a la vez, y la longitud de las respuestas varía considerablemente.
Estas solicitudes no consumen los mismos recursos de cómputo. Procesar un documento largo requiere más cómputo de entrada que procesar una pregunta corta. Generar una respuesta extensa también exige más trabajo que producir una respuesta breve.
A medida que crece el uso simultáneo, el sistema de servicio debe gestionar solicitudes que compiten entre sí y una memoria de GPU limitada. Los empleados pueden notar tiempos de respuesta irregulares aunque el hardware disponible parezca potente.
El problema ya no es simplemente si el modelo puede generar una respuesta. Es si el sistema de servicio puede atender solicitudes diferentes de forma eficiente y mantener un rendimiento aceptable.
Cómo gestionan los motores de inferencia las solicitudes simultáneas
En muchos modelos de lenguaje basados en transformers, la inferencia consta de dos etapas importantes. El prefill (prellenado) es la etapa en la que el modelo procesa los tokens de entrada y prepara la información necesaria para la generación. Las entradas más largas suelen generar más trabajo en esta etapa.
El decode (decodificación) es la etapa en la que el modelo genera los tokens de salida mediante pasos computacionales sucesivos. Las dos etapas tienen características computacionales distintas. Sus necesidades de recursos dependen del modelo, el hardware, la longitud de las solicitudes y la configuración de ejecución.
Cuando llegan varias solicitudes, una planificación eficiente se vuelve importante. Una técnica es el procesamiento por lotes continuo (continuous batching). En lugar de procesar un grupo fijo de solicitudes hasta que todas terminen, el motor puede ajustar el grupo activo a medida que se completan solicitudes y otras nuevas quedan listas. Esto puede mejorar el aprovechamiento del hardware y el throughput (el volumen de trabajo completado por unidad de tiempo).
La gestión de la memoria es igual de importante. Durante la generación, los modelos transformer suelen conservar información intermedia de atención de los tokens ya procesados. Es lo que se llama caché clave-valor (key-value cache), o caché KV. Conservar esta información evita repetir ciertos cálculos, pero la caché consume memoria. Más solicitudes simultáneas y secuencias más largas suelen aumentar las necesidades de memoria.
Los motores de inferencia usan estrategias distintas para gestionar esa memoria. Por ejemplo, vLLM introdujo PagedAttention, un enfoque que organiza la memoria de la caché KV en bloques para reducir las asignaciones ineficientes y aprovechar mejor la memoria.
Estas técnicas ayudan a explicar cómo un motor de inferencia puede mejorar el rendimiento sin cambiar el modelo subyacente. Fuente: documentación de vLLM
Texto alternativo accesible para esta figura
Dentro del motor, llegan a la vez solicitudes de distintas longitudes. Un planificador aplica procesamiento por lotes continuo, la etapa de prefill procesa los tokens de entrada, la etapa de decode genera los tokens de salida uno a uno y la respuesta se devuelve en streaming al usuario. Una caché KV en la memoria del acelerador da soporte al planificador, al prefill y al decode, y crece con más solicitudes simultáneas y secuencias más largas.
Alrededor del motor, un gateway de API puede encargarse de la autenticación y de los límites de solicitudes; la aplicación, de las sesiones, la recuperación de documentos, la autorización de herramientas y los tiempos de espera (timeouts); una plataforma de orquestación puede supervisar el proceso de servicio, y la monitorización debería unir las métricas del motor con el comportamiento de la aplicación.
Otras optimizaciones
A medida que las cargas de trabajo se vuelven más exigentes, otras técnicas pueden ayudar.
La cuantización usa una precisión numérica reducida para ciertos valores o cálculos del modelo. Puede reducir las necesidades de memoria y, potencialmente, mejorar el rendimiento, aunque hay que evaluar la compatibilidad y la calidad de las salidas.
El almacenamiento en caché de prefijos (prefix caching) reutiliza los cálculos aprovechables cuando las solicitudes comparten prefijos de prompt idénticos. Esto puede ayudar a las aplicaciones que envían una y otra vez las mismas instrucciones o el mismo contexto.
La decodificación especulativa usa tokens propuestos y un proceso de verificación para acelerar la generación en condiciones favorables.
Algunos despliegues también separan la ejecución del prefill y del decode, o reparten el cómputo del modelo entre varios aceleradores. No todas las aplicaciones se benefician por igual de estos métodos. La compatibilidad con cada función y su eficacia dependen del modelo, la versión del motor, el hardware y la carga de trabajo.
Entender estos mecanismos da a los ingenieros una base para evaluar los motores que los implementan.
Los motores de inferencia disponibles
Varios proyectos de código abierto ofrecen capacidades de ejecución de inferencia y de servicio de modelos. Sus funciones se solapan, pero su arquitectura, su compatibilidad y sus características operativas pueden ser distintas.
vLLM
vLLM es un motor de inferencia y servicio de código abierto asociado a una gestión eficiente de la caché KV mediante PagedAttention. Admite capacidades como el procesamiento por lotes continuo, el almacenamiento en caché de prefijos, la cuantización, la decodificación especulativa, las salidas estructuradas y la ejecución distribuida.
Es un candidato pertinente para entornos de servicio de modelos con varios usuarios, aunque cada función depende del modelo, el hardware, el backend y la versión. Fuente: documentación de vLLM
SGLang
SGLang ofrece capacidades de inferencia y servicio de modelos de lenguaje, entre ellas la planificación de la ejecución, optimizaciones relacionadas con la caché, la generación estructurada y la compatibilidad con llamadas a herramientas. También incluye herramientas de benchmarking para evaluar la ejecución offline y el servicio online.
Estas capacidades lo hacen pertinente para aplicaciones con requisitos de servicio exigentes, pero no demuestran que sea más rápido en todos los casos para cargas de trabajo agénticas. Fuente: documentación de SGLang
LMDeploy
LMDeploy permite servir modelos mediante backends de ejecución como TurboMind y PyTorch. Ofrece opciones de cuantización, interfaces de servicio y herramientas de evaluación del rendimiento.
Los modelos compatibles y las capacidades de optimización varían según el backend, lo que hace especialmente importante comprobar la compatibilidad. Fuente: documentación de LMDeploy
Dónde encaja llama.cpp
llama.cpp es otro entorno de ejecución de inferencia pertinente, sobre todo para la ejecución portable, los modelos cuantizados y el hardware con recursos limitados. También ofrece capacidades de servicio y puede ser adecuado para algunos entornos de producción.
Una aplicación más pequeña con tráfico predecible puede no necesitar una arquitectura de servicio más compleja. Las cargas de trabajo más exigentes pueden justificar la evaluación de otros motores. La pregunta práctica no es qué proyecto es el más popular, sino qué implementación cumple los requisitos reales de la aplicación.
| Motor | Qué destaca su documentación | Qué comprobar primero |
|---|---|---|
| vLLM | Gestión de la caché KV con PagedAttention, procesamiento por lotes continuo, caché de prefijos, cuantización, decodificación especulativa, salidas estructuradas, ejecución distribuida | Cuáles de estas funciones admiten tu modelo, tu hardware, tu backend y tu versión |
| SGLang | Planificación de la ejecución, optimizaciones relacionadas con la caché, generación estructurada, llamadas a herramientas, herramientas de benchmarking para servicio offline y online | Si sus puntos fuertes se aplican a tu carga de trabajo, porque no lo hacen más rápido en todos los casos para el trabajo agéntico |
| LMDeploy | Backends TurboMind y PyTorch, opciones de cuantización, interfaces de servicio, herramientas de evaluación del rendimiento | Modelos compatibles y optimizaciones que varían según el backend |
| llama.cpp | Ejecución portable, modelos cuantizados, hardware con recursos limitados, capacidades de servicio | Si una aplicación más pequeña con tráfico predecible necesita un motor más complejo |
Antes de comparar la velocidad, verifica la compatibilidad
Nuestro asistente interno necesita ahora admitir conversaciones normales, preguntas basadas en documentos, respuestas estructuradas y ciertos flujos de trabajo que usan herramientas. El equipo preselecciona varios motores de inferencia.
Antes de someterlos a benchmarks, debe verificar que cada candidato puede ejecutar la aplicación correctamente. Entre las comprobaciones importantes están la compatibilidad del modelo y del tokenizador, la longitud de contexto admitida, los requisitos de hardware, las plantillas de chat, el streaming, las salidas estructuradas y el comportamiento de las llamadas a herramientas.
Dos motores pueden exponer API compatibles con OpenAI sin comportarse de forma idéntica. Pueden diferir en los parámetros admitidos, las plantillas específicas de cada modelo, el comportamiento de la generación restringida y el análisis de las llamadas a herramientas.
Por ejemplo, un motor puede generar texto rápidamente pero devolver un JSON que no cumple el esquema que exige la aplicación. Del mismo modo, la salida de una llamada a herramienta puede requerir una configuración específica del modelo antes de que la aplicación pueda interpretarla de forma fiable.
El motor de inferencia puede ayudar a producir una solicitud de llamada a herramienta, pero la aplicación sigue siendo responsable de autorizar y ejecutar la acción solicitada. Las comparaciones de rendimiento solo tienen sentido cuando los candidatos cumplen los mismos requisitos funcionales.
Un motor que no puede producir de forma fiable salidas válidas para la aplicación no debería ganar por generar más tokens por segundo.
Cómo medir el rendimiento de la inferencia
Una vez establecida la compatibilidad, pueden empezar las pruebas de rendimiento. La primera pregunta es qué perciben realmente los usuarios.
Cuando un empleado envía una solicitud, puede haber un retraso antes de que aparezca el primer token. Después, la respuesta va llegando poco a poco hasta que termina la generación. Cada medición describe una parte distinta de esa experiencia.
| Métrica | Significado | Relevancia práctica |
|---|---|---|
| Tiempo hasta el primer token (TTFT) | Retraso antes de que llegue el primer token generado | Capacidad de respuesta interactiva |
| Latencia entre tokens (ITL) | Tiempo entre tokens generados sucesivos | Fluidez de las respuestas en streaming |
| Latencia de extremo a extremo | Tiempo total hasta que se completa la respuesta | Tiempo total para completar la tarea |
| Throughput | Solicitudes o tokens completados por unidad de tiempo | Capacidad de servicio |
| Tasa de solicitudes correctas | Solicitudes completadas según los requisitos de la aplicación | Capacidad útil efectiva |
Un motor puede alcanzar un throughput alto mientras algunas solicitudes concretas sufren retrasos mayores. El equilibrio preferible depende de la carga de trabajo. En un asistente conversacional, puede ser importante que la respuesta empiece rápido. En el procesamiento nocturno de documentos, pueden importar más el throughput total y el costo operativo.
Por qué los promedios pueden engañar
La latencia media no revela la distribución completa de los tiempos de respuesta. Un sistema puede atender rápido la mayoría de las solicitudes mientras un porcentaje menor sufre retrasos considerables.
Por eso los ingenieros examinan percentiles como P95 y P99. Por ejemplo, la latencia P95 identifica un valor igual o inferior al cual se completó aproximadamente el 95 % de las solicitudes medidas.
La evaluación del rendimiento también debe incluir errores, tiempos de espera agotados (timeouts), cancelaciones y respuestas no válidas. Excluir las solicitudes fallidas puede hacer que un sistema parezca más eficiente de lo que es. Fuente: referencia de métricas de NVIDIA AIPerf
Por qué no coinciden los benchmarks de motores de inferencia
Un benchmark puede indicar que SGLang supera a vLLM. Otro puede indicar lo contrario. Los resultados no son necesariamente contradictorios.
El rendimiento depende de la arquitectura del modelo, su tamaño, la precisión, el acelerador, la concurrencia, la longitud de entradas y salidas, y la configuración de servicio. Un benchmark hecho con un modelo pequeño en una sola GPU no determina cuál es el motor preferible para un modelo más grande repartido entre varios aceleradores. Ni siquiera un hardware idéntico garantiza una comparación justa si los motores usan ajustes de optimización distintos.
Por eso los ingenieros deberían distinguir entre dos tipos de evaluación:
- Comparación controlada: mantener constantes tantas variables como sea posible para entender las diferencias entre motores.
- Mejor configuración práctica: optimizar cada candidato de forma adecuada para determinar qué despliegue cumple mejor los requisitos de la aplicación.
Ambas son útiles, pero responden a preguntas distintas.
Benchmarks offline frente a benchmarks online
Un benchmark offline puede medir la ejecución del modelo sin el recorrido completo del servicio a través de la API. Un benchmark online envía solicitudes a un servicio en funcionamiento e incorpora efectos adicionales, como la gestión de las solicitudes y la planificación.
Un resultado offline no debe compararse directamente con uno online como si midieran condiciones idénticas. La guía de benchmarks de servicio de SGLang describe la generación de cargas de trabajo y las pruebas de rendimiento en los backends de servicio compatibles.
Los benchmarks del sector también siguen evolucionando. MLPerf Inference v6.1, publicado en septiembre de 2026, amplió su atención a cargas de trabajo como la generación aumentada por recuperación (RAG) de extremo a extremo y la inferencia agéntica. Estos avances mejoran los métodos disponibles para evaluar sistemas de inferencia, pero no señalan un motor como el mejor para todas las aplicaciones. Fuente: MLCommons, MLPerf Inference
Construye un benchmark en torno a la aplicación
Para nuestro asistente empresarial, una prueba útil debería incluir tres cargas de trabajo representativas. Las preguntas cortas revelan la capacidad de respuesta interactiva. Las solicitudes con documentos largos ponen de manifiesto las exigencias de procesamiento de la entrada y de memoria. Las solicitudes con salidas estructuradas y uso de herramientas ponen a prueba la corrección además del rendimiento.
El equipo debería aumentar la concurrencia de forma gradual y observar cómo se comporta cada motor con más tráfico. Para que la prueba sea reproducible, su registro debería indicar la revisión exacta del modelo, la versión del motor, el hardware, la precisión numérica, los ajustes de optimización y el método de medición.
La comparación final debería tener en cuenta los percentiles de latencia, el throughput, los errores, el consumo de recursos y las solicitudes válidas para la aplicación completadas con éxito. El objetivo no es elaborar una clasificación universal. Es determinar qué configuración cumple los requisitos de esta aplicación.
De qué no te protege un motor de inferencia
Un benchmark suele medir un motor en condiciones cómodas, así que la prueba también debería encontrar el punto en el que las condiciones dejan de serlo. Cuando la caché KV no puede alojar todas las solicitudes de un lote, el motor tiene que hacer algo con el trabajo sobrante. vLLM, por ejemplo, puede interrumpir de forma preventiva (preempt) una solicitud y volver a calcularla más tarde, y su documentación advierte de que esto puede perjudicar la latencia de extremo a extremo. Fuente: guía de optimización y ajuste de vLLM
Otros motores gestionan la presión de memoria a su manera. Para cada candidato, pregúntate qué le ocurre a una solicitud cuando se agota la memoria: ¿espera, se reinicia, ralentiza a todos o falla? ¿Y puede la aplicación distinguir un caso de otro?
Un motor de inferencia tampoco es, por defecto, una frontera de seguridad. La guía de seguridad de vLLM indica que su ajuste de clave de API solo protege ciertos prefijos de endpoints, enumera otros endpoints que siguen accesibles sin clave y recomienda minimizar los endpoints expuestos y colocar el servidor detrás de un proxy inverso. También indica que la comunicación entre nodos en un despliegue de varios nodos es insegura por defecto y debe protegerse mediante una red aislada. Fuente: guía de seguridad de vLLM
La regla práctica es que la autenticación, los límites de solicitudes y el aislamiento de red corresponden a las capas de gateway y de plataforma descritas antes, y que el motor no debería exponerse directamente a los usuarios ni a redes que no sean de confianza. Con cualquier otro motor, lee su documentación de seguridad antes de suponer que se comporta igual.
La recuperación exige preparación antes del primer incidente. Registra la revisión exacta del modelo y la versión del motor tanto en producción como en los benchmarks, mantén la imagen anterior del motor lista para desplegarse y envía una nueva versión a una pequeña parte del tráfico antes de pasar a todos los usuarios.
Después, prueba a propósito los casos desagradables: un reinicio en plena hora de tráfico intenso, un modelo que no llega a cargarse y una reversión (rollback), y mide durante cuánto tiempo se ven afectados los usuarios. Una actualización del motor puede cambiar los parámetros admitidos, las plantillas y el comportamiento de las llamadas a herramientas, así que las comprobaciones de compatibilidad anteriores deben repetirse tras cada actualización.
Qué ocurre después del despliegue
Un buen resultado en un benchmark no demuestra la fiabilidad en producción. El sistema de servicio también debe gestionar la cancelación de solicitudes, el agotamiento de recursos, el tráfico inesperado, los fallos al cargar el modelo, los reinicios y las actualizaciones de software.
Estas responsabilidades van más allá del motor de inferencia. Un gateway de API puede gestionar la autenticación y los límites de solicitudes. Una plataforma de orquestación puede supervisar el proceso de servicio. La aplicación puede controlar las sesiones, la recuperación de documentos, la autorización de herramientas y los tiempos de espera. El equipo tiene que establecer a quién corresponde cada responsabilidad.
Monitorización y resolución de problemas
Supongamos que los empleados informan de respuestas más lentas. El equipo debería poder determinar si la causa es un aumento del tráfico, prompts más largos, colas de solicitudes, presión de memoria, la ejecución del modelo o una dependencia posterior de la aplicación.
Los motores de inferencia suelen exponer métricas operativas. Por ejemplo, vLLM ofrece métricas compatibles con Prometheus para su entorno de servicio. Una observabilidad útil exige relacionar esas métricas del motor con el comportamiento de la aplicación.
Si la recuperación de documentos consume la mayor parte del tiempo de la solicitud, cambiar de motor de inferencia puede aportar poca mejora. Monitorizar solo la GPU no basta para explicar la experiencia completa del usuario.
Una inferencia más rápida puede reducir costos, pero no automáticamente
Un throughput mayor puede permitir que un despliegue muy utilizado atienda más solicitudes con el mismo hardware o reduzca el número de instancias de aceleradores necesarias. Sin embargo, aumentar el throughput en una GPU poco utilizada y facturada de forma continua puede no reducir el gasto. La evaluación económica debería tener en cuenta los cargos de infraestructura, la utilización, las solicitudes correctas, el esfuerzo de ingeniería, el mantenimiento y la complejidad operativa.
Una comparación útil mide el costo de cumplir los requisitos de servicio de la aplicación, no simplemente el costo por token teórico.
Cómo puede un equipo elegir un motor de inferencia
Nuestro asistente interno empezó como una demostración para un solo usuario. Ahora necesita un servicio fiable para varios tipos de solicitudes y muchos usuarios. El equipo de ingeniería ya entiende lo suficiente para abordar la decisión de forma sistemática.
Primero, debería decidir si hace falta gestionar la inferencia por su cuenta. Un servicio de inferencia gestionado puede cumplir ya los requisitos de la aplicación y, a la vez, reducir las responsabilidades de infraestructura. Si está justificado servir los modelos por cuenta propia, el equipo puede evaluar los motores compatibles.
| Decisión | Qué establecer |
|---|---|
| Enfoque de despliegue | Servicio gestionado o servicio autogestionado |
| Compatibilidad | Modelo, hardware, salidas e integraciones necesarios |
| Rendimiento | Latencia, throughput y comportamiento con tráfico realista |
| Fiabilidad | Límites de recursos, fallos, monitorización y recuperación |
| Economía | Costos de infraestructura, esfuerzo operativo y valor de la migración |
A veces el motor actual seguirá siendo la mejor opción práctica. Un motor de la competencia puede ofrecer más throughput, pero introducir costos de compatibilidad o de mantenimiento que superen la mejora. No hay ninguna obligación de migrar porque otro producto encabece un benchmark público.
Del mismo modo, un entorno de ejecución más sencillo puede bastar para una aplicación cuyos requisitos de rendimiento y fiabilidad ya se cumplen. La decisión debería basarse en requisitos medibles de la aplicación, no en la popularidad de una tecnología.
Qué nivel de conocimiento de los motores de inferencia necesita cada profesional
Cada rol requiere un nivel de conocimiento distinto.
Los desarrolladores de aplicaciones deberían entender la latencia de respuesta, la compatibilidad de la API, el streaming, la validación de las salidas y las implicaciones de las solicitudes que hacen al modelo.
Los ingenieros de plataforma y los SRE que operan infraestructura de inferencia necesitan un conocimiento más profundo de la utilización de recursos, la concurrencia, la monitorización, el despliegue, la fiabilidad y la planificación de capacidad.
Los especialistas en infraestructura de IA que optimizan la ejecución de modelos también pueden necesitar entender los algoritmos de planificación, la gestión de la caché KV, la cuantización, el paralelismo y las técnicas específicas de cada acelerador.
No todo el mundo necesita dominar el funcionamiento interno de los motores de inferencia. La profundidad adecuada depende de si el profesional consume, opera u optimiza la infraestructura de servicio.
Tomar la decisión de ingeniería correcta
Los modelos de IA atraen la atención porque sus salidas son visibles. Los motores de inferencia trabajan detrás de esas salidas y gestionan el trabajo computacional que hace posible el servicio en producción. Su importancia se ve más clara cuando las aplicaciones se enfrentan a tráfico simultáneo, longitudes de solicitud variables, limitaciones de memoria y requisitos de nivel de servicio.
Por eso, elegir un motor de inferencia exige algo más que comparar cifras de benchmarks. Los ingenieros tienen que verificar la compatibilidad con la aplicación, probar cargas de trabajo representativas, entender las responsabilidades operativas y evaluar el costo total de cumplir los requisitos de servicio.
Los productos y las clasificaciones de los benchmarks seguirán cambiando. La decisión de fondo sigue siendo la misma.
Elige el motor de inferencia que cumpla los requisitos de la aplicación con un rendimiento, una fiabilidad, un costo y una complejidad operativa aceptables, no simplemente el que mejor resultado obtiene en el benchmark de otro.
Para profundizar
- vLLM, Official Documentation, proyecto vLLM. Arquitectura del motor, PagedAttention, planificación, compatibilidad de modelos y funciones de servicio.
- SGLang, Official Documentation, proyecto SGLang. Ejecución de modelos, generación estructurada, llamadas a herramientas y capacidades de despliegue.
- SGLang, Serving Benchmark Guide, proyecto SGLang. Generación de cargas de trabajo, concurrencia y mediciones del servicio online.
- LMDeploy, Official Documentation, proyecto LMDeploy. Backends de ejecución TurboMind y PyTorch, modelos compatibles y servicio.
- llama.cpp, Official Repository, proyecto llama.cpp. Inferencia portable, ejecución cuantizada y capacidades de servidor.
- NVIDIA, AIPerf Metrics Reference, NVIDIA. Definiciones de la latencia de inferencia, el throughput y las mediciones relacionadas.
- MLCommons, MLPerf Inference, MLCommons. Metodología de los benchmarks y resultados publicados de sistemas de inferencia.
- vLLM, Optimization and Tuning, proyecto vLLM. Interrupción preventiva (preemption) y presión sobre la memoria de la caché KV.
- vLLM, Security, proyecto vLLM. Protección de endpoints y comunicación entre nodos.
Fecha de corte de la investigación: 20 de octubre de 2026. La disponibilidad exacta de las funciones y la compatibilidad deben verificarse con la versión del motor que se esté evaluando.
Lecturas relacionadas en TechiesJournal
- Por qué la inferencia de IA está cambiando nuestra forma de entender el balanceo de carga (en inglés), para ver cómo se enrutan las solicitudes entre réplicas de inferencia cuando un solo servidor ya no basta.
- Ejecutar modelos de IA abiertos por tu cuenta: lo que realmente hace falta (en inglés), para la decisión de autoalojamiento que precede a la elección de un motor.