

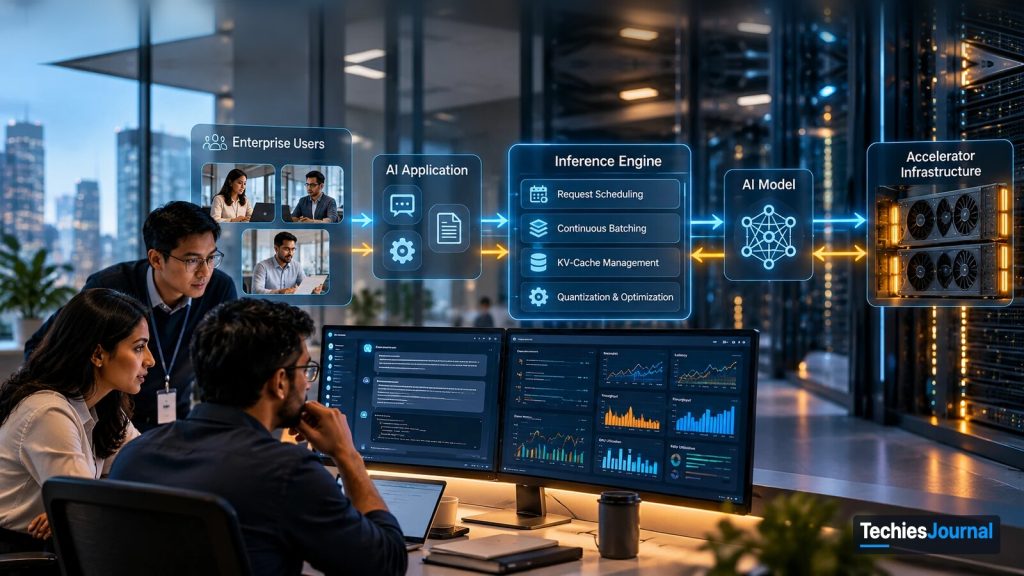
AI सर्विंग स्टैक का उदाहरणात्मक चित्र। दिखाए गए डैशबोर्ड और चार्ट सजावटी हैं, असली माप नहीं।
AI मॉडल चलाना एक बात है। उसे कई उपयोगकर्ताओं के लिए भरोसेमंद ढंग से जवाब देने लायक बनाना बिल्कुल दूसरी। इन्फरेंस इंजन को समझने से इंजीनियरिंग टीमें भ्रामक परफ़ॉर्मेंस तुलनाओं पर निर्भर हुए बिना बेहतर सर्विंग फ़ैसले ले पाती हैं।
AI मॉडल सवाल का जवाब कैसे देता है
कल्पना कीजिए कि एक संगठन अपने भीतरी इस्तेमाल के लिए AI असिस्टेंट बना रहा है। कर्मचारी इससे तकनीकी दस्तावेज़ खोज सकते हैं, आंतरिक प्रक्रियाएँ समझ सकते हैं और एप्लिकेशन तथा इन्फ्रास्ट्रक्चर के बारे में सवाल पूछ सकते हैं।
डेवलपमेंट टीम एक ओपन-वेट लैंग्वेज मॉडल चुनती है, उसे GPU वाली मशीन पर चलाती है और एक सरल चैट इंटरफ़ेस से जोड़ देती है। डेमो के दौरान सब कुछ ठीक चलता है। कर्मचारी सवाल पूछता है, मॉडल उसे प्रोसेस करता है और जवाब दिख जाता है।
इस प्रक्रिया को इन्फरेंस (inference) कहते हैं। मॉडल ट्रेनिंग के दौरान पैटर्न सीखता है। इन्फरेंस के दौरान वह अपने ट्रेन किए गए पैरामीटर इस्तेमाल करके नए इनपुट प्रोसेस करता है और आउटपुट बनाता है। आम तौर पर कोई सवाल पूछे जाने पर वह अपने-आप दोबारा ट्रेन नहीं होता।
लैंग्वेज मॉडल जवाब टोकन (token) की शृंखला के रूप में बनाते हैं, जो शब्द, शब्द के हिस्से या विराम चिह्न हो सकते हैं। इन टोकन को बनाने में कंप्यूटेशन और मेमोरी लगती है, और ज़रूरत मॉडल तथा वर्कलोड के हिसाब से बदलती है। एक उपयोगकर्ता वाले डेमो में उस कंप्यूटेशन को सँभालना आसान लग सकता है। प्रोडक्शन चुनौतियों का एक अलग ही सेट लेकर आता है।
AI इन्फरेंस इंजन क्या करता है
AI मॉडल और इन्फरेंस इंजन अलग-अलग काम करते हैं। मॉडल में वे ट्रेन किए गए पैरामीटर और कंप्यूटेशनल ढाँचा होता है जिनसे आउटपुट बनता है। इन्फरेंस इंजन वह सॉफ़्टवेयर है जो उस मॉडल को उपलब्ध हार्डवेयर पर चलाने और उससे जुड़े कंप्यूटेशनल काम को सँभालने के लिए ज़िम्मेदार है।
अपनी बनावट के आधार पर इन्फरेंस इंजन मॉडल लोड कर सकता है, अनुरोधों का शेड्यूल बना सकता है, मेमोरी सँभाल सकता है, ऑपरेशनों को बैच कर सकता है और बने हुए जवाब स्ट्रीम कर सकता है।
बुनियादी संबंध यह है:
उपयोगकर्ता → AI एप्लिकेशन → इन्फरेंस इंजन → मॉडल एक्ज़िक्यूशन → जवाब
प्रोडक्शन एप्लिकेशन में दस्तावेज़ रिट्रीवल, ऑथेंटिकेशन, नेटवर्क रूटिंग, मॉनिटरिंग और दूसरी सेवाएँ भी हो सकती हैं। इन्फरेंस इंजन इन घटकों की जगह नहीं लेता।
Ollama, LM Studio और llama.cpp जैसे टूल लोकल मॉडल चलाना सुलभ बनाते हैं, हालाँकि उनकी सर्विंग क्षमता अलग-अलग स्तर की है। vLLM, SGLang और LMDeploy जैसे सिस्टम इन्फरेंस वर्कलोड सँभालने के अतिरिक्त तरीके देते हैं। अगला हिस्सा बताता है कि डेवलपमेंट में चले आ रहे सेटअप को ही चलाते रहने की जगह किसी संगठन को इन क्षमताओं की ज़रूरत क्यों पड़ती है।
प्रोडक्शन समस्या को क्यों बदल देता है
संगठन अपना असिस्टेंट कई सौ कर्मचारियों के लिए उपलब्ध करा देता है। कुछ लोग छोटे सवाल पूछते हैं। कुछ लंबे दस्तावेज़ जमा करते हैं। कई अनुरोध एक साथ आते हैं और जवाबों की लंबाई में काफ़ी फ़र्क़ होता है।
इन अनुरोधों में कंप्यूटिंग संसाधन बराबर खर्च नहीं होते। लंबे दस्तावेज़ को प्रोसेस करने में छोटे सवाल की तुलना में ज़्यादा इनपुट कंप्यूटेशन लगता है। लंबा जवाब बनाने में भी संक्षिप्त उत्तर की तुलना में ज़्यादा काम होता है।
जैसे-जैसे एक साथ इस्तेमाल बढ़ता है, सर्विंग सिस्टम को आपस में होड़ करते अनुरोधों और सीमित GPU मेमोरी को सँभालना पड़ता है। हार्डवेयर शक्तिशाली दिखने पर भी कर्मचारियों को जवाब मिलने का समय असमान लग सकता है।
अब समस्या सिर्फ़ यह नहीं रही कि मॉडल जवाब बना सकता है या नहीं। सवाल यह है कि क्या सर्विंग सिस्टम स्वीकार्य परफ़ॉर्मेंस बनाए रखते हुए अलग-अलग अनुरोधों को कुशलता से सँभाल सकता है।
इन्फरेंस इंजन एक साथ आए अनुरोध कैसे सँभालते हैं
कई ट्रांसफ़ॉर्मर-आधारित लैंग्वेज मॉडल में इन्फरेंस के दो अहम चरण होते हैं। Prefill (प्रीफ़िल) वह चरण है जिसमें मॉडल इनपुट टोकन प्रोसेस करता है और जवाब बनाने के लिए ज़रूरी जानकारी तैयार करता है। लंबे इनपुट से आम तौर पर इस चरण में ज़्यादा काम पैदा होता है।
Decode (डिकोड) वह चरण है जिसमें मॉडल लगातार कंप्यूटेशनल क़दमों से आउटपुट टोकन बनाता है। दोनों चरणों की कंप्यूटेशनल विशेषताएँ अलग हैं। उनके संसाधनों की माँग मॉडल, हार्डवेयर, अनुरोधों की लंबाई और एक्ज़िक्यूशन कॉन्फ़िगरेशन पर निर्भर करती है।
कई अनुरोध आने पर कुशल शेड्यूलिंग अहम हो जाती है। एक तकनीक है continuous batching (कंटीन्युअस बैचिंग)। अनुरोधों के तय समूह को सबके पूरा होने तक प्रोसेस करते रहने की जगह, इंजन सक्रिय समूह को बदल सकता है, क्योंकि अनुरोध पूरे होते जाते हैं और नए अनुरोध तैयार होते जाते हैं। इससे हार्डवेयर का उपयोग और थ्रूपुट बेहतर हो सकता है।
मेमोरी प्रबंधन भी उतना ही अहम है। जवाब बनाते समय ट्रांसफ़ॉर्मर मॉडल आम तौर पर पहले प्रोसेस हो चुके टोकन की बीच की अटेंशन जानकारी अपने पास रखते हैं। इसे key-value cache (की-वैल्यू कैश) या KV cache कहते हैं। यह जानकारी रखने से कुछ गणनाएँ दोहरानी नहीं पड़तीं, लेकिन कैश मेमोरी खाता है। ज़्यादा एक साथ चल रहे अनुरोध और लंबे सीक्वेंस से मेमोरी की ज़रूरत आम तौर पर बढ़ती है।
इन्फरेंस इंजन उस मेमोरी को सँभालने के लिए अलग-अलग रणनीतियाँ अपनाते हैं। उदाहरण के लिए, vLLM ने PagedAttention पेश किया, एक ऐसा तरीक़ा जो KV-cache मेमोरी को ब्लॉक में व्यवस्थित करता है ताकि अकुशल आवंटन घटे और मेमोरी का उपयोग बेहतर हो।
ये तकनीकें समझाती हैं कि इन्फरेंस इंजन अंतर्निहित मॉडल को बदले बिना परफ़ॉर्मेंस कैसे सुधार सकता है। Source: vLLM documentation
इस चित्र का सुलभ टेक्स्ट विकल्प
इंजन के अंदर अलग-अलग लंबाई के अनुरोध एक साथ आते हैं। शेड्यूलर continuous batching लागू करता है, प्रीफ़िल चरण इनपुट टोकन प्रोसेस करता है, डिकोड चरण आउटपुट टोकन एक-एक करके बनाता है और जवाब उपयोगकर्ता तक स्ट्रीम होता है। एक्सेलरेटर मेमोरी में रखा KV-cache शेड्यूलर, प्रीफ़िल और डिकोड का साथ देता है और ज़्यादा एक साथ आए अनुरोधों और लंबे सीक्वेंस के साथ बढ़ता है।
इंजन के आसपास API गेटवे ऑथेंटिकेशन और अनुरोध-सीमाएँ सँभाल सकता है, एप्लिकेशन सेशन, दस्तावेज़ रिट्रीवल, टूल ऑथराइज़ेशन और टाइमआउट सँभाल सकता है, ऑर्केस्ट्रेशन प्लेटफ़ॉर्म सर्विंग प्रोसेस की निगरानी कर सकता है और मॉनिटरिंग को इंजन मेट्रिक्स को एप्लिकेशन-स्तर के व्यवहार से जोड़ना चाहिए।
दूसरे ऑप्टिमाइज़ेशन
वर्कलोड ज़्यादा माँग वाले होने पर अतिरिक्त तकनीकें मदद कर सकती हैं।
Quantization (क्वांटाइज़ेशन) मॉडल के कुछ मानों या गणनाओं के लिए घटी हुई संख्यात्मक सटीकता इस्तेमाल करता है। इससे मेमोरी की ज़रूरत घट सकती है और परफ़ॉर्मेंस बेहतर हो सकती है, हालाँकि संगतता और आउटपुट की गुणवत्ता परखनी पड़ती है।
Prefix caching (प्रीफ़िक्स कैशिंग) तब उपयुक्त गणनाओं को दोबारा इस्तेमाल करती है जब अनुरोधों के प्रॉम्प्ट प्रीफ़िक्स एक जैसे हों। जो एप्लिकेशन बार-बार वही निर्देश या संदर्भ भेजते हैं, उन्हें इससे मदद मिल सकती है।
Speculative decoding (स्पेक्युलेटिव डिकोडिंग) प्रस्तावित टोकन और सत्यापन प्रक्रिया के ज़रिए अनुकूल परिस्थितियों में जवाब बनाने की रफ़्तार बढ़ाती है।
कुछ डिप्लॉयमेंट prefill और decode के एक्ज़िक्यूशन को अलग भी करते हैं, या मॉडल का कंप्यूटेशन कई एक्सेलरेटरों में बाँट देते हैं। हर एप्लिकेशन को इन तरीक़ों से बराबर फ़ायदा नहीं होता। फ़ीचर का समर्थन और उसका असर मॉडल, इंजन वर्शन, हार्डवेयर और वर्कलोड पर निर्भर करता है।
इन प्रक्रियाओं को समझना इंजीनियरों को उन्हें लागू करने वाले इंजनों को परखने की बुनियाद देता है।
उपलब्ध इन्फरेंस इंजनों को समझना
कई ओपन-सोर्स प्रोजेक्ट इन्फरेंस एक्ज़िक्यूशन और सर्विंग की क्षमताएँ देते हैं। उनकी सुविधाएँ आपस में मिलती हैं, लेकिन उनकी बनावट, संगतता और ऑपरेशनल विशेषताएँ अलग हो सकती हैं।
vLLM
vLLM एक ओपन-सोर्स इन्फरेंस और सर्विंग इंजन है, जिसे PagedAttention के ज़रिए कुशल KV-cache प्रबंधन से जोड़कर देखा जाता है। यह continuous batching, prefix caching, quantization, speculative decoding, स्ट्रक्चर्ड आउटपुट और डिस्ट्रीब्यूटेड एक्ज़िक्यूशन जैसी क्षमताओं का समर्थन करता है।
कई उपयोगकर्ताओं वाले मॉडल-सर्विंग परिवेश के लिए यह एक प्रासंगिक विकल्प है, हालाँकि अलग-अलग फ़ीचर मॉडल, हार्डवेयर, बैकएंड और वर्शन पर निर्भर करते हैं। Source: vLLM documentation
SGLang
SGLang लैंग्वेज-मॉडल इन्फरेंस और सर्विंग की क्षमताएँ देता है, जिनमें एक्ज़िक्यूशन शेड्यूलिंग, कैश से जुड़े ऑप्टिमाइज़ेशन, स्ट्रक्चर्ड जनरेशन और टूल-कॉलिंग का समर्थन शामिल हैं। यह ऑफ़लाइन एक्ज़िक्यूशन और ऑनलाइन सर्विंग को परखने के लिए बेंचमार्किंग टूल भी देता है।
इन क्षमताओं के कारण यह कठिन सर्विंग ज़रूरतों वाले एप्लिकेशन के लिए प्रासंगिक बनता है, लेकिन इससे यह साबित नहीं होता कि एजेंटिक वर्कलोड के लिए यह हर जगह ज़्यादा तेज़ है। Source: SGLang documentation
LMDeploy
LMDeploy TurboMind और PyTorch जैसे एक्ज़िक्यूशन बैकएंड के ज़रिए मॉडल सर्विंग का समर्थन करता है। यह quantization के विकल्प, सर्विंग इंटरफ़ेस और परफ़ॉर्मेंस-मूल्यांकन टूल देता है।
इसका मॉडल समर्थन और ऑप्टिमाइज़ेशन क्षमताएँ बैकएंड के हिसाब से बदलती हैं, इसलिए संगतता की जाँच ख़ास तौर पर अहम हो जाती है। Source: LMDeploy documentation
llama.cpp कहाँ बैठता है
llama.cpp एक और प्रासंगिक इन्फरेंस रनटाइम है, ख़ास तौर पर पोर्टेबल एक्ज़िक्यूशन, क्वांटाइज़ किए गए मॉडल और सीमित संसाधनों वाले हार्डवेयर के लिए। यह सर्विंग क्षमताएँ भी देता है और कुछ प्रोडक्शन परिवेशों के लिए उपयुक्त हो सकता है।
अनुमान योग्य ट्रैफ़िक वाले छोटे एप्लिकेशन को ज़्यादा जटिल सर्विंग आर्किटेक्चर की ज़रूरत शायद न पड़े। ज़्यादा माँग वाले वर्कलोड अतिरिक्त इंजनों को परखने का औचित्य बना सकते हैं। व्यावहारिक सवाल यह नहीं है कि कौन-सा प्रोजेक्ट सबसे लोकप्रिय है, बल्कि यह है कि कौन-सा इम्प्लीमेंटेशन एप्लिकेशन की असली ज़रूरतों का समर्थन करता है।
| इंजन | इसका डॉक्यूमेंटेशन क्या रेखांकित करता है | पहले क्या जाँचें |
|---|---|---|
| vLLM | PagedAttention के ज़रिए KV-cache प्रबंधन, continuous batching, prefix caching, quantization, speculative decoding, स्ट्रक्चर्ड आउटपुट, डिस्ट्रीब्यूटेड एक्ज़िक्यूशन | इनमें से कौन-से फ़ीचर आपके मॉडल, हार्डवेयर, बैकएंड और वर्शन पर चलते हैं |
| SGLang | एक्ज़िक्यूशन शेड्यूलिंग, कैश से जुड़े ऑप्टिमाइज़ेशन, स्ट्रक्चर्ड जनरेशन, टूल-कॉलिंग का समर्थन, ऑफ़लाइन और ऑनलाइन सर्विंग के लिए बेंचमार्किंग टूल | क्या इसकी क्षमताएँ आपके वर्कलोड पर लागू होती हैं, क्योंकि वे एजेंटिक वर्कलोड के लिए इसे हर जगह तेज़ साबित नहीं करतीं |
| LMDeploy | TurboMind और PyTorch बैकएंड, quantization के विकल्प, सर्विंग इंटरफ़ेस, परफ़ॉर्मेंस-मूल्यांकन टूल | बैकएंड के हिसाब से बदलने वाला मॉडल समर्थन और ऑप्टिमाइज़ेशन |
| llama.cpp | पोर्टेबल एक्ज़िक्यूशन, क्वांटाइज़ किए गए मॉडल, सीमित संसाधनों वाला हार्डवेयर, सर्विंग क्षमताएँ | क्या अनुमान योग्य ट्रैफ़िक वाले छोटे एप्लिकेशन को ज़्यादा जटिल इंजन की ज़रूरत है |
रफ़्तार की तुलना से पहले संगतता जाँचें
हमारे आंतरिक असिस्टेंट को अब सामान्य बातचीत, दस्तावेज़ आधारित सवाल, स्ट्रक्चर्ड जवाब और कुछ टूल इस्तेमाल करने वाले वर्कफ़्लो का समर्थन करना है। टीम कई इन्फरेंस इंजनों की शॉर्टलिस्ट बनाती है।
उन्हें बेंचमार्क करने से पहले टीम को जाँचना होगा कि हर उम्मीदवार एप्लिकेशन को सही ढंग से चला सकता है। अहम जाँचों में शामिल हैं: मॉडल और टोकनाइज़र की संगतता, समर्थित कॉन्टेक्स्ट लंबाई, हार्डवेयर ज़रूरतें, चैट टेम्पलेट, स्ट्रीमिंग, स्ट्रक्चर्ड आउटपुट और टूल-कॉल का व्यवहार।
दो इंजन OpenAI-compatible API देकर भी एक जैसा व्यवहार करें, यह ज़रूरी नहीं। वे समर्थित पैरामीटर, मॉडल-विशेष टेम्पलेट, constrained-generation के व्यवहार और टूल-कॉल पार्सिंग में अलग हो सकते हैं।
उदाहरण के लिए, कोई इंजन टेक्स्ट तेज़ी से बना सकता है, पर ऐसा JSON लौटा सकता है जो एप्लिकेशन के ज़रूरी स्कीमा पर खरा नहीं उतरता। इसी तरह, एप्लिकेशन के टूल-कॉल आउटपुट को भरोसे से समझ पाने से पहले उसे मॉडल-विशेष कॉन्फ़िगरेशन की ज़रूरत पड़ सकती है।
इन्फरेंस इंजन टूल-कॉल अनुरोध बनाने में मदद कर सकता है, लेकिन माँगी गई कार्रवाई को अधिकृत करने और चलाने की ज़िम्मेदारी एप्लिकेशन की ही रहती है। परफ़ॉर्मेंस तुलनाएँ तभी अर्थपूर्ण हैं जब उम्मीदवार एक जैसी कार्यात्मक ज़रूरतें पूरी करें।
जो इंजन एप्लिकेशन के लिए वैध आउटपुट भरोसे से नहीं दे सकता, उसे इसलिए नहीं जीतना चाहिए कि वह प्रति सेकंड ज़्यादा टोकन बनाता है।
इन्फरेंस परफ़ॉर्मेंस कैसे मापें
संगतता तय हो जाने पर परफ़ॉर्मेंस टेस्टिंग शुरू की जा सकती है। पहला सवाल यह है कि उपयोगकर्ता असल में क्या अनुभव करते हैं।
कर्मचारी जब अनुरोध भेजता है, तो पहला टोकन दिखने से पहले कुछ देरी हो सकती है। फिर जवाब जनरेशन पूरा होने तक समय के साथ आता रहता है। अलग-अलग माप उस अनुभव के अलग-अलग हिस्सों का वर्णन करते हैं।
| मेट्रिक | अर्थ | व्यावहारिक प्रासंगिकता |
|---|---|---|
| पहले टोकन तक का समय (TTFT) | पहला बना हुआ टोकन पहुँचने से पहले की देरी | इंटरैक्टिव प्रतिक्रियाशीलता |
| टोकन के बीच की लेटेंसी (ITL) | लगातार बने टोकन के बीच का समय | स्ट्रीम होने वाले जवाबों की सहजता |
| एंड-टू-एंड लेटेंसी | जवाब पूरा होने तक का कुल समय | पूरा काम निपटने का समय |
| थ्रूपुट | प्रति इकाई समय में पूरे हुए अनुरोध या टोकन | सर्विंग क्षमता |
| सफल अनुरोध दर | एप्लिकेशन की ज़रूरतों के अनुसार पूरे हुए अनुरोध | प्रभावी उपयोग-योग्य क्षमता |
इंजन ऊँचा थ्रूपुट हासिल कर सकता है, जबकि कुछ अलग-अलग अनुरोधों को ज़्यादा देरी झेलनी पड़ती है। कौन-सा संतुलन बेहतर है, यह वर्कलोड पर निर्भर करता है। बातचीत वाले असिस्टेंट के लिए तेज़ शुरुआती जवाब अहम हो सकते हैं। रात भर चलने वाली दस्तावेज़ प्रोसेसिंग के लिए कुल थ्रूपुट और संचालन लागत ज़्यादा मायने रख सकती है।
औसत भ्रामक क्यों हो सकते हैं
औसत लेटेंसी जवाब के समय का पूरा वितरण नहीं दिखाती। सिस्टम ज़्यादातर अनुरोध तेज़ी से निपटा सकता है, जबकि छोटे प्रतिशत को काफ़ी देरी झेलनी पड़ती है।
इसलिए इंजीनियर P95 और P99 जैसे परसेंटाइल देखते हैं। उदाहरण के लिए, P95 लेटेंसी वह मान बताती है जिस पर या जिससे कम में मापे गए लगभग 95% अनुरोध पूरे हुए।
परफ़ॉर्मेंस मूल्यांकन में एरर, टाइमआउट, रद्द किए गए अनुरोध और अमान्य जवाब भी शामिल होने चाहिए। विफल अनुरोध छोड़ देने से सिस्टम असल से ज़्यादा कुशल दिख सकता है। Source: NVIDIA AIPerf metrics reference
इन्फरेंस-इंजन बेंचमार्क आपस में असहमत क्यों होते हैं
कोई बेंचमार्क बता सकता है कि SGLang, vLLM से बेहतर है। दूसरा इसका उलटा बता सकता है। ये नतीजे ज़रूरी नहीं कि एक-दूसरे के विरोधी हों।
परफ़ॉर्मेंस मॉडल आर्किटेक्चर, मॉडल के आकार, प्रिसिज़न, एक्सेलरेटर, कॉन्करेंसी, इनपुट और आउटपुट की लंबाई और सर्विंग कॉन्फ़िगरेशन पर निर्भर करती है। एक GPU पर छोटे मॉडल के साथ किया गया बेंचमार्क यह तय नहीं करता कि कई एक्सेलरेटरों में बँटे बड़े मॉडल के लिए कौन-सा इंजन बेहतर है। हार्डवेयर एक जैसा हो तब भी निष्पक्ष तुलना की गारंटी नहीं, अगर इंजन अलग ऑप्टिमाइज़ेशन सेटिंग इस्तेमाल करते हैं।
इसलिए इंजीनियरों को दो तरह के मूल्यांकन में फ़र्क़ करना चाहिए:
- Controlled comparison (नियंत्रित तुलना): इंजनों के बीच अंतर समझने के लिए ज़्यादा से ज़्यादा वेरिएबल स्थिर रखें।
- Best practical configuration (सर्वोत्तम व्यावहारिक कॉन्फ़िगरेशन): हर उम्मीदवार को उचित ढंग से ऑप्टिमाइज़ करें, ताकि पता चले कि कौन-सा डिप्लॉयमेंट एप्लिकेशन की ज़रूरतें सबसे असरदार ढंग से पूरी करता है।
दोनों उपयोगी हैं, लेकिन वे अलग-अलग सवालों के जवाब देते हैं।
ऑफ़लाइन बनाम ऑनलाइन बेंचमार्क
ऑफ़लाइन बेंचमार्क पूरे API-सर्विंग पथ के बिना मॉडल एक्ज़िक्यूशन माप सकता है। ऑनलाइन बेंचमार्क चल रही सेवा को अनुरोध भेजता है, जिससे अनुरोध हैंडलिंग और शेड्यूलिंग जैसे अतिरिक्त प्रभाव भी शामिल हो जाते हैं।
ऑफ़लाइन नतीजे की सीधी तुलना ऑनलाइन नतीजे से इस तरह नहीं होनी चाहिए मानो दोनों एक जैसी परिस्थितियाँ माप रहे हों। SGLang’s serving benchmark guide समर्थित सर्विंग बैकएंड में वर्कलोड जनरेशन और परफ़ॉर्मेंस टेस्टिंग का वर्णन करती है।
इंडस्ट्री बेंचमार्क भी विकसित होते रहते हैं। September 2026 में जारी MLPerf Inference v6.1 ने एंड-टू-एंड रिट्रीवल-ऑगमेंटेड जनरेशन और एजेंटिक इन्फरेंस जैसे वर्कलोड पर ध्यान बढ़ाया। ये विकास इन्फरेंस सिस्टम को परखने के उपलब्ध तरीक़ों को बेहतर बनाते हैं, लेकिन इनसे यह तय नहीं होता कि कोई एक इंजन हर एप्लिकेशन के लिए सबसे अच्छा है। Source: MLCommons, MLPerf Inference
एप्लिकेशन के आसपास बेंचमार्क बनाएँ
हमारे एंटरप्राइज़ असिस्टेंट के लिए उपयोगी टेस्ट में तीन प्रतिनिधि वर्कलोड होने चाहिए। छोटे सवाल इंटरैक्टिव प्रतिक्रियाशीलता दिखाते हैं। लंबे दस्तावेज़ों के अनुरोध इनपुट-प्रोसेसिंग और मेमोरी की माँग सामने लाते हैं। स्ट्रक्चर्ड-आउटपुट और टूल इस्तेमाल करने वाले अनुरोध परफ़ॉर्मेंस के साथ-साथ सही होने की भी परख करते हैं।
टीम को कॉन्करेंसी धीरे-धीरे बढ़ानी चाहिए और देखना चाहिए कि भारी ट्रैफ़िक में हर इंजन कैसा व्यवहार करता है। दोहराए जा सकने के लिए टेस्ट रिकॉर्ड में सटीक मॉडल रिविज़न, इंजन वर्शन, हार्डवेयर, संख्यात्मक प्रिसिज़न, ऑप्टिमाइज़ेशन सेटिंग और माप का तरीक़ा दर्ज होना चाहिए।
अंतिम तुलना में लेटेंसी परसेंटाइल, थ्रूपुट, एरर, संसाधन खपत और सफलतापूर्वक पूरे हुए एप्लिकेशन-वैध अनुरोध शामिल होने चाहिए। मक़सद कोई सार्वभौमिक लीडरबोर्ड बनाना नहीं है। मक़सद यह तय करना है कि कौन-सा कॉन्फ़िगरेशन इस एप्लिकेशन की ज़रूरतें पूरी करता है।
इन्फरेंस इंजन किस चीज़ से नहीं बचाता
बेंचमार्क आम तौर पर इंजन को आरामदायक परिस्थितियों में मापता है, इसलिए परीक्षण में यह भी खोजा जाना चाहिए कि परिस्थितियाँ कहाँ आरामदायक नहीं रहतीं। जब KV-cache एक बैच के सभी अनुरोध नहीं सँभाल पाता, तो इंजन को अतिरिक्त काम का कुछ करना ही पड़ता है। उदाहरण के लिए vLLM किसी अनुरोध को preempt करके बाद में दोबारा गणना (recompute) कर सकता है, और उसका डॉक्यूमेंटेशन चेताता है कि इससे एंड-टू-एंड लेटेंसी पर बुरा असर पड़ सकता है। Source: vLLM optimization and tuning guide
दूसरे इंजन मेमोरी के दबाव को अपने-अपने तरीक़े से सँभालते हैं। हर उम्मीदवार के लिए पूछिए कि मेमोरी ख़त्म होने पर अनुरोध का क्या होता है: वह इंतज़ार करता है, दोबारा शुरू होता है, सबको धीमा कर देता है या विफल हो जाता है, और क्या एप्लिकेशन इस फ़र्क़ को पहचान सकता है।
इन्फरेंस इंजन डिफ़ॉल्ट रूप से सुरक्षा-सीमा भी नहीं है। vLLM की सुरक्षा गाइड के अनुसार उसकी API key सेटिंग सिर्फ़ कुछ एंडपॉइंट प्रीफ़िक्स की रक्षा करती है, वह उन दूसरे एंडपॉइंट की सूची देती है जो बिना कुंजी के पहुँच में रहते हैं, और उजागर एंडपॉइंट घटाने तथा सर्वर को reverse proxy के पीछे रखने की सलाह देती है। वह यह भी बताती है कि मल्टी-नोड डिप्लॉयमेंट में नोड्स के बीच संचार डिफ़ॉल्ट रूप से असुरक्षित है और उसे अलग-थलग नेटवर्क से सुरक्षित किया जाना चाहिए। Source: vLLM security guide
व्यावहारिक नियम यह है कि ऑथेंटिकेशन, अनुरोध-सीमाएँ और नेटवर्क आइसोलेशन ऊपर बताई गई गेटवे और प्लेटफ़ॉर्म परतों के ज़िम्मे हैं, और इंजन को सीधे उपयोगकर्ताओं या अविश्वसनीय नेटवर्क के सामने नहीं रखना चाहिए। किसी दूसरे इंजन के लिए यह मान लेने से पहले कि वह वैसा ही बर्ताव करता है, उसकी सुरक्षा डॉक्यूमेंटेशन पढ़िए।
रिकवरी की तैयारी पहली घटना से पहले चाहिए। सटीक मॉडल रिवीज़न और इंजन वर्शन को बेंचमार्क के साथ-साथ प्रोडक्शन में भी दर्ज कीजिए, पिछली इंजन इमेज को डिप्लॉय करने लायक़ रखिए, और नया वर्शन सबको देने से पहले ट्रैफ़िक के छोटे हिस्से पर भेजिए।
फिर अप्रिय स्थितियों का जानबूझकर परीक्षण कीजिए: व्यस्त ट्रैफ़िक के बीच रीस्टार्ट, लोड न होने वाला मॉडल, रोलबैक, और यह मापिए कि उपयोगकर्ता कितनी देर प्रभावित रहते हैं। इंजन अपग्रेड समर्थित पैरामीटर, टेम्पलेट और टूल-कॉल व्यवहार बदल सकता है, इसलिए पहले की संगतता जाँचें हर अपग्रेड के बाद दोबारा करनी होंगी।
डिप्लॉयमेंट के बाद क्या होता है
शानदार बेंचमार्क नतीजा प्रोडक्शन की भरोसेमंदी साबित नहीं करता। सर्विंग सिस्टम को अनुरोध रद्द होना, संसाधन ख़त्म होना, अप्रत्याशित ट्रैफ़िक, मॉडल लोड की विफलताएँ, रीस्टार्ट और सॉफ़्टवेयर अपग्रेड भी सँभालने होते हैं।
ये ज़िम्मेदारियाँ इन्फरेंस इंजन से आगे तक फैली हैं। API गेटवे ऑथेंटिकेशन और अनुरोध-सीमाएँ सँभाल सकता है। ऑर्केस्ट्रेशन प्लेटफ़ॉर्म सर्विंग प्रोसेस की निगरानी कर सकता है। एप्लिकेशन सेशन, दस्तावेज़ रिट्रीवल, टूल ऑथराइज़ेशन और टाइमआउट नियंत्रित कर सकता है। टीम को तय करना होगा कि हर ज़िम्मेदारी कहाँ आती है।
मॉनिटरिंग और ट्रबलशूटिंग
मान लीजिए कर्मचारी जवाब धीमे आने की शिकायत करते हैं। टीम को पता लगा पाना चाहिए कि कारण बढ़ा हुआ ट्रैफ़िक है, लंबे प्रॉम्प्ट हैं, अनुरोधों की कतारें हैं, मेमोरी का दबाव है, मॉडल एक्ज़िक्यूशन है या एप्लिकेशन की कोई डाउनस्ट्रीम निर्भरता।
इन्फरेंस इंजन आम तौर पर ऑपरेशनल मेट्रिक्स देते हैं। उदाहरण के लिए, vLLM अपने सर्विंग परिवेश के लिए Prometheus-compatible मेट्रिक्स देता है। उपयोगी ऑब्ज़र्वेबिलिटी के लिए इंजन की उन मेट्रिक्स को एप्लिकेशन-स्तर के व्यवहार से जोड़ना होता है।
अगर अनुरोध का ज़्यादातर समय दस्तावेज़ रिट्रीवल में जा रहा है, तो इन्फरेंस इंजन बदलने से शायद ही कोई सुधार मिले। सिर्फ़ GPU की निगरानी पूरे उपयोगकर्ता अनुभव को समझाने के लिए काफ़ी नहीं है।
तेज़ इन्फरेंस लागत घटा सकता है, पर अपने-आप नहीं
ज़्यादा थ्रूपुट से भारी उपयोग वाला डिप्लॉयमेंट उतने ही हार्डवेयर पर ज़्यादा अनुरोध सँभाल सकता है, या ज़रूरी एक्सेलरेटर इंस्टेंस की संख्या घटा सकता है। लेकिन कम इस्तेमाल हो रहे, लगातार बिल होने वाले GPU पर थ्रूपुट बढ़ाने से खर्च घट सकता है, ऐसा ज़रूरी नहीं। आर्थिक मूल्यांकन में इन्फ्रास्ट्रक्चर शुल्क, उपयोग, सफल अनुरोध, इंजीनियरिंग प्रयास, रखरखाव और ऑपरेशनल जटिलता को गिनना चाहिए।
उपयोगी तुलना वह है जो एप्लिकेशन की सेवा-ज़रूरतें पूरी करने की लागत मापे, न कि केवल सैद्धांतिक प्रति-टोकन लागत।
टीम इन्फरेंस इंजन कैसे चुन सकती है
हमारा आंतरिक असिस्टेंट एक उपयोगकर्ता वाले डेमो के रूप में शुरू हुआ था। अब उसे कई तरह के अनुरोधों और कई उपयोगकर्ताओं के लिए भरोसेमंद सर्विंग चाहिए। इंजीनियरिंग टीम के पास अब इतनी समझ है कि वह फ़ैसले को व्यवस्थित ढंग से ले सके।
पहले उसे तय करना चाहिए कि सेल्फ़-मैनेज्ड इन्फरेंस ज़रूरी है या नहीं। हो सकता है मैनेज्ड इन्फरेंस सेवा एप्लिकेशन की ज़रूरतें पहले ही पूरी कर दे और इन्फ्रास्ट्रक्चर की ज़िम्मेदारियाँ घटा दे। अगर सेल्फ़-मैनेज्ड सर्विंग उचित ठहरती है, तो टीम संगत इंजनों को परख सकती है।
| फ़ैसला | क्या तय करना है |
|---|---|
| डिप्लॉयमेंट का तरीक़ा | मैनेज्ड सेवा या सेल्फ़-मैनेज्ड सर्विंग |
| संगतता | ज़रूरी मॉडल, हार्डवेयर, आउटपुट और इंटीग्रेशन |
| परफ़ॉर्मेंस | लेटेंसी, थ्रूपुट और यथार्थवादी ट्रैफ़िक में व्यवहार |
| भरोसेमंदी | संसाधन सीमाएँ, विफलताएँ, मॉनिटरिंग और रिकवरी |
| अर्थशास्त्र | इन्फ्रास्ट्रक्चर लागत, ऑपरेशनल प्रयास और माइग्रेशन का मूल्य |
कभी-कभी मौजूदा इंजन ही सबसे अच्छा व्यावहारिक विकल्प बना रहेगा। प्रतिस्पर्धी इंजन ज़्यादा थ्रूपुट दे सकता है, लेकिन ऐसी संगतता या रखरखाव की लागत जोड़ सकता है जो सुधार से भारी पड़े। सिर्फ़ इसलिए माइग्रेट करने की कोई बाध्यता नहीं कि कोई दूसरा उत्पाद सार्वजनिक बेंचमार्क में आगे है।
इसी तरह, जिस एप्लिकेशन की परफ़ॉर्मेंस और भरोसेमंदी की ज़रूरतें पहले से पूरी हो रही हैं, उसके लिए सरल रनटाइम काफ़ी हो सकता है। फ़ैसला मापे जा सकने वाली एप्लिकेशन ज़रूरतों पर चलना चाहिए, तकनीक की लोकप्रियता पर नहीं।
पेशेवरों को इन्फरेंस इंजन कितनी गहराई से समझने चाहिए
अलग-अलग भूमिकाओं को अलग स्तर के ज्ञान की ज़रूरत होती है।
एप्लिकेशन डेवलपर को जवाब की लेटेंसी, API संगतता, स्ट्रीमिंग, आउटपुट वैलिडेशन और अपने मॉडल अनुरोधों के निहितार्थ समझने चाहिए।
इन्फरेंस इन्फ्रास्ट्रक्चर चलाने वाले प्लेटफ़ॉर्म इंजीनियर और SRE को संसाधन उपयोग, कॉन्करेंसी, मॉनिटरिंग, डिप्लॉयमेंट, भरोसेमंदी और क्षमता नियोजन की गहरी समझ चाहिए।
मॉडल एक्ज़िक्यूशन ऑप्टिमाइज़ करने वाले AI इन्फ्रास्ट्रक्चर विशेषज्ञों को शेड्यूलिंग एल्गोरिदम, KV-cache प्रबंधन, quantization, पैरेलेलिज़्म और एक्सेलरेटर-विशेष तकनीकें भी समझनी पड़ सकती हैं।
हर किसी को इन्फरेंस-इंजन की भीतरी बनावट में महारत हासिल करने की ज़रूरत नहीं। उपयुक्त गहराई इस पर निर्भर करती है कि पेशेवर सर्विंग इन्फ्रास्ट्रक्चर का उपभोग करता है, उसे चलाता है या उसे ऑप्टिमाइज़ करता है।
सही इंजीनियरिंग फ़ैसला लेना
AI मॉडल ध्यान खींचते हैं क्योंकि उनके आउटपुट दिखाई देते हैं। इन्फरेंस इंजन उन आउटपुट के पीछे काम करते हैं और वह कंप्यूटेशनल काम सँभालते हैं जिससे प्रोडक्शन सर्विंग संभव होती है। उनकी अहमियत तब साफ़ होती है जब एप्लिकेशन को एक साथ आता ट्रैफ़िक, बदलती अनुरोध लंबाइयाँ, मेमोरी की सीमाएँ और सर्विस-लेवल की ज़रूरतें झेलनी पड़ती हैं।
इसलिए इन्फरेंस इंजन चुनने के लिए बेंचमार्क के आँकड़ों की तुलना से ज़्यादा कुछ चाहिए। इंजीनियरों को एप्लिकेशन की संगतता जाँचनी होगी, प्रतिनिधि वर्कलोड परखने होंगे, ऑपरेशनल ज़िम्मेदारियाँ समझनी होंगी और सेवा-ज़रूरतें पूरी करने की कुल लागत का मूल्यांकन करना होगा।
उत्पाद और बेंचमार्क रैंकिंग बदलती रहेंगी। बुनियादी फ़ैसला वही रहता है।
वह इन्फरेंस इंजन चुनिए जो स्वीकार्य परफ़ॉर्मेंस, भरोसेमंदी, लागत और ऑपरेशनल जटिलता के साथ एप्लिकेशन की ज़रूरतें पूरी करे, न कि सिर्फ़ वह जो किसी और के बेंचमार्क में सबसे अच्छा चले।
और गहराई में
- vLLM, Official Documentation, vLLM project. इंजन आर्किटेक्चर, PagedAttention, शेड्यूलिंग, मॉडल संगतता और सर्विंग फ़ीचर।
- SGLang, Official Documentation, SGLang project. मॉडल एक्ज़िक्यूशन, स्ट्रक्चर्ड जनरेशन, टूल कॉलिंग और डिप्लॉयमेंट क्षमताएँ।
- SGLang, Serving Benchmark Guide, SGLang project. वर्कलोड जनरेशन, कॉन्करेंसी और ऑनलाइन-सर्विंग माप।
- LMDeploy, Official Documentation, LMDeploy project. TurboMind और PyTorch एक्ज़िक्यूशन बैकएंड, मॉडल समर्थन और सर्विंग।
- llama.cpp, Official Repository, llama.cpp project. पोर्टेबल इन्फरेंस, क्वांटाइज़ एक्ज़िक्यूशन और सर्वर क्षमताएँ।
- NVIDIA, AIPerf Metrics Reference, NVIDIA. इन्फरेंस लेटेंसी, थ्रूपुट और संबंधित मापों की परिभाषाएँ।
- MLCommons, MLPerf Inference, MLCommons. बेंचमार्क पद्धति और प्रकाशित इन्फरेंस-सिस्टम नतीजे।
- vLLM, Optimization and Tuning, vLLM project. प्रीएम्प्शन और KV-cache मेमोरी का दबाव।
- vLLM, Security, vLLM project. एंडपॉइंट सुरक्षा और नोड्स के बीच संचार।
शोध की अंतिम तिथि: October 20, 2026. फ़ीचर की सटीक उपलब्धता और संगतता को उस इंजन रिलीज़ के विरुद्ध जाँच लेना चाहिए जिसे परखा जा रहा है।
TechiesJournal पर संबंधित लेख
- AI Inference हमारे load balancing सोचने के तरीके को क्यों बदल रहा है यह समझने के लिए कि एक सर्वर काफ़ी न रहने पर अनुरोध इन्फरेंस रेप्लिका में कैसे रूट होते हैं।
- खुद ओपन AI मॉडल चलाना: इसके लिए असल में क्या चाहिए सेल्फ़-होस्टिंग के उस फ़ैसले के लिए जो इंजन चुनने से पहले आता है।