

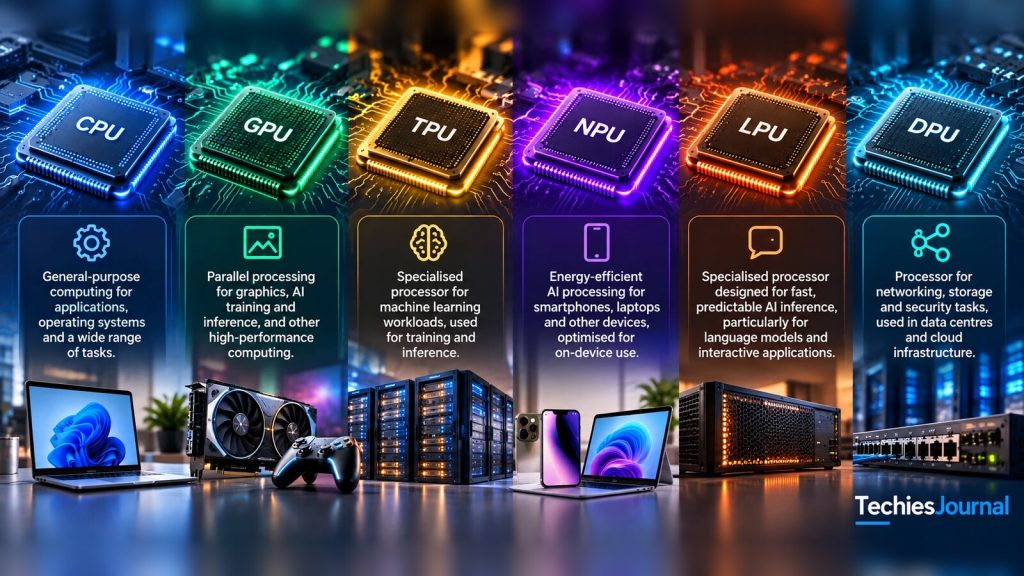
Seis tipos de procesador explicados con palabras sencillas, con ejemplos de teléfonos, computadoras y sistemas de IA.
Ilustración conceptual generada con IA de los seis tipos de procesador. Los chips, los dispositivos y las etiquetas de la imagen son representaciones artísticas, no fotografías de productos reales.
Cuando abres un navegador, juegas a un videojuego, mejoras una foto en el teléfono o le haces una pregunta a un asistente de IA, tu dispositivo o un servicio en línea tiene que realizar distintos tipos de trabajo. Parte de ese trabajo exige flexibilidad. Otra parte consiste en repetir miles de veces cálculos parecidos. Y otra necesita consumir muy poca energía o mover información de forma eficiente entre servidores.
Por eso las computadoras y los servicios de IA usan procesadores diferentes. Seguramente has oído hablar de las CPU y las GPU. Las TPU, NPU, LPU y DPU son menos conocidas, y sus nombres pueden hacer pensar que son versiones rivales del mismo producto. No lo son.
Algunas ejecutan modelos de IA, otras se encargan del trabajo general de las aplicaciones y otras gestionan la infraestructura que sostiene esos modelos. Veamos cómo funciona cada una y dónde puedes encontrarla.
CPU: el procesador de uso general
CPU significa Central Processing Unit (unidad central de procesamiento). Es el procesador flexible que ejecuta una amplia variedad de instrucciones. El sistema operativo, el navegador, las aplicaciones empresariales y muchos procesos de servidor dependen de las CPU.
Una CPU tiene varios núcleos. Cada uno puede ejecutar instrucciones distintas, reaccionar a las decisiones de un programa y coordinar el trabajo con la memoria y otros componentes. Piensa en un chef experto que lee las comandas, pasa de un plato a otro y atiende peticiones inesperadas. Es solo una analogía, pero muestra por qué importa la flexibilidad.
Usos habituales: ejecutar un sistema operativo como Windows, macOS o Linux, ejecutar la lógica de aplicaciones y bases de datos, procesar solicitudes web y coordinar aplicaciones de IA. Las CPU también pueden ejecutar modelos de IA más pequeños cuando su rendimiento es suficiente.
Punto fuerte: resuelve bien tareas variadas. Limitación: suele ser menos eficiente que los aceleradores dedicados ante grandes volúmenes de cálculo de IA paralelizable.
GPU: la especialista en procesamiento paralelo
GPU significa Graphics Processing Unit (unidad de procesamiento gráfico). Nació como hardware para gráficos, donde hay que realizar muchos cálculos similares sobre píxeles y objetos 3D. Esa misma capacidad la hace útil para la IA.
Imagina un equipo de cocina que prepara cientos de platos parecidos a la vez, en lugar de un solo chef que va saltando entre tareas sin relación. Las GPU dividen el trabajo que se presta a ello en muchas operaciones paralelas. Las GPU modernas incluyen además hardware dedicado al cálculo matricial, las operaciones numéricas que las redes neuronales usan de forma intensiva.
Usos habituales: videojuegos y gráficos 3D, simulaciones científicas, entrenamiento de modelos de IA y ejecución de modelos ya entrenados para generar texto, imágenes y otros resultados.
En un servicio de IA en la nube, una CPU puede encargarse de la solicitud del usuario mientras una GPU ejecuta el modelo. Las GPU son importantes porque combinan una gran potencia de cálculo paralelo con un amplio ecosistema de software.
Punto fuerte: realiza en paralelo muchos cálculos que se prestan a ello. Limitación: un hardware de alta potencia puede resultar un desperdicio cuando la carga de trabajo es pequeña o no puede aprovechar el paralelismo disponible. La guía de programación CUDA de NVIDIA explica con más detalle el modelo de ejecución paralela.
TPU: el acelerador de IA especializado de Google
TPU significa Tensor Processing Unit (unidad de procesamiento tensorial). Es la familia de procesadores de Google diseñada para el cálculo de aprendizaje automático. Un tensor es un conjunto de números; una matriz corriente es un ejemplo conocido.
Las redes neuronales realizan cálculos repetidos con estos conjuntos numéricos. Las TPU usan hardware especializado en el procesamiento de matrices para acelerar ese trabajo. Un diseño importante utiliza una cuadrícula de unidades de cálculo que se pasan valores de una a otra, de forma parecida a una cadena de montaje. El término técnico es matriz sistólica (systolic array). Las TPU modernas incluyen también otros componentes de procesamiento, memoria y comunicación.
Usos habituales: entrenar modelos de aprendizaje automático, ejecutar inferencia de IA y desplegar cargas de trabajo compatibles a través de Google Cloud.
Punto fuerte: ejecución eficiente de las operaciones de aprendizaje automático compatibles. Limitación: hay que tener en cuenta el software compatible y la carga de trabajo, porque una TPU no es automáticamente mejor opción que una GPU. La introducción a Cloud TPU de Google analiza de forma explícita situaciones en las que pueden ser preferibles las CPU o las GPU.
NPU: procesamiento de IA eficiente en los dispositivos
NPU significa Neural Processing Unit (unidad de procesamiento neuronal). Designa hardware dedicado a acelerar redes neuronales, que a menudo va integrado en teléfonos, computadoras portátiles y dispositivos embebidos. Muchas NPU están diseñadas para realizar las operaciones de IA compatibles consumiendo menos energía que un procesador más grande y de uso más general.
Un teléfono puede usar hardware de IA dedicado para mejorar fotos o procesar la voz. Una computadora portátil puede usar una NPU para funciones compatibles de videollamada o de accesibilidad. Qué tareas se ejecutan realmente en la NPU depende del dispositivo, del modelo y del software. La CPU o la GPU pueden encargarse de otras partes.
Usos habituales: cámaras de teléfonos, funciones compatibles de voz y lenguaje, efectos de videollamada, e IA embebida y en el borde (edge).
Punto fuerte: aceleración de IA con bajo consumo para cargas de trabajo compatibles en el dispositivo. Limitación: el tamaño del modelo, la memoria y las operaciones compatibles varían de un dispositivo a otro.
Ejecutar la IA en local puede reducir la necesidad de enviar datos a un servicio remoto, pero una NPU no hace que una aplicación sea privada de forma automática. La aplicación puede seguir transmitiendo información a otros lugares. La documentación de Core ML de Apple describe cómo los modelos compatibles pueden usar distintos procesadores del dispositivo.
LPU: la arquitectura de Groq para inferencia de modelos de lenguaje
LPU significa Language Processing Unit (unidad de procesamiento del lenguaje) en la terminología de Groq. A diferencia de CPU o GPU, es un nombre asociado a la arquitectura de inferencia de un proveedor concreto, no una familia de procesadores general de toda la industria.
La inferencia consiste en usar un modelo ya entrenado para obtener un resultado. Groq diseña su tecnología LPU para ejecutar los modelos compatibles de forma rápida y predecible. Su compilador planifica cuándo se realizan los cálculos y hacia dónde se mueve la información. La arquitectura también depende en gran medida de una memoria rápida integrada en el chip.
Imagina una cadena de montaje cuidadosamente programada en la que cada puesto sabe cuándo llegará la información y qué debe hacer a continuación. Es una forma introductoria de entender el diseño, no una descripción literal de cada operación.
Usos habituales: servicio de modelos de lenguaje compatibles, aplicaciones de IA interactivas y sistemas en los que importa una baja latencia de respuesta.
Punto fuerte: ejecución predecible e inferencia potencialmente muy rápida en cargas de trabajo adecuadas. Limitación: la compatibilidad de los modelos, la capacidad de memoria y la necesidad de conectar varios chips afectan al rendimiento real. Generar tokens más rápido no significa necesariamente que la aplicación completa sea más barata o más rápida. Consulta la explicación de la LPU de Groq para ver la descripción de la arquitectura según el propio proveedor.
DPU: el procesador de descarga de infraestructura
DPU significa Data Processing Unit (unidad de procesamiento de datos). Cumple una función distinta de la de los procesadores anteriores. Los grandes servidores y los centros de datos tienen que mover tráfico de red, gestionar operaciones de almacenamiento y aplicar controles de seguridad mientras se ejecutan las aplicaciones.
Una DPU puede asumir determinadas tareas de infraestructura de una CPU principal (host). Piensa en un equipo de logística que se ocupa de las entregas, los controles de acceso y el movimiento de existencias para que las personas que preparan los pedidos puedan centrarse en su trabajo.
Usos habituales: redes de centros de datos, determinadas tareas de cifrado y seguridad, E/S de almacenamiento, aislamiento de la infraestructura y soporte a grandes clústeres de IA.
Punto fuerte: descarga las operaciones de infraestructura de soporte. Limitación: normalmente no es el procesador que realiza los cálculos principales del modelo de IA. La documentación de la plataforma BlueField de NVIDIA ofrece un ejemplo de implementación.
Los seis de un vistazo
| Procesador | Función principal | Dónde puedes encontrarlo | Papel en la IA |
|---|---|---|---|
| CPU | Computación de uso general | Teléfonos, computadoras portátiles, servidores | Ejecuta aplicaciones, coordina el procesamiento y puede ejecutar modelos |
| GPU | Computación paralela | PC, estaciones de trabajo, servidores de IA | Entrenamiento e inferencia |
| TPU | Cálculo especializado de aprendizaje automático | Infraestructura de Google y Google Cloud | Entrenamiento e inferencia |
| NPU | Aceleración eficiente de redes neuronales | Teléfonos, computadoras portátiles, dispositivos inteligentes | IA compatible en el dispositivo |
| LPU | Ejecución especializada de inferencia de Groq | Infraestructura de inferencia de IA | Servicio de modelos compatibles con baja latencia |
| DPU | Descarga de red, almacenamiento y seguridad | Centros de datos y grandes servidores | Da soporte a la infraestructura que rodea las cargas de trabajo de IA |
Estas etiquetas no son todas equivalentes. CPU, GPU, NPU y DPU describen categorías amplias. TPU es la familia de procesadores de Google, y LPU es terminología de Groq. También existen otros aceleradores de IA, como AWS Trainium. La tabla es una introducción, no un catálogo exhaustivo.
Dónde aparecen en la tecnología cotidiana
En un smartphone: la CPU se encarga del trabajo general de las aplicaciones, la GPU de los gráficos y los cálculos compatibles, y una NPU u otro acelerador neuronal similar puede ejecutar las funciones de IA compatibles. No todos los teléfonos tienen los mismos componentes ni las mismas capacidades.
En una computadora portátil o de escritorio: la CPU ejecuta el sistema operativo y las aplicaciones. La GPU acelera los gráficos y, cuando conviene, los modelos de IA. Algunas computadoras portátiles recientes incluyen NPU para funciones de IA local.
En un servicio de IA en la nube: las CPU gestionan las aplicaciones y las solicitudes de los usuarios. Las GPU, TPU, LPU u otros aceleradores compatibles pueden ejecutar el modelo. A gran escala, las DPU pueden ayudar con parte del trabajo de red, seguridad o almacenamiento que rodea a los servidores.
Texto alternativo accesible para esta figura
La figura 1 muestra tres grupos de responsabilidades de los procesadores. Los grupos se solapan, así que no es el diagrama de un único sistema que contiene todos los procesadores.
Dispositivos y aplicaciones, informática cotidiana: CPU, GPU y NPU. Aplicaciones, gráficos e IA local compatible.
Ejecución de modelos de IA, entrenamiento o inferencia (o ambos): GPU, TPU y LPU. Elige hardware compatible con el modelo y la carga de trabajo.
Infraestructura, soporte para grandes sistemas: CPU y DPU. Gestión de servidores, red, seguridad y almacenamiento.
La CPU aparece en el grupo de dispositivos y en el de infraestructura. La GPU aparece en el grupo de dispositivos y en el de ejecución de modelos de IA.
Cada procesador lleva una breve etiqueta con su función: CPU, trabajo general; GPU, cálculo paralelo; TPU, cálculo tensorial; NPU, IA en el dispositivo; LPU, inferencia programada; DPU, descarga de red y almacenamiento.
Las categorías son ilustrativas. Los procesadores concretos que se usan dependen del dispositivo y del despliegue.
Cómo colaboran los distintos procesadores
Sí. Imagina que le pides a un asistente de IA en la nube que resuma un documento.
Tu dispositivo ejecuta la aplicación. Un servidor en la nube recibe la solicitud, comprueba los permisos y prepara la información. Un acelerador compatible realiza los cálculos del modelo. Después, el servidor devuelve el resultado.
Un despliegue grande también puede usar procesadores de infraestructura para algunas tareas de red o de seguridad. Las funciones de IA local de tu teléfono o computadora portátil, en cambio, pueden usar una NPU.
Texto alternativo accesible para esta figura
La figura 2 muestra, de forma simplificada, una posible solicitud de IA.
Paso 1. El dispositivo del usuario ejecuta la aplicación en una CPU. Una GPU o NPU local es opcional. La solicitud va a un servidor de aplicaciones en la nube.
Paso 2. En el servidor de aplicaciones en la nube, una CPU gestiona la solicitud y los permisos. Después, la solicitud pasa a un acelerador de IA.
El acelerador de IA es una opción compatible elegida entre GPU, TPU o LPU. Son alternativas, no tres etapas obligatorias.
Paso 3. La respuesta generada vuelve al usuario.
Soporte de infraestructura opcional: una DPU puede encargarse de determinadas tareas de red, almacenamiento y seguridad alrededor de los servidores.
Lo importante es que no todas las aplicaciones de IA necesitan los seis tipos de procesador. Una CPU corriente puede bastar para un modelo pequeño. Un servicio de IA potente puede combinar muchos tipos de hardware distintos.
Qué procesador conviene estudiar primero
Si te estás iniciando en la informática, empieza por la CPU y la GPU. Entender la computación de uso general y la computación paralela es la mejor base.
Si desarrollas aplicaciones móviles o embebidas, aprende cuándo puede el software usar una NPU y cuáles son sus límites. Si trabajas con modelos de IA, despliegue en la nube o aprendizaje automático, conoce bien las GPU y los aceleradores especializados como las TPU. Si trabajas en redes o infraestructura de centros de datos, las DPU cobran más relevancia. Y si evalúas el servicio de modelos con baja latencia, la LPU de Groq es una arquitectura que vale la pena entender.
No necesitas dominar los seis nombres solo porque aparezcan en los debates sobre IA. Aprende lo suficiente para reconocer qué hace cada uno y profundiza después donde tu trabajo lo requiera.
La diferencia principal que conviene recordar
Las CPU son procesadores flexibles de uso general. Las GPU destacan en el trabajo que se presta a la paralelización. Las TPU de Google aceleran el cálculo de aprendizaje automático. Las NPU permiten un procesamiento de IA eficiente en los dispositivos. Las LPU de Groq adoptan un enfoque especializado para la inferencia de modelos. Las DPU descargan determinadas tareas de infraestructura.
Estas tecnologías pueden complementarse entre sí, y ninguna es la opción universal para todas las aplicaciones.
El mejor procesador no es simplemente el más potente. Es el que mejor se adapta al trabajo que hay que hacer.
Fuentes y lecturas adicionales
Fecha de corte de las fuentes: 17 de octubre de 2026. Cada fuente se abrió y se comprobó el 17 de octubre de 2026. Varias son documentos de proveedores, por lo que describen los productos de cada proveedor y no son comparaciones independientes.
- Intel: CPU vs GPU. Introducción al procesamiento de uso general y al procesamiento paralelo.
- NVIDIA: CUDA Programming Guide. El modelo de ejecución de la GPU y la programación paralela.
- Google Cloud: Introduction to Cloud TPU. Finalidad de las TPU, cargas de trabajo adecuadas y limitaciones.
- Apple: Core ML. Uso de modelos de aprendizaje automático en el hardware de los dispositivos de Apple.
- Groq: What is a Language Processing Unit?. Explicación de la propia Groq sobre su arquitectura. Sus afirmaciones promocionales de rendimiento no deben tomarse como resultados de pruebas comparativas independientes.
- NVIDIA: BlueField Networking Platform. Usos de la DPU en redes, seguridad y almacenamiento.
- AWS: Trainium. Un ejemplo de acelerador de IA más allá de las seis etiquetas introductorias.
Fuentes técnicas revisadas el 17 de octubre de 2026. Las capacidades de los productos cambian, así que consulta la documentación enlazada para conocer los detalles actuales.