

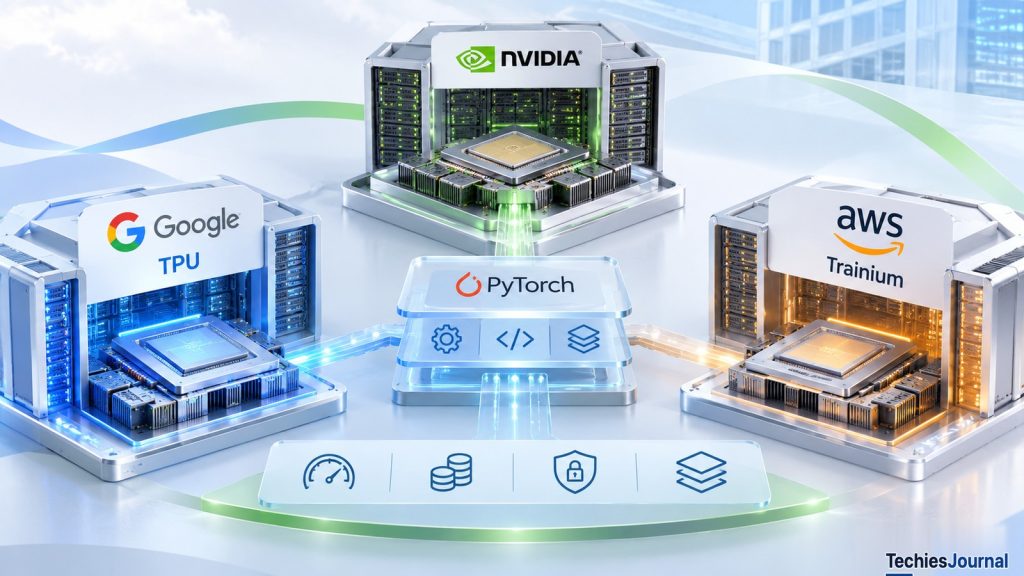
Google తాజా TPU సిస్టమ్లు, PyTorch మద్దతులో మెరుగుదలలు AI కంప్యూటింగ్కు మరిన్ని ఎంపికలను సృష్టిస్తున్నాయి. కానీ NVIDIA పై ఆధారపడటాన్ని తగ్గించాలంటే వేరే ప్రాసెసర్ను ఎంచుకోవడం కంటే ఎక్కువే అవసరం.
సంస్థలు NVIDIA కు అవతల ఎందుకు చూస్తున్నాయి
ఉద్యోగులు అంతర్గత పత్రాలను వెతకడానికి, ప్రశ్నలకు సమాధానాలు పొందడానికి, సాధారణ పనులు పూర్తి చేయడానికి సహాయపడే ఒక AI అసిస్టెంట్ను నడుపుతున్న కంపెనీని ఊహించండి. ఆ అసిస్టెంట్ NVIDIA GPUలపై నడుస్తుంది. దాని డెవలపర్లు PyTorch ను, NVIDIA కంప్యూటింగ్ ప్లాట్ఫామ్ కోసం ఆప్టిమైజ్ చేసిన libraries ను వాడుతున్నారు.
సర్వీస్ విస్తరిస్తున్న కొద్దీ కంపెనీకి మరింత ప్రాసెసింగ్ సామర్థ్యం అవసరమవుతుంది. విశ్వసనీయతను లేదా ఇప్పటికే పెట్టిన ఇంజనీరింగ్ పెట్టుబడిని త్యాగం చేయకుండా, అవసరమైన సర్వీస్ను తక్కువ మొత్తం ఖర్చుతో అందించగల ప్రత్యామ్నాయ హార్డ్వేర్ ఉందా అని దాని ఆర్కిటెక్ట్లు తెలుసుకోవాలనుకుంటున్నారు.
Google, మెషిన్-లెర్నింగ్ వర్క్లోడ్ల కోసం రూపొందించిన ప్రత్యేక ప్రాసెసర్లైన Tensor Processing Units (TPUలు) ను అందిస్తోంది. AWS, మరొక AI accelerators కుటుంబమైన Trainium ను అందిస్తోంది. ఈ రెండు ప్రొవైడర్లూ పరిచితమైన డెవలప్మెంట్ frameworks కు మద్దతును మెరుగుపరుస్తున్నాయి. నవంబర్ 9, 2026 న Google TPU 8tx, TPU 8i Max లను ప్రకటించడం ఈ ప్రశ్నను సమయోచితం చేస్తోంది, కానీ అసలు మార్పు ఏమిటంటే, సంస్థలు సరిపోయే AI వర్క్లోడ్లను కేవలం NVIDIA పైనే ఆధారపడకుండా నడపగలవా అనేది.
NVIDIA ను భర్తీ చేయడం ఎందుకు కష్టం
Graphics processing units (GPUలు) అనేక లెక్కలను సమాంతరంగా చేయగలవు కాబట్టి AIకి ముఖ్యమయ్యాయి. అందువల్ల అవి న్యూరల్ నెట్వర్క్ల training కు, అలాగే inference కు, అంటే శిక్షణ పొందిన మోడల్ను ఉపయోగించి ఫలితాలను రాబట్టడానికి ఉపయోగపడతాయి.
NVIDIA ప్రయోజనం దాని ప్రాసెసర్లను దాటి విస్తరిస్తుంది. దాని parallel computing ప్లాట్ఫామ్ అయిన CUDA ప్రోగ్రామింగ్ టూల్స్ను, ఆప్టిమైజ్ చేసిన libraries ను అందిస్తుంది. AI frameworks, custom operations, inference engines, deployment టూల్స్ ఆ ఎకోసిస్టమ్తో దగ్గరగా కలిసిపోయాయి. అందువల్ల ఒక PyTorch అప్లికేషన్ డెవలపర్లు CUDA కోడ్ను నేరుగా అరుదుగా రాసినా కూడా NVIDIA-నిర్దిష్ట భాగాలపై ఆధారపడవచ్చు.
అప్లికేషన్ను మరొక accelerator కు మార్చడానికి GPU యొక్క compute పనితీరును సరిపోల్చడం కంటే ఎక్కువే అవసరం. మోడల్, ఆధారపడే libraries, మెమరీ అవసరాలు, ఆపరేటింగ్ టూల్స్ ప్రత్యామ్నాయ హార్డ్వేర్లో సరిగ్గా, సమర్థంగా పనిచేయాలి. అందుకే NVIDIA ను సులభంగా భర్తీ చేయలేరు.
ప్రాసెసర్ మౌలికాంశాల కోసం TechiesJournal యొక్క CPU vs GPU vs TPU vs NPU vs LPU vs DPU వివరణ వ్యాసం చూడండి.
Google కొత్త TPU సిస్టమ్లు ఏమి మారుస్తాయి
నవంబర్ 9, 2026 న Google తన eighth-generation TPU పోర్ట్ఫోలియోను విస్తరిస్తూ TPU 8tx, TPU 8i Max లను ప్రకటించింది.
| TPU సిస్టమ్ | ఉద్దేశించిన వర్క్లోడ్ |
|---|---|
| TPU 8t | పెద్ద స్థాయి మోడల్ training |
| TPU 8i | రియల్-టైమ్ inference, reasoning |
| TPU 8tx | గోప్యమైన inference, సున్నితమైన AI వర్క్లోడ్లు |
| TPU 8i Max | పెద్ద-context వర్క్లోడ్లు, పెరిగిన compute సాంద్రత |
ఇవి ఒకే ప్రాసెసర్ యొక్క నాలుగు పరస్పరం మార్చుకోదగిన వెర్షన్లు కావు. ప్యాకేజింగ్, మెమరీ, నెట్వర్కింగ్, సెక్యూరిటీ సహా హార్డ్వేర్ సిస్టమ్లను వేర్వేరు AI వర్క్లోడ్లకు Google అనుగుణంగా మలుస్తోంది. TPU 8tx, TPU 8t తో సమానమైన silicon ను వాడుతుందని, TPU 8i Max ఇప్పటికే ఉన్న రెండు TPU 8i చిప్లను ప్యాకేజ్ చేస్తుందని Google చెబుతోంది, కాబట్టి ఇవి కొత్త చిప్ ఆర్కిటెక్చర్లు కాకుండా కొత్త సిస్టమ్ కాన్ఫిగరేషన్లు.
TPU 8tx: సున్నితమైన వర్క్లోడ్లకు రక్షణ
సున్నితమైన కస్టమర్ రికార్డులను ప్రాసెస్ చేయడానికి AI మోడల్ను వాడుతున్న ఒక ఆర్థిక సంస్థను పరిగణించండి. నిల్వలో, ప్రసారంలో డేటాను రక్షించడం ముఖ్యమే, కానీ మోడల్ ఆ సమాచారాన్ని ప్రాసెస్ చేస్తున్న సమయంలో కూడా ఆ సంస్థకు రక్షణలు అవసరం కావచ్చు.
Confidential computing (అమలు సమయంలో డేటాను రక్షించే విధానం) అమలు సమయంలో అనధికార ప్రవేశాన్ని తగ్గించడానికి హార్డ్వేర్ ఆధారిత isolation, రక్షణ యంత్రాంగాలను వాడుతుంది. మద్దతు ఉన్న inference వర్క్లోడ్లకు, అలాగే ప్రైవేట్ మోడల్ customization కు, ఎంపిక చేసిన training వినియోగాలకు TPU 8tx అలాంటి సామర్థ్యాలను అందిస్తుందని Google చెబుతోంది.
Confidential computing మొత్తం అప్లికేషన్ సెక్యూరిటీకి హామీ ఇవ్వదు. ఐడెంటిటీ, permissions, మోడల్ ప్రవర్తన, deployment కాన్ఫిగరేషన్ వేర్వేరు బాధ్యతలుగా మిగిలే ఉంటాయి.
TPU 8i Max: కష్టతరమైన context వర్క్లోడ్లకు తోడ్పాటు
విస్తృతమైన పత్రాలను లేదా సాఫ్ట్వేర్ రిపాజిటరీలను ప్రాసెస్ చేసే ఒక AI ఏజెంట్కు మెమరీ సామర్థ్యం, మెమరీకి compute భాగాలకు మధ్య సమాచారం కదిలే వేగం పరిమితులు కావచ్చు.
TPU 8i Max కోసం Google రెండు TPU 8i చిప్లను ఒకే ప్యాకేజీలో కలుపుతుంది. ఒక TPU 8i తో పోలిస్తే రెండింతల compute, on-chip SRAM, high-bandwidth memory bandwidth ఉంటాయని కంపెనీ నివేదిస్తోంది. ఈ పోలికలు Google సొంత పోర్ట్ఫోలియో లోపలివే. సమానమైన NVIDIA deployment కంటే ప్రయోజనాన్ని అవి నిరూపించవు.
ప్రకటించడం అంటే అందరికీ అందుబాటులో ఉన్నట్లు కాదు
ఈ ప్రకటన ఉద్దేశించిన సామర్థ్యాలను వివరిస్తుంది. ప్రతి కాన్ఫిగరేషన్కు, లొకేషన్కు, deployment మోడల్కు సాధారణ కస్టమర్ లభ్యతను అది నిర్ధారించదు. మైగ్రేషన్ను ప్రణాళిక వేసే ముందు కొనుగోలుదారులు అర్హత, సామర్థ్యం, మద్దతు ఉన్న సాఫ్ట్వేర్, ధర, వాణిజ్య యాక్సెస్ను నిర్ధారించుకోవాలి.
చిప్ల కంటే PyTorch మద్దతు ఎందుకు ఎక్కువ ముఖ్యం కావచ్చు
డెవలపర్ల అప్లికేషన్లు దానిపై నడవగలిగినప్పుడే accelerator వారికి ఉపయోగపడుతుంది. అక్టోబర్ 20, 2026 న PyTorch ప్రాజెక్ట్ TorchTPU ను ప్రకటించింది, ఇది Google, Meta ల ఓపెన్-సోర్స్ సహకారం. TorchTPU, Google TPUల కోసం native PyTorch backend ను పరిచయం చేస్తుంది, అప్లికేషన్లను మరొక మెషిన్-లెర్నింగ్ framework చుట్టూ తిరిగి నిర్మించాల్సిన అవసరాన్ని తగ్గించడం దీని లక్ష్యం.
ఈ ప్రాజెక్ట్ చురుగ్గా అభివృద్ధి చెందుతోంది. కొన్ని training, inference వర్క్లోడ్లకు ప్రొడక్షన్ వినియోగాన్ని దాని డెవలపర్లు వివరిస్తున్నారు, కానీ అది ప్రతి మోడల్కు compatibility కి లేదా ప్రొడక్షన్ సంసిద్ధతకు హామీ కాదు.
మోడల్ను నడపడం, దాన్ని ఆప్టిమైజ్ చేయడం ఒకటి కాదు
కంపెనీ AI అసిస్టెంట్కు తిరిగి వెళ్దాం. దాని ప్రస్తుత PyTorch మోడల్ NVIDIA GPUలను వాడుతోందనుకోండి. మద్దతు ఉన్న కాన్ఫిగరేషన్కు, execution device ను మార్చడం వల్ల మోడల్ TPUలపై నడిచి సరైన సమాధానాలు ఇవ్వవచ్చు. TorchTPU స్వంత వివరణ ప్రకారం, పోర్టింగ్ అనేది model.to("cuda") ను model.to("tpu") గా మార్చినంత సులభం కావచ్చు, అయితే గరిష్ఠ పనితీరుకు ఇంకా ఎక్కువ అవసరమనే షరతు ఉంది. అది ఉపయోగకరమైన ఆరంభ స్థానం, మైగ్రేషన్ ముగింపు కాదు.
అసలు మోడల్ GPU-నిర్దిష్ట custom kernels ను, ప్రత్యేక మెమరీ layouts ను, లేదా తన layers ను ప్రాసెసర్ల మధ్య విభజించే ఒక వ్యూహాన్ని వాడుతుండవచ్చు. TPU హార్డ్వేర్పై మెమరీని, accelerator కమ్యూనికేషన్ను సమర్థంగా వాడుకోవడానికి వేరే sharding వ్యూహం (మోడల్ను ప్రాసెసర్ల మధ్య పంచే విధానం) అవసరం కావచ్చు. సరిగ్గా అమలయ్యే ఒక operation కూడా tuning లేకుంటే పేలవంగా పనిచేయవచ్చు.
మోడల్ shapes, sharding, operations లను ఆచరణాత్మక ఆప్టిమైజేషన్ అంశాలుగా TorchTPU సాంకేతిక చర్చ గుర్తిస్తోంది. XLA compiler, tensor shapes compile సమయంలోనే తెలిసి ఉండాలని ఆశిస్తుందని, మారే shapes కు మద్దతు ఇంకా చురుగ్గా అభివృద్ధి దశలో ఉందని కూడా అది పేర్కొంటోంది. Framework compatibility వల్ల ఒక వర్క్లోడ్ను నడపడం సాధ్యమవుతుంది. Performance portability సాధించాలంటే, అవసరానికి మించిన పునఃఅభివృద్ధి లేకుండా మొత్తం సిస్టమ్ సమర్థంగా నడవాలి.
మూలం: PyTorch, అక్టోబర్ 20, 2026.
ఈ చిత్రానికి అందుబాటులో ఉండే టెక్స్ట్ ప్రత్యామ్నాయం
మీ PyTorch మోడల్ను model.to("cuda") తో NVIDIA GPU కి పంపవచ్చు, అక్కడ CUDA libraries, GPU kernels వాడబడతాయి.
లేదా model.to("tpu") తో Google TPU కి పంపవచ్చు, అక్కడ TorchTPU backend, XLA compiler వాడబడతాయి. మోడల్ నడుస్తుంది.
గరిష్ట వేగానికి ఇంకా tuning అవసరం: model shapes, sharding, GPU-నిర్దిష్ట kernels.
AWS ఇలాంటి ప్రత్యామ్నాయాన్ని అభివృద్ధి చేస్తోంది
AWS, Trainium ద్వారా సంబంధిత విధానాన్ని అనుసరిస్తోంది. అక్టోబర్ 20, 2026 న అది TorchNeuron ను ప్రకటించింది, ఇది మద్దతు ఉన్న Trainium మౌలిక సదుపాయాల కోసం ఉద్దేశించిన native PyTorch backend. eager execution, compilation సహా పరిచితమైన PyTorch డెవలప్మెంట్ నమూనాలకు ఇది మద్దతు ఇస్తుంది.
AWS, TorchNeuron ను Trainium2, Trainium3 ల కోసం public beta గా విడుదల చేసింది. ఈ స్థితి మద్దతు అంచనాలకు, ప్రొడక్షన్ ప్రణాళికకు ముఖ్యం. TorchNeuron, TorchTPU కొన్ని సాఫ్ట్వేర్ స్వీకరణ అడ్డంకులను తగ్గిస్తాయి, కానీ Google, AWS accelerators ను పరస్పరం మార్చుకోదగినవిగా చేయవు. హార్డ్వేర్, compilers, మద్దతు ఉన్న operations, deployment వాతావరణాలు వేర్వేరు.
NVIDIA సంపూర్ణ సిస్టమ్ల ద్వారా పోటీ పడుతోంది
NVIDIA కూడా కష్టతరమైన AI వర్క్లోడ్లకు అనుగుణంగా మారుతోంది. 2026 మార్చిలో production-ready గా ప్రకటించిన దాని Dynamo 1.0 inference framework, distributed execution, request routing, GPU సిస్టమ్లలో మెమరీని మరింత సమర్థంగా వాడడాన్ని పరిష్కరిస్తుంది.
NVIDIA Rubin ఆర్కిటెక్చర్, compute, మెమరీ, interconnects లో మెరుగుదలల ద్వారా reasoning, long-context inference లను లక్ష్యంగా చేసుకుంటుంది. దాని ప్రచురిత పనితీరు గణాంకాలు vendor-reported వాదనలు, వాటిని అన్నిచోట్లా సాధించిన ఫలితాలుగా భావించకూడదు.
ఇది వేరువేరు ప్రాసెసర్ల మధ్య కాకుండా, హార్డ్వేర్, ప్రోగ్రామింగ్ ఇంటర్ఫేస్లు, inference సాఫ్ట్వేర్, నెట్వర్కింగ్ సహా accelerator ప్లాట్ఫామ్ల మధ్య పోటీ. క్లౌడ్ పెట్టుబడి నేపథ్యం గురించి మరింత తెలుసుకోవడానికి TechiesJournal యొక్క AWS, NVIDIA మౌలిక సదుపాయాల విస్తరణ వ్యాసం చూడండి.
మూలాలు: NVIDIA Dynamo, మార్చి 16, 2026 మరియు Rubin ఆర్కిటెక్చర్, జూలై 21, 2026.
ప్రత్యామ్నాయం విలువైనదో కాదో ఎలా నిర్ణయించాలి
కంపెనీ ఆర్కిటెక్ట్లు ఇప్పుడు తమ స్థిరపడిన NVIDIA deployment ను అందుబాటులో ఉన్న, మద్దతు ఉన్న TPU కాన్ఫిగరేషన్తో పోల్చాలనుకుంటున్నారు. వేరువేరు చిప్ స్పెసిఫికేషన్లను పోల్చడం కంటే సమానమైన వర్క్లోడ్లను పరీక్షించాలి. రెండు సిస్టమ్లూ ఒకే మోడల్తో, లేదా తేడాలను పారదర్శకంగా నమోదు చేసిన కాన్ఫిగరేషన్లతో ఆమోదయోగ్యమైన మోడల్ నాణ్యతను అందించాలి.
| మూల్యాంకన అంశం | కొలవాల్సినది |
|---|---|
| Correctness | అవుట్పుట్ నాణ్యత, మద్దతు ఉన్న operations |
| Latency | మొదటి token వరకు సమయం, పూర్తి ప్రతిస్పందన |
| Throughput | అవసరమైన concurrency వద్ద ఉపయోగకరమైన పని |
| మెమరీ | సామర్థ్యం, bandwidth, long-context ప్రవర్తన |
| ఖర్చు | సమానమైన సర్వీస్కు మొత్తం ఖర్చు |
| మైగ్రేషన్ | కోడ్ మార్పులు, tuning, ఇంజనీరింగ్ శ్రమ |
| ఆపరేషన్స్ | మానిటరింగ్, మద్దతు, లభ్యత, troubleshooting |
వర్క్లోడ్ అసమర్థంగా నడిస్తే తక్కువ గంట ధర కూడా అధిక సర్వీస్ ఖర్చుకు దారితీయవచ్చు. అవసరమైన సర్వీస్ పరిమితుల్లో ఎక్కువ ఉపయోగకరమైన పనిని అందించినప్పుడు ఖరీదైన సిస్టమ్ కూడా లాభదాయకం కావచ్చు. ప్రచురిత benchmarks అభ్యర్థులను ఎంచుకోవడానికి సహాయపడతాయి, కానీ మోడల్, precision, context పొడవు, concurrency లలో తేడాల వల్ల ముఖ్య ఫలితాలను పోల్చలేకపోవచ్చు.
ఒక ఆధారపడటాన్ని మార్చడం మరొకదాన్ని తీసుకురావచ్చు
TPUలకు మారడం CUDA, NVIDIA హార్డ్వేర్ పై ఆధారపడటాన్ని తగ్గించగలదు, అదే సమయంలో Google Cloud పై, TPU-నిర్దిష్ట టూలింగ్ పై, లేదా మద్దతు ఉన్న deployment ఎంపికలపై ఆధారపడటాన్ని పెంచవచ్చు. Trainium, AWS లోపల ఇలాంటి ఆధారపడటాలను సృష్టించగలదు.
Hardware independence అంటే ఒక accelerator ఎకోసిస్టమ్కు ఆచరణీయమైన ప్రత్యామ్నాయం ఉండటం. Cloud portability అంటే అధిక పునఃరూపకల్పన, ఆపరేషనల్ అంతరాయం లేకుండా అప్లికేషన్ను క్లౌడ్ వాతావరణాల మధ్య తరలించగలగడం. ఒకటి మరొకదానికి హామీ ఇవ్వదు.
ఒకే ప్రొవైడర్కు కట్టుబడిన సంస్థ కొలవదగిన లాభాల కోసం ప్రత్యేక ఇంటిగ్రేషన్ను అంగీకరించవచ్చు. మల్టీ-క్లౌడ్ సంస్థ portability కి ఎక్కువ విలువ ఇవ్వవచ్చు. ఏ లక్ష్యాన్నీ దాని ఖర్చును పరిగణించకుండా అనుసరించకూడదు.
NVIDIA మార్కెట్ వాటాను కోల్పోతుందా?
విశ్వసనీయమైన ఎంపికలు కనిపించడం అనేది, తనంతట తానుగా, NVIDIA కు ఆర్థిక నష్టాన్ని నిర్ధారించదు. మూడు ఫలితాలు వేర్వేరు.
Choice అంటే ఒక కస్టమర్ మరొక accelerator ను పరిగణించగలగడం. Substitution అంటే ఆ కస్టమర్ నిజంగా మద్దతు ఉన్న వర్క్లోడ్ను తరలించడం. Financial displacement అంటే ఆ తరలింపు, లేకపోతే జరిగేదానితో పోలిస్తే, NVIDIA కొనుగోళ్లను తగ్గించడం.
NVIDIA GPUలు, custom accelerators ఒకేసారి వృద్ధి చెందేంతగా AI కంప్యూటింగ్ మార్కెట్ విస్తరించవచ్చు. NVIDIA సాఫ్ట్వేర్ ఎకోసిస్టమ్, installed base ప్రయోజనాలుగా మిగిలే ఉన్నాయి. TPU 8tx లేదా TPU 8i Max కారణంగా ఒక నిర్దిష్ట మార్కెట్-వాటా అంచనాను ప్రస్తుత ఆధారాలు సమర్థించలేవు.
డెవలపర్లు, క్లౌడ్ ఆర్కిటెక్ట్లు ఇప్పుడు ఏమి చేయాలి
ఇప్పటికే ఉన్న బృందాలు మొదట CUDA-నిర్దిష్ట kernels ను, inference libraries ను, model-serving dependencies ను, GPU-ఆధారిత ఆపరేషనల్ టూల్స్ను గుర్తించాలి. కొత్త సిస్టమ్లు మోడల్ అవసరాలు, అందుబాటులో ఉన్న సామర్థ్యం, latency, సెక్యూరిటీ, మొత్తం ఖర్చు ఆధారంగా accelerator ఎంపికలను షార్ట్లిస్ట్ చేయాలి.
సంభావ్య ప్రయోజనాలు శ్రమను సమర్థించే చోట, నమ్మదగిన baseline కు వ్యతిరేకంగా పరిమిత benchmark నిర్వహించండి. మోడల్ నడుస్తుందా, ఎంత బాగా పనిచేస్తుంది, ఏ ఇంజనీరింగ్ పని అవసరమవుతుంది, ఆపరేటింగ్ మోడల్కు మద్దతు ఇవ్వగలమా అనేది నమోదు చేయండి.
Google TPU విస్తరణ, మెరుగవుతున్న framework మద్దతు ఎంపిక చేసిన వర్క్లోడ్లకు accelerator ప్రత్యామ్నాయాలను మరింత ఆచరణాత్మకం చేస్తున్నాయి. మారడం విలువైనదో కాదో compatibility, కొలిచిన పనితీరు, మొత్తం ఖర్చు, అది తెచ్చే కొత్త ఆధారపడటాల ఆధారంగా నిర్ణయించాలి.
మరింత లోతుగా తెలుసుకోండి
- Google: Our newest TPUs, 8tx and 8i Max (నవంబర్ 9, 2026).
- PyTorch: Introducing TorchTPU (అక్టోబర్ 20, 2026).
- AWS: Native PyTorch Support for AWS Trainium (అక్టోబర్ 20, 2026).
- NVIDIA: Dynamo 1.0 Production-Scale Inference (మార్చి 16, 2026).
- NVIDIA: Inside Rubin GPU Architecture (జూలై 21, 2026).
మూలాలను నవంబర్ 13, 2026 న చదివాము. ఉత్పత్తి లభ్యత, పరిపక్వత, వెండర్ వాదనలు మారవచ్చు.