

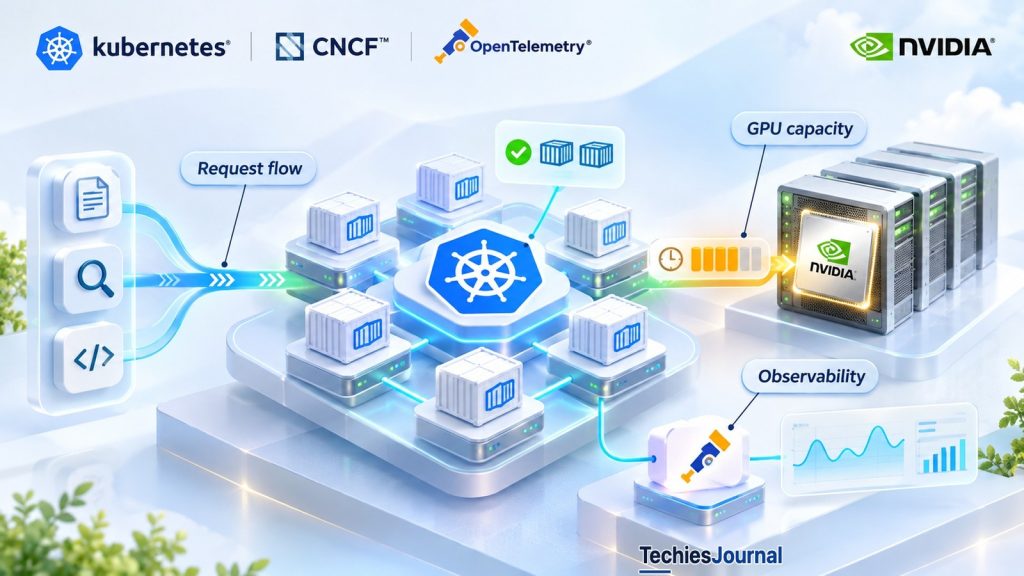
À mesure que les organisations mettent l’IA en production, Kubernetes devient un environnement familier pour les services qui l’entourent. Mais une application peut fonctionner alors que les utilisateurs attendent toujours leurs réponses. Cette différence change la manière dont les équipes plateforme analysent les performances, allouent les GPU et planifient un service fiable.
Illustration éditoriale : L’entreprise et l’incident décrits dans cet article sont fictifs. Les explications techniques et les statistiques du secteur s’appuient sur les sources citées en lien.
Tout fonctionne, mais les employés attendent
Le nouvel assistant d’IA de l’entreprise semblait être une réussite. Les employés pouvaient poser des questions sur les politiques internes et les documents techniques au lieu de chercher sur plusieurs sites web. Le projet pilote renvoyait des réponses utiles en quelques secondes. Ses développeurs ont empaqueté le logiciel dans des conteneurs et l’ont déployé sur la plateforme Kubernetes existante de l’entreprise.
Puis l’assistant a été ouvert à des milliers d’employés. Certaines réponses arrivaient rapidement, d’autres prenaient tant de temps que les utilisateurs abandonnaient.
Les ingénieurs d’exploitation ont inspecté le cluster. Les nœuds étaient disponibles, les conteneurs de l’application fonctionnaient et Kubernetes avait maintenu le nombre de copies attendu. Pourtant, le service semblait en panne.
Ajouter un serveur d’application de plus semblait la réponse évidente. Mais cela aurait coûté de l’argent sans répondre à une question plus importante : où chaque requête passait-elle son temps ?
Ce problème reflète un changement plus large. Dans son enquête 2025 Annual Cloud Native Survey, publiée en janvier 2026, la CNCF indiquait que 82 % des utilisateurs de conteneurs interrogés exploitaient Kubernetes en production.
Dans une autre question de l’enquête, à laquelle ont répondu 213 organisations hébergeant des charges de travail d’IA, 66 % utilisaient Kubernetes pour une partie ou la totalité de leurs charges de travail d’inférence. Ces chiffres décrivent des groupes de répondants différents, et non l’ensemble des entreprises dans le monde. La CNCF a également créé un parcours thématique dédié AI Inference + Agentic à la KubeCon North America 2026.
L’IA arrive dans une infrastructure que les équipes plateforme connaissent déjà. Tout le mystère est de comprendre pourquoi des outils familiers ne racontent pas toujours toute l’histoire.
Suivre une question à travers le système
Les ingénieurs choisissent une requête retardée : un employé a demandé ce qui avait changé dans la politique de remboursement des frais de déplacement.
L’assistant vérifie d’abord que l’employé a le droit de consulter cette politique. Il effectue une recherche dans les documents de l’entreprise, sélectionne les passages pertinents, puis envoie la question et le texte à l’appui à un modèle de langage. Le modèle génère une réponse. Trouver les informations à l’appui avant la génération s’appelle couramment la génération augmentée par récupération (retrieval-augmented generation, RAG). Utiliser un modèle déjà entraîné pour produire une réponse s’appelle l’inférence.
Kubernetes peut faire fonctionner le logiciel qui assure ces étapes. Un conteneur (container) regroupe une application et ses dépendances logicielles.
Kubernetes planifie les conteneurs dans des Pods, les unités qu’il place sur des machines de travail appelées nœuds (nodes). Il peut maintenir le nombre de copies demandé et remplacer les Pods défaillants lorsque des ressources adaptées sont disponibles. La présentation officielle de Kubernetes explique le modèle d’orchestration.
Mais l’assistant ne fonctionne pas comme un service unique et indivisible. Sa requête traverse plusieurs étapes :
| Étape de la requête | Travail effectué | Retard possible |
|---|---|---|
| Identité | Vérifier les droits d’accès de l’employé | Réponse du service d’identité |
| Récupération | Rechercher dans les documents de politique indexés | Latence de la recherche ou du stockage |
| Inférence | Générer une réponse avec le modèle de langage | Attente de capacité du modèle et temps de génération |
| Retour | Transmettre la réponse à l’application | Retard du réseau ou de l’application |
Dans notre enquête, qui sert d’illustration, les services d’identité et de récupération répondent rapidement. Les requêtes s’accumulent au niveau de l’inférence.
L’API de l’application accepte les questions plus vite que le modèle ne peut les traiter, ce qui crée une file d’attente (queue). Davantage de Pods d’API ne feraient qu’alimenter plus vite la même file d’attente. Les ingénieurs ont localisé le goulot d’étranglement. Il leur faut maintenant comprendre la ressource qui se trouve derrière.
Un CPU disponible n’est pas un GPU disponible
Les services web ordinaires dépendent souvent avant tout d’un CPU, le processeur généraliste qui exécute le code de l’application, et de la mémoire pour les données actives. Les grands modèles de langage utilisent fréquemment des GPU, des processeurs adaptés à de nombreuses opérations mathématiques parallèles. Les GPU ont aussi besoin d’une mémoire dédiée suffisante pour contenir les données du modèle et traiter les requêtes. Tous les services d’IA n’ont pas besoin de leur propre GPU : les modèles plus petits peuvent fonctionner sur des CPU, et de nombreuses applications appellent plutôt un modèle hébergé.
Notre entreprise a choisi d’héberger un modèle qui s’appuie sur des GPU. Imaginez qu’elle dispose de quatre GPU adaptés et que les quatre soient déjà alloués à des charges de travail de service de modèles. Il se peut que Kubernetes dispose de CPU et de mémoire libres pour un Pod d’API supplémentaire, mais un réplica supplémentaire du modèle a besoin d’un GPU adapté. Ce réplica peut rester non planifié alors même que le cluster semble disposer de beaucoup de capacité de calcul ordinaire.
Kubernetes prend connaissance des GPU grâce aux plugins de périphériques (device plugins) et peut utiliser l’allocation dynamique de ressources (Dynamic Resource Allocation, DRA) pour permettre aux charges de travail de demander des caractéristiques de périphériques au moyen de demandes de ressources (resource claims). DRA est stable depuis Kubernetes 1.35.
Point essentiel, la documentation de DRA indique que l’ordonnanceur (scheduler) ne peut pas préempter un Pod existant qui utilise des ressources DRA pour attribuer ce périphérique à un Pod de priorité plus élevée. Le Pod urgent peut rester en attente jusqu’à ce que le périphérique se libère. Le partage de périphériques est possible dans les configurations prises en charge. L’exemple des quatre GPU n’est qu’une illustration simplifiée, et non une règle universelle d’une charge de travail par GPU.
C’est à ce stade que l’ancien réflexe de mise à l’échelle de l’équipe échoue : créer davantage de copies du logiciel ne peut pas fabriquer un accélérateur rare.
Ce que l’enquête a changé
| Hypothèse initiale | Ce que montre la requête |
|---|---|
| Les conteneurs sont sains, donc l’assistant l’est aussi | Les utilisateurs attendent toujours l’inférence du modèle |
| Davantage de réplicas d’API corrigeront le retard | L’API n’est pas le composant contraint |
| Un CPU de serveur inactif signifie qu’il reste de la capacité | La mémoire ou les périphériques GPU adaptés sont peut-être déjà alloués |
| La priorité garantit une capacité de reprise immédiate | La planification DRA présente une limite de préemption documentée |
Les ingénieurs n’ont plus besoin d’une nouvelle explication de la panne. Ils doivent choisir une intervention et en tester les conséquences.
Corriger la capacité, la visibilité et la reprise
Partez de la demande d’inférence, pas de l’utilisation CPU de l’API. L’équipe mesure les requêtes en attente du modèle, les requêtes en cours de traitement, la latence des réponses et le débit du service de modèles. KServe est une plateforme open source de service de modèles sur Kubernetes. Sa documentation sur la mise à l’échelle automatique (autoscaling) de l’inférence générative montre comment KEDA (Kubernetes Event-driven Autoscaling, la mise à l’échelle automatique de Kubernetes pilotée par les événements) peut ajuster le nombre de réplicas d’inférence à partir de métriques de service de modèles, notamment le nombre de requêtes fourni par le moteur d’inférence vLLM, à condition que l’infrastructure de métriques nécessaire soit configurée.
Cette mise à l’échelle peut demander davantage de réplicas, mais elle ne peut pas garantir la disponibilité des GPU. L’équipe doit déterminer ce qui donne le meilleur résultat : réserver des accélérateurs, améliorer le regroupement des requêtes (batching, qui consiste à grouper les requêtes pour que le modèle en traite plusieurs ensemble), réduire les appels inutiles au modèle ou changer la taille du modèle. Une fois qu’il existe plusieurs réplicas, notre article sur la répartition de charge de l’inférence d’IA (en anglais) explique comment le routage peut tenir compte du travail mis en cache et de la capacité de calcul occupée.
Suivez la requête de bout en bout. Une trace distribuée enregistre le parcours d’une requête et le temps passé dans chacune de ses étapes. OpenTelemetry, qui a obtenu le statut de projet diplômé de la CNCF le 21 mai 2026, fournit des outils d’observabilité (observability) indépendants des fournisseurs. Ses conventions sémantiques GenAI, les noms de champs convenus pour ce type de télémétrie (telemetry), continuent d’évoluer pour les invocations de modèles, l’utilisation des jetons et l’exécution d’outils.
Un jeton (token) est une unité de texte consommée ou générée par un modèle. Le nombre de jetons peut aider à expliquer la demande de traitement et le coût. Le traçage permet de distinguer le temps passé à attendre du temps passé à générer une réponse. Notre article sur la maîtrise du pipeline de télémétrie explique ce qu’OpenTelemetry standardise et dans quels cas exploiter un Collector justifie la couche supplémentaire.
Tenez le contenu sensible à l’écart de la télémétrie superflue. Les prompts des employés, les textes de politique récupérés et les réponses générées pourraient contenir des informations privées. La documentation des attributs GenAI d’OpenTelemetry signale les contenus potentiellement sensibles. Les ingénieurs devraient mesurer la latence et les volumes sans stocker sans discernement les prompts complets, et appliquer des contrôles d’accès, un filtrage et une durée de conservation à tout contenu dont ils ont réellement besoin.
Testez le service, pas seulement le redémarrage. Si un nœud d’inférence tombe en panne, Kubernetes peut planifier un Pod de remplacement. Ce Pod a toujours besoin d’un accélérateur adapté et des fichiers du modèle, et l’application a aussi besoin de ses dépendances de recherche et d’identité. Un test de reprise utile mesure le moment où les employés peuvent de nouveau obtenir une réponse correcte et autorisée.
Et si un agent d’IA peut modifier des enregistrements, l’application en aval doit autoriser chaque action pour l’utilisateur réel : qu’un modèle décide d’appeler un outil ne vaut pas permission d’effectuer l’opération. Les contrôles de sécurité de Kubernetes aident à protéger les charges de travail, mais ne remplacent pas l’autorisation métier.
Ces réponses résolvent des problèmes différents. La mise à l’échelle traite le manque de capacité, le traçage explique les performances, les contrôles de confidentialité protègent les données collectées, et la reprise comme l’autorisation protègent le service lui-même.
Exploiter le modèle ou acheter l’inférence
L’équipe peut continuer à héberger l’inférence sur Kubernetes, ou exploiter son application sur Kubernetes tout en utilisant une API de modèle gérée. Aucune de ces deux options n’est la réponse universelle.
| Choix | Inférence auto-hébergée | API de modèle gérée |
|---|---|---|
| Matériel | L’équipe gère la capacité et l’utilisation des accélérateurs | Le fournisseur gère l’infrastructure de service |
| Mise à l’échelle | Exige la planification, des métriques de service de modèles et une capacité de réserve | Exige la gestion des quotas, de la concurrence et des limites du fournisseur |
| Contrôle | Davantage de contrôle sur l’environnement d’exécution et le déploiement des modèles | Limité aux modèles et fonctionnalités pris en charge par le fournisseur |
| Économie | Temps matériel, ingénierie, exploitation et stockage | Frais d’utilisation, engagements et coûts d’intégration |
| Risque | Chargement des modèles, reprise du cluster et des accélérateurs | Réseau, disponibilité du service et modalités de traitement des données |
Pour une entreprise qui sert de nombreux modèles avec un volume soutenu, gérer l’inférence peut valoir la peine. Une petite équipe qui exploite un seul assistant pourrait éviter un travail important sur les GPU en utilisant un service géré. Si elle garde l’inférence dans Kubernetes, des pools de nœuds GPU dédiés (node pools, c’est-à-dire des groupes de machines de travail équipées de GPU) ou des clusters séparés peuvent être appropriés lorsque l’isolation, la capacité ou la fiabilité le justifient. Une équipe qui héberge elle-même un modèle doit aussi choisir un moteur pour le servir, et notre guide pour choisir un moteur d’inférence d’IA détaille les points à comparer.
L’entreprise de notre exemple peut désormais comparer les options à partir de la demande mesurée en requêtes, des objectifs de service, de l’effort d’exploitation et des exigences relatives aux données. C’est plus utile que de décider que chaque composant d’IA doit vivre dans un cluster Kubernetes simplement parce que le reste de l’application s’y trouve.
Le niveau de détail nécessaire dépend du rôle de chaque équipe. La plupart des équipes plateforme et applicatives ont seulement besoin de reconnaître ce schéma et de mesurer où une requête attend, ce qui suffit pour poser tôt la bonne question. Les équipes qui hébergent elles-mêmes des modèles doivent approfondir la planification des accélérateurs et le service de modèles, et la documentation de Kubernetes et de KServe citée ci-dessous est écrite pour elles.
Kubernetes reste une base solide : il planifie les services, aide à maintenir la disponibilité et donne aux équipes des contrôles opérationnels familiers. L’IA ajoute des contraintes de ressources et des responsabilités applicatives que ces contrôles ne peuvent pas régler à eux seuls.
La compétence importante pour les équipes plateforme n’est pas de traiter l’IA comme un monde entièrement nouveau. C’est de savoir où s’arrêtent les pratiques Kubernetes familières, et où l’ingénierie du service de modèles doit commencer.
Pour aller plus loin
- CNCF Annual Cloud Native Survey 2025. CNCF, janvier 2026. Chiffres d’adoption, populations interrogées et limites de l’enquête.
- KubeCon North America 2026 AI Inference + Agentic track. CNCF, août 2026. Les priorités d’infrastructure émergentes de l’événement.
- Kubernetes GPU scheduling. Recommandations officielles sur les plugins de périphériques.
- Kubernetes Dynamic Resource Allocation. Statut stable, demandes de périphériques et limites de préemption.
- KServe generative-inference autoscaling. KServe. Mise à l’échelle du service de modèles et métriques KEDA.
- OpenTelemetry graduation. 21 mai 2026. Étape importante du projet.
- OpenTelemetry GenAI semantic conventions. Télémétrie des modèles, des agents et des outils, en évolution.
- OpenTelemetry GenAI attributes. Détails d’instrumentation sensibles pour la confidentialité.