

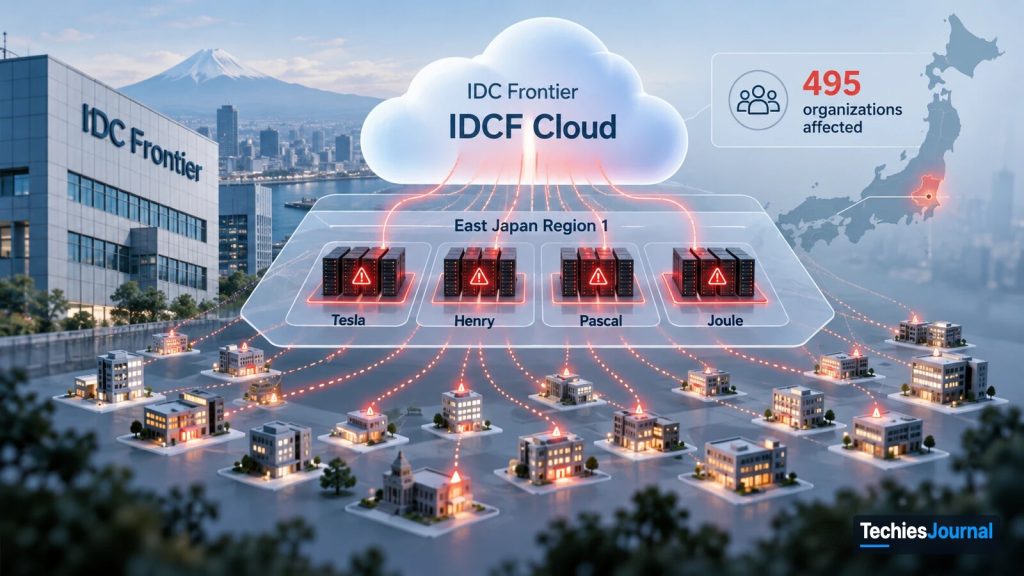
Solo es una ilustración. Muestra cómo muchos clientes dependen de un mismo proveedor y no es un diagrama de la red real de IDC Frontier. Los edificios y la posición en el mapa son simbólicos.
Un ataque de ransomware en octubre de 2026 interrumpió servicios en la nube que usaban 495 organizaciones en Japón. El incidente muestra cómo un problema de seguridad dentro de un solo proveedor puede afectar a muchos clientes y complicar su recuperación.
Un solo incidente, 495 organizaciones afectadas
El 7 de octubre de 2026, el proveedor de nube japonés IDC Frontier informó de un acceso no autorizado que afectaba a parte de su infraestructura de IDCF Cloud. En su segundo informe de ese día, la empresa confirmó que el incidente incluía ransomware e informó de que estaban afectadas 495 empresas y organizaciones de la administración local.
La interrupción afectó a cuatro zonas de East Japan Region 1: Tesla, Henry, Pascal y Joule. Los servidores virtuales de esas zonas se habían detenido y no se podían reiniciar. Como parte de su respuesta, IDC Frontier desconectó de la red la infraestructura afectada y restringió temporalmente el acceso a los sistemas de gestión de la nube. Otras zonas y regiones, entre ellas las zonas radian y newton de East Japan Region 1, East Japan Region 2 y 3 y West Japan Region 1, no sufrieron interrupciones, y el proveedor dijo que no había confirmado ningún acceso no autorizado en ellas. Sus clientes conservaron sus servidores virtuales, pero se les pidió que hicieran sus propias copias de seguridad, y el proveedor iniciaba y detenía los servidores por ellos mientras la consola de gestión estaba en pausa.
Para los clientes, esto supuso algo más que una interrupción temporal. Sus aplicaciones podían quedar inaccesibles, y las herramientas habituales para gestionar o reiniciar sus servidores virtuales no estaban necesariamente disponibles. Fuente: IDC Frontier, informe del incidente del 8 de octubre.
Los informes, en orden
| Fecha | Informe | Qué cubría |
|---|---|---|
| 7 de octubre | Segundo informe | Confirmación del ransomware, 495 organizaciones y la respuesta inicial del proveedor |
| 8 de octubre | Tercer informe | Cuatro zonas afectadas, 495 organizaciones, servidores virtuales detenidos e indicaciones para la recuperación |
| 14 de octubre | Quinto informe | Conclusiones sobre los datos de clientes, consultas que afectaban a 48 clientes y recuperación de instantáneas (snapshots) para 194 clientes |
| 18 de octubre | Sexto informe | Anuncio de la reanudación del servicio de copias de seguridad en las zonas no afectadas, con la función de instantáneas aún suspendida |
Por qué un solo ataque puede afectar a muchos clientes
Los proveedores de nube operan una infraestructura que muchas organizaciones usan de forma independiente. Cada cliente puede tener sus propias máquinas virtuales, aplicaciones y datos. Sin embargo, esos servicios siguen dependiendo de la infraestructura subyacente de cómputo, almacenamiento, red y gestión del proveedor.
Esto crea una dependencia compartida. Aunque las cargas de trabajo de los clientes estén aisladas lógicamente, un problema que afecte a la infraestructura del proveedor o a su capacidad para operarla puede interrumpir el servicio de varios clientes.
En el caso de IDC Frontier, la empresa informó de que había desconectado los sistemas afectados y restringido el acceso de gestión como parte de su respuesta al ransomware. Estas medidas de contención eran importantes para la investigación y para evitar más daños, pero también limitaron lo que podían hacer los clientes afectados.
Normalmente, un cliente podría reiniciar un servidor virtual desde una consola o una API de la nube. Durante este incidente, IDC Frontier informó de que los servidores virtuales afectados no se podían reiniciar. El incidente ilustra una distinción importante: los clientes gestionan sus aplicaciones, pero no controlan todos los sistemas subyacentes de los que dependen esas aplicaciones.
La recuperación no fue sencilla de inmediato
El 8 de octubre, IDC Frontier advirtió de que sería difícil recuperar o restaurar datos de las zonas afectadas. Al principio, la empresa aconsejó a los clientes afectados que prepararan entornos alternativos y se recuperaran con copias de seguridad que mantuvieran ellos mismos, y dijo que, en ese momento, su criterio era que los datos solo podían restaurarse a partir de esas copias.
Esto suponía un reto particular para los clientes que dependían de las funciones de recuperación integradas del proveedor. Una instantánea de la nube puede conservar una copia de los datos de una máquina virtual. Pero acceder a esa instantánea puede seguir dependiendo de la infraestructura de almacenamiento y de los servicios de gestión del proveedor. Si esos sistemas no están disponibles o están restringidos durante una investigación, la existencia de una instantánea no garantiza que el cliente pueda recuperarla de inmediato.
La situación cambió a medida que IDC Frontier avanzaba en la investigación. El 14 de octubre, la empresa informó de que, después de que una empresa de seguridad externa ayudara a confirmar que los datos de las copias de seguridad eran seguros, se podían recuperar los datos de las copias de seguridad por instantánea de 194 clientes afectados que habían usado su función de instantáneas.
Fue un avance importante, pero no significaba que los 194 clientes ya hubieran restaurado sus aplicaciones. El proveedor seguía trabajando con los clientes para ver cómo podían usar los datos recuperados en su recuperación. Tampoco significaba que las otras 301 organizaciones (495 menos 194) hubieran perdido sus datos de forma permanente. Pueden haber tenido otras copias de seguridad u otros mecanismos de recuperación, y las conclusiones publicadas no establecían cómo terminó finalmente su recuperación. Fuente: IDC Frontier, actualización de la investigación del 14 de octubre.
La secuencia muestra por qué la recuperación era más complicada que simplemente reiniciar una máquina virtual. Los clientes necesitaban tanto acceso a datos utilizables como un entorno en el que sus servicios pudieran volver a funcionar.
Lo que estableció la investigación sobre los datos de los clientes
Un incidente de ransomware puede implicar interrupción del servicio, acceso no autorizado a datos o robo de datos. Son resultados distintos. En su informe del 14 de octubre, IDC Frontier afirmó que su investigación no había encontrado pruebas de que los atacantes hubieran accedido a los datos almacenados en los servidores virtuales de los clientes de las cuatro zonas afectadas ni de que los hubieran extraído. Dijo que en ese momento no había confirmado ningún uso indebido ni otros daños secundarios, y concluyó que ningún dato había salido de sus sistemas.
Por otro lado, la empresa informó de consultas no autorizadas a información de registro del portal de la nube asociada a 48 clientes. Los tipos de datos consultados incluían nombres de empresas, identificadores de inicio de sesión del portal, contraseñas del portal almacenadas como hashes que el proveedor describió como aleatorios y difíciles de restaurar, direcciones de correo electrónico de notificación e importes mensuales totales facturados, y dos direcciones de correo electrónico podrían haber incluido el nombre de una persona. En ese momento, IDC Frontier dijo que no había encontrado pruebas de que la información de registro consultada se hubiera sacado de sus sistemas.
Estas eran las conclusiones del proveedor en el momento del anuncio, no la prueba de que se hubiera descartado cualquier forma posible de exposición. El impacto confirmado a gran escala fue la interrupción de los servicios en la nube. Por lo tanto, sería inexacto describir a las 495 organizaciones afectadas como víctimas de un robo de datos confirmado. Fuente: IDC Frontier, actualización de la investigación del 14 de octubre.
Qué pasó después
El 18 de octubre, IDC Frontier anunció que su servicio independiente IDCF Cloud Backup se reanudaría en las zonas radian y newton, East Japan Region 2 y 3 y West Japan Region 1, donde los servidores virtuales habían seguido funcionando. El proveedor también describió opciones para recuperar los datos de las copias de seguridad y restaurarlos fuera de IDCF Cloud, por ejemplo en otras nubes o en entornos locales (on-premises).
Sin embargo, la función de instantáneas siguió suspendida mientras continuaban las comprobaciones de seguridad adicionales. Se trató de la restauración parcial de un servicio de copias de seguridad concreto, no del anuncio de que todos los sistemas y clientes afectados se habían recuperado. Fuente: IDC Frontier, actualización del servicio de copias de seguridad del 18 de octubre.
Qué nos dice este incidente
El incidente de IDC Frontier recuerda que a los clientes de la nube pueden afectarles hechos que van más allá de sus propias aplicaciones y configuraciones de seguridad. Un solo incidente de ransomware en el proveedor interrumpió los servicios de 495 organizaciones. Las medidas de contención restringieron las operaciones normales de la infraestructura, y las opciones de recuperación solo se aclararon a medida que avanzaba la investigación.
El incidente no demuestra que todos los clientes afectados perdieran datos, que la arquitectura de seguridad del proveedor fuera necesariamente inadecuada ni que usar varios proveedores de nube hubiera evitado la interrupción.
Sí muestra algo importante sobre la infraestructura de nube compartida: un incidente en el proveedor puede afectar a muchos clientes a la vez, y recuperar una aplicación puede depender de capacidades que esos clientes no controlan directamente. Esa distinción merece atención cada vez que una organización evalúa qué parte de su negocio depende de un único proveedor de infraestructura.
Para profundizar
Fecha de corte de la investigación: 20 de octubre de 2026. Los anuncios originales de IDC Frontier que siguen están publicados en japonés.
- IDC Frontier, 7 de octubre de 2026: segundo informe del incidente, confirmación del ransomware y respuesta inicial del proveedor al incidente.
- IDC Frontier, 8 de octubre de 2026: tercer informe del incidente, cuatro zonas afectadas, 495 organizaciones afectadas, servidores virtuales detenidos e indicaciones para la recuperación.
- IDC Frontier, 14 de octubre de 2026: quinto informe del incidente, investigación sobre la exposición de datos de clientes, consultas que afectaban a 48 clientes y recuperación de instantáneas para 194 clientes.
- IDC Frontier, 18 de octubre de 2026: sexto informe del incidente, reanudación del servicio independiente de copias de seguridad en determinadas zonas de operación.
Lecturas relacionadas en TechiesJournal
- La capacidad en la nube no es lo mismo que la disponibilidad, para entender por qué un servicio en la nube puede estar en funcionamiento y aun así no poder proporcionar los recursos que necesita un cliente.