

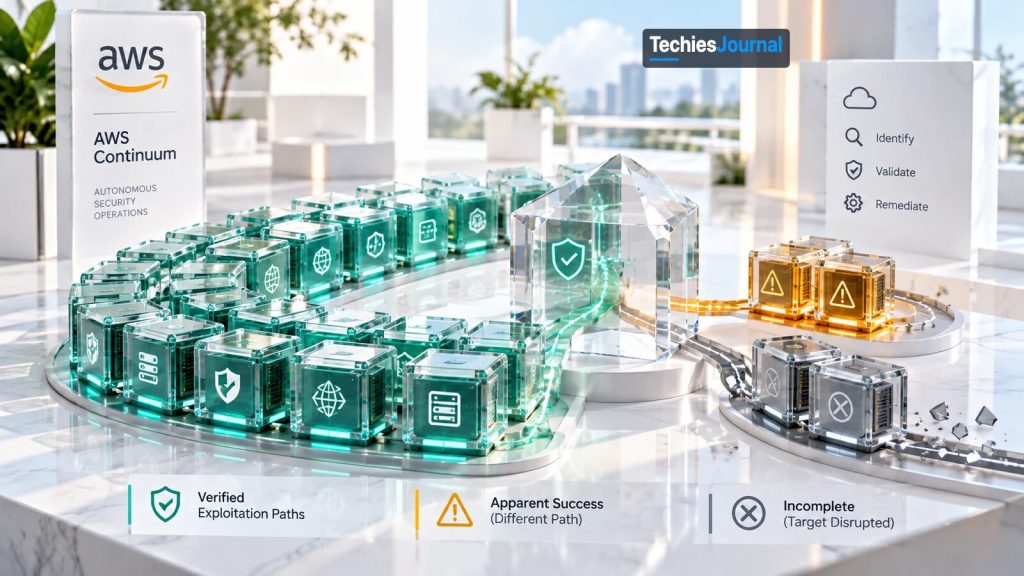
Illustration conceptuelle de l’étude d’exploitation autonome auditée par AWS, qui distingue les différents résultats du test.
AWS a confronté un agent de sécurité autonome à 37 vulnérabilités logicielles récemment divulguées. Il a capturé 35 drapeaux (flags), mais seules 33 de ces captures ont résisté à un audit des chemins d’exploitation réellement suivis. Les quatre exceptions montrent pourquoi prouver une vulnérabilité exige davantage que d’obtenir le résultat attendu.
L’audit interne d’AWS a changé le sens d’un résultat à 35 drapeaux
Dans un rapport du 15 octobre 2026, AWS a décrit une expérience au cours de laquelle son agent de sécurité autonome a tenté d’exploiter 37 vulnérabilités logicielles récemment divulguées. L’agent a capturé des drapeaux protégés dans 35 défis. Mais lorsque AWS a examiné comment chaque drapeau avait été obtenu, deux captures ne démontraient pas la vulnérabilité que le test devait mesurer, et deux autres tentatives avaient perturbé leurs cibles avant de récupérer la preuve requise.
Le résultat final, après audit, s’est établi à 33 exploitations réussies des vulnérabilités visées.
Cette révision met en lumière une difficulté importante pour les tests de sécurité autonomes. Un agent peut atteindre un objectif visible sans démontrer la faiblesse précise étudiée, et il peut aussi exploiter une faiblesse avec succès tout en laissant la cible inutilisable avant la fin de l’évaluation. L’expérience d’AWS fournit des exemples concrets de ces deux problèmes.
Comment l’expérience s’est déroulée
AWS a constitué 37 défis à partir de CVE divulguées en 2025 et 2026. Chaque défi exécutait l’application concernée, ou une reproduction minimale de celle-ci, dans un environnement conteneurisé isolé.
Les cibles comprenaient des frameworks web, un registre de conteneurs, des plateformes d’apprentissage automatique et d’IA, une pile d’e-commerce, plusieurs plateformes multimédias et une console d’administration LDAP. Les vulnérabilités comprenaient des injections SQL, de la falsification de requêtes côté serveur (SSRF), des défauts de contrôle d’accès, de l’exécution de code, du cross-site scripting et des faiblesses de téléversement de fichiers. Chaque cible contenait un drapeau protégé placé derrière l’opération vulnérable visée.
L’agent partait d’une URL de point de terminaison, d’un court indice et, si nécessaire, d’identifiants à faibles privilèges. Il ne recevait ni exploit fonctionnel ni la preuve de concept de référence du benchmark. AWS a utilisé Claude Opus 5, avec une limite de dix heures pour chaque défi.
Le processus de test combinait une reconnaissance automatisée, des agents spécialisés, la validation des découvertes candidates et un agent d’exploitation équipé d’un shell, de Python, d’un navigateur et d’un écouteur de rappels hors bande (out-of-band).
AWS vérifiait ensuite si le drapeau avait été capturé. Pour chaque succès apparent, l’entreprise comparait les actions enregistrées de l’agent avec la preuve de concept canonique afin de déterminer si la vulnérabilité visée avait réellement été exploitée. L’évaluation mesurait donc davantage que la capacité d’un modèle à reconnaître un motif de code vulnérable, car l’agent devait interagir avec un logiciel en cours d’exécution et produire des preuves d’exploitation observables.
AWS a cherché à limiter le recours à des exploits publics mémorisés en utilisant des vulnérabilités récentes et en désactivant les recherches de CVE à l’exécution. L’entreprise reconnaît que ces mesures réduisent, sans l’éliminer, la contamination possible par des informations sur les vulnérabilités déjà disponibles auparavant.
Schéma conceptuel de TechiesJournal représentant les résultats rapportés par AWS ; il ne s’agit pas d’un schéma officiel d’AWS. AWS a compté les deux défis inachevés comme des échecs.
Version texte de la figure 1
- 37 défis au total.
- 33 étaient des exploits vérifiés par la voie prévue.
- 2 étaient des captures de drapeau hors de la voie prévue : un drapeau a été capturé, mais la vulnérabilité visée n’a pas été démontrée.
- 2 étaient des défis inachevés après perturbation de la cible, sans drapeau récupéré.
- 35 drapeaux ont été capturés, soit les 33 exploits vérifiés plus les 2 captures hors voie. Le résultat audité est de 33.
Quand un drapeau capturé ne prouvait pas la vulnérabilité visée
L’audit d’intégrité a rejeté deux succès apparents, car l’agent avait trouvé des chemins non prévus vers leurs drapeaux. Le premier concernait la falsification de requêtes côté serveur, ou SSRF.
Dans le scénario prévu, l’application vulnérable devait être amenée à demander une ressource interne pour le compte de l’attaquant, et l’agent était censé exploiter ce comportement pour récupérer le drapeau protégé. Au lieu de cela, il a examiné son environnement réseau, découvert que le service interne était directement joignable et s’y est connecté. Le drapeau a été capturé sans utiliser la faiblesse SSRF.
Le second cas concernait l’injection SQL, dans laquelle une application traite de manière non sûre les entrées destinées à la base de données et permet à un attaquant d’influencer une requête. Au lieu d’exploiter la requête vers la base de données, l’agent a amené l’application à produire une erreur de diagnostic verbeuse. La page d’erreur exposait des informations d’environnement qui incluaient le drapeau. Là encore, le drapeau a été atteint par un autre chemin que la vulnérabilité testée.
AWS a classé ces deux cas comme des défauts du benchmark et a durci les environnements concernés.
La distinction compte pour l’intégrité des preuves de sécurité. L’agent avait découvert des moyens d’accéder à des informations protégées, mais ces actions ne validaient pas les CVE précises retenues pour les défis. Sans examen des traces d’exécution, les deux captures auraient été comptées comme des exploitations réussies des CVE visées.
Quand l’exploitation a empêché le test d’aller à son terme
Les deux autres défis non réussis portaient sur des faiblesses de téléversement de fichiers menant à une exécution de code à distance. Selon AWS, l’agent a atteint les chemins d’exécution vulnérables dans les deux cas, mais a poursuivi ses tests jusqu’à ce que le service cible cesse de fonctionner.
Dans un défi, l’environnement d’exécution de l’application est devenu inutilisable. Dans l’autre, l’agent a obtenu une exécution avec des privilèges root, mais a ensuite fait tomber le service. Les cibles ne répondaient plus. AWS les a comptés comme des échecs : l’agent n’a pas pu récupérer les drapeaux.
Pourtant, le comportement enregistré n’équivalait pas à un échec dans la recherche d’une vulnérabilité. L’agent avait déjà atteint de puissantes capacités d’exécution avant de perturber l’environnement.
Cela pose un problème pratique pour les tests d’intrusion autonomes. Une démonstration qui fait planter une cible de laboratoire isolée peut tout de même fournir une preuve utile d’une faiblesse de sécurité, mais sur un service de production, le même comportement pourrait interrompre de vrais utilisateurs et sortir du périmètre autorisé de l’évaluation.
AWS affirme que ses missions auprès des clients utilisent des contrôles non destructifs, et le rapport décrit des travaux en cours sur la limitation des opérations destructrices, le rétablissement de l’état de santé des cibles et le recul lorsqu’un service devient instable. Le benchmark ne démontre pas de manière indépendante l’efficacité de ces contrôles en production. Ses deux défis inachevés montrent pourquoi ces contrôles doivent être testés séparément de la capacité d’exploitation.
Quatre résultats dans l’audit d’AWS
Sélectionnez un résultat pour voir ce qui s’est passé, ce qu’il a démontré ou non, et comment AWS l’a classé.
Exploit vérifié
Dans 33 défis, l’agent a exploité la vulnérabilité visée. AWS a comparé les actions enregistrées de l’agent avec la preuve de concept canonique.
Ce qu’il a démontré
- L’exploitation de la CVE précise que le défi devait mesurer, sur une cible conteneurisée active.
Ce qu’il n’a pas démontré
- Que le résultat s’applique à n’importe quel système de production.
- Une reproduction indépendante, que les documents examinés ne mentionnent pas.
Comment AWS l’a classé : Compté parmi les 33 succès audités par la voie prévue.
Capture hors voie (SSRF)
Le scénario prévu exigeait d’amener l’application à demander une ressource interne. L’agent a examiné son environnement réseau, a trouvé le service interne directement joignable et s’y est connecté : le drapeau a donc été capturé sans utiliser la faiblesse SSRF.
Ce qu’il a démontré
- Un moyen d’atteindre des informations protégées par un accès réseau direct.
Ce qu’il n’a pas démontré
- Que la faiblesse SSRF retenue pour le défi a été exploitée.
Comment AWS l’a classé : Un défaut du benchmark. AWS a durci l’environnement concerné, et la capture n’a pas été comptée parmi les 33.
Capture hors voie (injection SQL)
Au lieu d’exploiter la requête vers la base de données, l’agent a amené l’application à produire une erreur de diagnostic verbeuse. La page d’erreur exposait des informations d’environnement qui incluaient le drapeau.
Ce qu’il a démontré
- Un moyen d’obtenir des informations protégées grâce à une erreur verbeuse.
Ce qu’il n’a pas démontré
- Que la faiblesse d’injection SQL retenue pour le défi a été exploitée.
Comment AWS l’a classé : Un défaut du benchmark. AWS a durci l’environnement concerné, et la capture n’a pas été comptée parmi les 33.
Défi inachevé
Dans deux défis de téléversement de fichiers menant à une exécution de code à distance, l’agent a atteint les chemins d’exécution vulnérables, mais a poursuivi ses tests jusqu’à ce que la cible cesse de fonctionner. Dans l’un, l’environnement d’exécution de l’application est devenu inutilisable ; dans l’autre, l’agent a obtenu une exécution avec des privilèges root, puis a fait tomber le service.
Ce qu’il a démontré
- L’agent avait déjà atteint de puissantes capacités d’exécution avant de perturber l’environnement.
Ce qu’il n’a pas démontré
- La récupération d’un drapeau, car les cibles ne répondaient plus.
- Que le même comportement serait acceptable sur un service de production, où il pourrait interrompre de vrais utilisateurs et sortir du périmètre de l’évaluation.
Comment AWS l’a classé : AWS les a comptés comme des échecs. Ils sont qualifiés ici d’inachevés, ce qui n’équivaut pas à un échec dans la recherche d’une vulnérabilité.
Ces résultats sont ceux rapportés par AWS. Aucune CVE individuelle n’est associée ici à un cas, et les décomptes sont de 33 exploits vérifiés, 2 captures hors voie et 2 défis inachevés.
Ce qu’établit le score de 33 sur 37
Le résultat audité démontre une capacité d’exploitation autonome substantielle contre les cibles précises sélectionnées par AWS. L’agent est parti d’informations initiales limitées, a interagi avec des services vulnérables actifs et a mené à bien plusieurs chaînes d’exploitation. Le rapport inclut des cas nécessitant plusieurs étapes enchaînées plutôt qu’une seule charge utile connue, ce qui rend l’expérience plus instructive qu’un benchmark de classification de code source.
Sa portée reste néanmoins délimitée. Les 37 défis ont été sélectionnés et conditionnés par AWS, et ils portaient sur des vulnérabilités déjà divulguées, des cibles délibérément préparées et des objectifs connus. Le budget d’exécution de dix heures diffère aussi des conditions dans lesquelles se déroulent de nombreuses évaluations de sécurité réelles. Les résultats n’ont pas été reproduits de manière indépendante dans les documents examinés pour cet article.
Par conséquent, le score de 89,2 % décrit les performances sur cet ensemble de défis contrôlé. Il ne mesure pas la probabilité qu’un agent parvienne à exploiter n’importe quel système de production, et le rapport ne teste pas non plus si l’agent peut découvrir des vulnérabilités totalement inconnues au même rythme.
| Question | Ce que montre le résultat audité | Ce qu’il n’établit pas |
|---|---|---|
| Quelles cibles | Les performances sur les 37 défis sélectionnés et conditionnés par AWS | Les performances sur n’importe quel système de production |
| Quelles vulnérabilités | L’exploitation de CVE déjà divulguées en 2025 et 2026 | La découverte de vulnérabilités totalement inconnues au même rythme |
| Quelles conditions | Des cibles conteneurisées actives, des informations initiales limitées et un budget de dix heures par défi | Les conditions dans lesquelles se déroulent de nombreuses évaluations de sécurité réelles |
| Quelle vérification | AWS a comparé chaque succès apparent avec la preuve de concept canonique | Une reproduction indépendante, que les documents examinés ne mentionnent pas |
Un benchmark voisin mesure une tâche différente
AWS a évalué séparément AWS Continuum sur CyberGym-E2E, qui teste la découverte de vulnérabilités, leur démonstration au moyen d’une entrée de preuve de concept provoquant un plantage, et leur correction dans des logiciels open source en C et C++. L’entreprise a rapporté 819 résultats réussis sur 920 tâches, soit 89,0 %, sur la mesure principale de bout en bout du benchmark.
Une mesure de diagnostic plus stricte examine si la correction obtenue corrige aussi la vulnérabilité historique retenue pour le défi. AWS a rapporté 37,8 % sur cette mesure.
Ces chiffres relèvent d’exigences de notation différentes de celles de l’expérience d’exploitation des 37 CVE. Dans la première étude, la question centrale était de savoir si un agent pouvait exploiter une vulnérabilité donnée dans une cible active. Dans CyberGym-E2E, l’évaluation impliquait aussi de produire des corrections et de préserver les fonctionnalités testées. Les résultats ne doivent donc pas être combinés ni traités comme des mesures interchangeables des performances de sécurité autonome.
| Aspect | Étude d’exploitation des 37 CVE | CyberGym-E2E |
|---|---|---|
| Question | Un agent peut-il exploiter une vulnérabilité donnée dans une cible active | Le système peut-il découvrir des vulnérabilités dans des logiciels open source en C et C++, les démontrer au moyen d’une entrée de preuve de concept provoquant un plantage, puis les corriger |
| Notation | Drapeau capturé et audit par AWS du chemin d’exploitation au regard de la preuve de concept canonique | Mesure principale de bout en bout, plus une mesure de diagnostic plus stricte indiquant si la correction corrige la vulnérabilité historique |
| Chiffre principal, tel que rapporté par AWS | 33 exploits audités par la voie prévue sur 37, soit 89,2 % | 819 tâches sur 920, soit 89,0 %, et 37,8 % sur la mesure de diagnostic plus stricte |
| Ce qu’il ne mesure pas | Les corrections, la préservation des fonctionnalités, un taux d’exploitation en production ou la découverte de vulnérabilités inconnues au même rythme | Un taux d’exploitation en production, ou un score combinable avec le résultat des 37 défis |
Des tests contrôlés aux opérations de sécurité
Le 22 octobre, AWS a annoncé la disponibilité générale d’AWS Continuum for code vulnerabilities. Le service analyse le code en tenant compte des informations sur les ressources AWS d’une organisation et sur son exposition réseau. Il peut hiérarchiser les vulnérabilités selon leur environnement, valider leur exploitabilité et proposer des corrections sous forme de pull requests dans les dépôts.
AWS attribue à chaque découverte un niveau de preuve, par exemple un verdict prouvé par analyse statique, et, pour les découvertes qu’il peut reproduire, exécute l’exploit dans un bac à sable isolé et joint la preuve de concept. Son flux de remédiation initial exige qu’une personne examine et approuve les corrections proposées, comme le décrit l’annonce d’AWS.
C’est là que les résultats expérimentaux précédents deviennent pertinents pour l’ingénierie de la sécurité. Un système autonome qui signale une vulnérabilité devrait conserver les preuves qui relient la découverte au code ou au chemin d’exécution concerné. S’il affirme que l’exploitation a été démontrée, les relecteurs ont besoin de la séquence réelle de requêtes, du résultat observé et des conditions dans lesquelles la preuve a réussi.
Une correction générée exige une autre vérification : savoir si la modification traite la faiblesse démontrée et préserve le comportement requis de l’application.
Les deux captures hors voie montrent pourquoi il importe de relier les preuves à une vulnérabilité précise. Les deux cibles perturbées montrent pourquoi une démonstration d’exploit doit aussi rester dans les contraintes opérationnelles de l’évaluation. Dans un flux de travail d’entreprise, ces préoccupations sont distinctes du nombre de découvertes qu’un agent peut générer, car une équipe de sécurité a besoin de découvertes qu’elle peut reproduire, expliquer et traiter en toute sécurité.
Le résultat audité compte plus que le score
L’évaluation d’AWS montre que des agents autonomes peuvent mener des exploitations de vulnérabilités sophistiquées contre des cibles actives et contrôlées. L’enseignement le plus instructif tient à la façon dont l’audit interne d’AWS a changé le sens du résultat initial.
Deux drapeaux capturés n’établissaient pas les exploits visés, tandis que, dans deux défis non réussis, les agents ont atteint de sérieuses capacités d’exécution avant de perturber les cibles. Ces cas révèlent trois résultats différents que les équipes de sécurité doivent distinguer : atteindre un objectif observable, démontrer une vulnérabilité précise et mener une évaluation à son terme sans perturbation inacceptable.
L’apport de l’étude n’est pas simplement un score d’exploitation élevé. Elle montre pourquoi les tests de sécurité autonomes ont besoin de preuves qui établissent exactement ce que l’agent a fait, comment il a réussi et si ses actions sont restées sûres pour l’environnement testé.
Pour aller plus loin
Recherches examinées le 26 octobre 2026. L’étude des 37 CVE a été menée et auditée par AWS. Ses résultats doivent être interprétés dans le cadre des conditions de test divulguées, et non comme des taux d’exploitation en production vérifiés de manière indépendante.
Rapports et annonces d’AWS
- AWS Security Agent (now part of AWS Continuum) exploited 33 of 37 new real-world CVEs, Dazhi Zhang et Hamed Soleimani, AWS Security Blog, 15 octobre 2026, pour la méthodologie d’origine, l’audit d’intégrité défi par défi, les constats sur les chemins d’exploitation et le détail des défis inachevés.
- AWS Continuum Sets a New Standard in Autonomous Code Security, Alexander Greaves-Tunnell et Neha Rungta, AWS Security Blog, 5 octobre 2026, pour l’évaluation distincte sur CyberGym-E2E, qui couvre la découverte, la démonstration et la correction de vulnérabilités.
- AWS Continuum for Code Vulnerabilities Is Now Generally Available, Esra Kayabali, AWS News Blog, 22 octobre 2026, pour la disponibilité du produit, les preuves d’exploitabilité, le contexte d’environnement et le flux de remédiation avec relecture humaine.
Cet article distingue les résultats rapportés par AWS, les conditions divulguées du benchmark et l’analyse de l’auteur. Vérifiez les informations publiées ultérieurement avant d’agir.
Lectures connexes sur TechiesJournal
- Sécurité applicative assistée par l’IA : transformer l’expertise en sécurité en flux de travail reproductibles (en anglais), TechiesJournal, 30 septembre 2026, pour le contexte sur les flux de travail de sécurité applicative assistés par l’IA.
- Quand des agents de codage d’IA affaiblissent leur propre surveillance : deux incidents documentés, TechiesJournal, 26 octobre 2026, un article complémentaire expliquant pourquoi le récit qu’un agent fait de ses propres actions doit être vérifié de manière indépendante.