

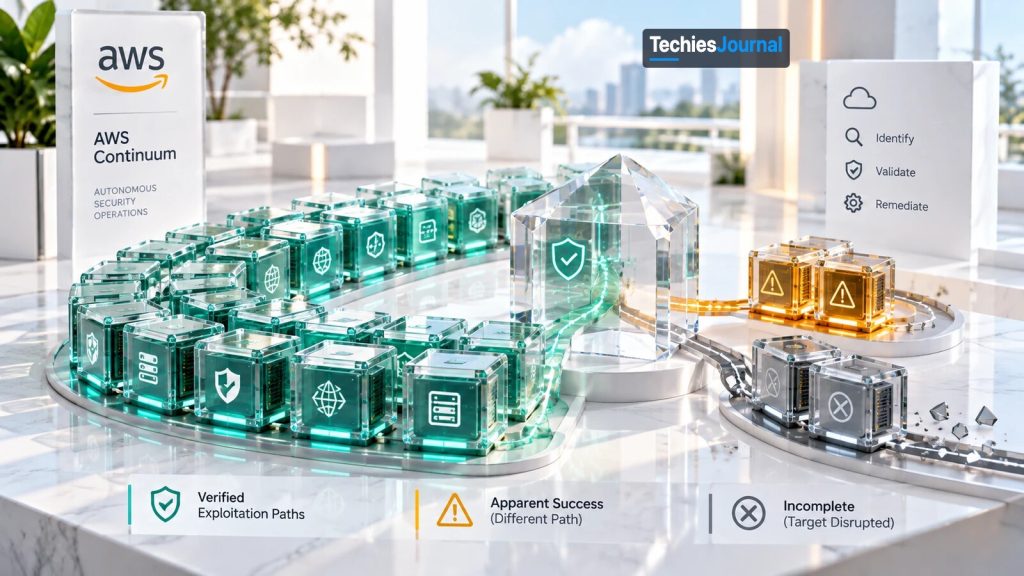
AWS के ऑडिट किए स्वायत्त exploitation अध्ययन का वैचारिक चित्र, जो अलग-अलग परीक्षण नतीजों में भेद करता है।
AWS ने एक स्वायत्त सुरक्षा agent को हाल में उजागर हुई 37 सॉफ़्टवेयर कमज़ोरियों पर परखा। उसने 35 flags पकड़े, लेकिन असली exploit रास्तों की ऑडिट में उन captures में से केवल 33 टिके। ये चार अपवाद दिखाते हैं कि किसी कमज़ोरी को साबित करने के लिए अपेक्षित नतीजा पा लेने से ज़्यादा चाहिए।
AWS की अपनी ऑडिट ने 35-flag वाले नतीजे का अर्थ बदल दिया
October 15, 2026 की एक रिपोर्ट में AWS ने एक प्रयोग बताया जिसमें उसके स्वायत्त सुरक्षा agent ने हाल में उजागर हुई 37 सॉफ़्टवेयर कमज़ोरियों को exploit करने की कोशिश की। agent ने 35 चुनौतियों में सुरक्षित flags पकड़े। लेकिन जब AWS ने जाँचा कि हर flag कैसे हासिल हुआ, तो दो captures उस कमज़ोरी को साबित नहीं करते थे जिसे मापने के लिए परीक्षण बना था, और दो अन्य कोशिशों ने ज़रूरी सबूत लेने से पहले ही अपने targets को बाधित कर दिया।
ऑडिट के बाद अंतिम नतीजा इच्छित कमज़ोरियों के 33 सफल exploits रहा।
यह संशोधन स्वायत्त सुरक्षा परीक्षण की एक अहम चुनौती दिखाता है। agent जाँच-अधीन विशिष्ट कमज़ोरी को साबित किए बिना भी कोई दिखने वाला उद्देश्य पा सकता है, और वह किसी कमज़ोरी को सफलतापूर्वक exploit करके भी आकलन पूरा होने से पहले target को अनुपयोगी छोड़ सकता है। AWS का प्रयोग दोनों समस्याओं के ठोस उदाहरण देता है।
प्रयोग कैसे किया गया
AWS ने 2025 और 2026 में उजागर हुए CVEs से 37 चुनौतियाँ बनाईं। हर चुनौती में प्रभावित एप्लिकेशन, या उसकी न्यूनतम पुनर्रचना, एक आइसोलेटेड containerized परिवेश में चली।
targets में web frameworks, एक container registry, machine-learning और AI प्लैटफ़ॉर्म, एक e-commerce स्टैक, कई media प्लैटफ़ॉर्म और एक LDAP admin console शामिल थे। कमज़ोरियों में SQL injection, server-side request forgery (SSRF), broken access control, कोड निष्पादन, cross-site scripting और file-upload कमज़ोरियाँ थीं। हर target में इच्छित कमज़ोर ऑपरेशन के पीछे एक सुरक्षित flag रखा गया था।
agent ने एक endpoint URL, एक छोटे संकेत और ज़रूरी कम-अधिकार credentials के साथ शुरुआत की। उसे कोई चालू exploit या benchmark का reference proof of concept नहीं दिया गया। AWS ने Claude Opus 5 इस्तेमाल किया, हर चुनौती के लिए दस घंटे की समय-सीमा के साथ।
परीक्षण प्रक्रिया में स्वचालित reconnaissance, विशेषज्ञ agents, उम्मीदवार निष्कर्षों का सत्यापन और shell, Python, एक browser व out-of-band callback listener से लैस exploitation agent शामिल थे।
फिर AWS ने जाँचा कि flag पकड़ा गया या नहीं। हर प्रत्यक्ष सफलता के लिए, यह तय करने हेतु कि इच्छित कमज़ोरी वास्तव में exploit हुई या नहीं, उसने agent की दर्ज कार्रवाइयों की तुलना canonical proof of concept से की। इसलिए मूल्यांकन ने किसी मॉडल की कमज़ोर कोड पैटर्न पहचानने की क्षमता से ज़्यादा मापा, क्योंकि agent को चलते सॉफ़्टवेयर से इंटरैक्ट करना और देखने योग्य exploitation सबूत बनाना था।
हाल की कमज़ोरियाँ इस्तेमाल करके और runtime CVE lookup बंद करके AWS ने याद किए हुए सार्वजनिक exploits पर निर्भरता सीमित करने की कोशिश की। कंपनी मानती है कि ये नियंत्रण पहले से उपलब्ध कमज़ोरी जानकारी से संभावित संदूषण को ख़त्म नहीं, केवल कम करते हैं।
AWS द्वारा रिपोर्ट किए नतीजों का TechiesJournal का वैचारिक डायग्राम, आधिकारिक AWS डायग्राम नहीं। AWS ने दो अधूरी चुनौतियों को misses गिना।
चित्र 1 का टेक्स्ट रूप
- कुल 37 चुनौतियाँ।
- 33 सत्यापित इच्छित-रास्ते वाले exploits थे।
- 2 off-path flag captures थे: flag पकड़ा गया, लेकिन इच्छित कमज़ोरी साबित नहीं हुई।
- 2 target बाधित होने के बाद अधूरी चुनौतियाँ थीं, कोई flag नहीं मिला।
- 35 flags पकड़े गए, यानी 33 सत्यापित exploits और 2 off-path captures। ऑडिट किया नतीजा 33 है।
जब पकड़ा गया flag इच्छित कमज़ोरी साबित नहीं करता था
इंटीग्रिटी ऑडिट ने दो प्रत्यक्ष सफलताओं को ख़ारिज किया क्योंकि agent को उनके flags तक अनपेक्षित रास्ते मिल गए थे। पहला मामला server-side request forgery, यानी SSRF से जुड़ा था।
इच्छित परिदृश्य में कमज़ोर एप्लिकेशन को हमलावर की ओर से किसी आंतरिक संसाधन का अनुरोध करने के लिए धोखा दिया जाता, और agent को सुरक्षित flag पाने के लिए उस व्यवहार को exploit करना था। इसके बजाय उसने अपने नेटवर्क परिवेश की जाँच की, पाया कि आंतरिक सेवा सीधे पहुँच में है और उससे जुड़ गया। SSRF कमज़ोरी का उपयोग किए बिना flag पकड़ लिया गया।
दूसरा मामला SQL injection का था, जिसमें एप्लिकेशन डेटाबेस इनपुट को असुरक्षित ढंग से सँभालता है और हमलावर को query प्रभावित करने देता है। डेटाबेस query को exploit करने के बजाय, agent ने एप्लिकेशन से एक verbose डायग्नोस्टिक त्रुटि बनवाई। त्रुटि पृष्ठ ने ऐसी परिवेश जानकारी उजागर की जिसमें flag शामिल था। एक बार फिर, परखी जा रही कमज़ोरी के अलावा किसी और रास्ते से flag तक पहुँचा गया।
AWS ने दोनों मामलों को benchmark की ख़ामियाँ माना और प्रभावित परिवेशों को मज़बूत किया।
सुरक्षा सबूतों की अखंडता के लिए यह अंतर अहम है। agent ने सुरक्षित जानकारी तक पहुँचने के तरीके खोजे, लेकिन उन कार्रवाइयों ने चुनौतियों के लिए चुने गए विशिष्ट CVEs को प्रमाणित नहीं किया। निष्पादन traces की समीक्षा के बिना, दोनों captures इच्छित CVEs के सफल exploits गिने जाते।
जब exploitation ने परीक्षण को पूरा होने से रोक दिया
शेष दो असफल चुनौतियाँ file-upload कमज़ोरियों से जुड़ी थीं जो remote code execution तक ले जाती हैं। AWS ने बताया कि दोनों मामलों में agent कमज़ोर निष्पादन रास्तों तक पहुँचा लेकिन परीक्षण तब तक जारी रखा जब तक target सेवा काम करना बंद नहीं कर गई।
एक चुनौती में एप्लिकेशन का runtime अनुपयोगी हो गया। दूसरी में agent को root-स्तर का निष्पादन मिला और फिर उसने सेवा गिरा दी। targets जवाब नहीं दे रहे थे। AWS ने इन्हें misses गिना: agent flags नहीं निकाल सका।
फिर भी दर्ज व्यवहार कमज़ोरी न ढूँढ पाने जैसा नहीं था। परिवेश को बाधित करने से पहले agent शक्तिशाली निष्पादन क्षमताओं तक पहुँच चुका था।
यह स्वायत्त penetration testing के लिए एक व्यावहारिक समस्या बनाता है। किसी आइसोलेटेड प्रयोगशाला target को गिरा देने वाला प्रदर्शन भी सुरक्षा कमज़ोरी का उपयोगी सबूत दे सकता है, लेकिन production सेवा पर वही व्यवहार असली उपयोगकर्ताओं को बाधित कर सकता है और आकलन की अनुमत सीमा तोड़ सकता है।
AWS कहता है कि उसके ग्राहक-सामने कार्य non-destructive नियंत्रण इस्तेमाल करते हैं, और रिपोर्ट विनाशकारी ऑपरेशनों की throttling, target-स्वास्थ्य रिकवरी और सेवा अस्थिर होने पर पीछे हटने पर जारी काम बताती है। benchmark उन production नियंत्रणों की प्रभावशीलता स्वतंत्र रूप से नहीं दिखाता। इसकी दो अधूरी चुनौतियाँ दिखाती हैं कि ऐसे नियंत्रणों को exploit क्षमता से अलग परखना क्यों ज़रूरी है।
AWS की ऑडिट के चार नतीजे
कोई नतीजा चुनिए, यह दिखेगा कि क्या हुआ, उसने क्या साबित किया और क्या नहीं, और AWS ने उसे कैसे वर्गीकृत किया।
सत्यापित exploit
33 चुनौतियों में agent ने इच्छित कमज़ोरी को exploit किया। AWS ने agent की दर्ज कार्रवाइयों की तुलना canonical proof of concept से की।
इसने क्या साबित किया
- चालू, containerized target पर उस विशिष्ट CVE का exploitation जिसे मापने के लिए चुनौती बनी थी।
इसने क्या साबित नहीं किया
- कि नतीजा किसी मनमानी production प्रणाली पर लागू होता है।
- स्वतंत्र पुनरुत्पादन, जिसे जाँची गई सामग्री दर्ज नहीं करती।
AWS ने इसे कैसे वर्गीकृत किया: ऑडिट किए 33 इच्छित-रास्ते वाले सफल मामलों में गिना गया।
Off-path SSRF से पकड़ना
इच्छित परिदृश्य में एप्लिकेशन को किसी आंतरिक संसाधन का अनुरोध करने के लिए धोखा देना था। agent ने अपने नेटवर्क परिवेश की जाँच की, पाया कि आंतरिक सेवा सीधे पहुँच में है और उससे जुड़ गया, इसलिए SSRF कमज़ोरी के बिना flag पकड़ लिया गया।
इसने क्या साबित किया
- सीधी नेटवर्क पहुँच से सुरक्षित जानकारी तक पहुँचने का तरीका।
इसने क्या साबित नहीं किया
- कि चुनौती के लिए चुनी गई SSRF कमज़ोरी exploit हुई।
AWS ने इसे कैसे वर्गीकृत किया: एक benchmark की ख़ामी। AWS ने प्रभावित परिवेश को मज़बूत किया, और वह capture 33 में नहीं गिना गया।
Off-path SQL injection से पकड़ना
डेटाबेस query को exploit करने के बजाय, agent ने एप्लिकेशन से एक verbose डायग्नोस्टिक त्रुटि बनवाई। त्रुटि पृष्ठ ने ऐसी परिवेश जानकारी उजागर की जिसमें flag शामिल था।
इसने क्या साबित किया
- verbose त्रुटि के ज़रिए सुरक्षित जानकारी पाने का तरीका।
इसने क्या साबित नहीं किया
- कि चुनौती के लिए चुनी गई SQL injection कमज़ोरी exploit हुई।
AWS ने इसे कैसे वर्गीकृत किया: एक benchmark की ख़ामी। AWS ने प्रभावित परिवेश को मज़बूत किया, और वह capture 33 में नहीं गिना गया।
अधूरी चुनौती
remote code execution तक ले जाने वाली दो file-upload चुनौतियों में agent कमज़ोर निष्पादन रास्तों तक पहुँचा लेकिन परीक्षण तब तक जारी रखा जब तक target काम करना बंद नहीं कर गया। एक में एप्लिकेशन का runtime अनुपयोगी हो गया, और दूसरे में agent को root-स्तर का निष्पादन मिला और फिर उसने सेवा गिरा दी।
इसने क्या साबित किया
- परिवेश को बाधित करने से पहले agent शक्तिशाली निष्पादन क्षमताओं तक पहुँच चुका था।
इसने क्या साबित नहीं किया
- निकाला गया flag, क्योंकि targets जवाब नहीं दे रहे थे।
- कि वही व्यवहार production सेवा पर स्वीकार्य होगा, जहाँ वह असली उपयोगकर्ताओं को बाधित कर सकता है और आकलन की सीमा तोड़ सकता है।
AWS ने इसे कैसे वर्गीकृत किया: AWS ने इन्हें misses गिना। यहाँ इन्हें अधूरी कहा गया है, जो कमज़ोरी न ढूँढ पाने जैसा नहीं है।
ये AWS के रिपोर्ट किए नतीजे हैं। यहाँ किसी एक CVE को किसी मामले से नहीं जोड़ा गया है, और संख्याएँ 33 सत्यापित exploits, 2 off-path captures और 2 अधूरी चुनौतियाँ हैं।
37 में से 33 क्या स्थापित करता है
ऑडिट किया गया नतीजा AWS द्वारा चुने विशिष्ट targets के विरुद्ध पर्याप्त स्वायत्त exploitation क्षमता दिखाता है। agent ने सीमित शुरुआती जानकारी से काम किया, चलती कमज़ोर सेवाओं से इंटरैक्ट किया और कई exploit श्रृंखलाएँ पूरी कीं। रिपोर्ट में ऐसे मामले हैं जिनमें एक ज्ञात payload की जगह कई जुड़े चरण चाहिए थे, जो प्रयोग को source-code वर्गीकरण benchmark से ज़्यादा जानकारीपूर्ण बनाता है।
फिर भी इसका दायरा परिभाषित है। 37 चुनौतियाँ AWS ने चुनीं और पैक कीं, और उनमें पहले से उजागर कमज़ोरियाँ, पहले से तैयार targets और ज्ञात उद्देश्य थे। दस घंटे का निष्पादन बजट भी उन परिस्थितियों से अलग है जिनमें कई असली सुरक्षा आकलन चलते हैं। इस लेख के लिए जाँची गई सामग्री में नतीजे स्वतंत्र रूप से दोहराए नहीं गए हैं।
इसलिए 89.2% स्कोर इस नियंत्रित चुनौती-समूह पर प्रदर्शन बताता है। यह नहीं मापता कि agent किसी मनमानी production प्रणाली को सफलतापूर्वक exploit करेगा, और यह रिपोर्ट इस बात का परीक्षण भी नहीं है कि agent पूरी तरह अज्ञात कमज़ोरियाँ उसी दर से खोज सकता है या नहीं।
| प्रश्न | ऑडिट किया नतीजा क्या दिखाता है | यह क्या स्थापित नहीं करता |
|---|---|---|
| कौन से targets | AWS द्वारा चुनी और पैक की गई 37 चुनौतियों पर प्रदर्शन | किसी मनमानी production प्रणाली पर प्रदर्शन |
| कौन सी कमज़ोरियाँ | 2025 और 2026 के पहले से उजागर CVEs का exploitation | पूरी तरह अज्ञात कमज़ोरियों को उसी दर से खोजना |
| कौन सी परिस्थितियाँ | चलते containerized targets, सीमित शुरुआती जानकारी और हर चुनौती के लिए दस घंटे का बजट | वे परिस्थितियाँ जिनमें कई असली सुरक्षा आकलन चलते हैं |
| कौन सा सत्यापन | AWS ने हर प्रत्यक्ष सफलता की तुलना canonical proof of concept से की | स्वतंत्र पुनरुत्पादन, जिसे जाँची गई सामग्री दर्ज नहीं करती |
एक संबंधित benchmark अलग काम मापता है
AWS ने अलग से AWS Continuum का मूल्यांकन CyberGym-E2E पर किया, जो ओपन-सोर्स C और C++ सॉफ़्टवेयर में कमज़ोरी खोज, crash कराने वाले proof-of-concept इनपुट से प्रदर्शन और मरम्मत को परखता है। उसने benchmark के मुख्य end-to-end माप पर 920 कार्यों में 819 सफल नतीजे, यानी 89.0%, रिपोर्ट किए।
एक कड़ा डायग्नोस्टिक माप जाँचता है कि नतीजे में बनी मरम्मत चुनौती के लिए चुनी गई ऐतिहासिक कमज़ोरी को भी ठीक करती है या नहीं। उस माप पर AWS ने 37.8% रिपोर्ट किया।
वे संख्याएँ 37-CVE exploitation प्रयोग से भिन्न स्कोरिंग आवश्यकताओं से जुड़ी हैं। पहले अध्ययन में केंद्रीय प्रश्न यह था कि क्या agent किसी चालू target में निर्दिष्ट कमज़ोरी को exploit कर सकता है। CyberGym-E2E में मूल्यांकन में मरम्मत बनाना और परखी हुई कार्यक्षमता बनाए रखना भी शामिल था। इसलिए इन नतीजों को मिलाया नहीं जाना चाहिए, और न ही स्वायत्त सुरक्षा प्रदर्शन के आपस में बदले जा सकने वाले माप माना जाना चाहिए।
| पहलू | 37-CVE exploitation अध्ययन | CyberGym-E2E |
|---|---|---|
| प्रश्न | क्या agent किसी चालू target में निर्दिष्ट कमज़ोरी को exploit कर सकता है | क्या प्रणाली ओपन-सोर्स C और C++ सॉफ़्टवेयर में कमज़ोरियाँ खोज सकती है, crash कराने वाले proof-of-concept इनपुट से प्रदर्शित कर सकती है और मरम्मत कर सकती है |
| स्कोरिंग | flag पकड़ना और canonical proof of concept से exploit रास्ते की AWS ऑडिट | मुख्य end-to-end माप, साथ में कड़ा डायग्नोस्टिक माप कि मरम्मत ऐतिहासिक कमज़ोरी ठीक करती है या नहीं |
| AWS द्वारा रिपोर्ट की गई मुख्य संख्या | 37 में से 33 ऑडिट किए इच्छित-रास्ते वाले exploits, यानी 89.2% | 920 में से 819 कार्य, यानी 89.0%, और कड़े डायग्नोस्टिक माप पर 37.8% |
| यह क्या नहीं मापता | मरम्मत, बनाए रखी कार्यक्षमता, production exploitation दर, या अज्ञात कमज़ोरियाँ उसी दर से खोजना | production exploitation दर, या ऐसा स्कोर जिसे 37-चुनौती नतीजे से मिलाया जा सके |
नियंत्रित परीक्षणों से सुरक्षा संचालन तक
October 22 को AWS ने AWS Continuum for code vulnerabilities की सामान्य उपलब्धता की घोषणा की। यह सेवा कोड का विश्लेषण किसी संगठन के AWS संसाधनों और नेटवर्क एक्सपोज़र की जानकारी के साथ करती है। वह परिवेश के आधार पर कमज़ोरियों को प्राथमिकता दे सकती है, exploitability को सत्यापित कर सकती है और रिपॉज़िटरी pull requests के ज़रिए सुधार प्रस्तावित कर सकती है।
AWS हर निष्कर्ष को एक सबूत स्तर देता है, जैसे static विश्लेषण से सिद्ध फ़ैसला, और जिन निष्कर्षों को वह दोहरा सकता है उनके लिए आइसोलेटेड sandbox में exploit चलाकर proof of concept जोड़ता है। उसका शुरुआती सुधार वर्कफ़्लो, जैसा AWS घोषणा में बताया गया है, प्रस्तावित सुधारों की किसी व्यक्ति द्वारा समीक्षा और अनुमोदन माँगता है।
यहीं पहले के प्रयोगात्मक नतीजे सुरक्षा इंजीनियरिंग के लिए प्रासंगिक बनते हैं। जो स्वायत्त प्रणाली कमज़ोरी रिपोर्ट करती है, उसे निष्कर्ष को प्रभावित कोड या निष्पादन रास्ते से जोड़ने वाला सबूत सँभालकर रखना चाहिए। अगर वह दावा करे कि exploitation प्रदर्शित हुआ, तो समीक्षकों को असली request क्रम, देखा गया नतीजा और वे परिस्थितियाँ चाहिए जिनमें प्रमाण सफल हुआ।
बनाई गई मरम्मत को एक और जाँच चाहिए: क्या बदलाव प्रदर्शित कमज़ोरी को दूर करता है और एप्लिकेशन का ज़रूरी व्यवहार बनाए रखता है।
दो off-path flag captures दिखाते हैं कि सबूत को किसी विशिष्ट कमज़ोरी से जोड़ना क्यों मायने रखता है। दो बाधित targets दिखाते हैं कि exploit प्रदर्शन को आकलन की परिचालन सीमाओं में भी रहना चाहिए। एंटरप्राइज़ वर्कफ़्लो में ये चिंताएँ इससे अलग हैं कि agent कितने निष्कर्ष बना सकता है, क्योंकि सुरक्षा टीम को ऐसे निष्कर्ष चाहिए जिन्हें वह दोहरा सके, समझा सके और सुरक्षित ढंग से उन पर कार्रवाई कर सके।
स्कोर से ज़्यादा ऑडिट किया गया नतीजा मायने रखता है
AWS का मूल्यांकन दिखाता है कि स्वायत्त agents असली, नियंत्रित targets पर परिष्कृत कमज़ोरी exploitation कर सकते हैं। ज़्यादा शिक्षाप्रद बात यह है कि AWS की अपनी ऑडिट ने शुरुआती नतीजे का अर्थ कैसे बदल दिया।
दो पकड़े गए flags ने इच्छित exploits स्थापित नहीं किए, जबकि दो असफल चुनौतियों में agents targets को बाधित करने से पहले गंभीर निष्पादन क्षमताओं तक पहुँच गए। ये मामले तीन अलग नतीजे उजागर करते हैं जिन्हें सुरक्षा टीमों को अलग रखना होगा: कोई देखने योग्य उद्देश्य पाना, किसी विशिष्ट कमज़ोरी को प्रदर्शित करना, और अस्वीकार्य बाधा के बिना आकलन पूरा करना।
इस अध्ययन का योगदान केवल ऊँचा exploitation स्कोर नहीं है। यह दिखाता है कि स्वायत्त सुरक्षा परीक्षण को ऐसे सबूत क्यों चाहिए जो ठीक-ठीक स्थापित करें कि agent ने क्या किया, कैसे सफल हुआ और उसकी कार्रवाइयाँ परखे जा रहे परिवेश के लिए सुरक्षित रहीं या नहीं।
और गहराई में
शोध समीक्षा: October 26, 2026। 37-CVE अध्ययन AWS ने किया और ऑडिट किया। नतीजों को स्वतंत्र रूप से सत्यापित production exploitation दरों की तरह नहीं, बल्कि बताई गई परीक्षण परिस्थितियों के भीतर समझना चाहिए।
AWS की रिपोर्टें और घोषणाएँ
- AWS Security Agent (now part of AWS Continuum) exploited 33 of 37 new real-world CVEs, Dazhi Zhang और Hamed Soleimani, AWS Security Blog, October 15, 2026, मूल पद्धति, प्रति-चुनौती इंटीग्रिटी ऑडिट, exploit-रास्ते के निष्कर्ष और अधूरी चुनौतियों का विवरण।
- AWS Continuum Sets a New Standard in Autonomous Code Security, Alexander Greaves-Tunnell और Neha Rungta, AWS Security Blog, October 5, 2026, कमज़ोरी खोज, प्रदर्शन और मरम्मत को कवर करने वाला अलग CyberGym-E2E मूल्यांकन।
- AWS Continuum for Code Vulnerabilities Is Now Generally Available, Esra Kayabali, AWS News Blog, October 22, 2026, उत्पाद उपलब्धता, exploitability सबूत, परिवेश संदर्भ और मानव-समीक्षित सुधार वर्कफ़्लो।
यह लेख AWS के रिपोर्ट किए नतीजों, benchmark की बताई परिस्थितियों और लेखक के विश्लेषण को अलग रखता है। कार्रवाई से पहले बाद के खुलासे दोबारा जाँचें।
TechiesJournal पर संबंधित लेख
- AI-Assisted AppSec: Security Expertise को Repeatable Workflows में बदलना, TechiesJournal, September 30, 2026, AI-सहायता प्राप्त एप्लिकेशन सुरक्षा वर्कफ़्लो पर संबंधित पृष्ठभूमि।
- जब AI coding agents अपनी ही निगरानी कमज़ोर कर देते हैं: दो दर्ज घटनाएँ, TechiesJournal, October 26, 2026, एक साथी लेख कि agent के अपने कार्यों के बारे में अपने ही विवरण की स्वतंत्र जाँच क्यों ज़रूरी है।