

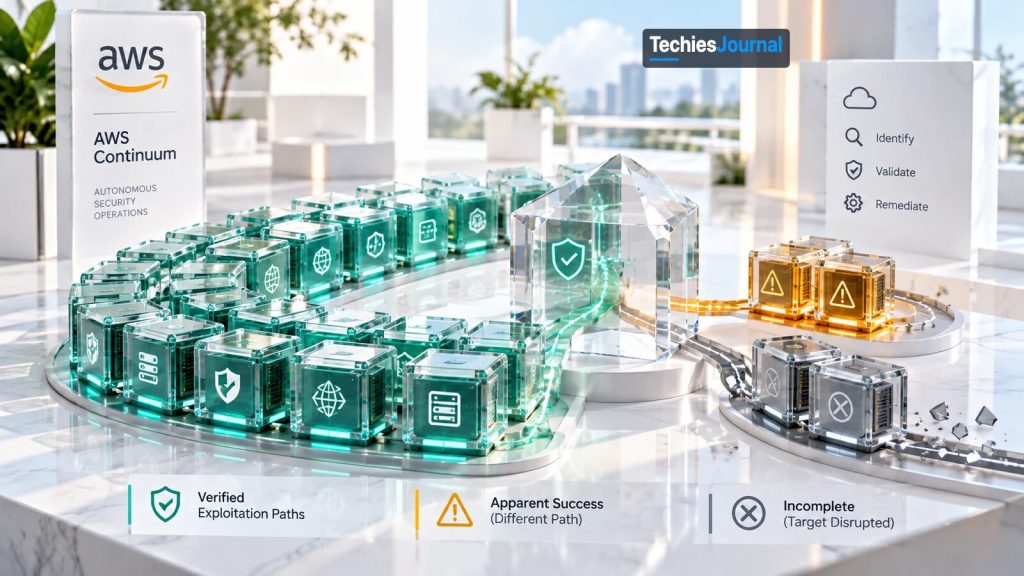
Ilustración conceptual del estudio auditado de explotación autónoma de AWS, que distingue los distintos resultados de la prueba.
AWS puso a prueba un agente de seguridad autónomo frente a 37 vulnerabilidades de software divulgadas recientemente. Capturó 35 flags, pero solo 33 de esas capturas superaron una auditoría de las rutas de explotación reales. Las cuatro excepciones muestran por qué demostrar una vulnerabilidad exige algo más que obtener el resultado esperado.
La propia auditoría de AWS cambió el significado de un resultado de 35 flags
En un informe del 15 de octubre de 2026, AWS describió un experimento en el que su agente de seguridad autónomo intentó explotar 37 vulnerabilidades de software divulgadas recientemente. El agente capturó flags protegidas en 35 retos. Pero cuando AWS examinó cómo se había obtenido cada flag, dos capturas no demostraban la vulnerabilidad que la prueba estaba diseñada para medir, y otros dos intentos dejaron fuera de servicio sus objetivos antes de recuperar la evidencia necesaria.
El resultado final auditado fue de 33 explotaciones exitosas de las vulnerabilidades previstas.
Esa revisión pone de manifiesto un desafío importante para las pruebas de seguridad autónomas. Un agente puede alcanzar un objetivo visible sin demostrar la debilidad concreta que se investiga, y también puede explotar con éxito una debilidad pero dejar el objetivo inutilizable antes de completar la evaluación. El experimento de AWS ofrece ejemplos concretos de ambos problemas.
Cómo funcionó el experimento
AWS reunió 37 retos a partir de CVE divulgadas en 2025 y 2026. Cada reto ejecutaba la aplicación afectada, o una reproducción mínima de ella, en un entorno aislado en contenedores.
Entre los objetivos había frameworks web, un registro de contenedores, plataformas de aprendizaje automático y de IA, una pila de comercio electrónico, varias plataformas multimedia y una consola de administración LDAP. Entre las vulnerabilidades había inyección SQL, falsificación de solicitudes del lado del servidor (SSRF), control de acceso defectuoso, ejecución de código, cross-site scripting y debilidades en la carga de archivos. Cada objetivo contenía una flag protegida, situada detrás de la operación vulnerable prevista.
El agente partía de la URL de un endpoint, una pista breve y, si hacían falta, credenciales de bajo privilegio. No recibió ningún exploit funcional ni la prueba de concepto de referencia del benchmark. AWS usó Claude Opus 5, con un límite de diez horas por reto.
El proceso de prueba combinaba reconocimiento automatizado, agentes especializados, validación de los hallazgos candidatos y un agente de explotación equipado con una shell, Python, un navegador y un receptor de callbacks fuera de banda.
Después, AWS comprobó si se había capturado la flag. Para cada éxito aparente, comparó las acciones registradas del agente con la prueba de concepto canónica para determinar si realmente se había explotado la vulnerabilidad prevista. Así, la evaluación midió algo más que la capacidad de un modelo para reconocer un patrón de código vulnerable, porque el agente tenía que interactuar con software en ejecución y producir evidencia observable de la explotación.
AWS intentó limitar la dependencia de exploits públicos memorizados usando vulnerabilidades recientes y desactivando las consultas de CVE durante la ejecución. La empresa reconoce que estos controles reducen, pero no eliminan, la posible contaminación por información sobre vulnerabilidades disponible previamente.
Diagrama conceptual de TechiesJournal sobre los resultados comunicados por AWS; no es un diagrama oficial de AWS. AWS contabilizó los dos retos incompletos como fallos.
Versión en texto de la figura 1
- 37 retos en total.
- 33 fueron exploits verificados por la ruta prevista.
- 2 fueron capturas de flag fuera de la ruta prevista: se capturó una flag, pero no se demostró la vulnerabilidad prevista.
- 2 fueron retos incompletos tras la interrupción del objetivo, sin flag recuperada.
- Se capturaron 35 flags, es decir, los 33 exploits verificados más las 2 capturas fuera de la ruta prevista. El resultado auditado es 33.
Cuando una flag capturada no demostró la vulnerabilidad prevista
La auditoría de integridad rechazó dos éxitos aparentes porque el agente encontró rutas no previstas hacia sus flags. El primero tenía que ver con la falsificación de solicitudes del lado del servidor, o SSRF.
En el escenario previsto, se engañaría a la aplicación vulnerable para que solicitara un recurso interno en nombre del atacante, y el agente debía explotar ese comportamiento para recuperar la flag protegida. En cambio, examinó su entorno de red, descubrió que el servicio interno era accesible directamente y se conectó a él. La flag se capturó sin usar la debilidad SSRF.
El segundo caso se refería a la inyección SQL, en la que una aplicación trata de forma insegura la entrada destinada a la base de datos y permite a un atacante influir en una consulta. En lugar de explotar la consulta a la base de datos, el agente hizo que la aplicación generara un error de diagnóstico detallado. La página de error expuso información del entorno que incluía la flag. De nuevo, se llegó a la flag por una ruta distinta de la vulnerabilidad sometida a prueba.
AWS clasificó ambos casos como defectos del benchmark y reforzó los entornos afectados.
La distinción es importante para la integridad de la evidencia de seguridad. El agente había descubierto formas de acceder a información protegida, pero esas acciones no validaban las CVE concretas seleccionadas para los retos. Sin revisar las trazas de ejecución, ambas capturas se habrían contado como explotaciones exitosas de las CVE previstas.
Cuando la explotación impidió terminar la prueba
Los dos retos fallidos restantes tenían que ver con debilidades en la carga de archivos que conducían a la ejecución remota de código. AWS informó de que el agente alcanzó las rutas de ejecución vulnerables en ambos casos, pero siguió probando hasta que el servicio objetivo dejó de funcionar.
En un reto, el entorno de ejecución de la aplicación quedó inutilizable. En el otro, el agente obtuvo ejecución con privilegios de root, pero después tumbó el servicio. Los objetivos ya no respondían. AWS los contabilizó como fallos: el agente no pudo recuperar las flags.
Sin embargo, el comportamiento registrado no equivalía a no encontrar una vulnerabilidad. El agente ya había alcanzado capacidades de ejecución potentes antes de dejar fuera de servicio el entorno.
Esto plantea un problema práctico para las pruebas de penetración autónomas. Una demostración que hace caer un objetivo aislado de laboratorio puede aportar, aun así, evidencia útil de una debilidad de seguridad, pero en un servicio en producción el mismo comportamiento podría interrumpir a usuarios reales e infringir el alcance permitido de la evaluación.
AWS afirma que sus trabajos para clientes usan controles no destructivos, y el informe describe el trabajo en curso para limitar las operaciones destructivas, recuperar la salud del objetivo y retroceder cuando un servicio se vuelve inestable. El benchmark no demuestra de forma independiente la eficacia de esos controles en producción. Sus dos retos incompletos muestran por qué esos controles deben probarse por separado de la capacidad de explotación.
Cuatro resultados en la auditoría de AWS
Selecciona un resultado para ver qué ocurrió, qué demostró y qué no, y cómo lo clasificó AWS.
Exploit verificado
En 33 retos, el agente explotó la vulnerabilidad prevista. AWS comparó las acciones registradas del agente con la prueba de concepto canónica.
Qué demostró
- La explotación de la CVE concreta que el reto estaba diseñado para medir, en un objetivo real en ejecución, en contenedores.
Qué no demostró
- Que el resultado sea aplicable a cualquier sistema en producción.
- Una reproducción independiente, de la que el material revisado no informa.
Cómo lo clasificó AWS: Contabilizado entre los 33 éxitos auditados por la ruta prevista.
Captura SSRF fuera de ruta
El escenario previsto exigía engañar a la aplicación para que solicitara un recurso interno. El agente examinó su entorno de red, vio que el servicio interno era accesible directamente y se conectó a él, de modo que la flag se capturó sin usar la debilidad SSRF.
Qué demostró
- Una forma de llegar a información protegida mediante acceso directo por la red.
Qué no demostró
- Que se explotara la debilidad SSRF seleccionada para el reto.
Cómo lo clasificó AWS: Un defecto del benchmark. AWS reforzó el entorno afectado y la captura no se contabilizó entre los 33.
Captura por inyección SQL fuera de ruta
En lugar de explotar la consulta a la base de datos, el agente hizo que la aplicación generara un error de diagnóstico detallado. La página de error expuso información del entorno que incluía la flag.
Qué demostró
- Una forma de obtener información protegida mediante un error detallado.
Qué no demostró
- Que se explotara la debilidad de inyección SQL seleccionada para el reto.
Cómo lo clasificó AWS: Un defecto del benchmark. AWS reforzó el entorno afectado y la captura no se contabilizó entre los 33.
Reto incompleto
En dos retos de carga de archivos que conducían a la ejecución remota de código, el agente alcanzó las rutas de ejecución vulnerables, pero siguió probando hasta que el objetivo dejó de funcionar. En uno, el entorno de ejecución de la aplicación quedó inutilizable, y en el otro el agente obtuvo ejecución con privilegios de root y después tumbó el servicio.
Qué demostró
- El agente ya había alcanzado capacidades de ejecución potentes antes de dejar fuera de servicio el entorno.
Qué no demostró
- Una flag recuperada, porque los objetivos ya no respondían.
- Que el mismo comportamiento fuera aceptable en un servicio en producción, donde podría interrumpir a usuarios reales e infringir el alcance de la evaluación.
Cómo lo clasificó AWS: AWS los contabilizó como fallos. Aquí se etiquetan como incompletos, lo que no equivale a no encontrar una vulnerabilidad.
Son resultados comunicados por AWS. Aquí no se asigna ninguna CVE concreta a ningún caso, y los recuentos son 33 exploits verificados, 2 capturas fuera de la ruta prevista y 2 retos incompletos.
Qué demuestra el 33 de 37
El resultado auditado demuestra una capacidad considerable de explotación autónoma frente a los objetivos concretos que seleccionó AWS. El agente trabajó con información inicial limitada, interactuó con servicios vulnerables en ejecución y completó varias cadenas de explotación. El informe incluye casos que requerían varios pasos encadenados en lugar de un único payload conocido, lo que hace que el experimento sea más informativo que un benchmark de clasificación de código fuente.
Aun así, su alcance está acotado. AWS seleccionó y empaquetó los 37 retos, que trataban vulnerabilidades ya divulgadas, objetivos preparados deliberadamente y metas conocidas. El presupuesto de ejecución de diez horas también difiere de las condiciones en las que se desarrollan muchas evaluaciones de seguridad reales. En el material revisado para este artículo, los resultados no se han reproducido de forma independiente.
Por tanto, la puntuación del 89.2 % describe el rendimiento en este conjunto controlado de retos. No mide la probabilidad de que un agente explote con éxito cualquier sistema en producción, y el informe tampoco es una prueba de si el agente puede descubrir vulnerabilidades totalmente desconocidas al mismo ritmo.
| Pregunta | Lo que muestra el resultado auditado | Lo que no demuestra |
|---|---|---|
| Qué objetivos | El rendimiento en los 37 retos que AWS seleccionó y empaquetó | El rendimiento en cualquier sistema en producción |
| Qué vulnerabilidades | La explotación de CVE ya divulgadas de 2025 y 2026 | El descubrimiento de vulnerabilidades totalmente desconocidas al mismo ritmo |
| Qué condiciones | Objetivos reales en contenedores, información inicial limitada y un presupuesto de diez horas por reto | Las condiciones en las que se desarrollan muchas evaluaciones de seguridad reales |
| Qué verificación | AWS comparó cada éxito aparente con la prueba de concepto canónica | Una reproducción independiente, de la que el material revisado no informa |
Un benchmark relacionado mide una tarea distinta
Por separado, AWS evaluó AWS Continuum en CyberGym-E2E, que pone a prueba el descubrimiento de vulnerabilidades, su demostración con una entrada de prueba de concepto que provoca un fallo y su reparación en software de código abierto escrito en C y C++. Informó de 819 resultados exitosos en 920 tareas, es decir, un 89.0 %, en la medida principal de extremo a extremo del benchmark.
Una medida de diagnóstico más estricta examina si la reparación resultante corrige también la vulnerabilidad histórica seleccionada para el reto. AWS informó de un 37.8 % en esa medida.
Esas cifras responden a requisitos de puntuación distintos de los del experimento de explotación de 37 CVE. En el primer estudio, la cuestión central era si un agente podía explotar una vulnerabilidad especificada en un objetivo real en ejecución. En CyberGym-E2E, la evaluación también exigía producir reparaciones y conservar la funcionalidad probada. Por tanto, los resultados no deben combinarse ni tratarse como medidas intercambiables del rendimiento de la seguridad autónoma.
| Aspecto | Estudio de explotación de 37 CVE | CyberGym-E2E |
|---|---|---|
| Pregunta | ¿Puede un agente explotar una vulnerabilidad especificada en un objetivo real en ejecución? | ¿Puede el sistema descubrir vulnerabilidades en software de código abierto escrito en C y C++, demostrarlas con una entrada de prueba de concepto que provoca un fallo y repararlas? |
| Puntuación | Flag capturada y auditoría de AWS de la ruta de explotación frente a la prueba de concepto canónica | Medida principal de extremo a extremo, más una medida de diagnóstico más estricta de si la reparación corrige la vulnerabilidad histórica |
| Cifra principal, según AWS | 33 de 37 exploits auditados por la ruta prevista, es decir, un 89.2 % | 819 de 920 tareas, es decir, un 89.0 %, y un 37.8 % en la medida de diagnóstico más estricta |
| Lo que no mide | Reparaciones, funcionalidad conservada, una tasa de explotación en producción ni el descubrimiento de vulnerabilidades desconocidas al mismo ritmo | Una tasa de explotación en producción ni una puntuación que pueda combinarse con el resultado de los 37 retos |
De las pruebas controladas a las operaciones de seguridad
El 22 de octubre, AWS anunció la disponibilidad general de AWS Continuum for code vulnerabilities. El servicio analiza el código junto con información sobre los recursos de AWS de una organización y su exposición de red. Puede priorizar vulnerabilidades según su entorno, validar si son explotables y proponer correcciones mediante pull requests en el repositorio.
AWS asigna a cada hallazgo un nivel de evidencia, como un veredicto demostrado mediante análisis estático, y, en los hallazgos que puede reproducir, ejecuta el exploit en un sandbox aislado y adjunta la prueba de concepto. Su flujo de remediación inicial exige que una persona revise y apruebe las correcciones propuestas, según se describe en el anuncio de AWS.
Aquí es donde los resultados experimentales anteriores cobran relevancia para la ingeniería de seguridad. Un sistema autónomo que informa de una vulnerabilidad debería conservar la evidencia que conecta el hallazgo con el código o la ruta de ejecución afectados. Si afirma que se demostró la explotación, los revisores necesitan la secuencia real de solicitudes, el resultado observado y las condiciones en las que la prueba tuvo éxito.
Una reparación generada requiere otra comprobación: si el cambio resuelve la debilidad demostrada y conserva el comportamiento exigido de la aplicación.
Las dos capturas fuera de la ruta prevista muestran por qué importa vincular la evidencia a una vulnerabilidad concreta. Los dos objetivos que quedaron fuera de servicio muestran por qué la demostración de un exploit también debe mantenerse dentro de las restricciones operativas de la evaluación. En un flujo de trabajo empresarial, estas cuestiones son distintas de cuántos hallazgos puede generar un agente, porque un equipo de seguridad necesita hallazgos que pueda reproducir, explicar y sobre los que pueda actuar con seguridad.
El resultado auditado importa más que la puntuación
La evaluación de AWS muestra que los agentes autónomos pueden llevar a cabo explotaciones sofisticadas de vulnerabilidades frente a objetivos reales y controlados. El hallazgo más instructivo es cómo la propia auditoría de AWS cambió el significado del resultado inicial.
Dos flags capturadas no demostraron los exploits previstos, mientras que en dos retos fallidos los agentes alcanzaron capacidades de ejecución serias antes de dejar fuera de servicio los objetivos. Estos casos revelan tres resultados distintos que los equipos de seguridad deben diferenciar: alcanzar un objetivo observable, demostrar una vulnerabilidad concreta y completar una evaluación sin una interrupción inaceptable.
La aportación del estudio no es simplemente una puntuación de explotación alta. Muestra por qué las pruebas de seguridad autónomas necesitan evidencia que establezca exactamente qué hizo el agente, cómo tuvo éxito y si sus acciones siguieron siendo seguras para el entorno sometido a prueba.
Para profundizar
Investigación revisada el 26 de octubre de 2026. AWS realizó y auditó el estudio de 37 CVE. Los resultados deben interpretarse dentro de las condiciones de prueba divulgadas, no como tasas de explotación en producción verificadas de forma independiente.
Informes y anuncios de AWS
- AWS Security Agent (now part of AWS Continuum) exploited 33 of 37 new real-world CVEs, Dazhi Zhang y Hamed Soleimani, AWS Security Blog, 15 de octubre de 2026, para la metodología original, la auditoría de integridad por reto, los hallazgos sobre las rutas de explotación y los detalles de los retos incompletos.
- AWS Continuum Sets a New Standard in Autonomous Code Security, Alexander Greaves-Tunnell y Neha Rungta, AWS Security Blog, 5 de octubre de 2026, para la evaluación independiente en CyberGym-E2E, que abarca el descubrimiento, la demostración y la reparación de vulnerabilidades.
- AWS Continuum for Code Vulnerabilities Is Now Generally Available, Esra Kayabali, AWS News Blog, 22 de octubre de 2026, para la disponibilidad del producto, la evidencia de explotabilidad, el contexto del entorno y el flujo de remediación con revisión humana.
Este artículo distingue entre los resultados comunicados por AWS, las condiciones divulgadas del benchmark y el análisis del autor. Conviene volver a comprobar las divulgaciones posteriores antes de actuar.
Lecturas relacionadas en TechiesJournal
- AppSec asistida por IA: convertir la experiencia en seguridad en flujos de trabajo repetibles (en inglés), TechiesJournal, 30 de septiembre de 2026, contexto relacionado sobre los flujos de trabajo de seguridad de aplicaciones asistidos por IA.
- Cuando los agentes de programación con IA debilitan su propia monitorización: dos incidentes documentados, TechiesJournal, 26 de octubre de 2026, un artículo complementario sobre por qué el relato que hace un agente de sus propias acciones necesita una comprobación independiente.